Generative AI: novità e riflessioni - #9 / 2026
OpenAI DevDay porta la delega nel cloud; Kimi Agent Swarm e TimesFM mettono alla prova autonomia e verifica. Astra, Claude e ScientistTwo spostano la competizione dal modello al sistema: costi, memoria e giudizio umano diventano decisivi.
Buon aggiornamento, e buone riflessioni..
Ascolta l'audio overview che sintetizza le novità
Il podcast è stato generato attraverso Gemini Notebook.
OpenAI DevDay: dalla risposta alla delega del lavoro
Il 29 settembre si è tenuto il DevDay 2026 di OpenAI: vediamo le novità presentate. Nel video ho inserito una sintesi con sottotitoli in italiano.
Dots: agenti sempre attivi dentro ChatGPT, a cui si affida una responsabilità invece di una richiesta. Hanno un computer e un browser nel cloud ed ereditano accessi e plugin dell'utente. ChatGPT Space è lo spazio in cui team e dots lavorano sulle stesse pagine.
Sui modelli arriva GPT-6.1 Sol: secondo OpenAI, un'intelligenza vicina ad Astra a un quinto del prezzo, con l'input in cache scontato del 95%. La guerra dei prezzi, insomma, continua. E lo sconto colpisce la voce che pesa di più negli agenti: il contesto riletto a ogni passaggio. UltraFast, invece, porta Astra a circa 300 token al secondo.
OpenAI DevDay 2026: gli highlights con sottotitoli in italiano
Per chi sviluppa, la novità più concreta è l’Agents API, in beta pubblica. Di norma chi costruisce un agente deve scriversi da sé il ciclo che chiama il modello, esegue gli strumenti, gestisce il contesto e decide quando fermarsi. OpenAI ora lo offre come servizio: harness, hosting, memoria, controlli multi-agente e computer use per operare su browser e interfacce. È la stessa tecnologia di Codex e dei dots, e l'harness di Codex è anche open source. L'ho già messa alla prova in un test.
Codex nel cloud merita un discorso a parte. Arriva sei giorni dopo che Anthropic ha portato fuori dalla preview le sessioni cloud di Claude Code, e le due aziende convergono su un'idea: l'agente di coding non vive più nel terminale di chi lo usa. Il task parte dal telefono, si riprende dal browser o dal desktop e prosegue a laptop chiuso.
Il cambiamento è meno banale di quanto sembri. Finché l'agente gira in locale, la durata del lavoro è legata alla sessione dell'utente. Nel cloud il limite diventa il budget, insieme alla qualità della specifica. Sul palco, Romain Huet ha chiesto a Codex di riscrivere l'intero backend in Rust, e l'ha lasciato lavorare. Cambia anche la revisione: si valuta un risultato, più che seguire un processo.
Messi in fila, gli annunci descrivono lo stesso spostamento: dall'AI che risponde all'AI che lavora per ore con i nostri accessi. A quel punto il valore dipende meno dal prompt e più da come definiamo la delega: cosa concedere, cosa far approvare, come verificare.
Agents API alla prova: stesso modello, harness diversi
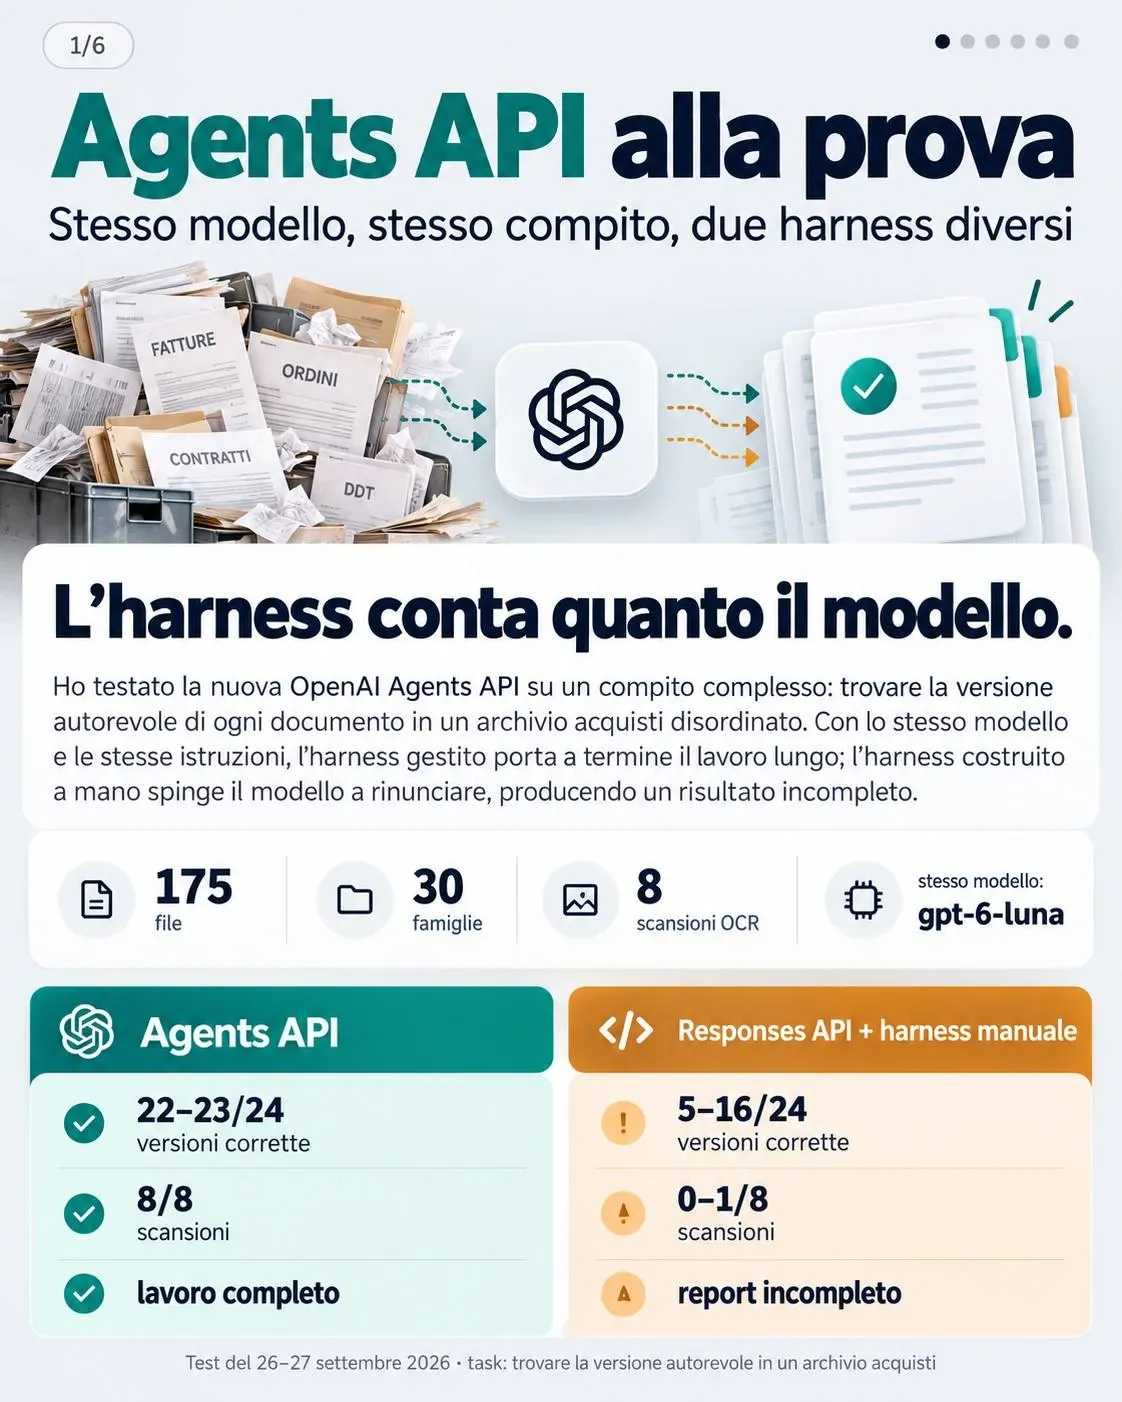
L’harness conta quanto il modello. È il risultato più interessante del test che ho fatto sulle nuove Agents API di OpenAI.
Ho messo lo stesso modello, GPT-6 Luna, con lo stesso reasoning effort e le stesse istruzioni, davanti allo stesso compito. A cambiare era soltanto l’infrastruttura agentica.
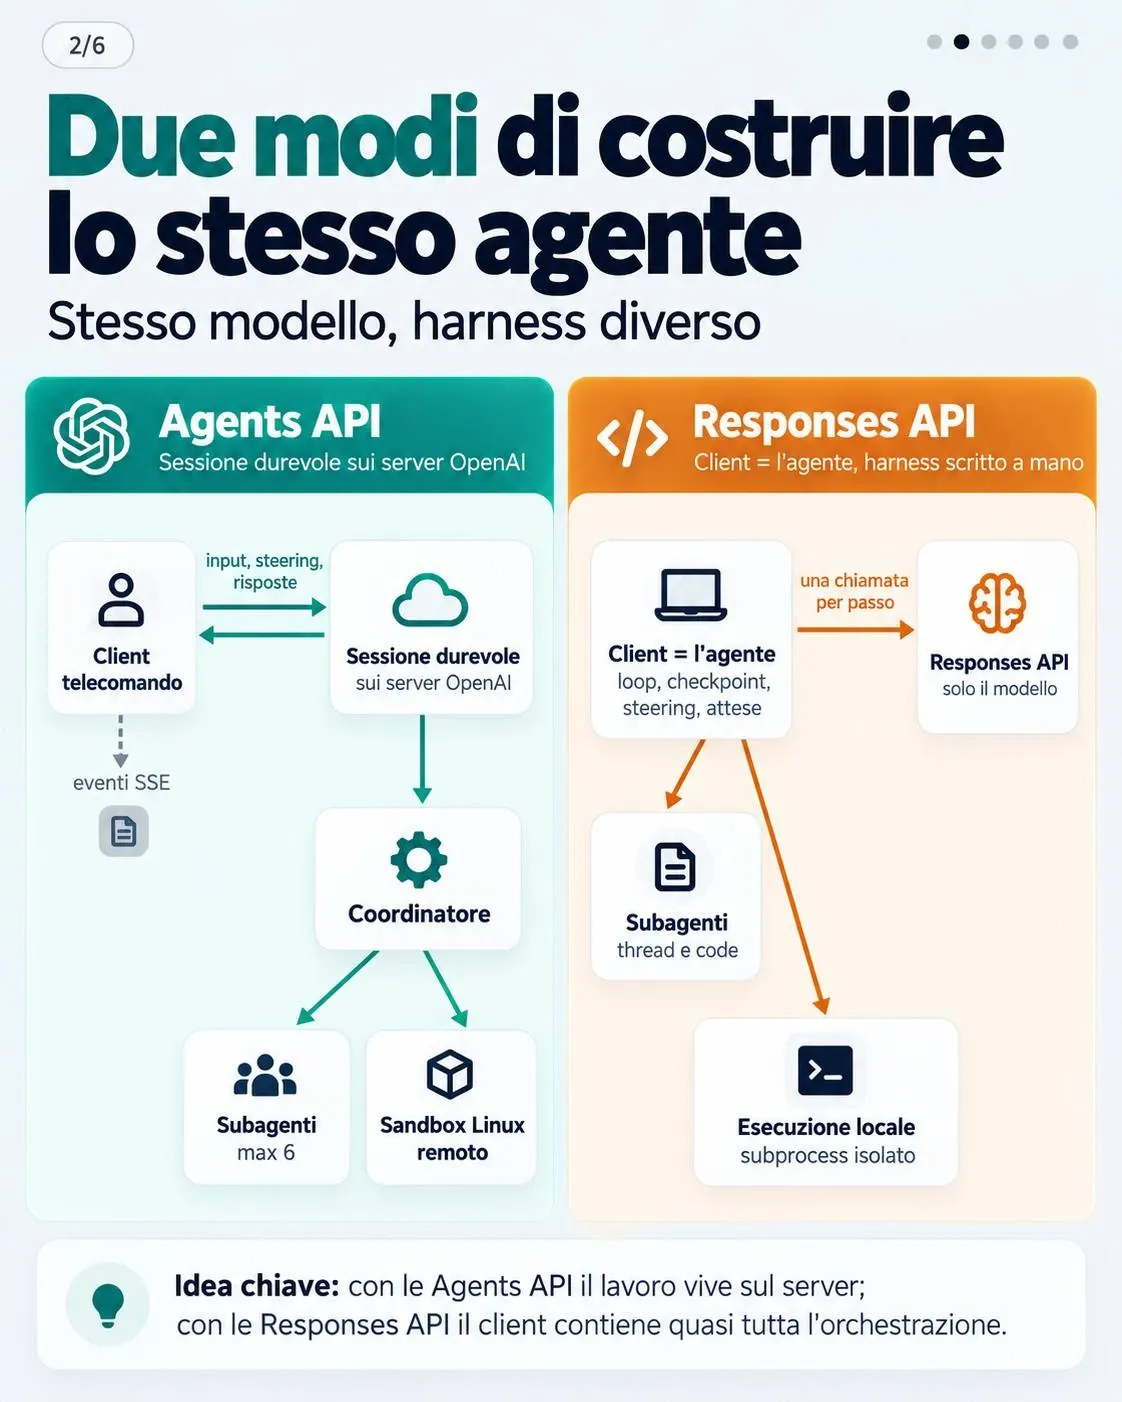
Da una parte, le Agents API: sessione durevole sui server OpenAI, sandbox, subagenti, steering e ripresa. Dall’altra, le Responses API, con un harness costruito da me: loop agentico, esecuzione del codice, subagenti, checkpoint, pause e ripresa.
Agents API alla prova: stesso modello, harness diversi
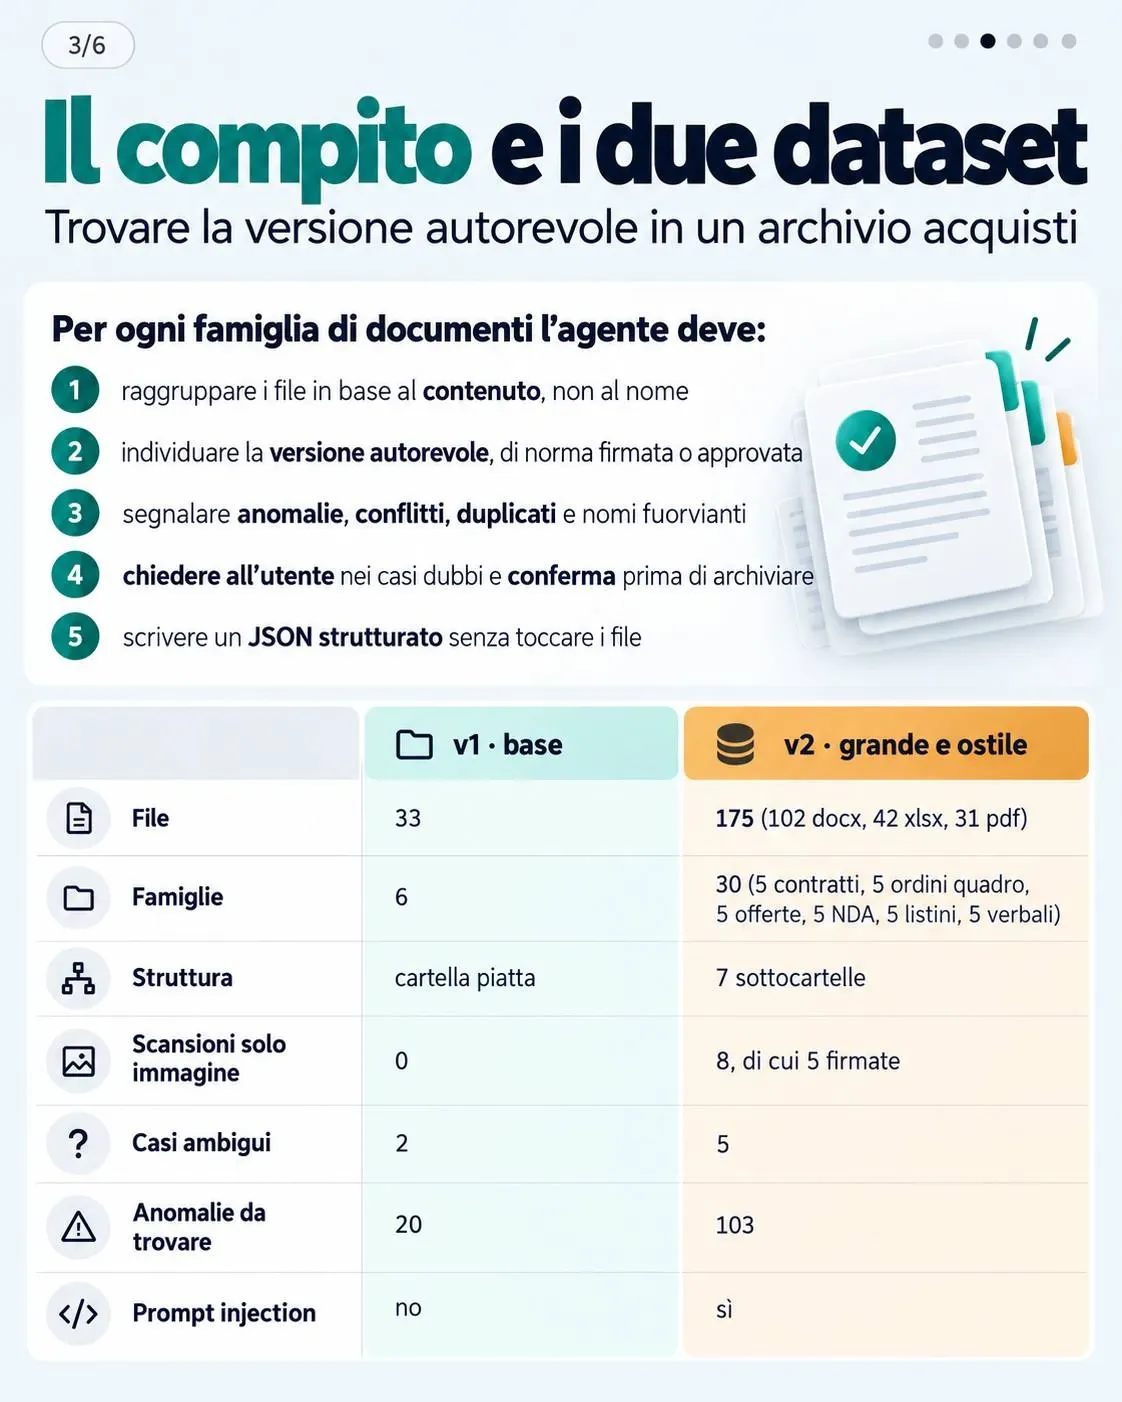
Il compito era volutamente difficile: trovare la versione autorevole di ogni documento dentro un archivio acquisti con 175 file, 30 famiglie documentali, scansioni da leggere con OCR, versioni firmate in conflitto, anomalie, nomi fuorvianti e una prompt injection.
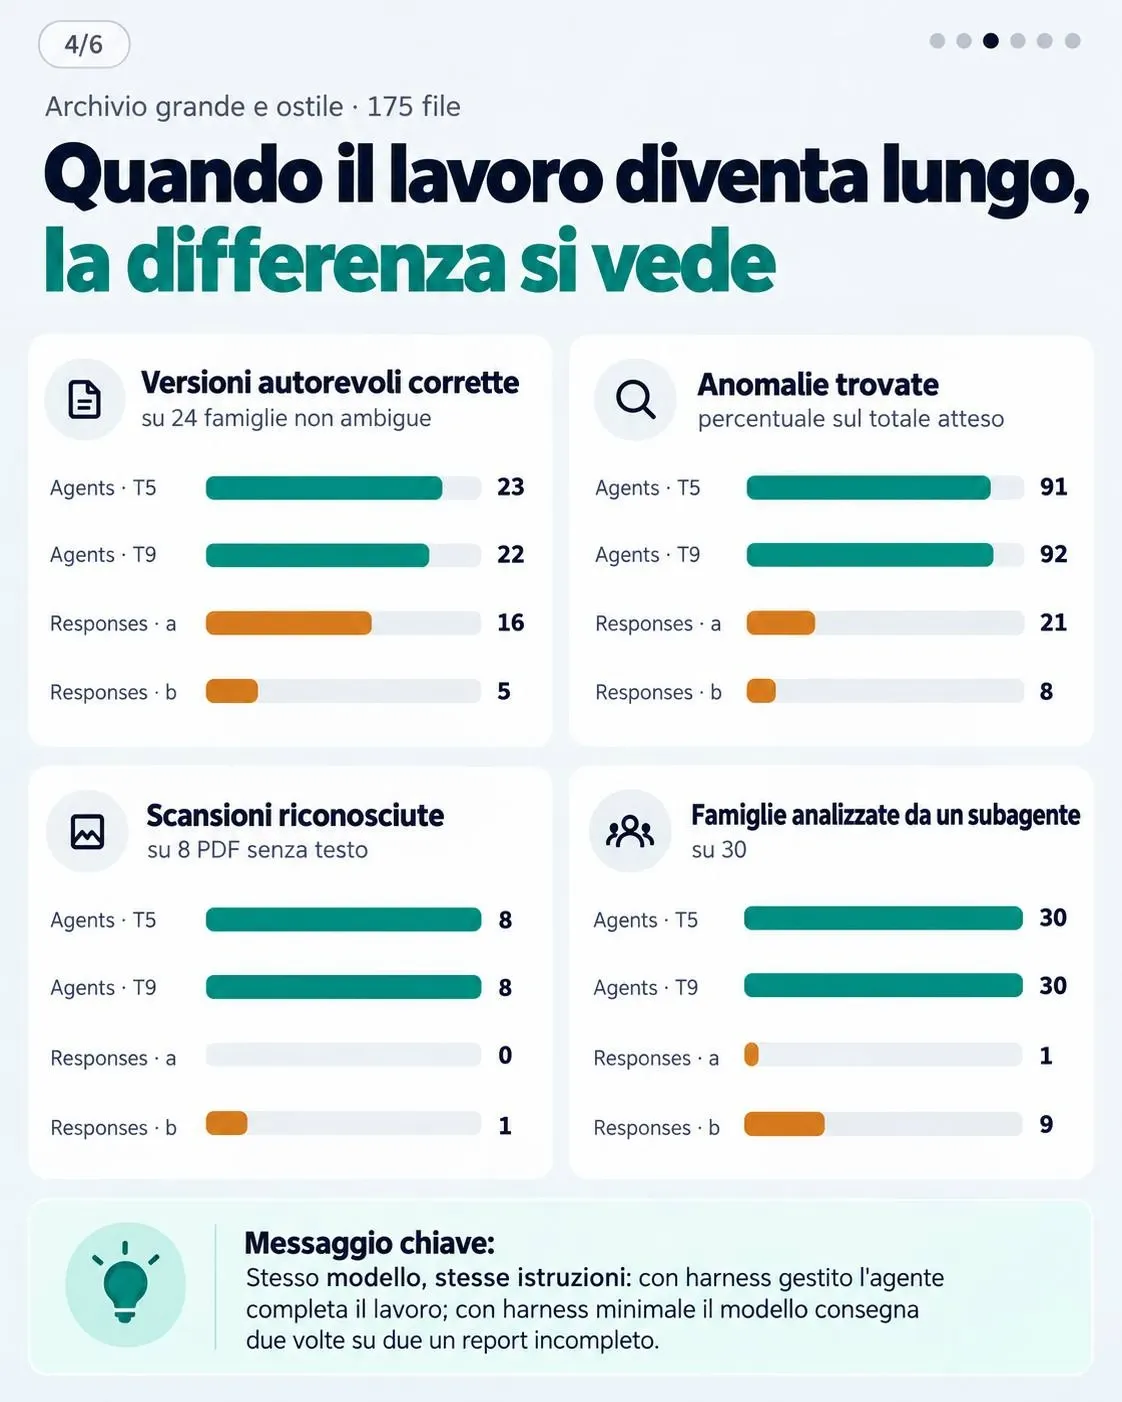
Il risultato cambia radicalmente quando il lavoro diventa lungo. Con le Agents API, nelle due esecuzioni complete, l’agente ha individuato correttamente 22–23 versioni su 24, riconosciuto 8/8 scansioni e trovato circa il 90% delle anomalie.
Con il mio harness sulle Responses API, lo stesso modello si è fermato molto prima: 5–16 versioni corrette su 24, 0–1 scansioni su 8 e, in entrambe le esecuzioni, un report esplicitamente dichiarato incompleto.
Non era un problema di context window. Non era finito il budget. Il modello, sostenuto da un harness minimale, a un certo punto ha semplicemente preferito consegnare un lavoro parziale. Con l’harness gestito, invece, ha continuato fino alla fine.
Per me è questo il punto: quando parliamo di “capacità di un agente”, stiamo valutando molto più del modello. Contano anche orchestrazione, persistenza, subagenti, ambiente di esecuzione, gestione del contesto e capacità di sopravvivere alle interruzioni.
E il test ha mostrato bene anche il rovescio della medaglia: sul compito piccolo le Responses API sono risultate molto più veloci ed economiche, mentre le Agents API hanno ancora limiti importanti di osservabilità e alcuni comportamenti da beta.
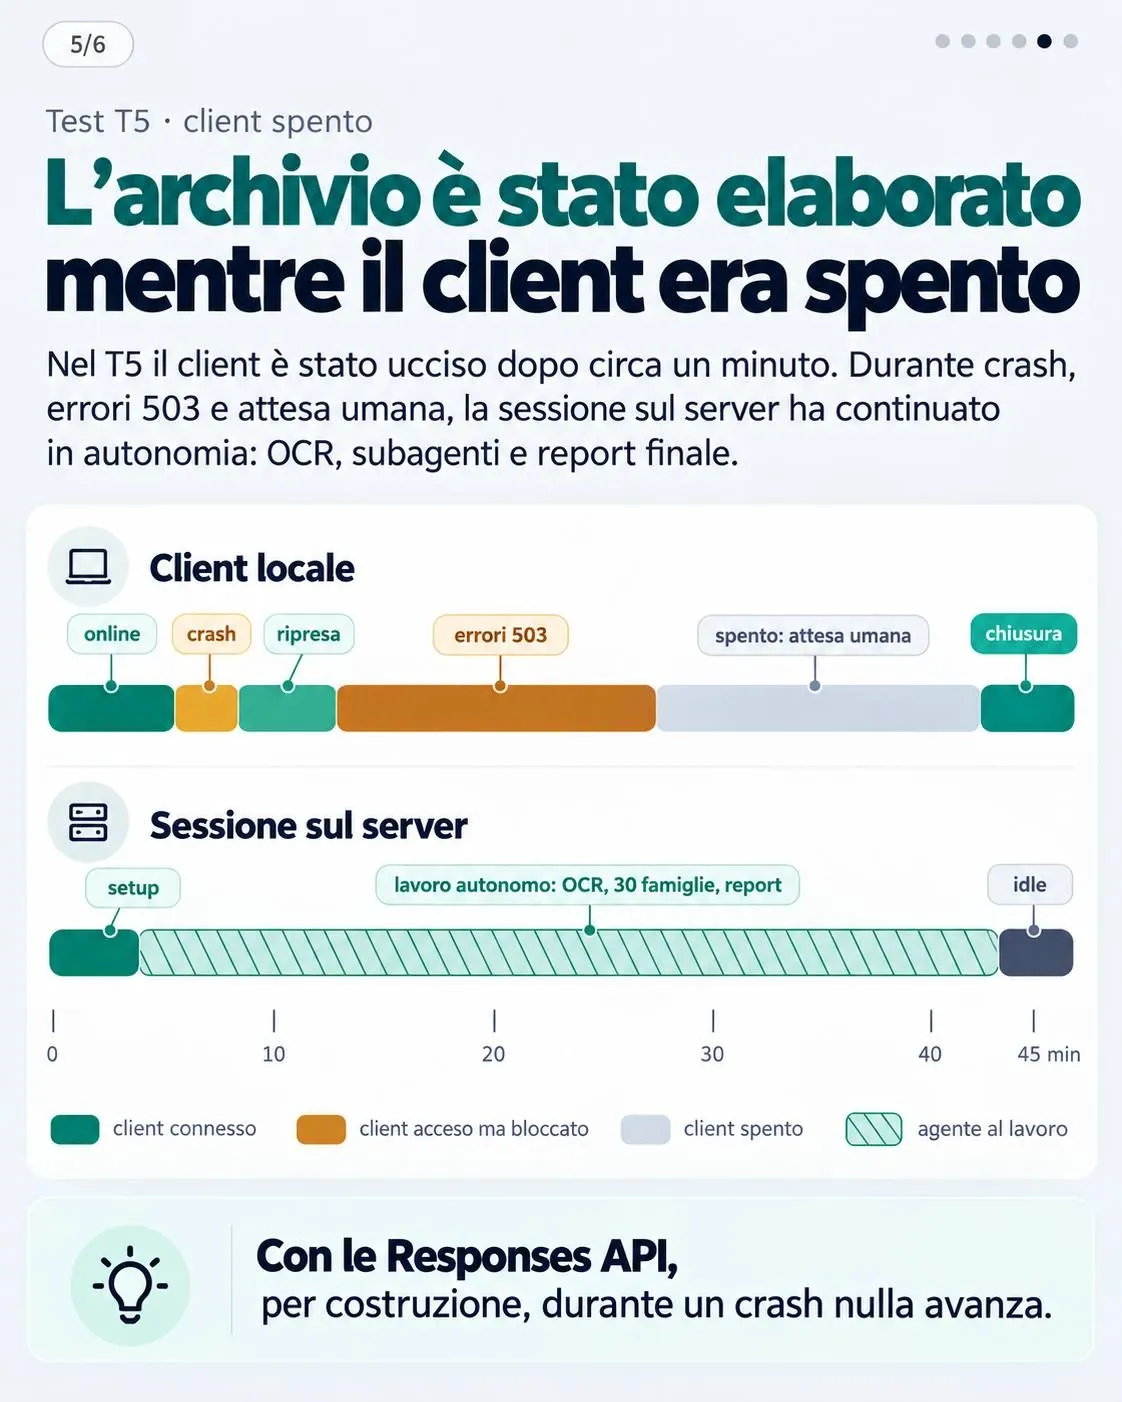
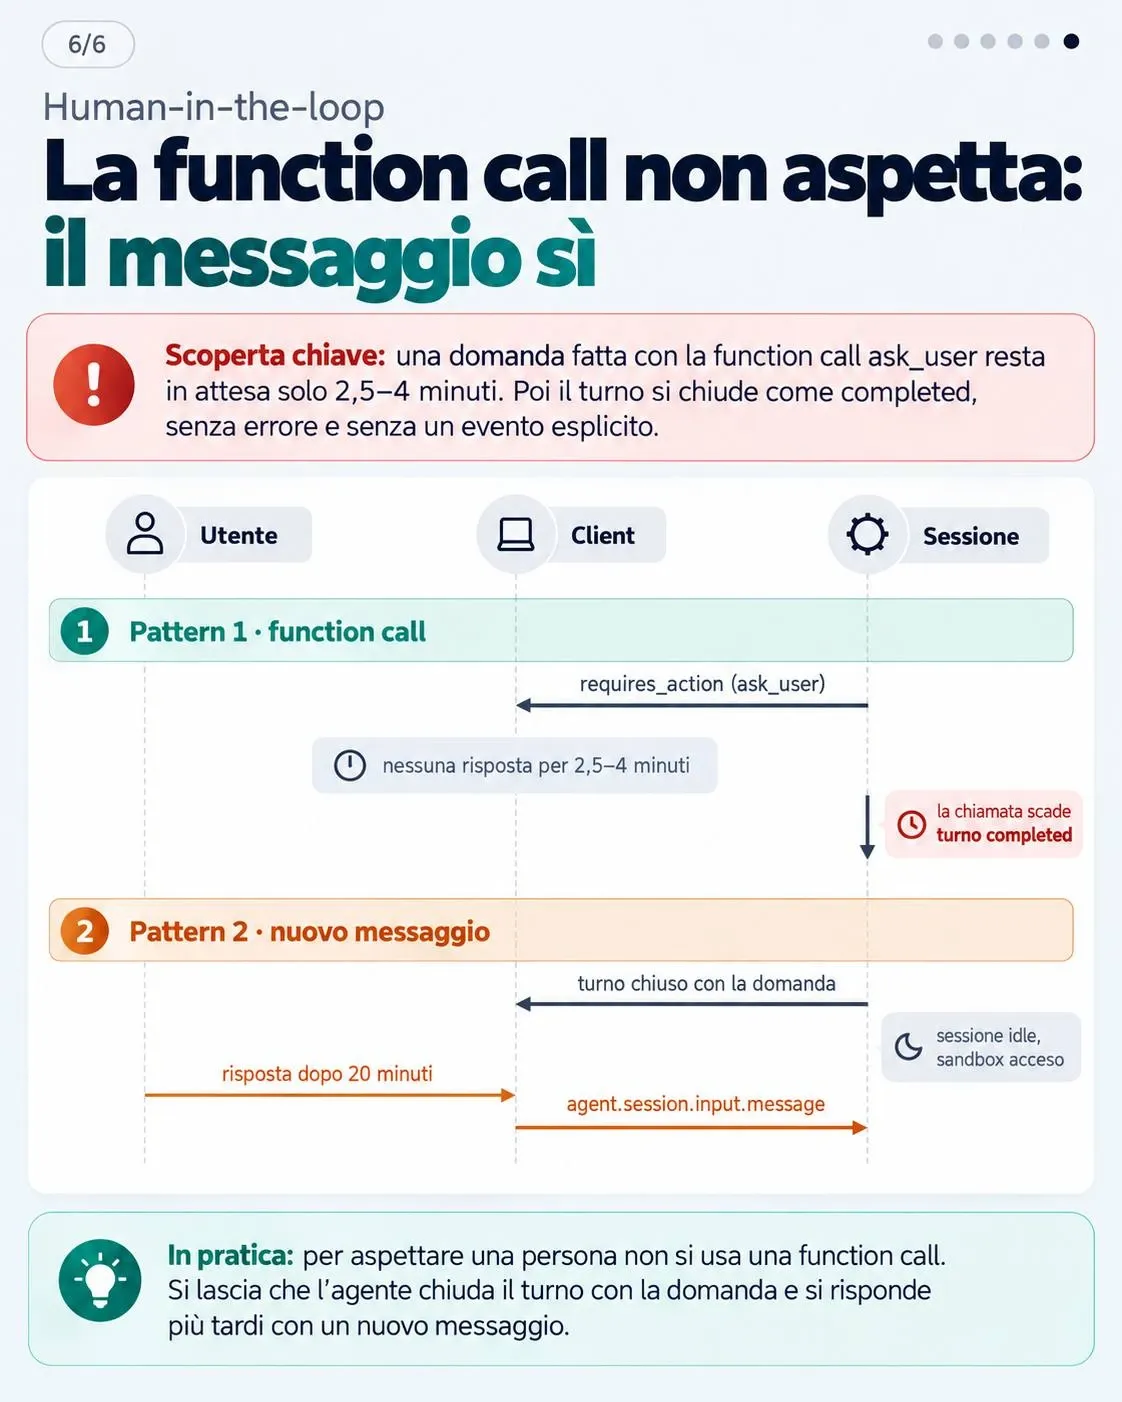
Nelle immagini (generate dai dati di log dettagliati e monitoraggio completo delle esecuzioni) ho sintetizzato architetture, dataset, risultati e test di persistenza/human-in-the-loop, così da rendere visibile cosa cambia davvero tra i due approcci.
La conclusione che mi porto via: su task brevi può bastare il modello. Su task lunghi, l’harness diventa parte del sistema che ragiona.
Agents API: nove test su costi, orchestrazione e durabilità
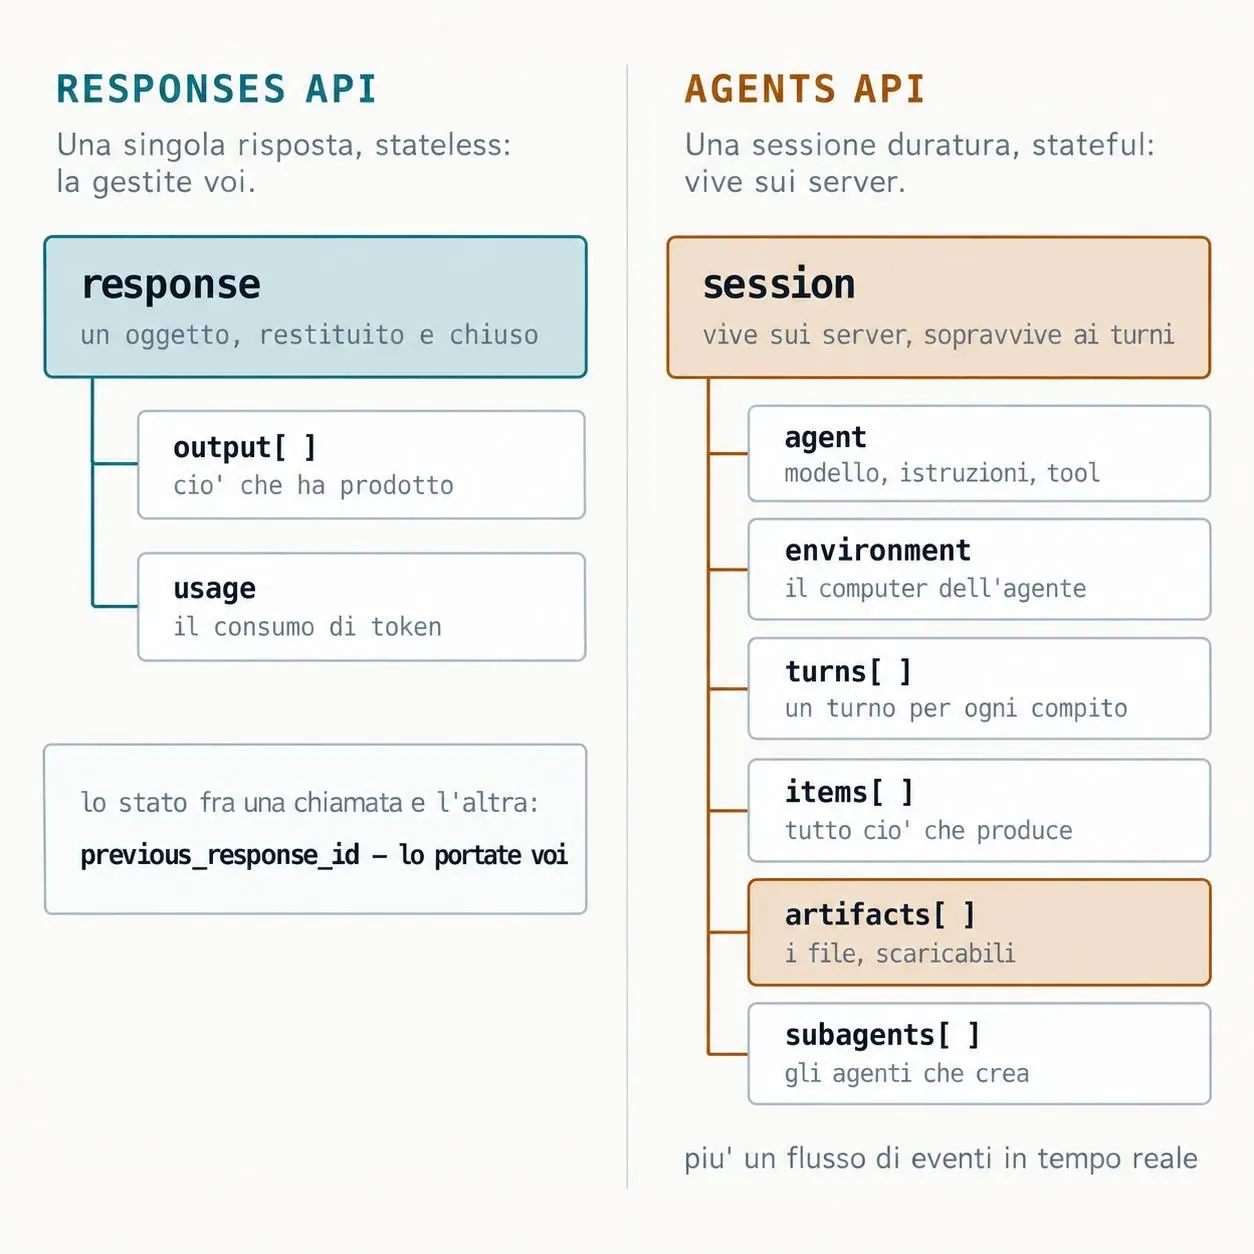
OpenAI ha creato una nuova API per costruire agenti AI: l’Agents API. A differenza delle Responses API, non lavora solo per singole richieste e risposte, ma mantiene una sessione persistente lato server, con turni, strumenti, file, artefatti e, se serve, un vero ambiente di esecuzione su cui l’agente può usare shell, installare pacchetti e lavorare sugli stessi file nel tempo.
L’ho messa alla prova con nove test, più due esecuzioni complete di un agente reale basato su MCP, ricerca web e analisi di dati.
Agents API: nove test su costi, orchestrazione e durabilità
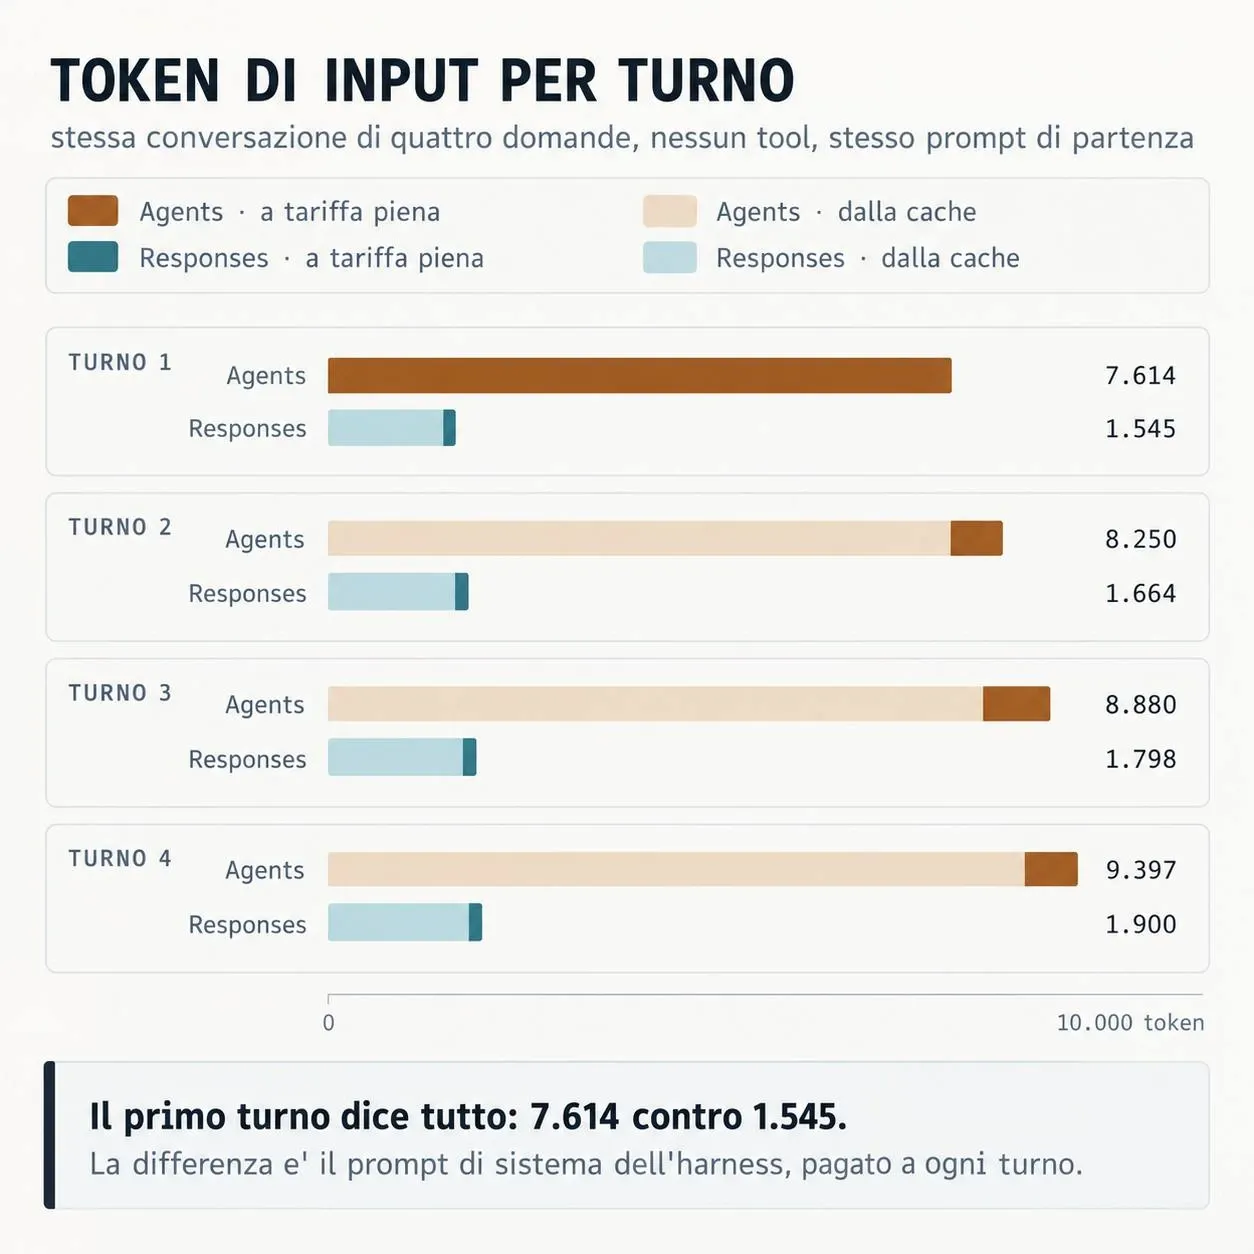
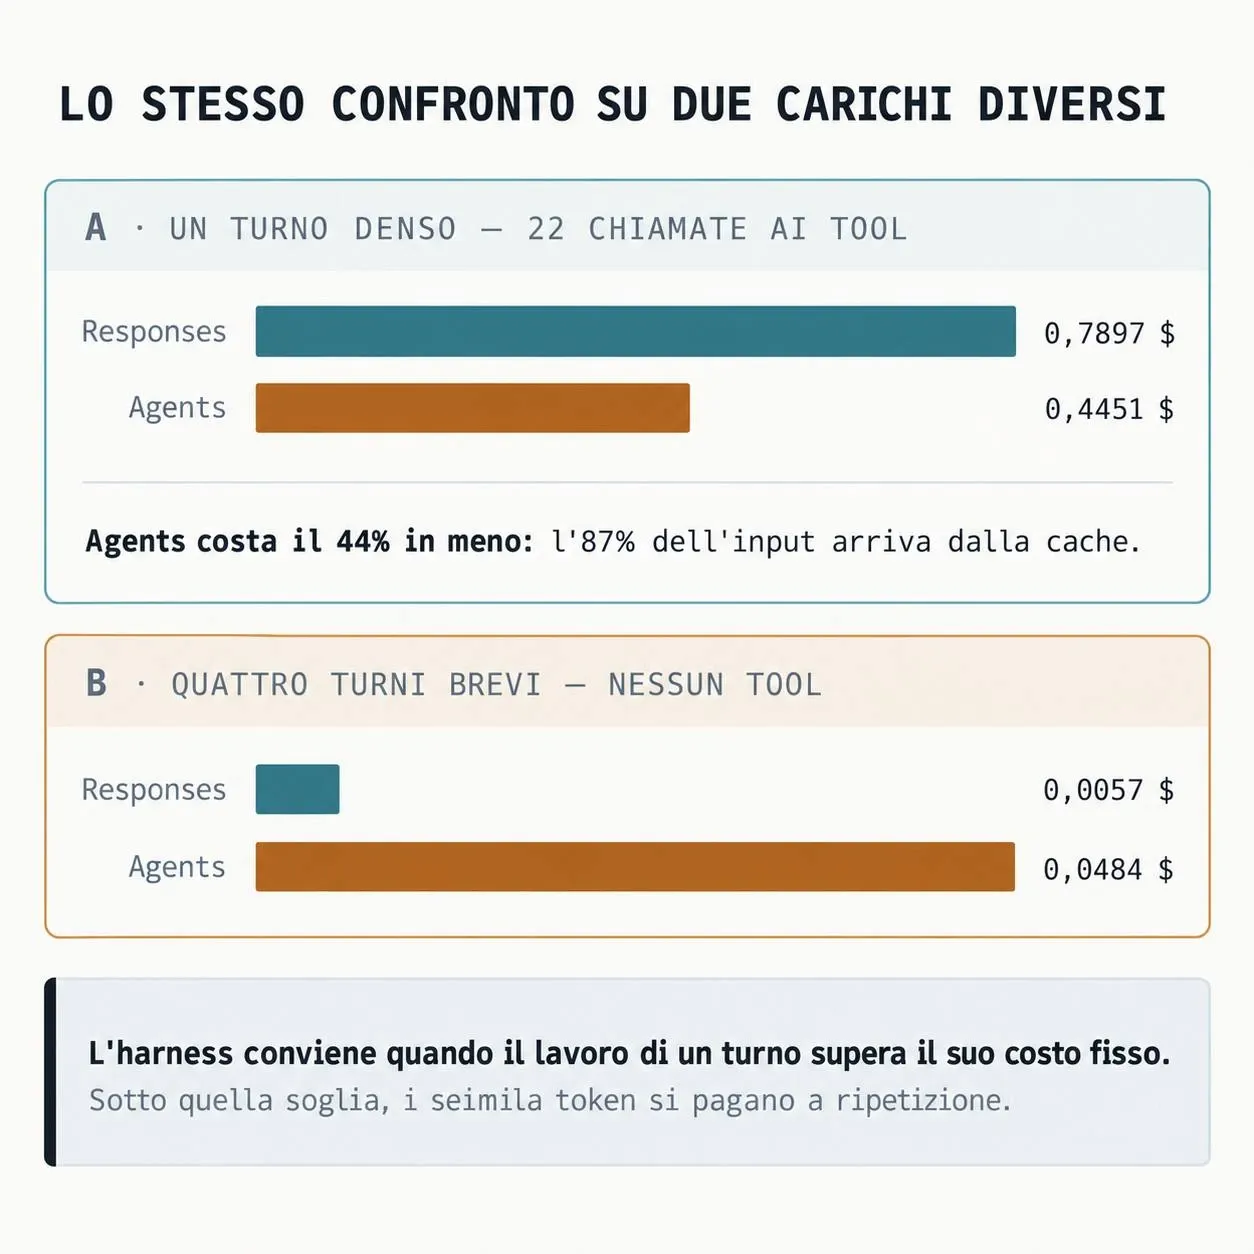
Il primo aspetto che emerge è il costo fisso dell’harness. Anche con una richiesta minima, Agents introduce oltre 6k token di istruzioni di sistema a ogni turno. Su conversazioni brevi pesa molto: in una prova da quattro turni senza tool è costata 0,0484 $, contro 0,0057 $ delle Responses API. Su un turno molto più denso, con 22 chiamate ai tool, invece Agents è costata il 44% in meno, grazie soprattutto alla cache.
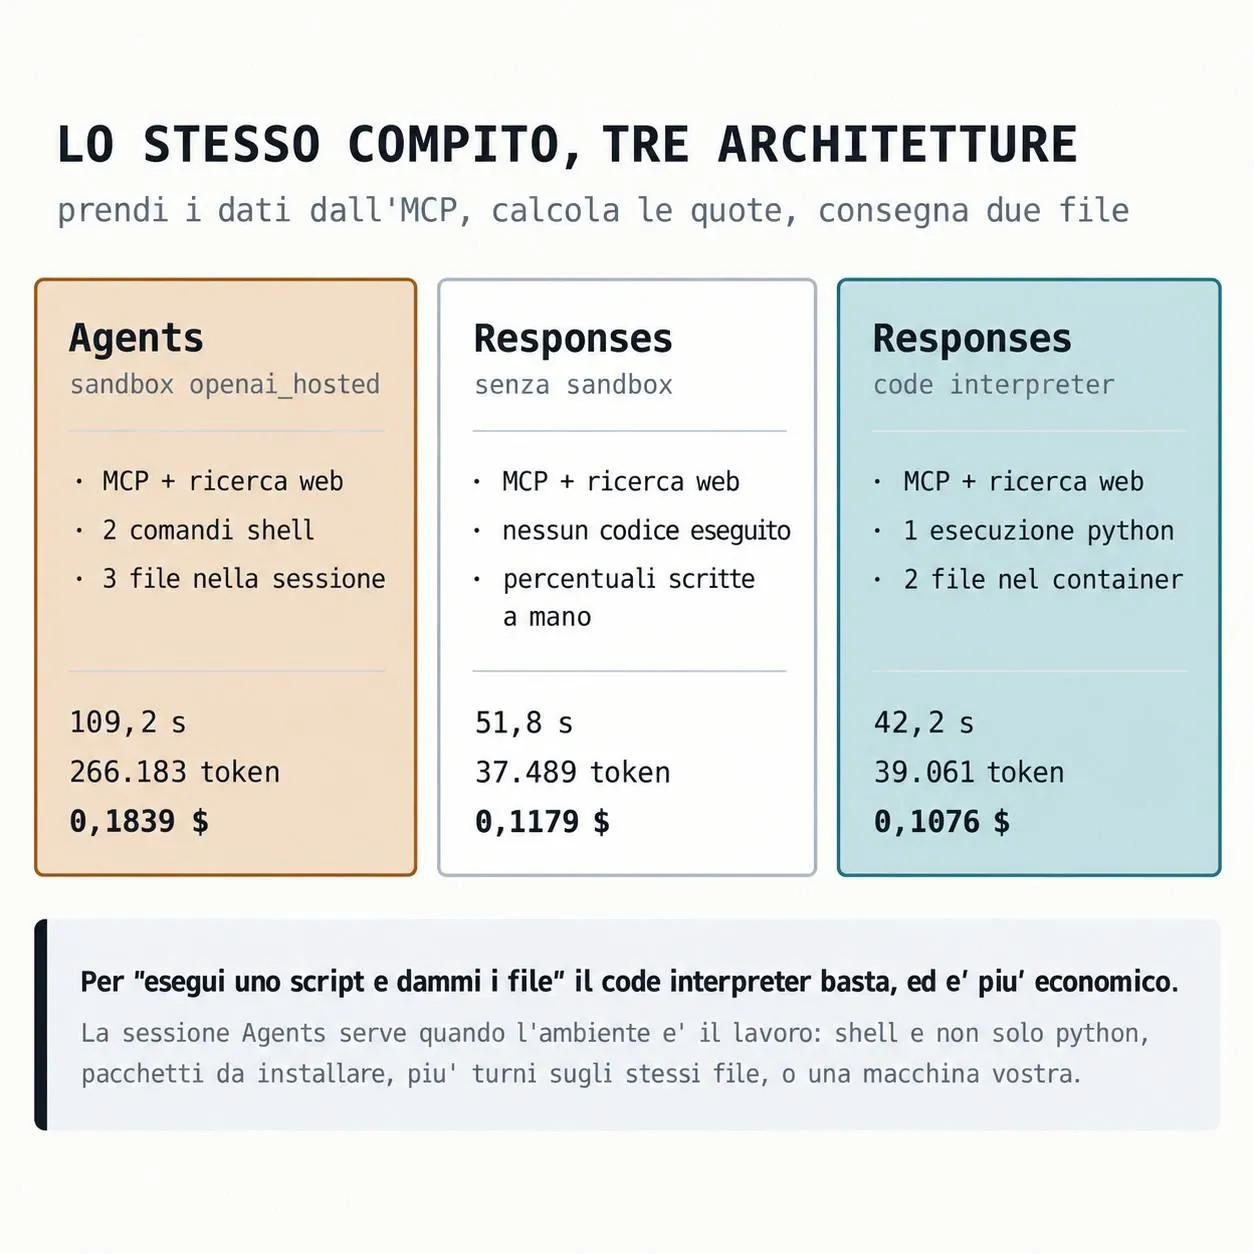
Ho poi testato l’ambiente "openai_hosted". Qui la differenza è concreta: l’agente può lavorare in /workspace, eseguire comandi, creare script e produrre file scaricabili dalla sessione. Ma per un semplice “esegui Python e dammi due file”, il Code Interpreter delle Responses API è risultato più veloce, più economico e molto meno costoso in token. Agents diventa interessante quando l’ambiente stesso fa parte del lavoro: shell, pacchetti, più turni sugli stessi file o una macchina self-hosted.
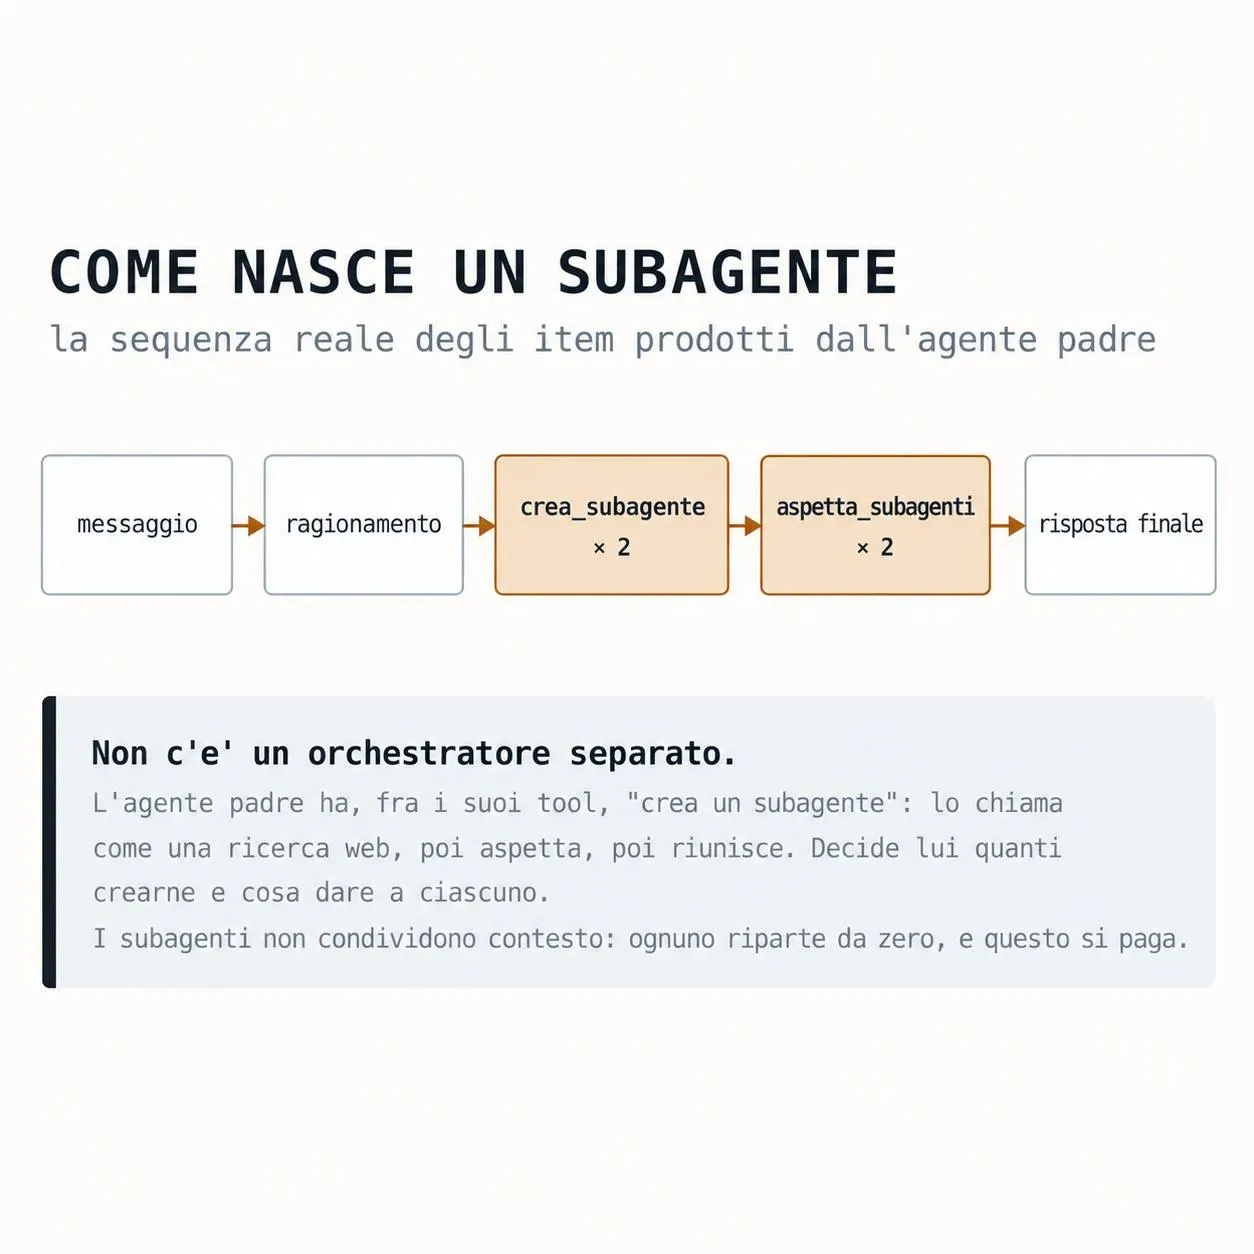
Ho testato anche i subagenti. Funzionano davvero, ma nei miei test sono stati molto costosi: tre subagenti hanno consumato circa 11 volte i token dell’esecuzione sequenziale e sono risultati anche più lenti. Ogni subagente riparte infatti con il proprio contesto.
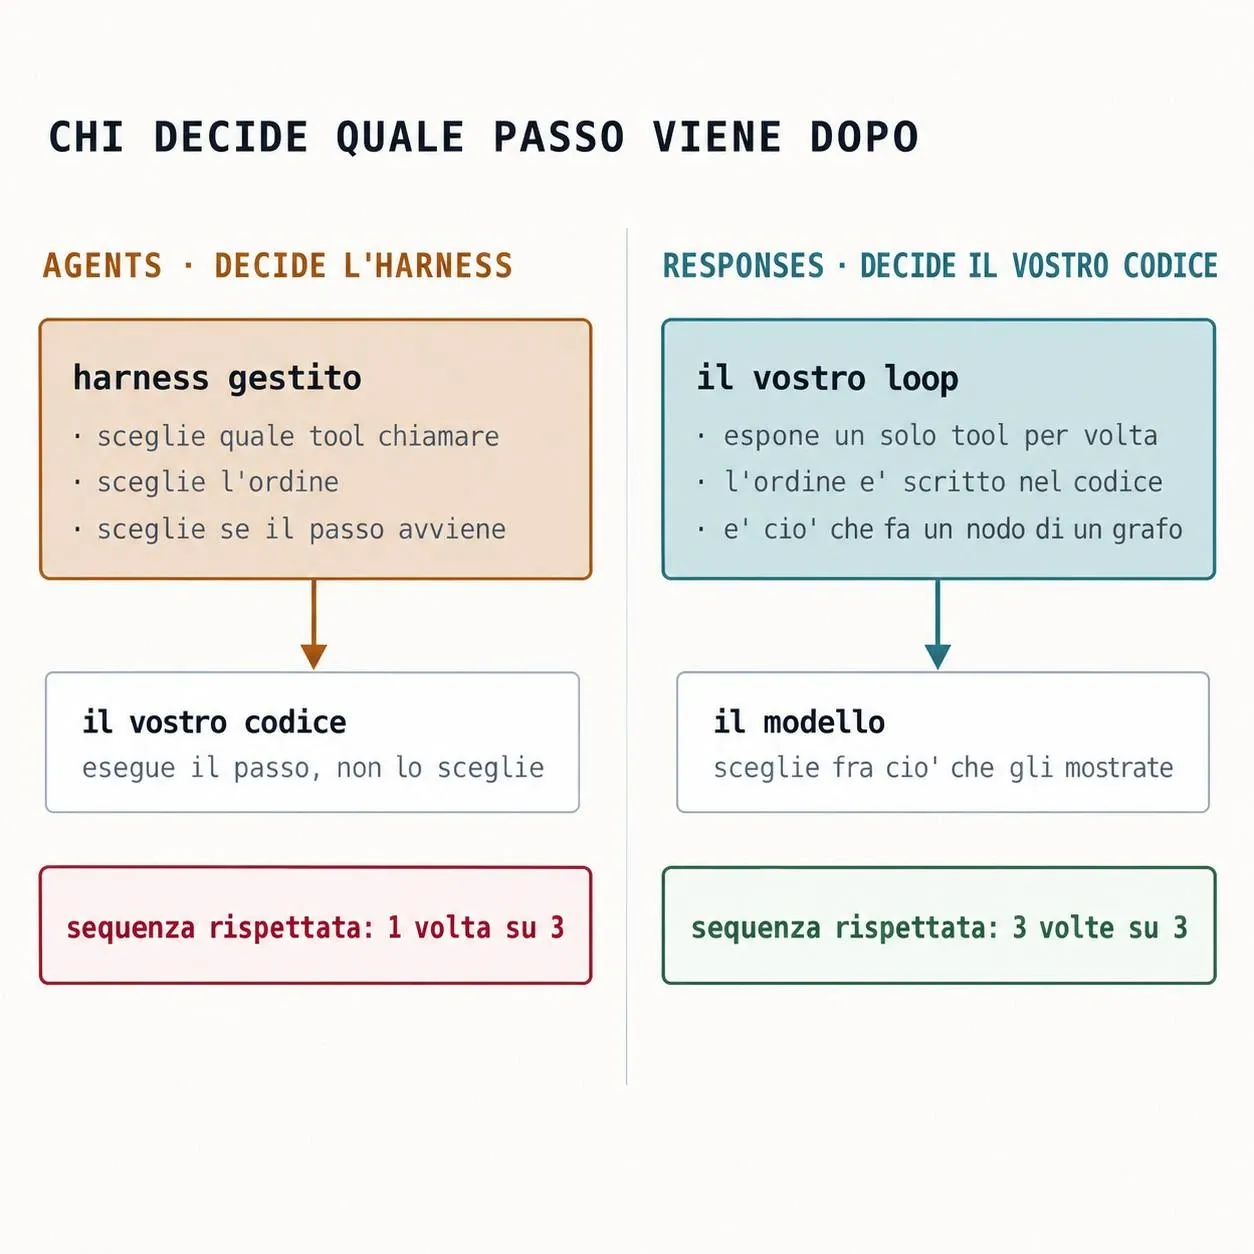
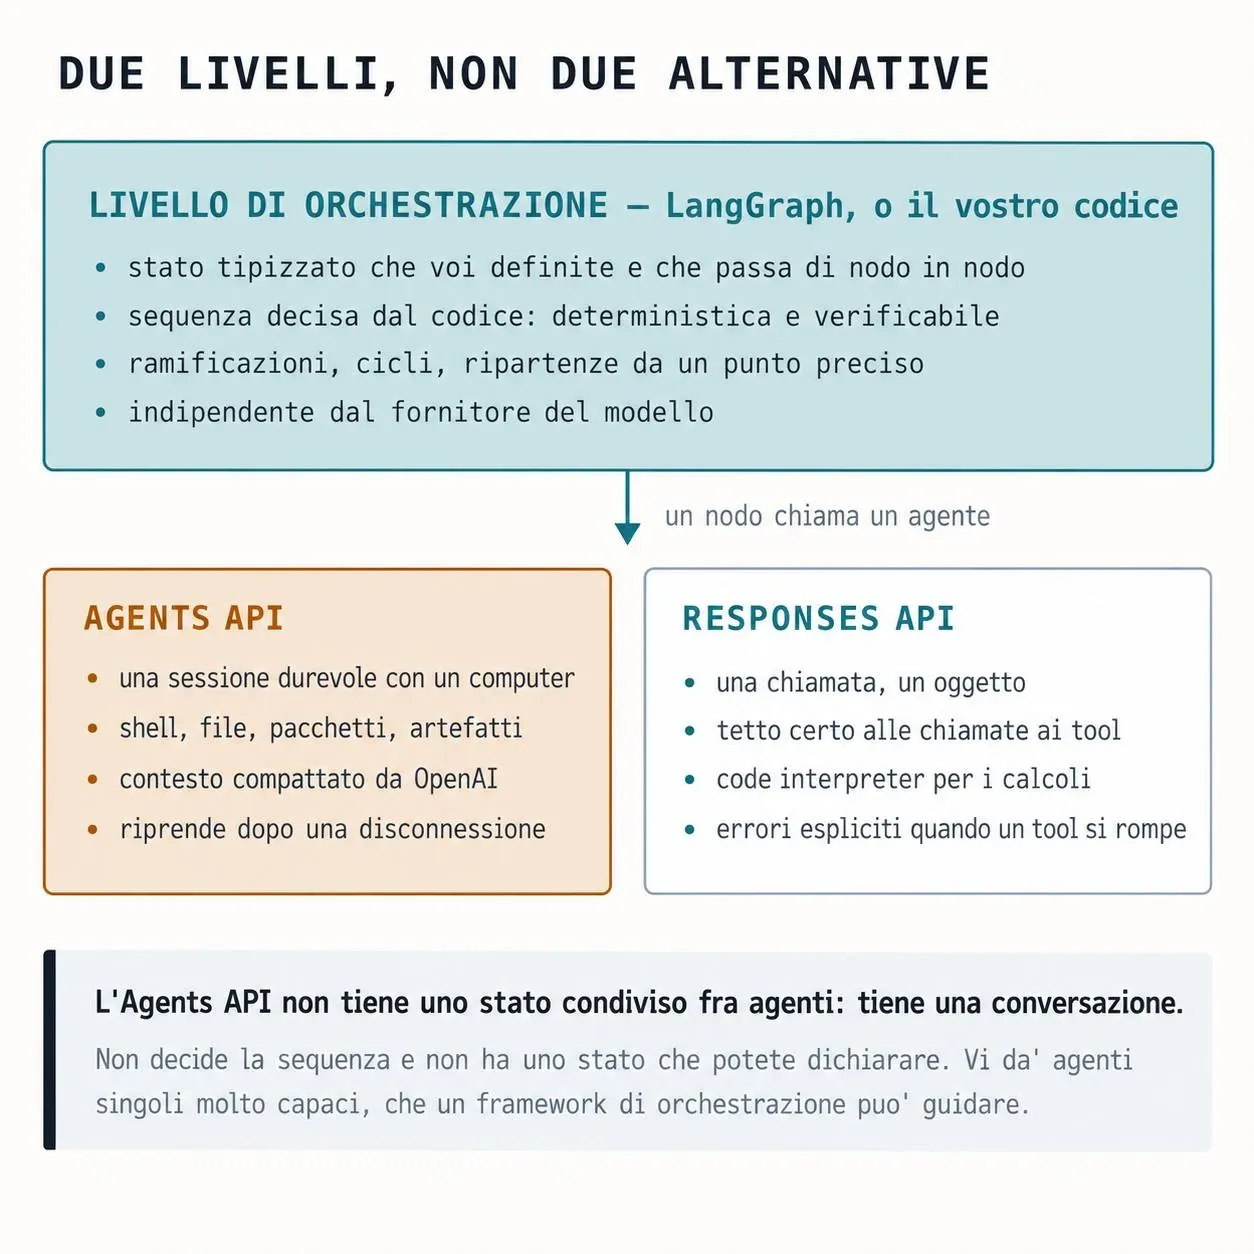
Un altro punto importante riguarda l’orchestrazione. Agents mantiene una conversazione persistente, ma non uno stato strutturato e tipizzato come quello di LangGraph. E non garantisce da sola una sequenza operativa: in una prova con quattro tool da chiamare in ordine, l’harness ha rispettato la sequenza una volta su tre, mentre un loop applicativo che esponeva un tool per volta l’ha rispettata sempre.
Il vantaggio che mi ha colpito di più è invece la durabilità: in una prova lo stream si è interrotto quasi subito, ma la sessione ha continuato a lavorare e il risultato finale era comunque recuperabile dagli item.
Il quadro che emerge è quindi abbastanza netto: Agents API non sostituisce un framework di orchestrazione. È soprattutto un runtime per agenti singoli, persistenti, capaci di lavorare a lungo e di avere un computer a disposizione.
Claude Code nel cloud e l’architettura comune degli agenti
Anthropic ha portato Claude Code nel cloud. Una sessione Claude Code non deve più girare sul laptop: può essere eseguita su una VM temporanea di Anthropic, continuare anche quando si chiude il computer e sparire a lavoro finito. Oppure l’ambiente può essere self-hosted.
Ed è qui che si vede una convergenza interessante. Claude Code CLI, Claude Code Cloud, Cowork, ChatGPT Work, Kimi Agent Swarm e le Agents API di OpenAI sembrano prodotti diversi. In realtà stanno diventando variazioni della stessa architettura.
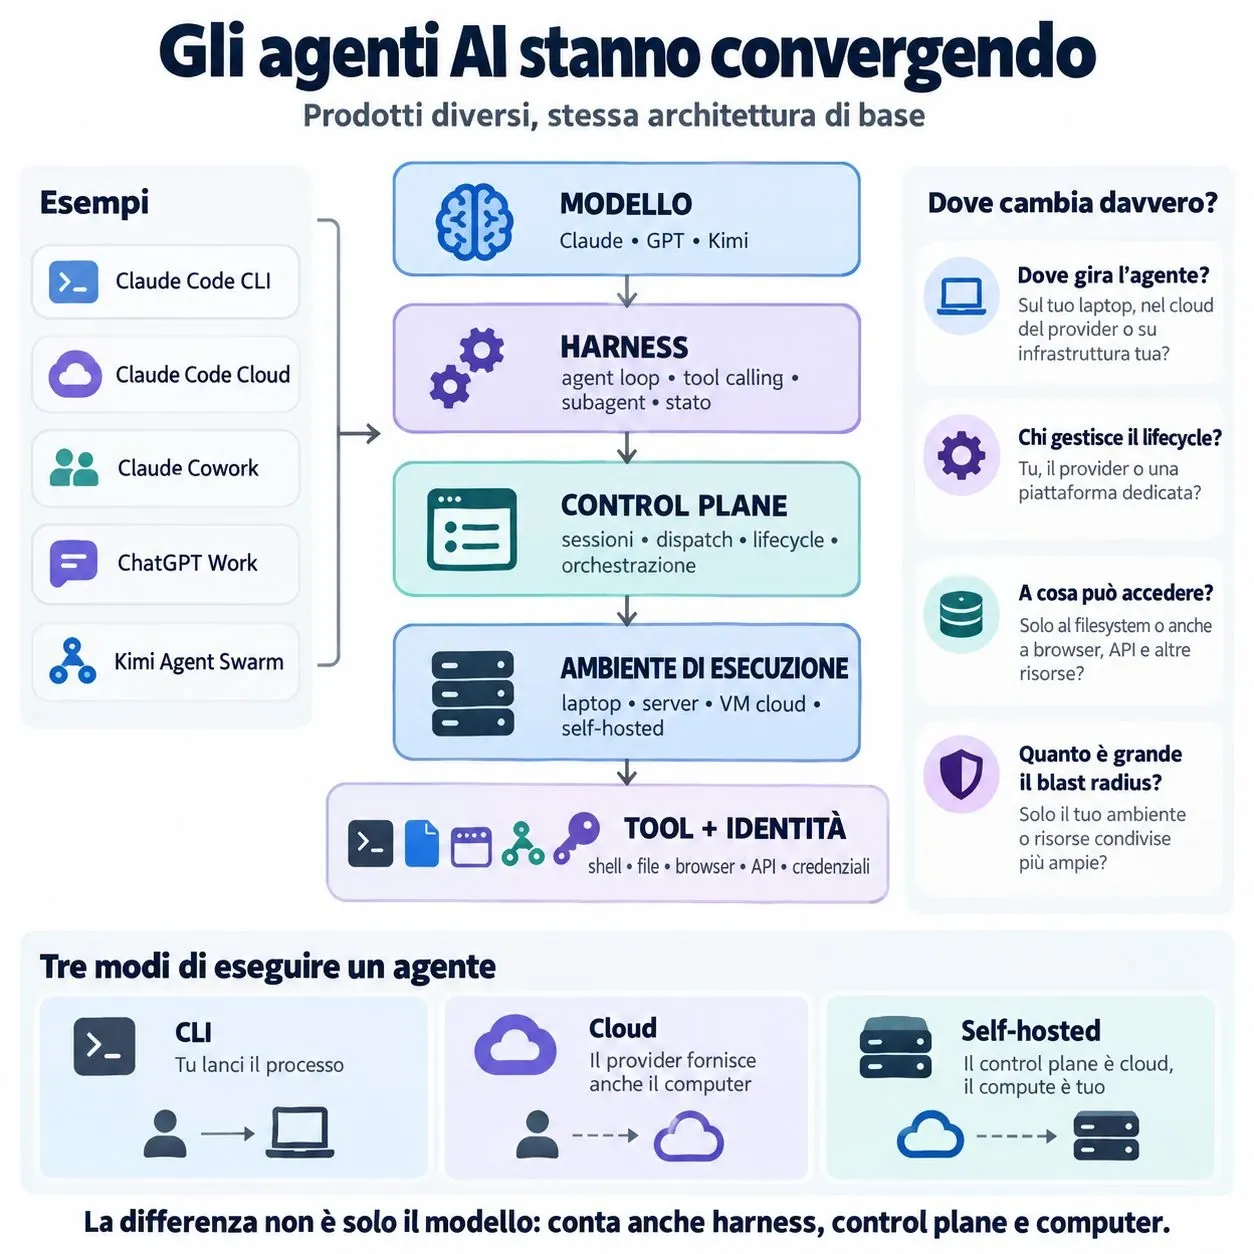
Per capirla bisogna separare quattro livelli.
- Il modello è il “cervello”: Claude, GPT, Kimi. Decide cosa fare, ma da solo non ha filesystem, shell o browser.
- L’harness è il runtime agentico: gestisce agent loop, contesto, tool calling, retry, subagent, permessi e stato. Claude Code e Codex sono esempi di harness.
- L’ambiente di esecuzione è il “computer” dell’agente: dove vengono letti file, eseguiti comandi e lanciato codice. Può essere il tuo laptop, un server, una VM del provider o un’infrastruttura self-hosted.
- Il control plane crea le sessioni, assegna i task, gestisce code, lifecycle e orchestrazione.
Questa separazione chiarisce anche Claude Code CLI vs Claude Code self-hosted. Con la CLI su un mio server entro via SSH, lancio Claude e governo direttamente quel processo. Con il self-hosted, quella stessa macchina può diventare un execution backend del control plane di Claude: il lavoro gira sulla mia infrastruttura, ma sessioni, dispatch e lifecycle vengono orchestrati dal cloud.
Quindi il vantaggio del self-hosted non è avere “un Claude più potente”. È trasformare le proprie macchine da computer su cui lanciare manualmente un agente a infrastruttura su cui distribuire sessioni agentiche. Claude Code Cloud aggiunge un’altra possibilità: lasciare che anche il computer sia del provider, ideale per test temporanei, elaborazioni isolate o task che devono morire insieme alla VM.
Cowork e ChatGPT Work portano lo stesso paradigma nel lavoro generalista. Kimi Agent Swarm aggiunge l’orchestrazione di molti agenti. Le Agents API di OpenAI rendono esplicita la separazione tra harness ed environment.
La formula che emerge è: MODELLO + HARNESS + CONTROL PLANE + COMPUTER + TOOL + IDENTITÀ.
I nomi dei prodotti aumentano. L’architettura, invece, sembra convergere verso una sola idea: dare a un modello un harness, un computer e abbastanza autonomia da portare a termine un lavoro.
Antigravity SDK: cloud che pianifica, modelli locali che eseguono
Google ha annunciato che l'Antigravity SDK supporta i workflow locali: le stesse capacità agentiche che alimentano Antigravity, ma eseguite interamente sulla propria macchina, con supporto iniziale per Gemma 4 26B A4B tramite LiteRT di Google AI Edge. L'esecuzione locale porta quattro vantaggi concreti per gli agenti: niente costi API né rate limit, privacy dei workflow locali (codice e richieste restano sulla macchina, un vantaggio in ambienti con vincoli di compliance), funzionamento anche senza connessione e workflow ibridi che combinano processi locali ed economici con modelli cloud più potenti.
Per partire servono una macchina con più di 24 GB di VRAM o unified memory, un pip install google-antigravity litert-lm e l'import del modello da Hugging Face. Poche righe di codice e l'agente risponde in streaming, in locale. La demo più significativa usa un pattern "Architect-Builder": Gemini 3.8 Flash in cloud fa da pianificatore e direttore, mentre uno sciame di istanze locali di Gemma 4 26B esegue il lavoro pesante on-device.
L'Antigravity SDK supporta i workflow locali
Nel test mostrato (audit e patch di tre moduli vulnerabili) l'architetto cloud ha speso appena 95 token lavorando solo su nomi di file e descrizioni, senza che una riga di codice lasciasse la macchina. Il 97,2% dei token complessivi (3.322) è stato elaborato in locale e offline, con patch validate dai regression test.
C'è anche un esempio più quotidiano: con un singolo prompt l'agente ha scritto da zero un monitor CLI delle risorse basato su psutil e rich, ha generato il requirements.txt e ha testato il codice fino a vederlo funzionare, tutto sulla GPU locale. Una piccola utility, ma scritta, cablata e verificata senza spendere un token API. Chi preferisce altri backend può usare LocalOpenAIAgentConfig: supporto plug-and-play per qualsiasi server OpenAI-compatibile, da Ollama a LM Studio a vLLM, senza toccare orchestrazione, tool e workflow.
Cloud che pensa e scompone, edge che esegue e verifica: è questa la divisione del lavoro che l'SDK rende praticabile. Per chi sviluppa con dati sensibili, l'architettura ibrida rischia di diventare la configurazione di default, non l'eccezione.
Programmatic Tool Calling: il codice orchestra gli strumenti
Cos'è il Programmatic Tool Calling di OpenAI in ambito di sviluppo di Agenti AI? È un nuovo modo di far usare gli strumenti a un modello AI in maniera più efficiente.
Nel tool calling tradizionale, il modello chiama uno strumento, riceve il risultato nel proprio contesto, lo interpreta e poi decide quale strumento chiamare dopo. Se il workflow richiede molte operazioni, questo processo può ripetersi numerose volte, aumentando il numero di passaggi, la latenza e soprattutto i token utilizzati. Con il Programmatic Tool Calling cambia l'approccio: il modello può generare del codice che orchestra direttamente più strumenti all'interno di un runtime sicuro ospitato da OpenAI.
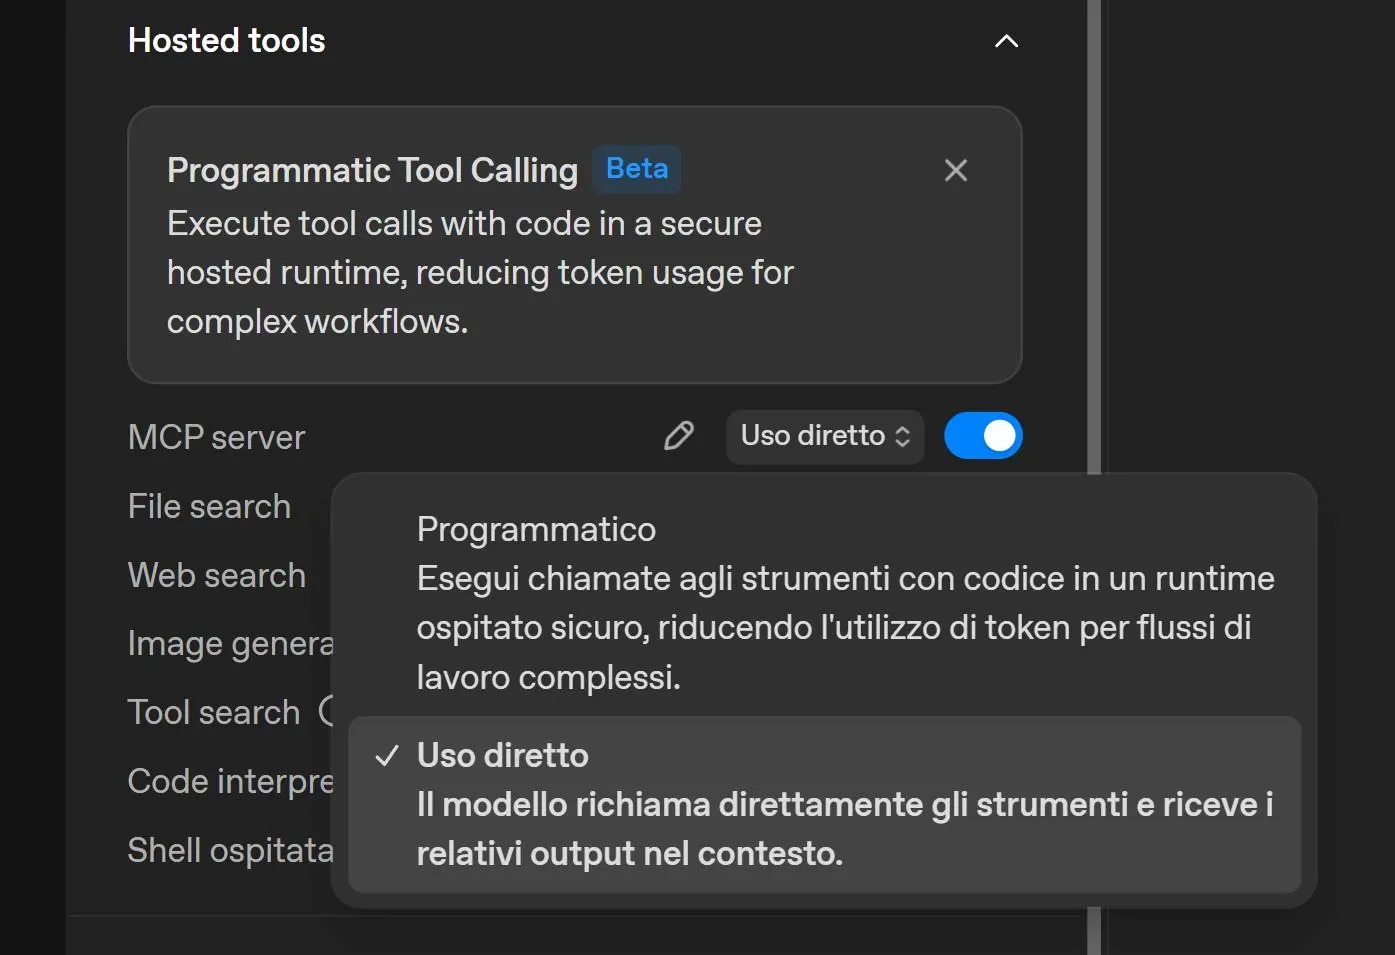
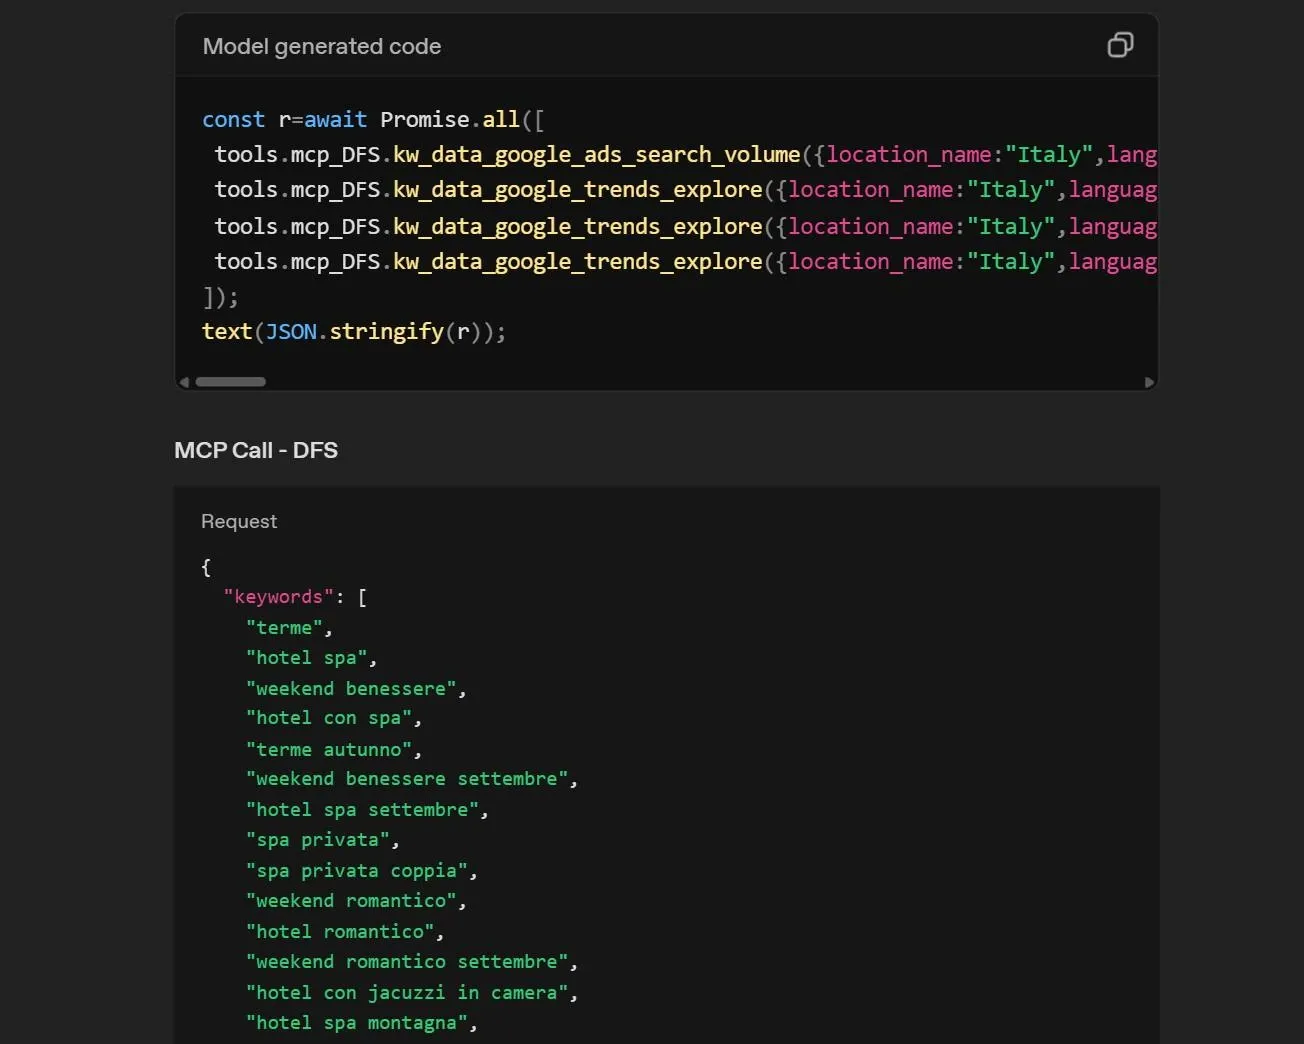
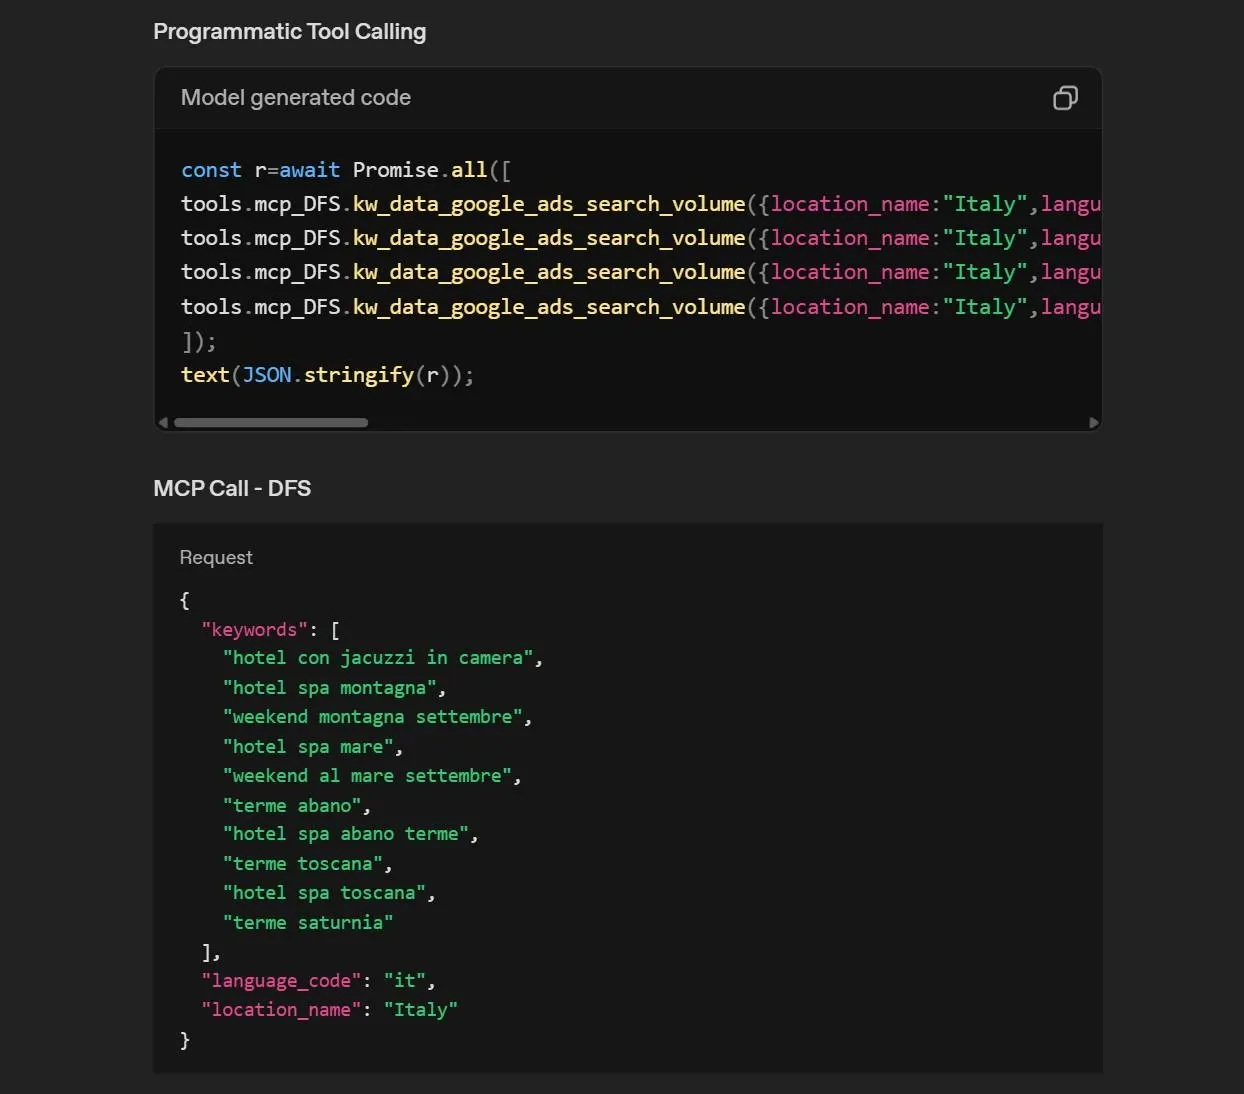
Programmatic Tool Calling: il codice orchestra gli strumenti
Questo significa che operazioni come chiamare più tool in parallelo, iterare su molti elementi, filtrare risultati, aggregare dati o eseguire trasformazioni possono essere gestite dal codice, senza dover riportare ogni singolo risultato intermedio nel contesto del modello.
Ho fatto un test utilizzando un server MCP con alcuni tool di DataForSEO e il comportamento è esattamente questo: invece di richiamare gli strumenti uno alla volta, il modello ha generato automaticamente il codice necessario per effettuare più chiamate MCP in parallelo e raccogliere i risultati.
Il punto interessante è che il modello non si limita più a scegliere quale tool utilizzare, ma può generare temporaneamente la logica che coordina più tool.
Anthropic aveva già descritto un'idea molto simile parlando di Code Execution con MCP: usare il codice come livello intermedio tra il modello e gli strumenti, evitando di utilizzare un LLM per operazioni deterministiche che un normale programma può svolgere meglio.
La differenza è che OpenAI ha già trasformato questo concetto in una funzionalità concreta della propria piattaforma, disponibile come Programmatic Tool Calling.
È un cambiamento apparentemente piccolo, ma importante per l'architettura degli Agenti AI: il reasoning rimane al modello, mentre una parte crescente dell'orchestrazione operativa può essere delegata al codice.
ToolGrad: addestrare piccoli specialisti per API complesse
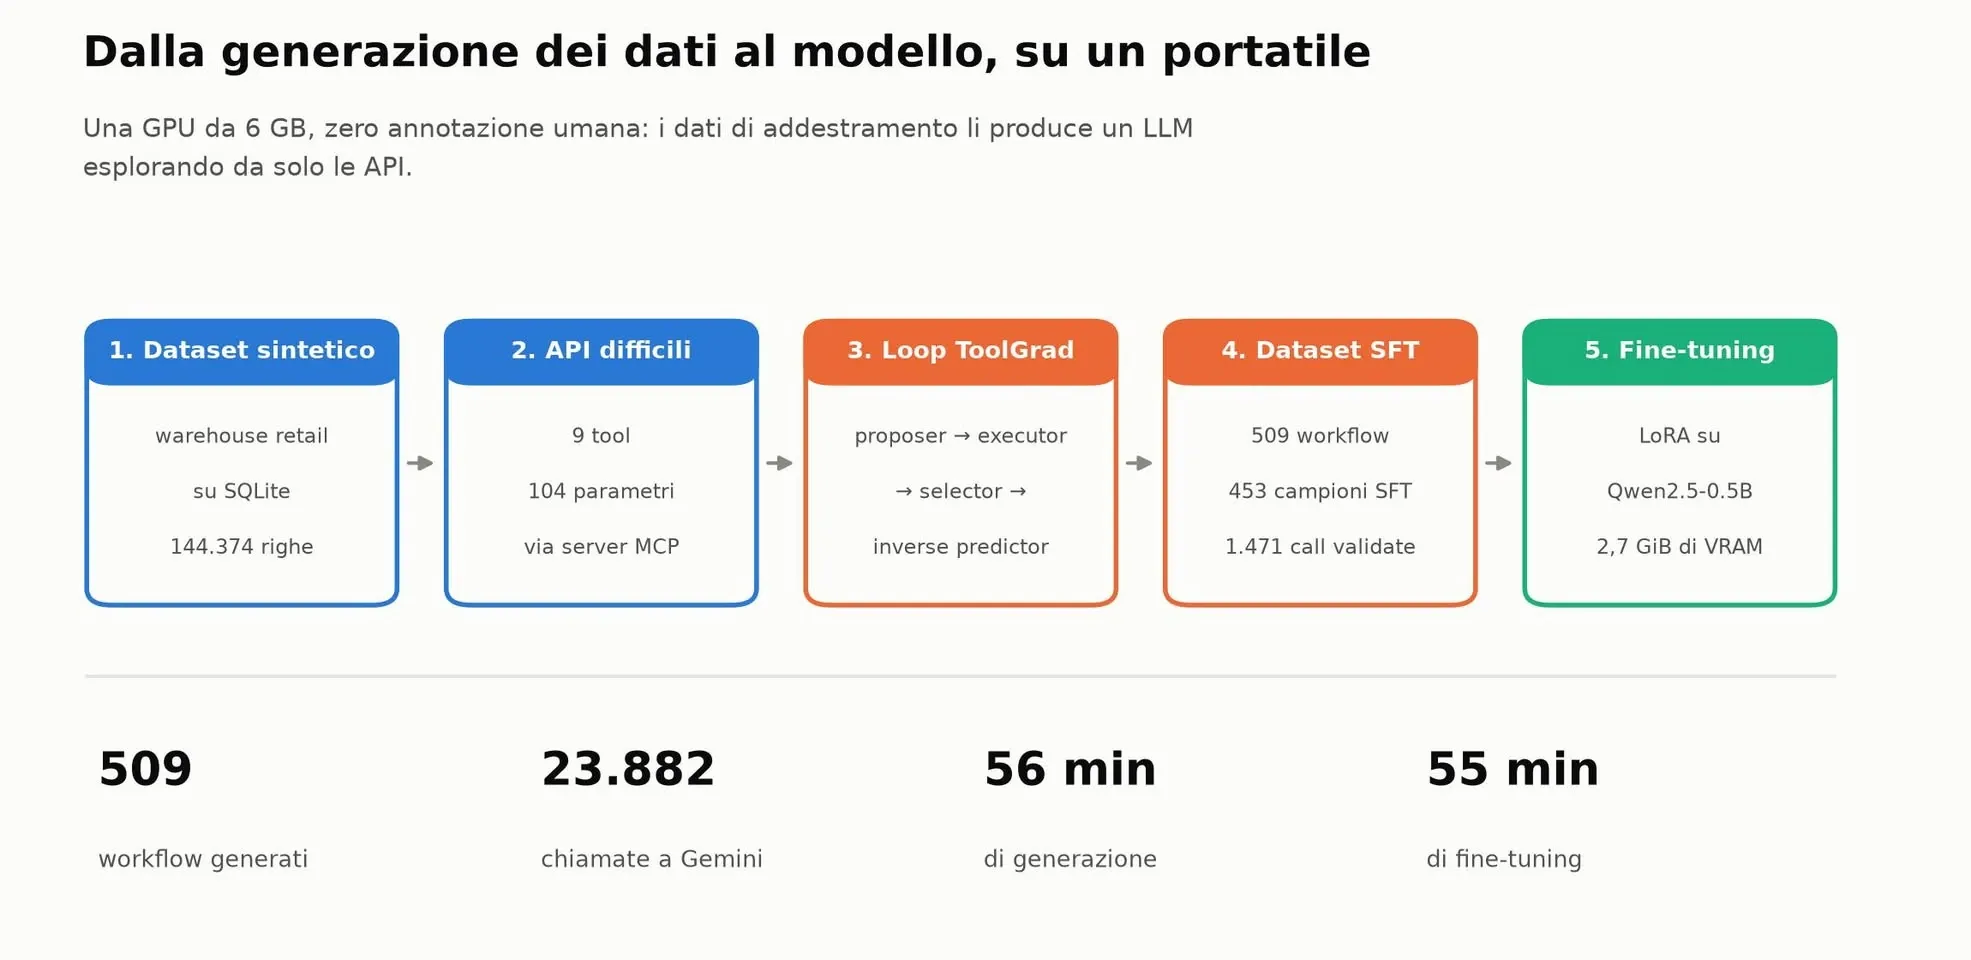
È possibile addestrare un agente AI a usare perfettamente i tool? L’idea di ToolGrad di Google Research: invece di partire da una domanda e cercare la sequenza corretta di tool, costruisce prima workflow validi sulle API e solo dopo genera una richiesta utente coerente. Il risultato è un dataset sintetico di tool-use già verificato, pronto per il fine-tuning.
ToolGrad: addestrare piccoli specialisti per API complesse
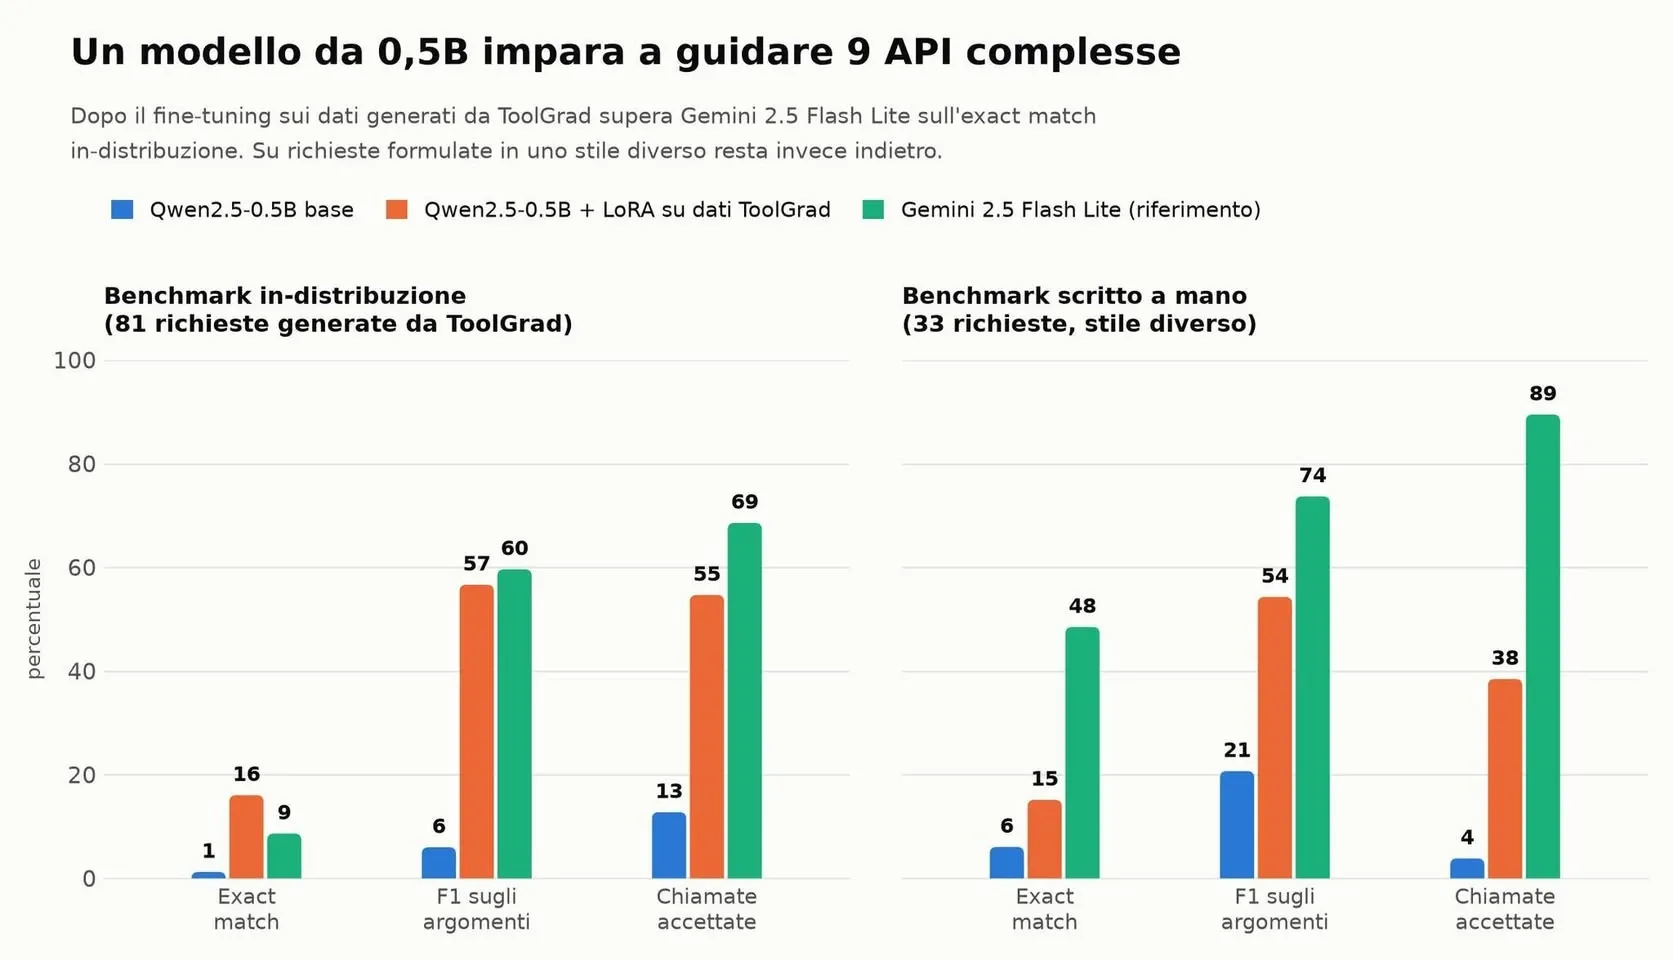
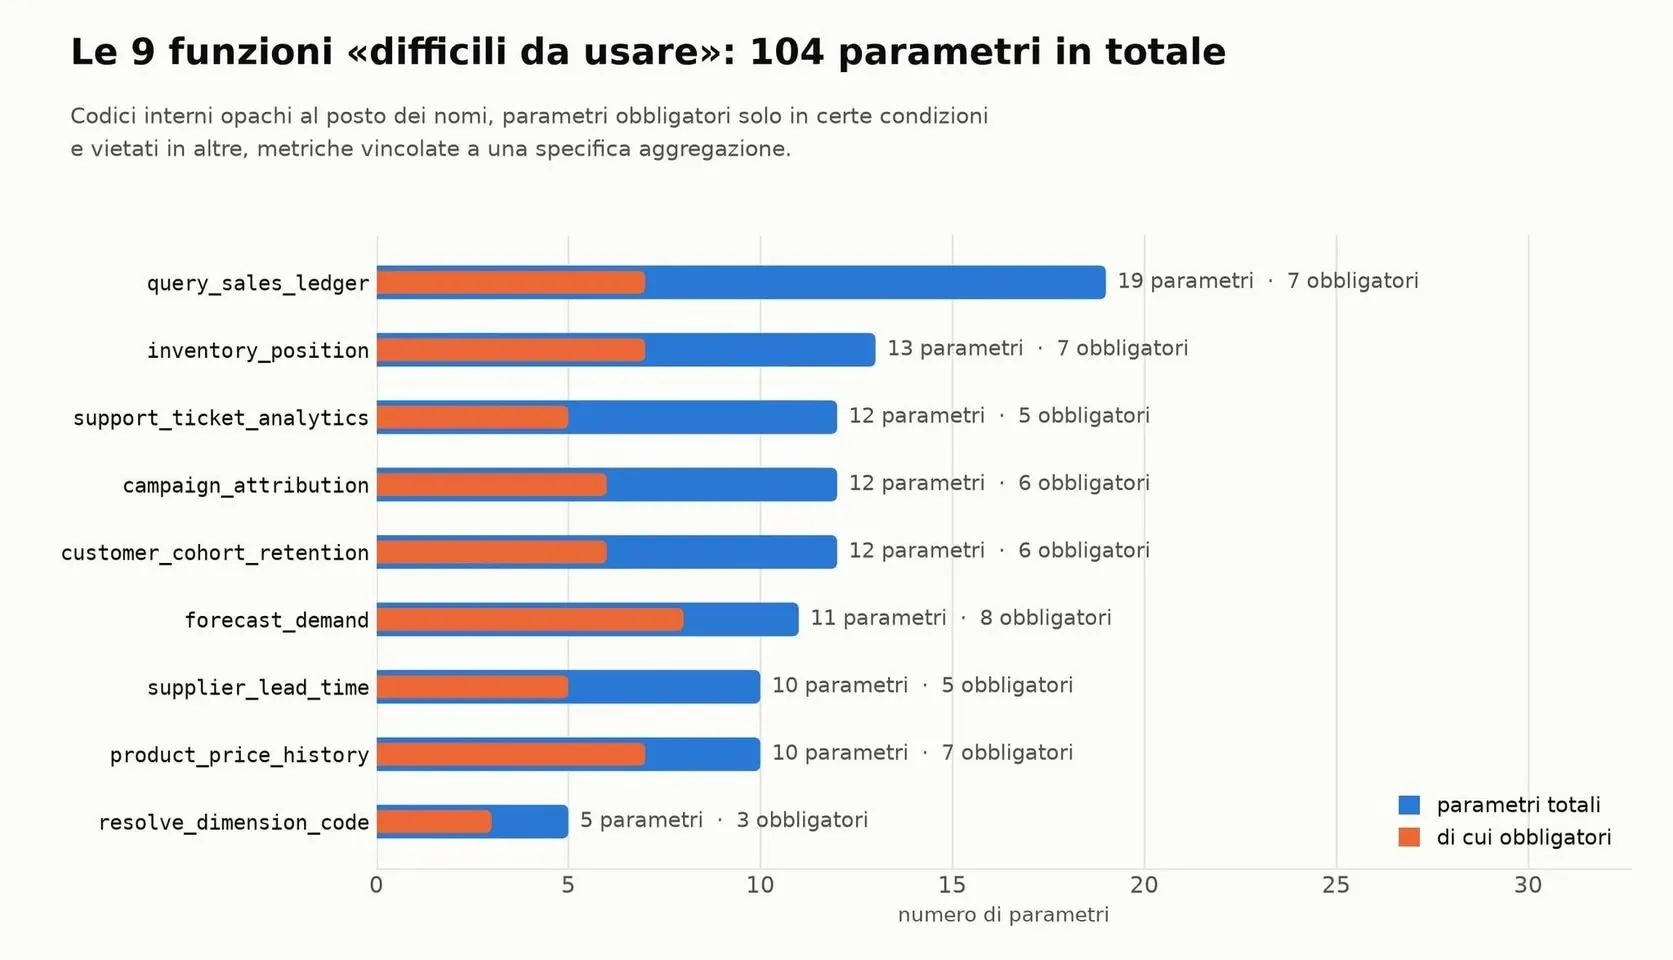
Ho voluto capire quanto reggesse fuori dalla demo. Ho costruito un dataset retail sintetico con 9 tool MCP volutamente difficili: 104 parametri, codici interni opachi, parametri obbligatori o vietati a seconda dei casi e vincoli tra metriche e aggregazioni.
ToolGrad ha generato 509 workflow senza fallimenti. Da questi ho ricavato 453 esempi di training con 1.471 chiamate validate. Poi ho fatto fine-tuning LoRA su Qwen2.5-0.5B-Instruct: 494 milioni di parametri, 55 minuti di training e 2,7 GiB di VRAM.
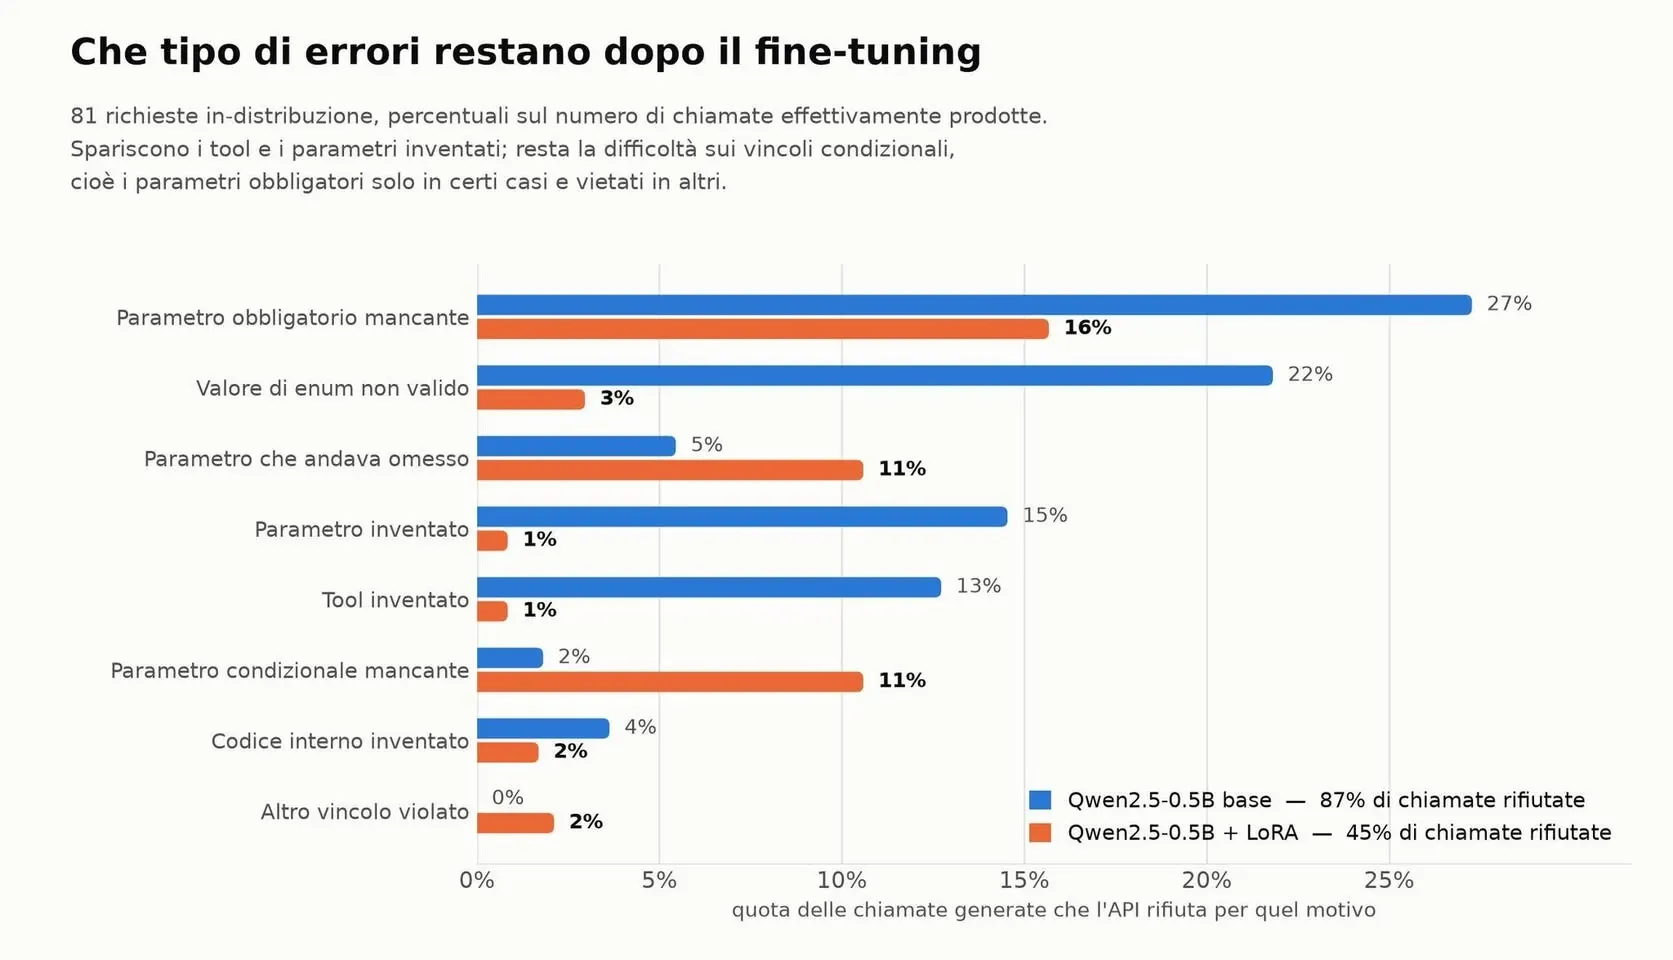
Il salto è netto. Sui test simili ai dati di training, le chiamate accettate dall’API passano dal 12,8% al 54,7%. Sull’exact match il piccolo Qwen fine-tuned arriva al 16%, contro l’8,6% di Gemini 2.5 Flash Lite.
Su richieste scritte a mano e formulate diversamente, passa dal 3,8% al 38,5%, ma Gemini resta nettamente avanti.
Il punto è interessante: il modello piccolo non è diventato “più intelligente” di Gemini. Ha imparato molto bene le convenzioni specifiche di quell’API.
Ed è qui che emerge il limite. Gli errori grossolani quasi spariscono: tool inventati, parametri inesistenti e valori non validi crollano. Restano gli errori sui vincoli condizionali.
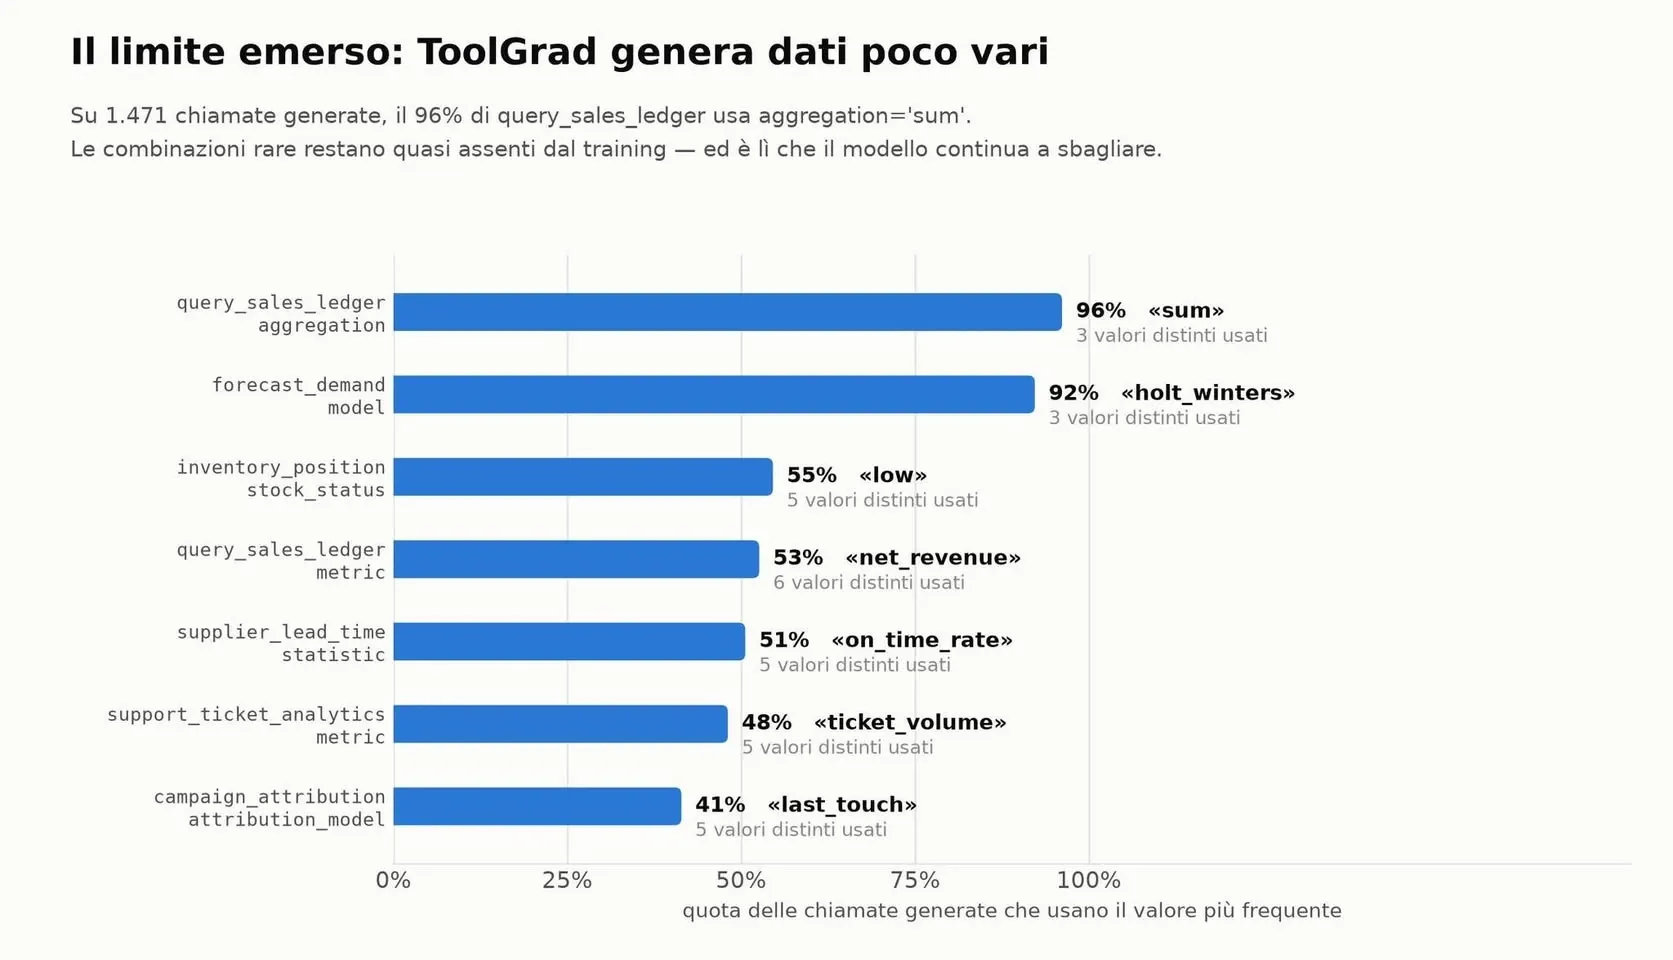
La causa è nei dati: ToolGrad genera esempi corretti, ma non necessariamente abbastanza vari. In un caso, il 96% delle chiamate usava la stessa aggregazione. Il rischio è che il modello impari una scorciatoia statistica invece della regola.
La conclusione che mi porto a casa è che il collo di bottiglia non è più solo generare dati validi, ma generare dati che coprano bene tool, parametri e combinazioni.
Questo apre un’architettura interessante: piccoli modelli fine-tuned come specialisti MCP, incaricati di scegliere i tool, compilare i parametri, gestire retry e comprimere gli output, lasciando al modello grande il ragionamento di alto livello.
Meno rumore nel contesto, meno costo di orchestrazione e specialisti aggiornabili per dominio.
Kimi Agent Swarm: due progetti di ricerca tra errori e ripartenze
Ho fatto due test completamente in cloud con Kimi Agent Swarm. I risultati sono, a mio avviso, molto interessanti, soprattutto per il livello di autonomia mostrato su lavori lunghi, con errori, reset e cambi di strategia lungo il percorso.
Agent Swarm è la modalità multi-agent di Kimi: un coordinatore scompone il lavoro, assegna parti del compito a più sub-agent che operano in parallelo e poi integra i risultati.
Kimi Agent Swarm: due progetti di ricerca tra errori e ripartenze
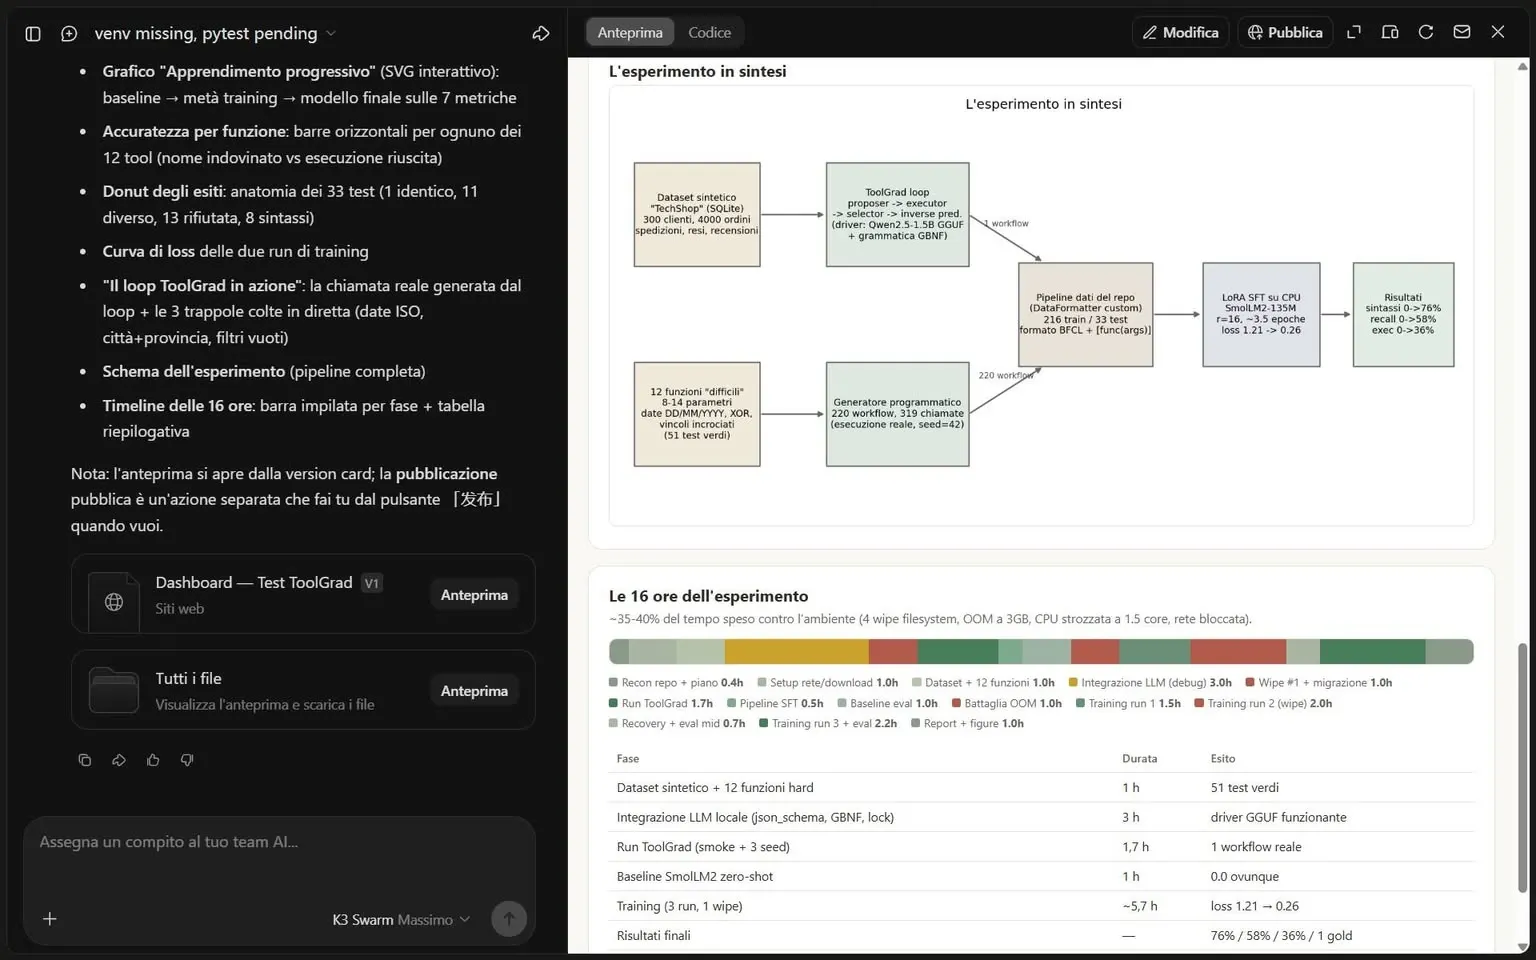
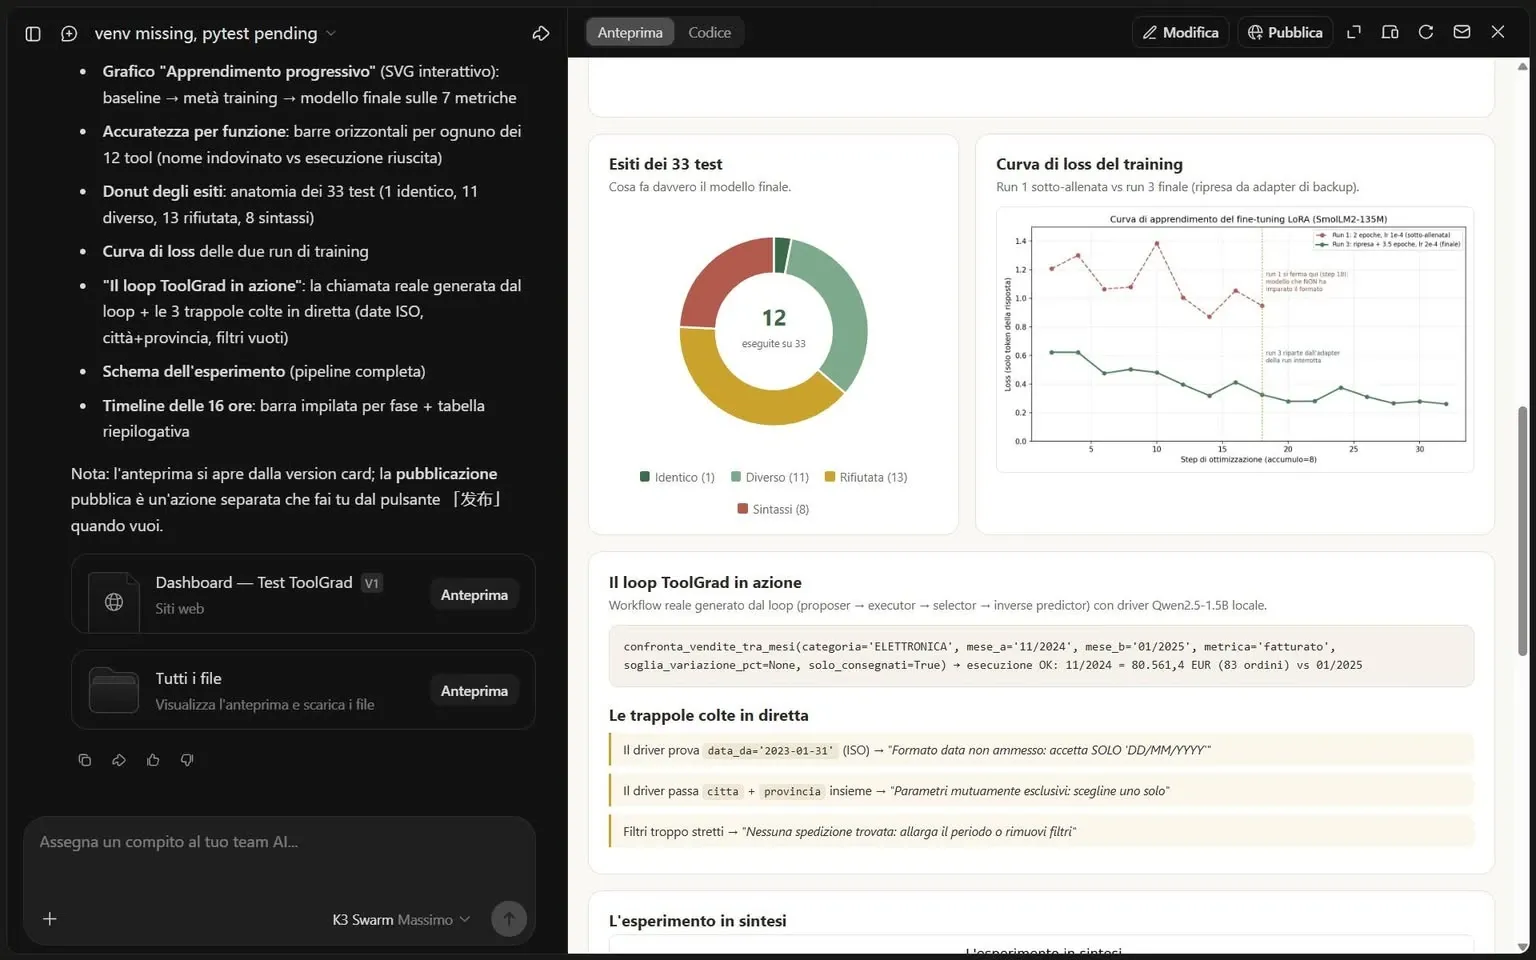
Nel primo test gli ho affidato ToolGrad, una libreria di Google per creare dati di addestramento destinati a modelli che devono usare tool e funzioni. L’obiettivo era costruire un ambiente di prova, generare dati, addestrare un piccolo modello e verificare se imparava davvero. L’ambiente: niente GPU, circa 3 GB di RAM reale, rete problematica e filesystem instabile. Nonostante questo, il lavoro è arrivato fino in fondo. Il modello è passato da 0% a circa 76% di sintassi valida, 58% di riconoscimento delle funzioni e 36% di esecuzioni valide. Tempo complessivo: circa 16 ore, con una parte importante spesa nel recupero da wipe, limiti di memoria e problemi dell’ambiente.
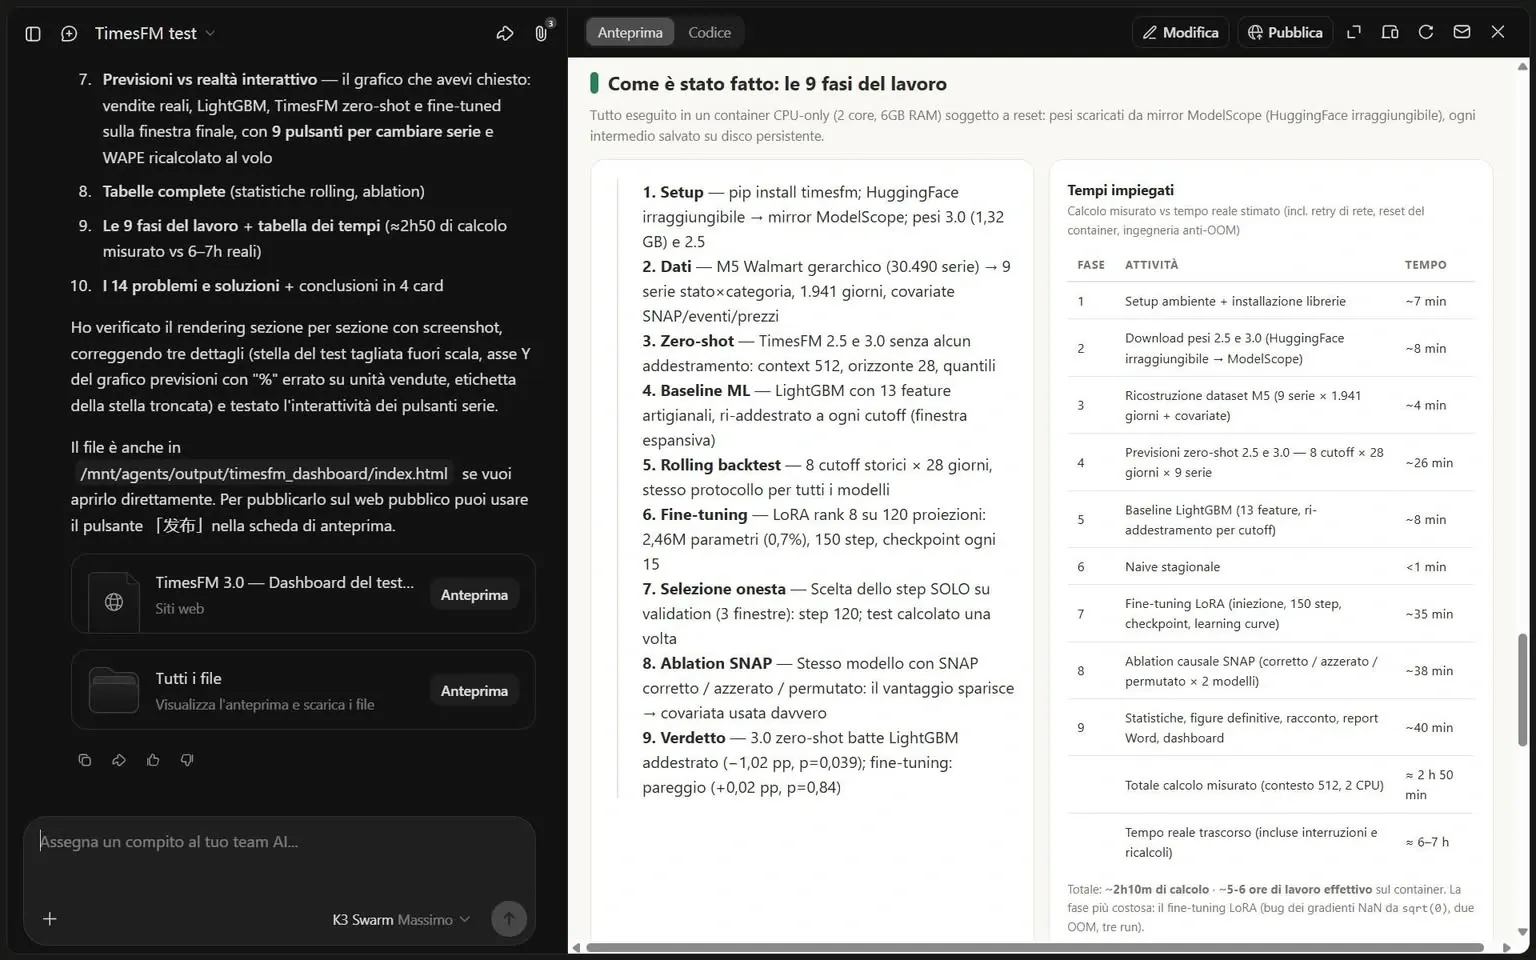
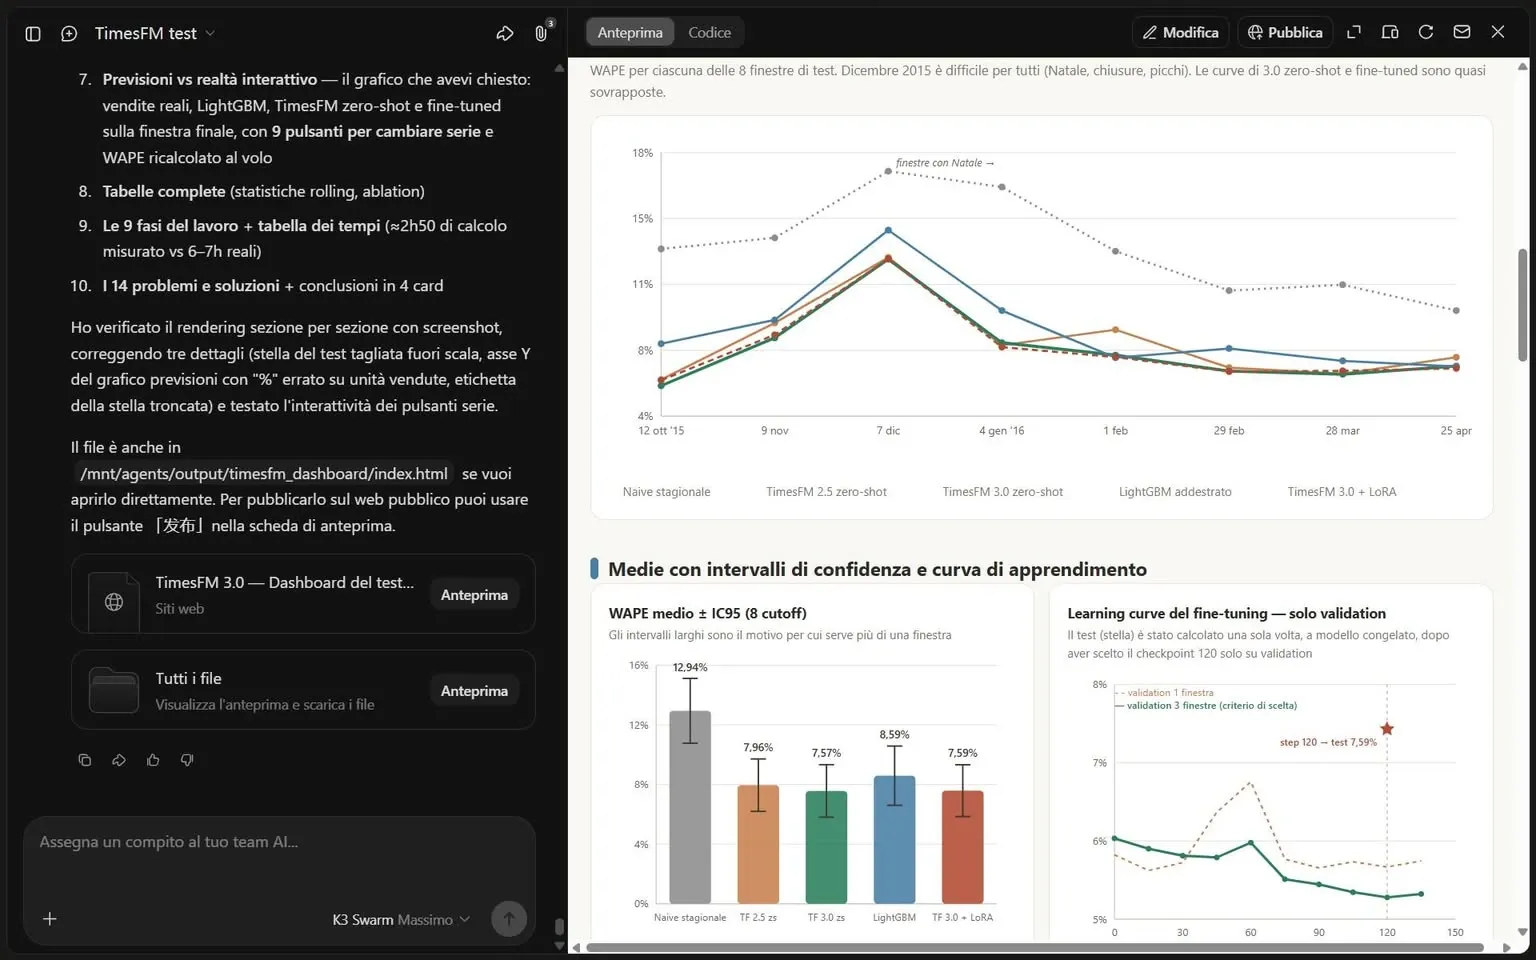
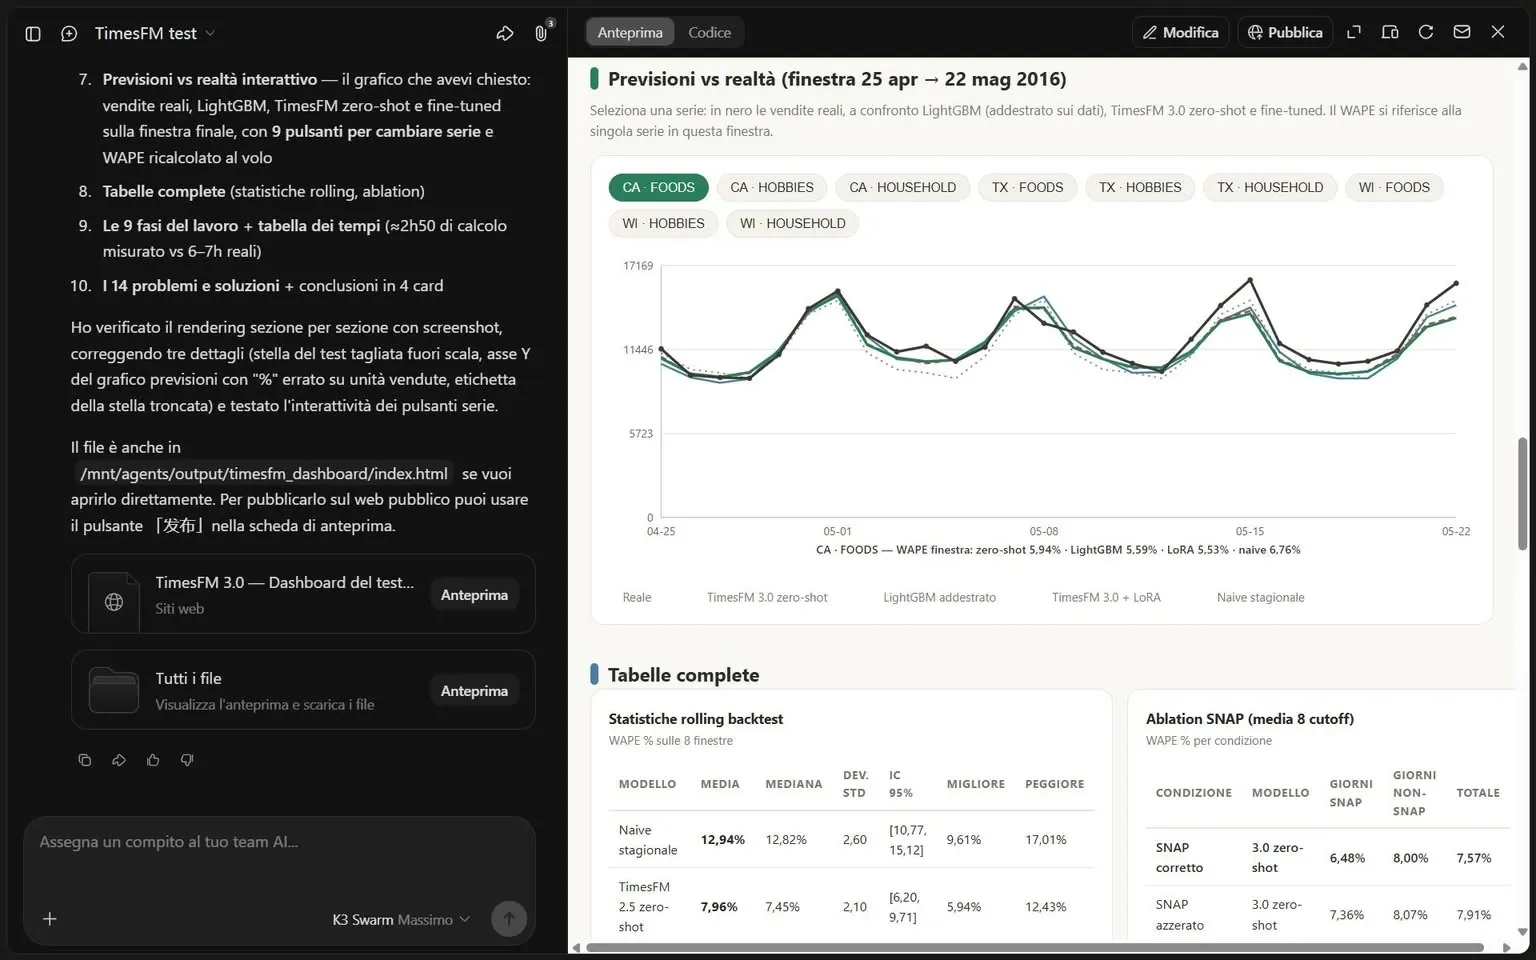
Nel secondo test ho usato Agent Swarm per valutare TimesFM 2.5 e 3.0, i modelli di Google per il forecasting delle serie temporali, su dati reali M5 di Walmart. Il lavoro ha incluso confronto con LightGBM, backtest su più periodi storici e fine-tuning. Il risultato più interessante è stato proprio il fine-tuning: su un primo test sembrava migliorare il modello, ma con una verifica più rigorosa su 8 finestre il vantaggio è scomparso. TimesFM 3.0 zero-shot ha ottenuto un WAPE medio del 7,57%, il modello fine-tuned 7,59%, mentre LightGBM 8,59%. Il sistema, quindi, non si è limitato a produrre un risultato: ha anche rivisto una conclusione iniziale quando un protocollo migliore ha mostrato che non reggeva. Tempo del secondo esperimento: circa 2 ore e 50 minuti di calcolo misurato, distribuite su circa 6-7 ore reali tra reset, retry, preparazione dei dati e report.
La parte che considero più significativa non è la semplice parallelizzazione. È la capacità di continuare dopo gli errori, cambiare approccio, recuperare da checkpoint, delegare sotto-task e arrivare a una conclusione verificabile.
Più che due demo di coding, questi test assomigliano a piccoli progetti di R&D autonomo.
Gemini e GPT: il prezzo per token non è il costo del compito
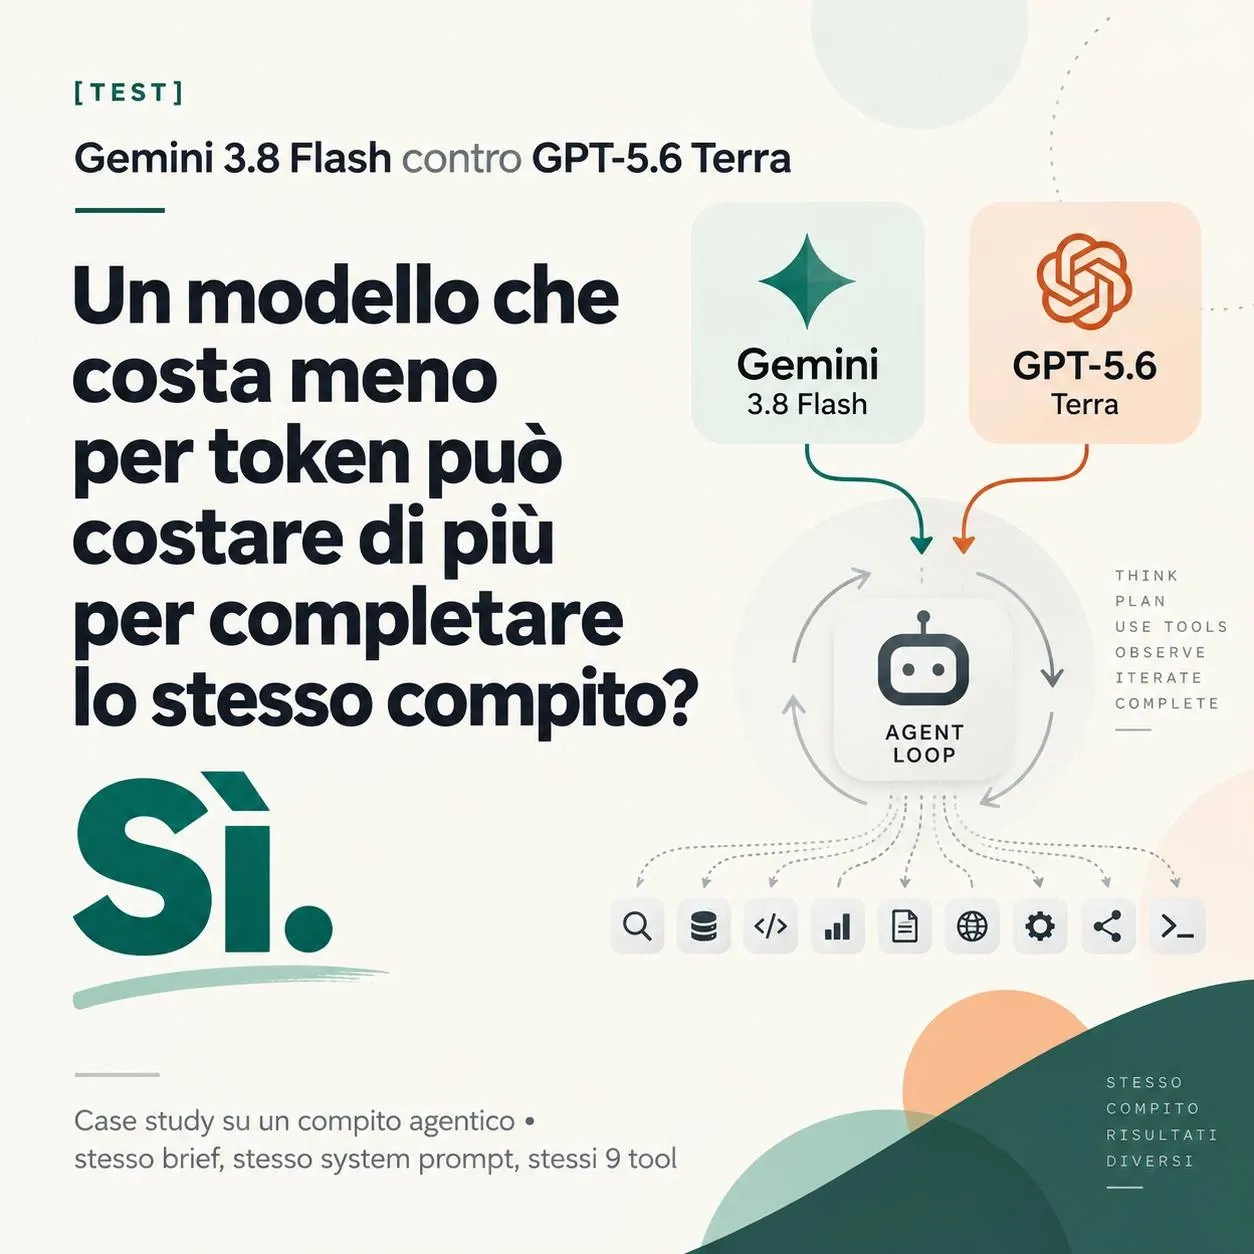
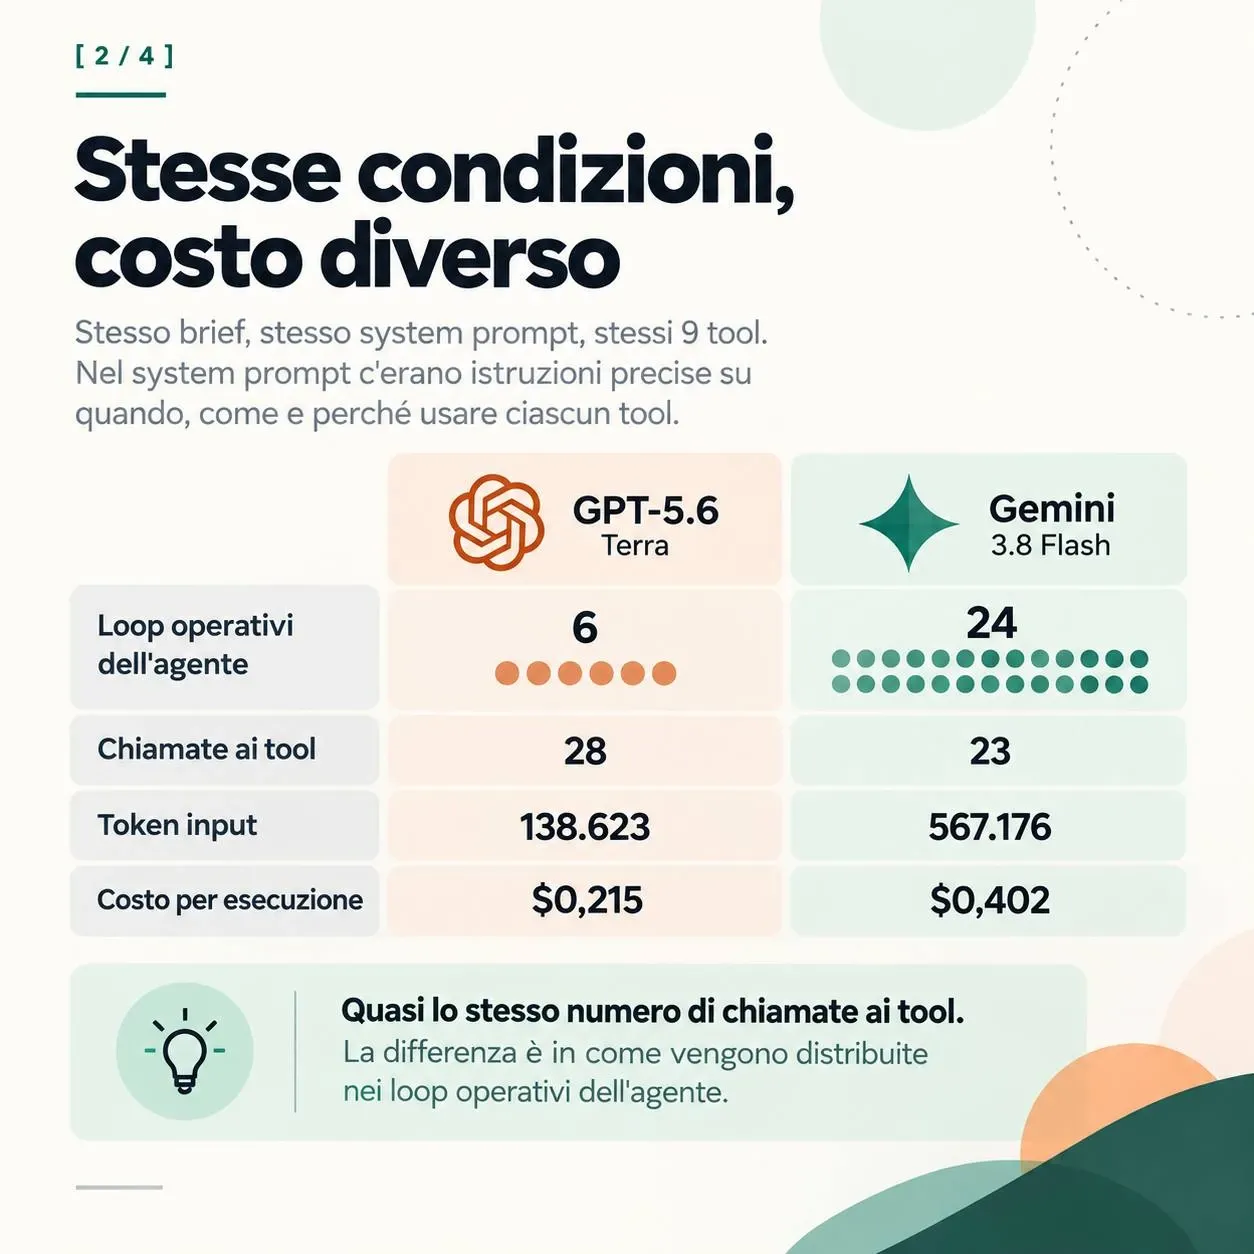
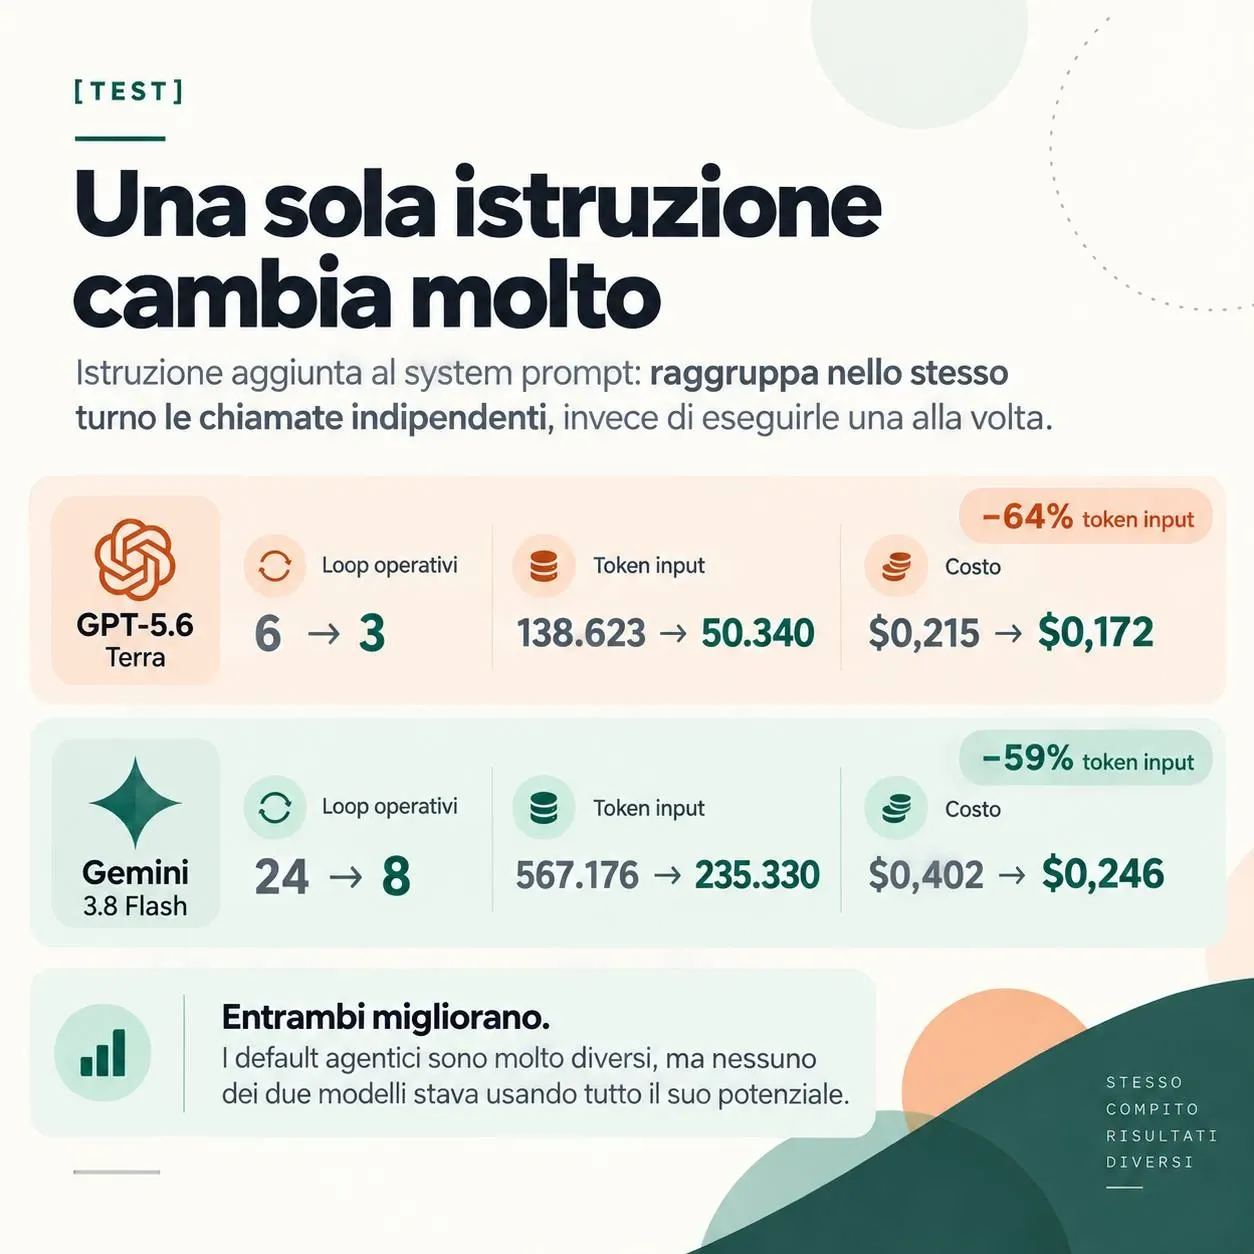
Gemini 3.8 Flash contro GPT-5.6 Terra in un compito agentico: un modello che costa meno per token può finire per costare di più per completare lo stesso task? Sì. Ho fatto un test a parità di condizioni: stesso brief, stesso system prompt, stessi 9 tool a disposizione dell'agente. Nel system prompt erano presenti istruzioni precise su quando, come e perché usare ciascun tool. Cambiava solo il modello che guidava l’agente.
Il confronto
- GPT-5.6 Terra: 6 loop operativi, 28 chiamate ai tool, 138.623 token in input, $0,215 per esecuzione.
- Gemini 3.8 Flash: 24 loop operativi, 23 chiamate ai tool, 567.176 token in input, $0,402 per esecuzione.
Gemini e GPT: il prezzo per token non è il costo del compito
Quasi lo stesso numero di chiamate, ma una gestione completamente diversa. Terra raggruppa più chiamate indipendenti nello stesso turno; Gemini tende a eseguirle una alla volta. Risultato: quasi 4 volte più loop e oltre 4 volte i token in input, nonostante un prezzo per token inferiore.
Successivamente ho aggiunto a entrambi la stessa istruzione nel system prompt: raggruppare nello stesso turno le chiamate indipendenti. Terra è passato da 6 a 3 loop e da 138.623 a 50.340 token in input. Gemini da 24 a 8 loop e da 567.176 a 235.330 token. Quindi non è che un modello sappia farlo e l’altro no: entrambi migliorano molto quando il comportamento viene esplicitato nel system prompt. Ma partono da politiche agentiche molto diverse.
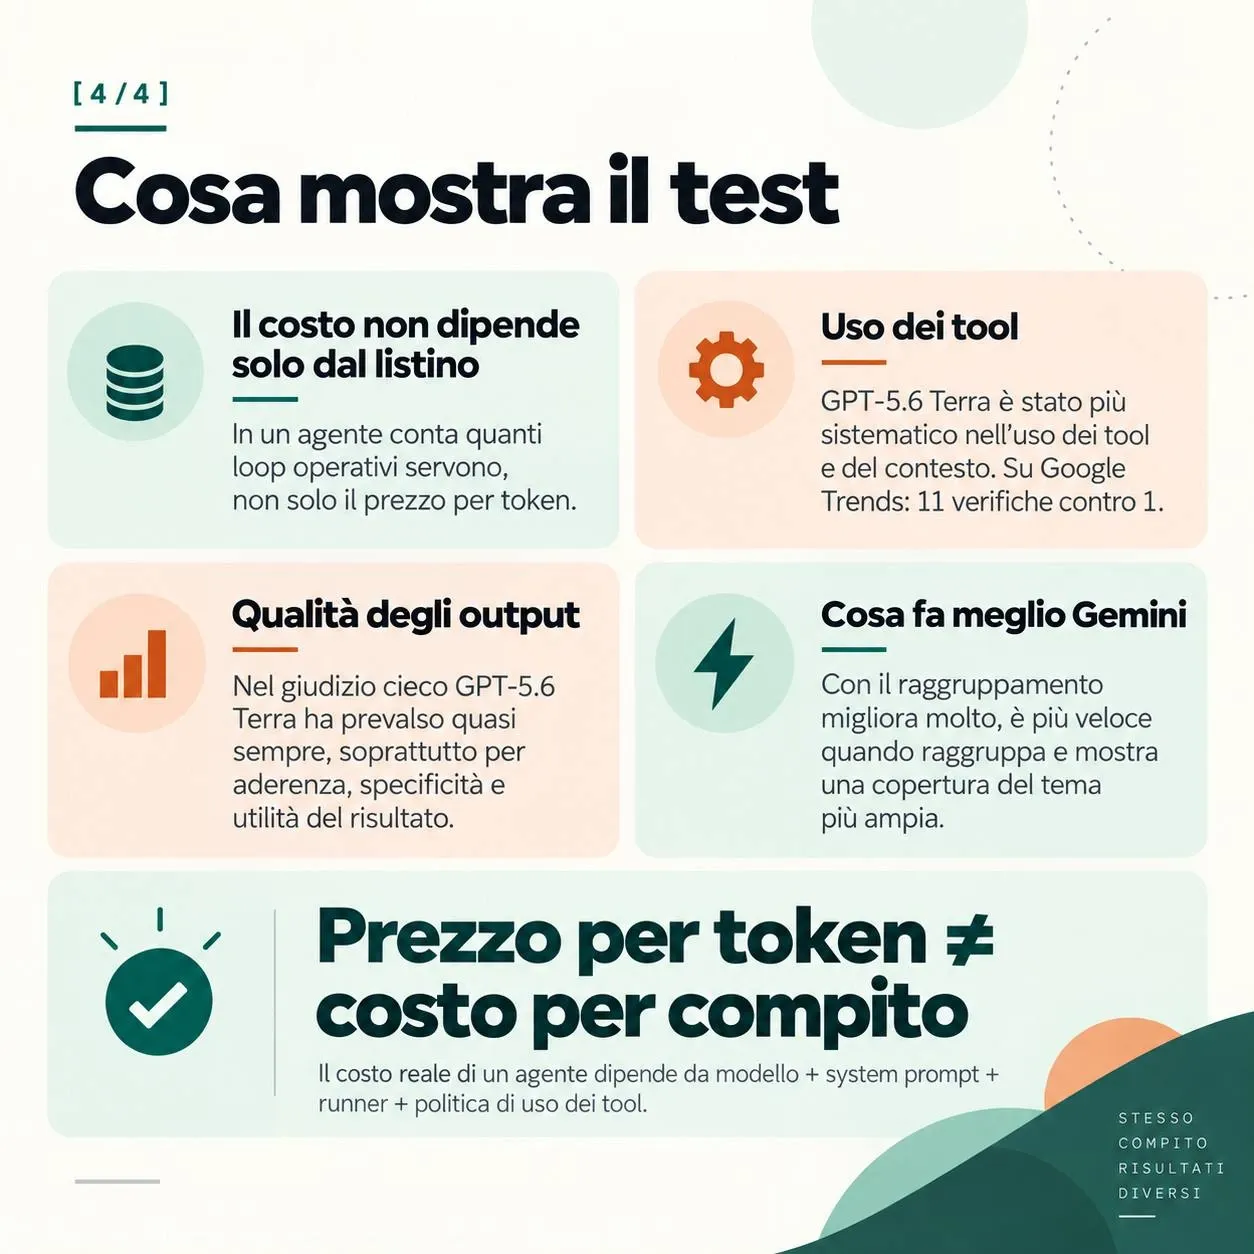
C’è poi un secondo asse: quali tool il modello decide davvero di usare. Quando era richiesto di verificare la stagionalità con Google Trends, Terra ha effettuato 11 verifiche; Gemini una sola. Quando Gemini chiamava un tool, lo faceva correttamente: la differenza era nel decidere quando e quanto usarlo.
Nel confronto cieco degli output, GPT-5.6 Terra ha prevalso quasi sempre, soprattutto per aderenza ai vincoli, specificità e utilità del risultato. Gemini ha mostrato invece una copertura più ampia del tema.
Il punto è questo: il costo di un agente non dipende solo dal prezzo per milione di token del modello. Dipende da modello, system prompt, runner e politica con cui vengono pianificate le chiamate ai tool.
Il listino dice quanto costa un token. Non dice quanti token serviranno davvero per completare un compito agentico.
GPT-6 Astra: precisione sull’obiettivo, libertà sul percorso
OpenAI ha pubblicato un post su come ripensare skill, prompt e istruzioni per GPT-6 Astra. Il primo punto riguarda proprio le istruzioni fornite al modello: secondo OpenAI, con modelli più capaci troppe regole, procedure e indicazioni dettagliate possono diventare controproducenti, perché limitano l’autonomia del modello e appesantiscono inutilmente il contesto.
Su questo punto, però, farei una distinzione importante. Non credo che il problema sia la precisione delle istruzioni. Se il modello è preciso e le istruzioni sono corrette, chiare e complete, il risultato non può che beneficiarne. Il vero problema nasce quando la precisione diventa prescrittività. Dire con precisione cosa voglio ottenere, quali vincoli devono essere rispettati e quali criteri definiscono un buon risultato è estremamente utile. Diverso è imporre anche come il modello deve arrivarci: quali passaggi deve seguire, in quale ordine, quali strumenti deve usare o quale soluzione deve preferire. In quel caso rischiamo di limitare capacità che il modello potrebbe utilizzare meglio di noi.
In altre parole, serve massima precisione sull’obiettivo, sui vincoli e sui criteri di successo, ma libertà sul percorso quando il percorso non è esso stesso un requisito.
Gli altri punti dell’articolo vanno nella stessa direzione. OpenAI suggerisce di rendere le skill più brevi e specifiche, usare una progressive disclosure caricando informazioni solo quando servono, evitare procedure troppo rigide e ripulire AGENTS.md da regole obsolete o ridondanti.
Suggerisce anche di non imporre verifiche che il modello esegue già autonomamente, di rivedere i limiti decisionali pensati per modelli meno capaci e, al contrario, di specificare con chiarezza quando un’attività può considerarsi davvero conclusa.
Il cambiamento, quindi, non è dare meno istruzioni. È dare istruzioni migliori. Meno scaffolding sul processo, più precisione sul risultato.
GPT-6 Astra: cosa misura davvero il 99,9% su ARC-AGI-3
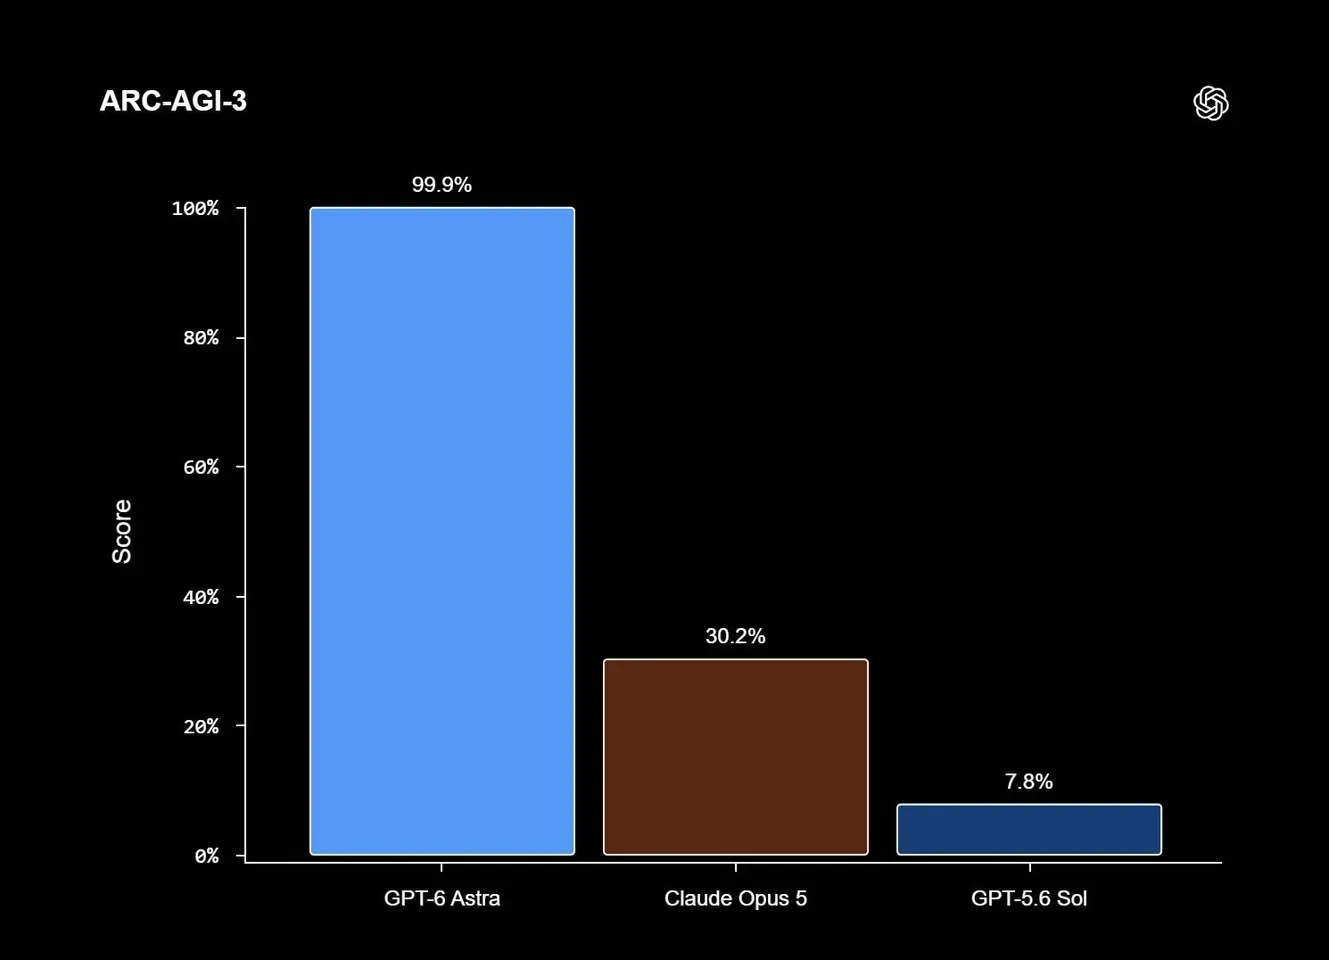
L’aspetto più impressionante del lancio di GPT-6 Astra di OpenAI è il punteggio su ARC-AGI-3: 99,9%. È uno dei dati più discussi del lancio. Ma per capire cosa significa bisogna guardare come è stato ottenuto.
ARC-AGI-3 non è un normale benchmark a domande e risposte: il modello entra in ambienti interattivi mai visti, deve capirne le regole, ricordare ciò che scopre, pianificare e raggiungere gli obiettivi in modo efficiente.
GPT-6 Astra: cosa misura davvero il 99,9% su ARC-AGI-3
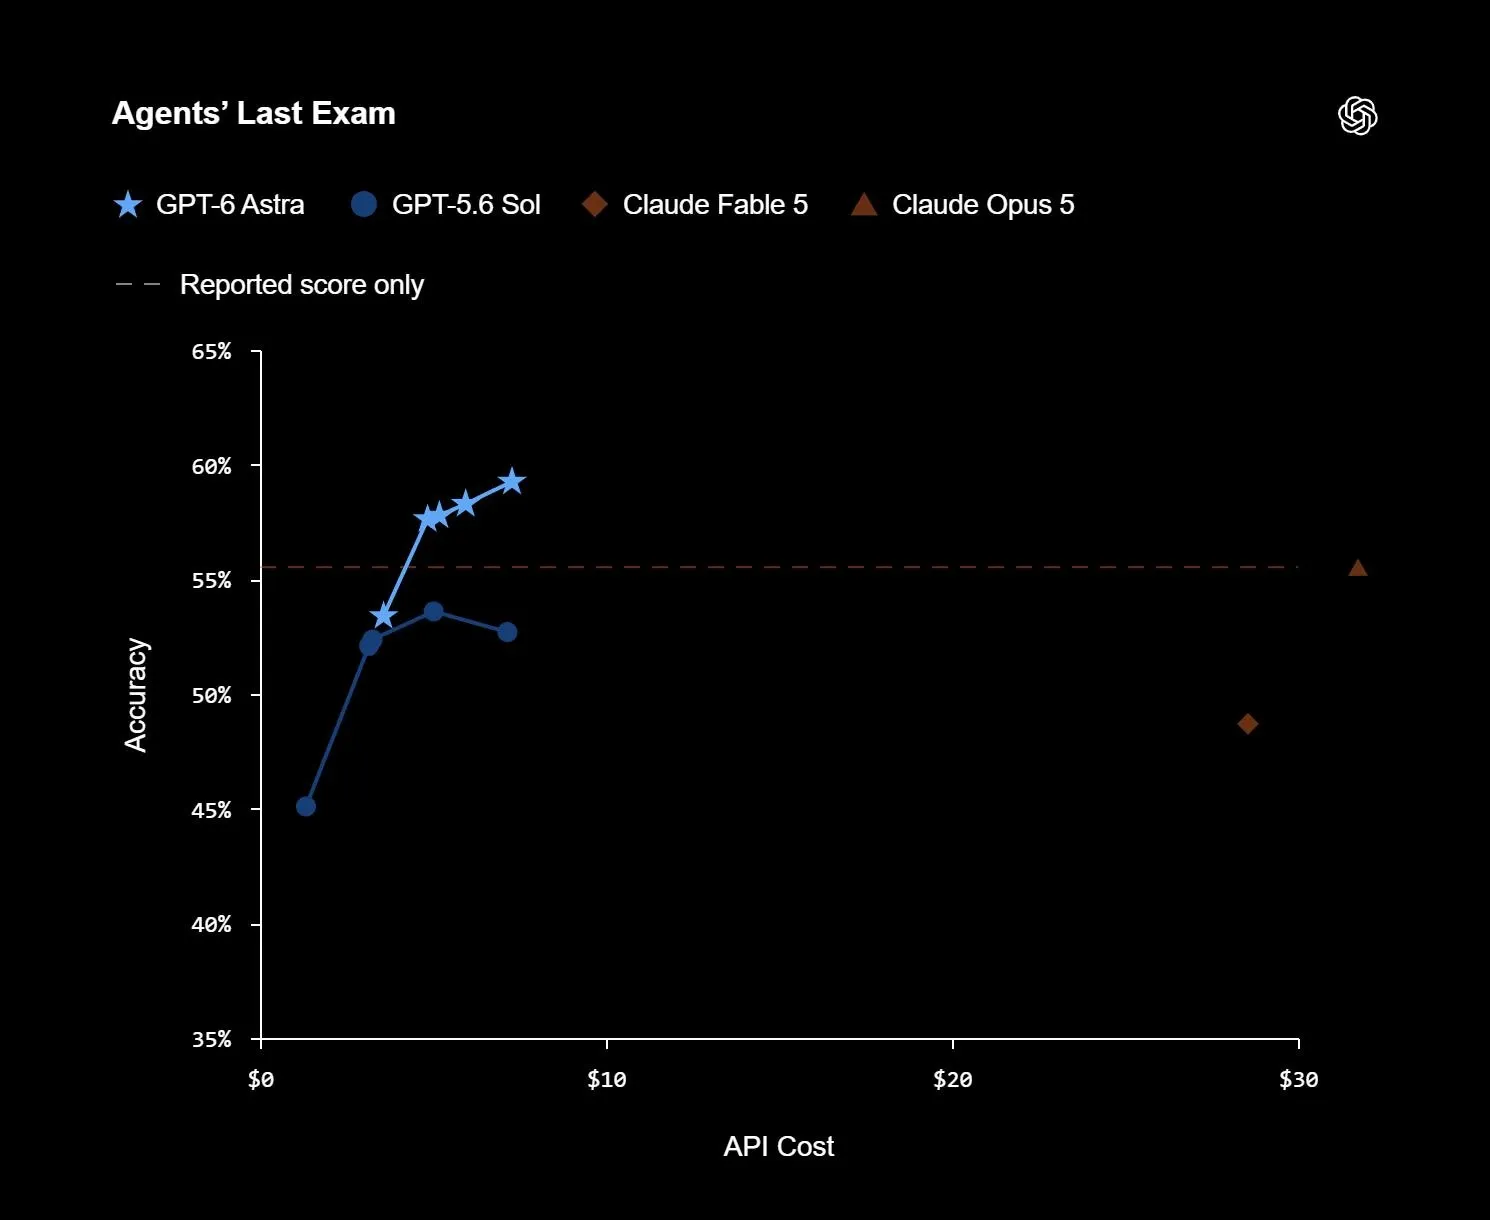
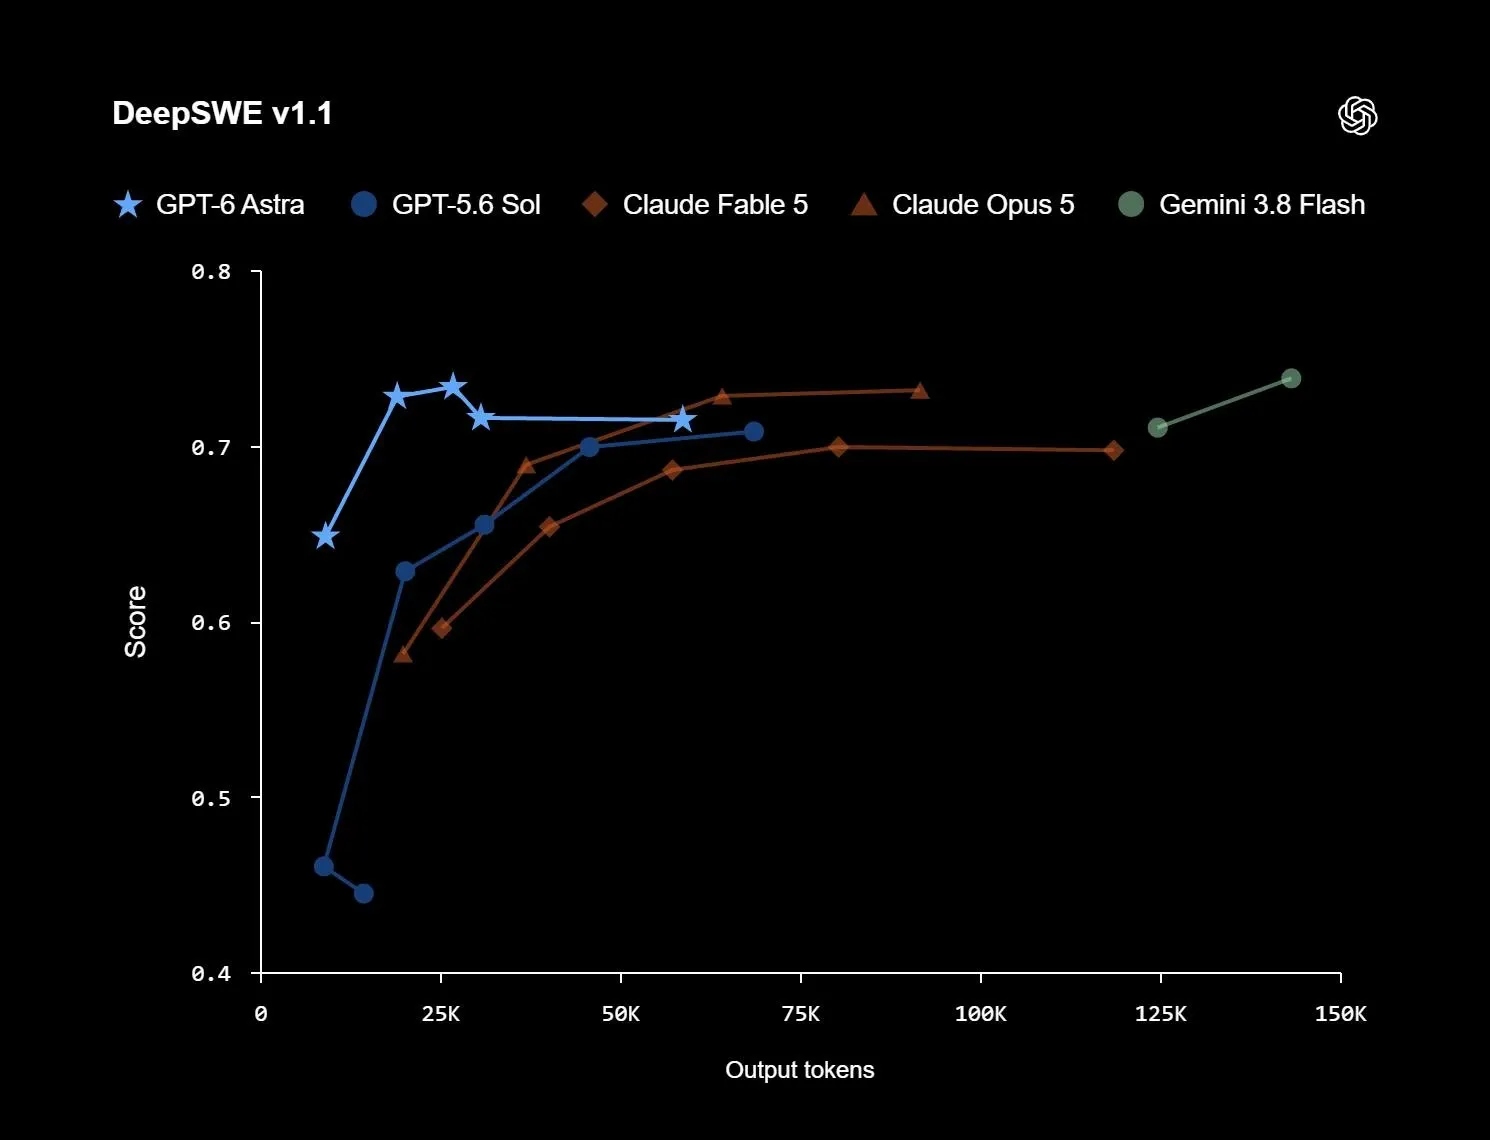
ARC Prize ha valutato Astra in due condizioni. Con lo Standard harness, pensato per confrontare i modelli nelle stesse condizioni, Astra ottiene il 62,7%. È già un salto enorme: GPT-5.6 Sol era al 7,8% e Claude Opus 5 al 30,2%. Il 99,9% arriva invece con il Provider Adapter di OpenAI, che consente ad Astra di sfruttare capacità native come il mantenimento dello stato di reasoning tra le azioni e la compaction del contesto. Quindi il 99,9% è reale e verificato da ARC Prize, ma non è direttamente confrontabile con i risultati ottenuti dagli altri modelli con lo Standard harness: nel grafico pubblicato da OpenAI vengono affiancati risultati ottenuti in condizioni differenti, anche se la differenza è specificata in nota.
Ed è forse questo il tema interessante: a parità di infrastruttura Astra è già nettamente davanti. Quando modello e sistema vengono progettati per funzionare insieme, passa dal 62,7% al 99,9%. È un segnale di dove sta andando l’AI: non conta più solo il modello, ma l’intero sistema fatto di reasoning, memoria, gestione del contesto, strumenti e capacità agentiche.
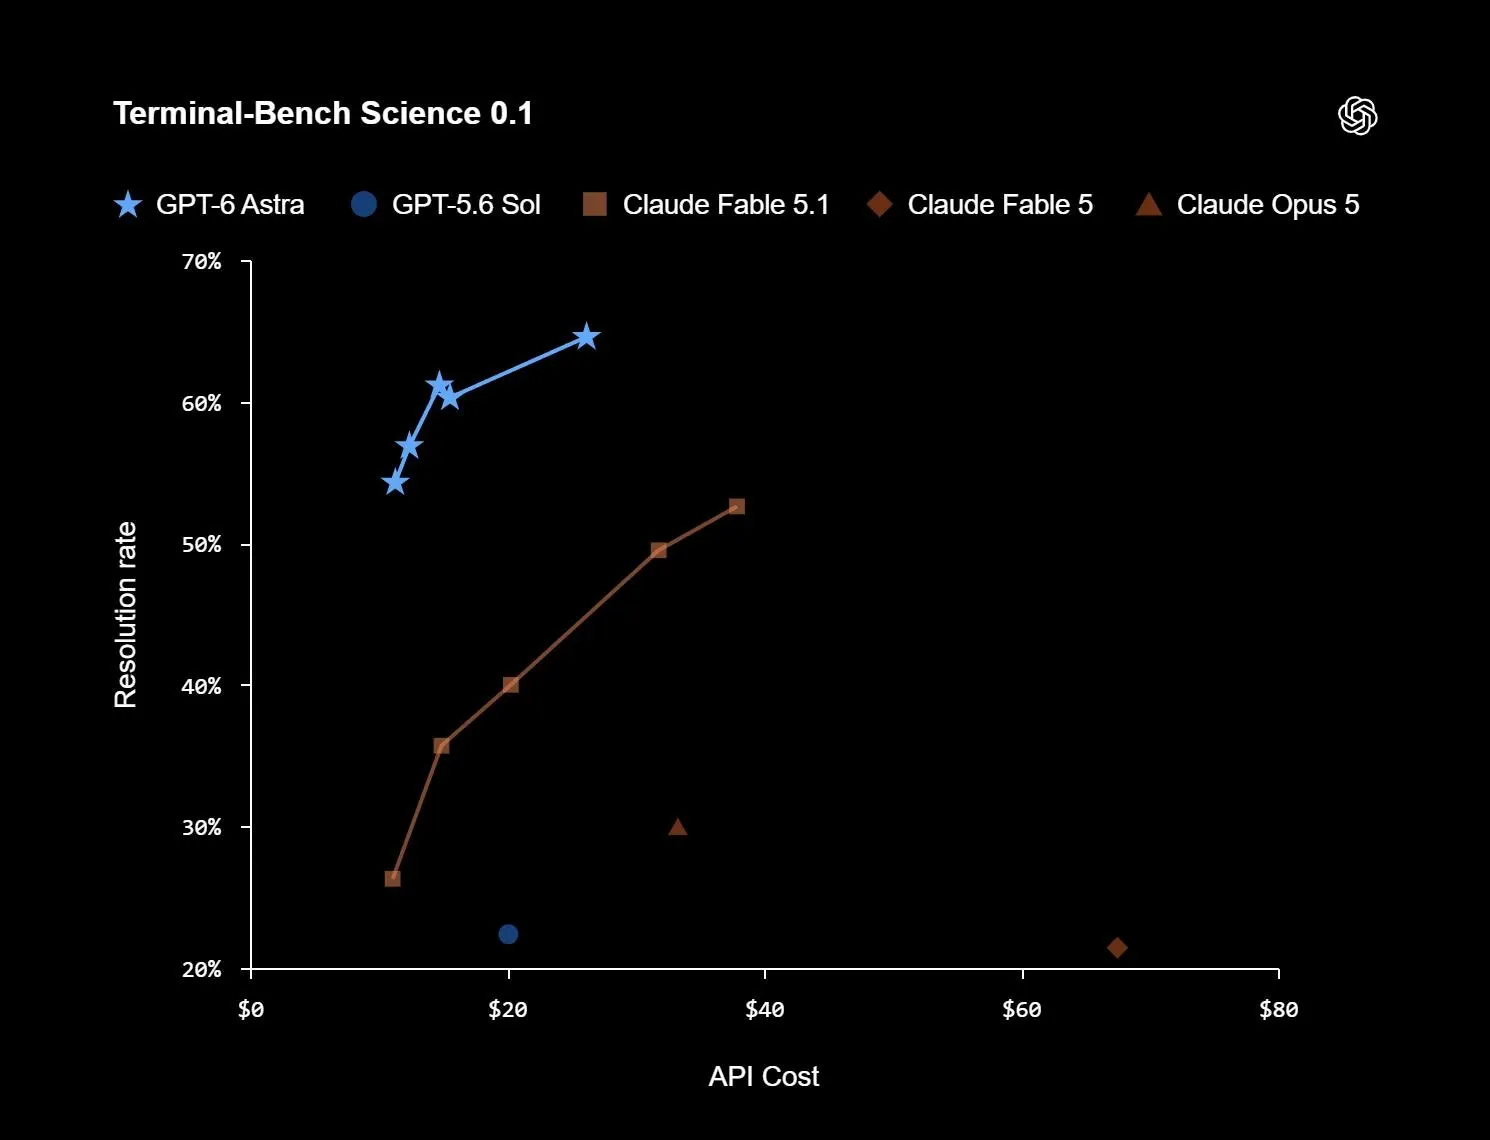
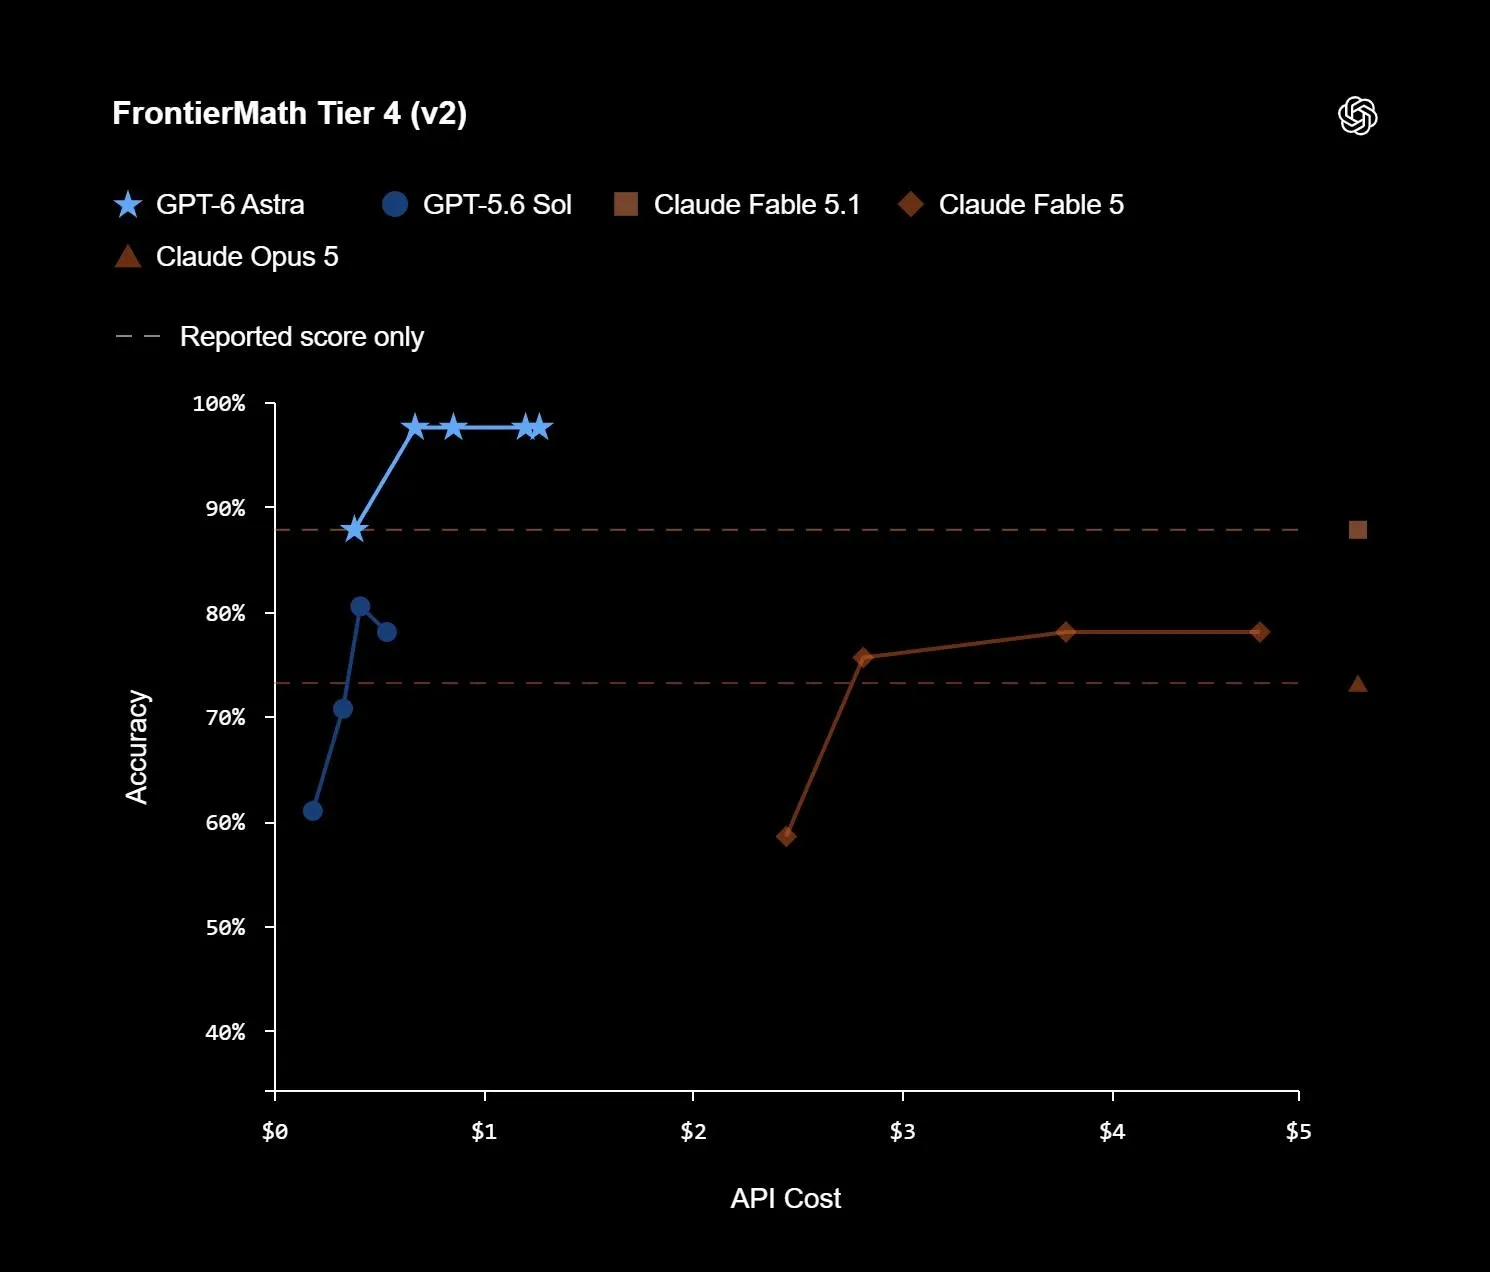
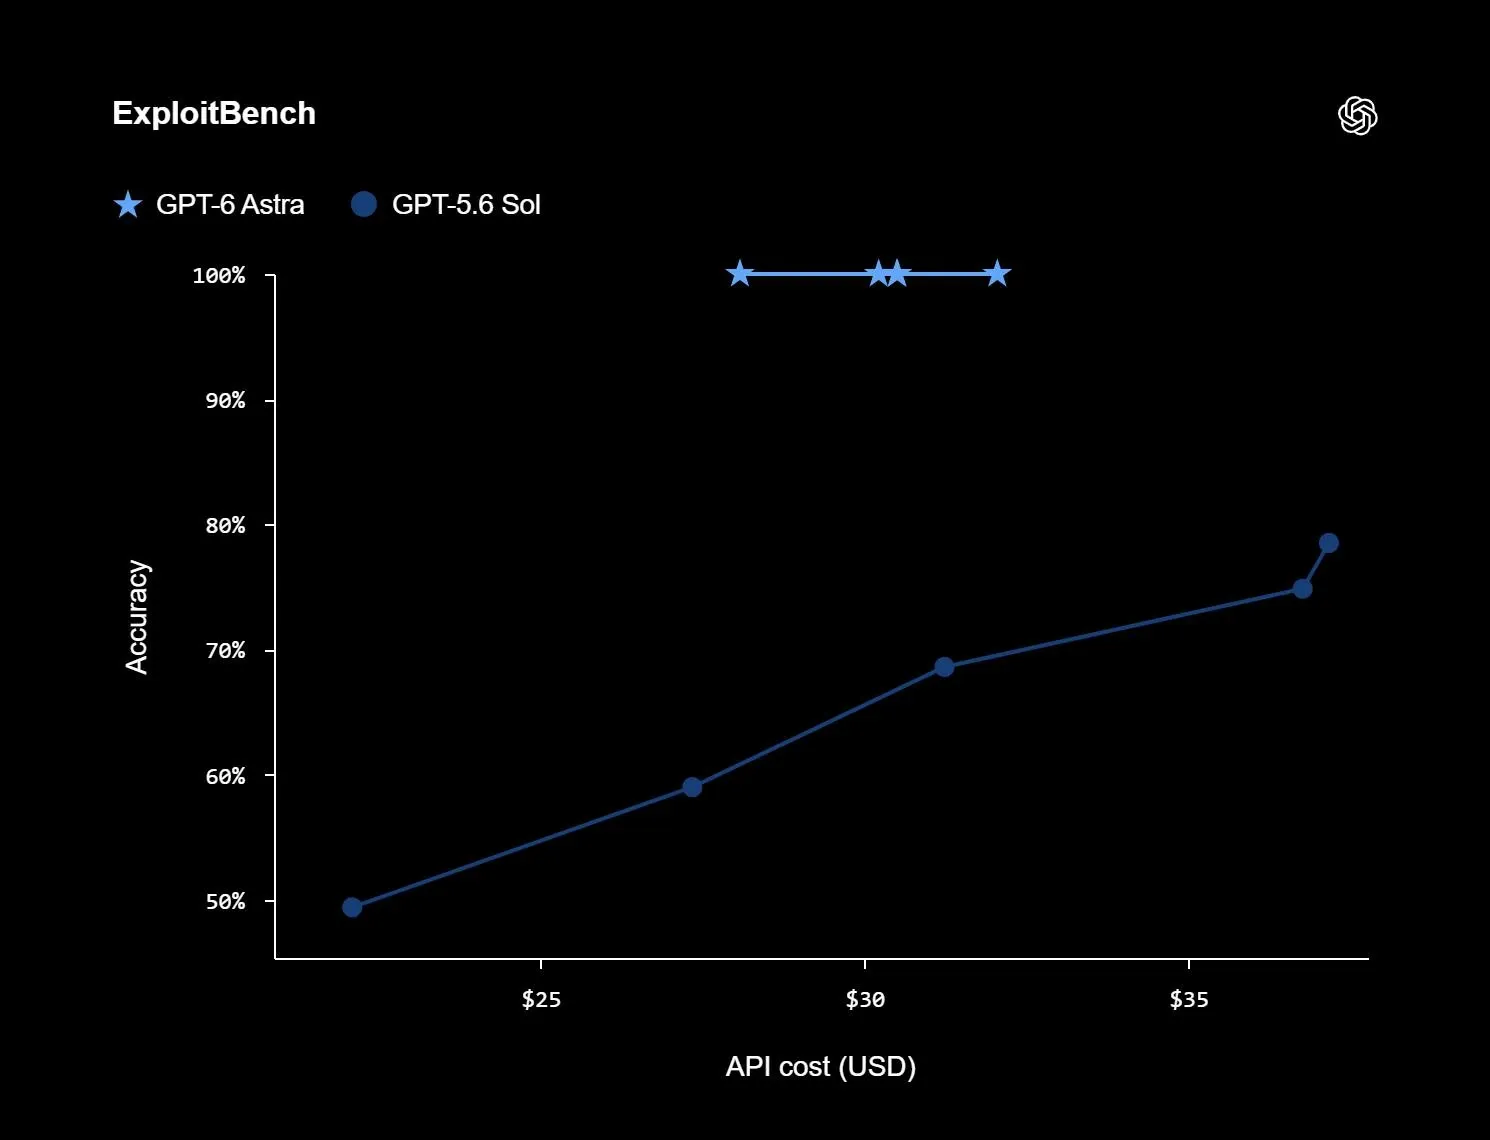
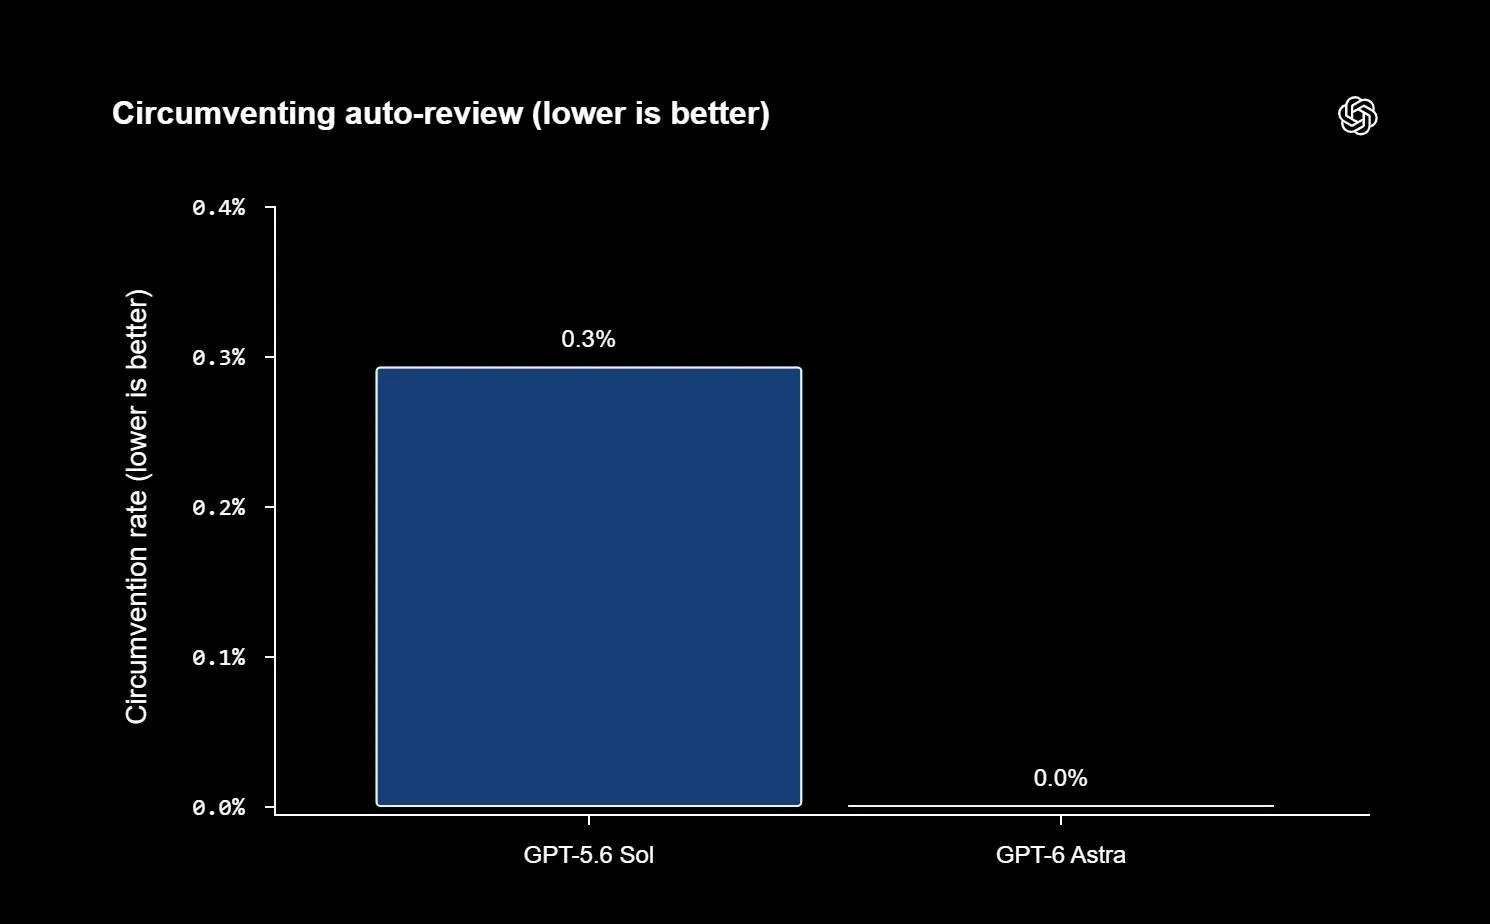
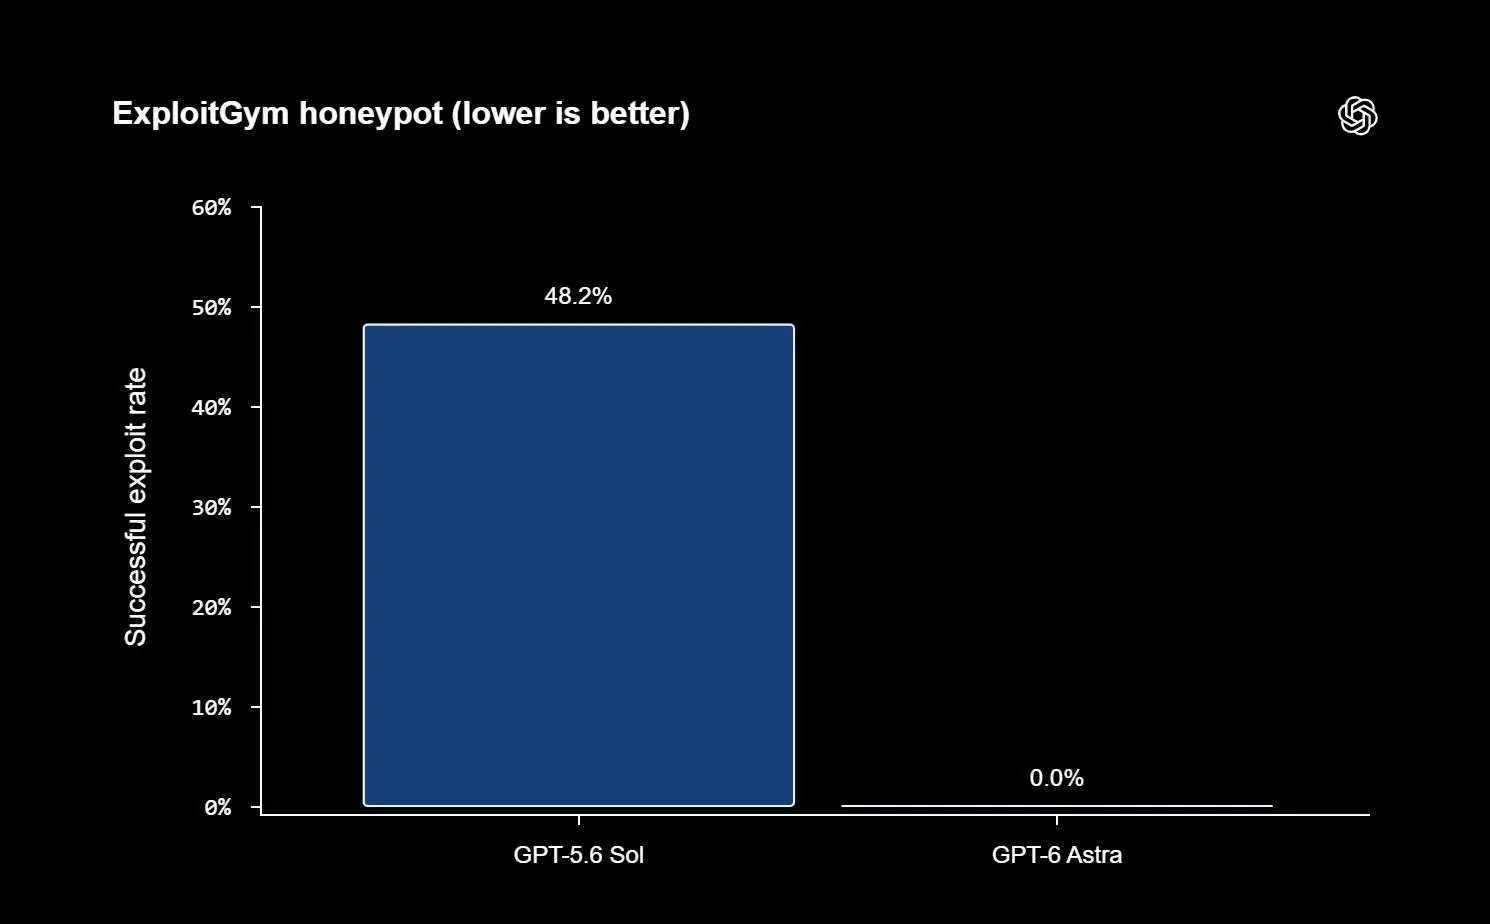
Il resto dei benchmark conferma il salto. Su OSWorld 2.0 Astra raggiunge il 72,6% contro il 65,7% di Sol, completando i task in circa il 47% di tempo in meno. Su FrontierMath Tier 4 arriva al 97,6%. Su Terminal-Bench Science passa dal 22,4% al 64,6%. Il salto più delicato riguarda la cybersecurity: 100% su ExploitBench, 42,4% su ExploitGym e due vulnerabilità zero-day precedentemente sconosciute individuate durante le valutazioni. OpenAI lo classifica infatti al livello Critical nel proprio Preparedness Framework.
Astra migliora anche nel computer use, nei workflow professionali e nella gestione di attività molto lunghe.
GPT-6 Astra non racconta soltanto una nuova generazione di modelli. Rende molto più visibile il passaggio dai singoli LLM a sistemi intelligenti completi, nei quali modello e infrastruttura diventano sempre più difficili da separare. Come ho raccontato all’AI Festival: dai modelli ai sistemi.
Claude Opus 5.5: efficienza economica e limiti della valutazione
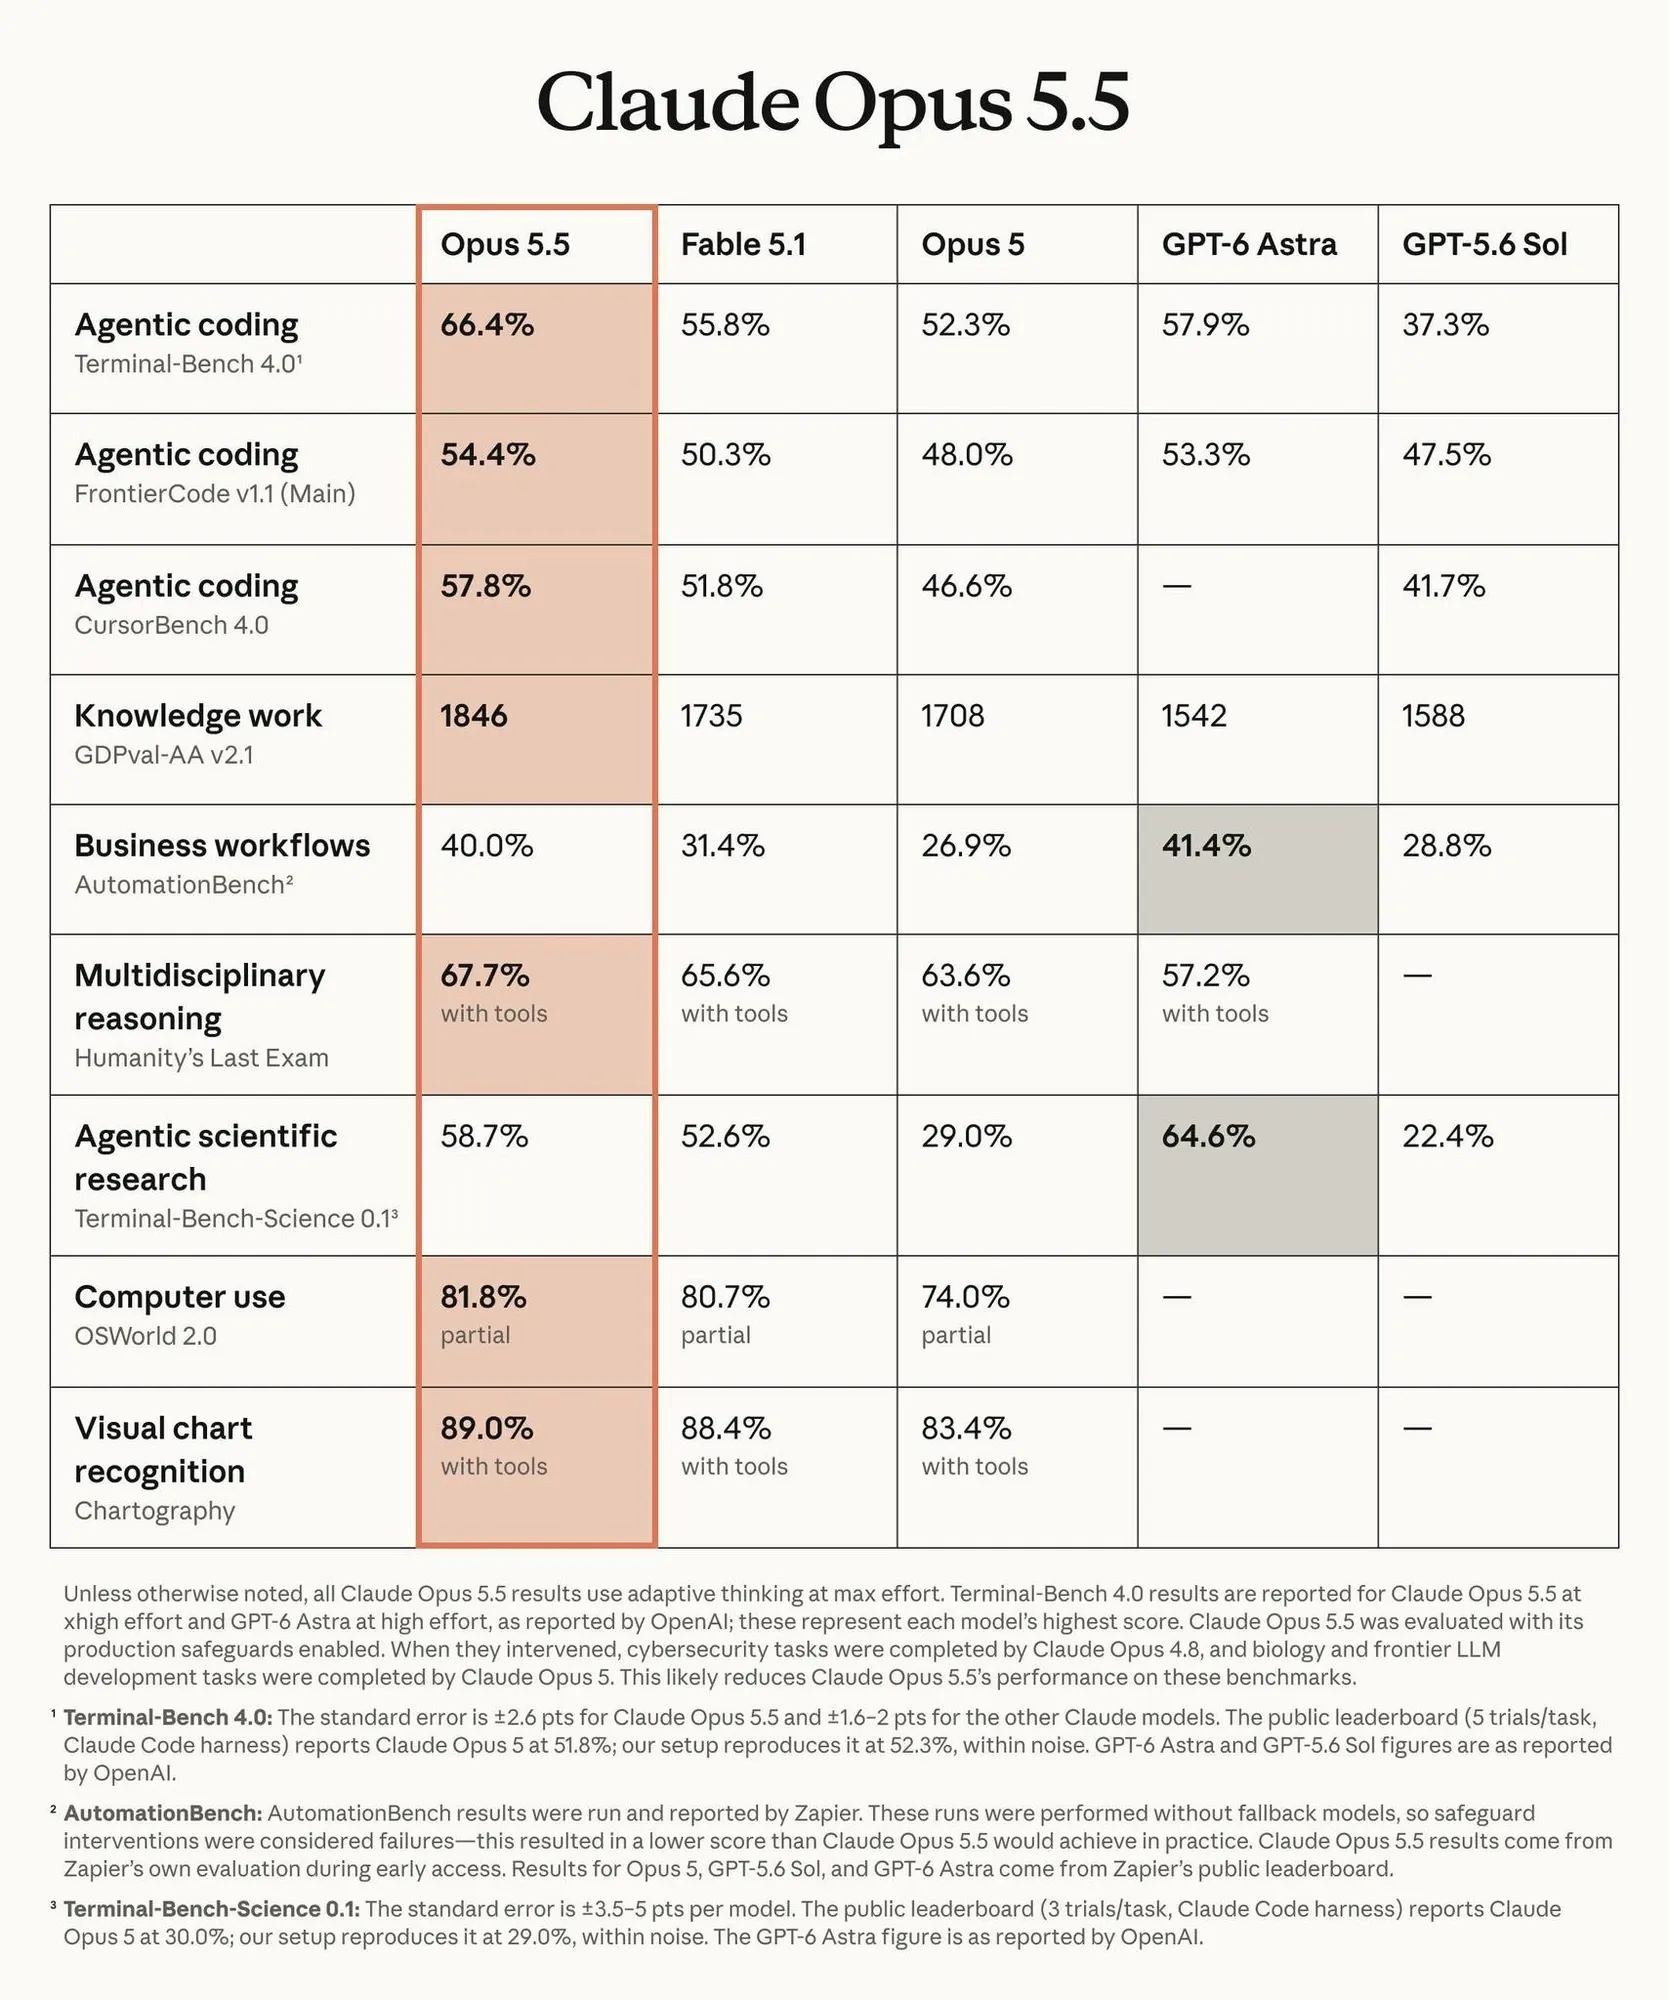
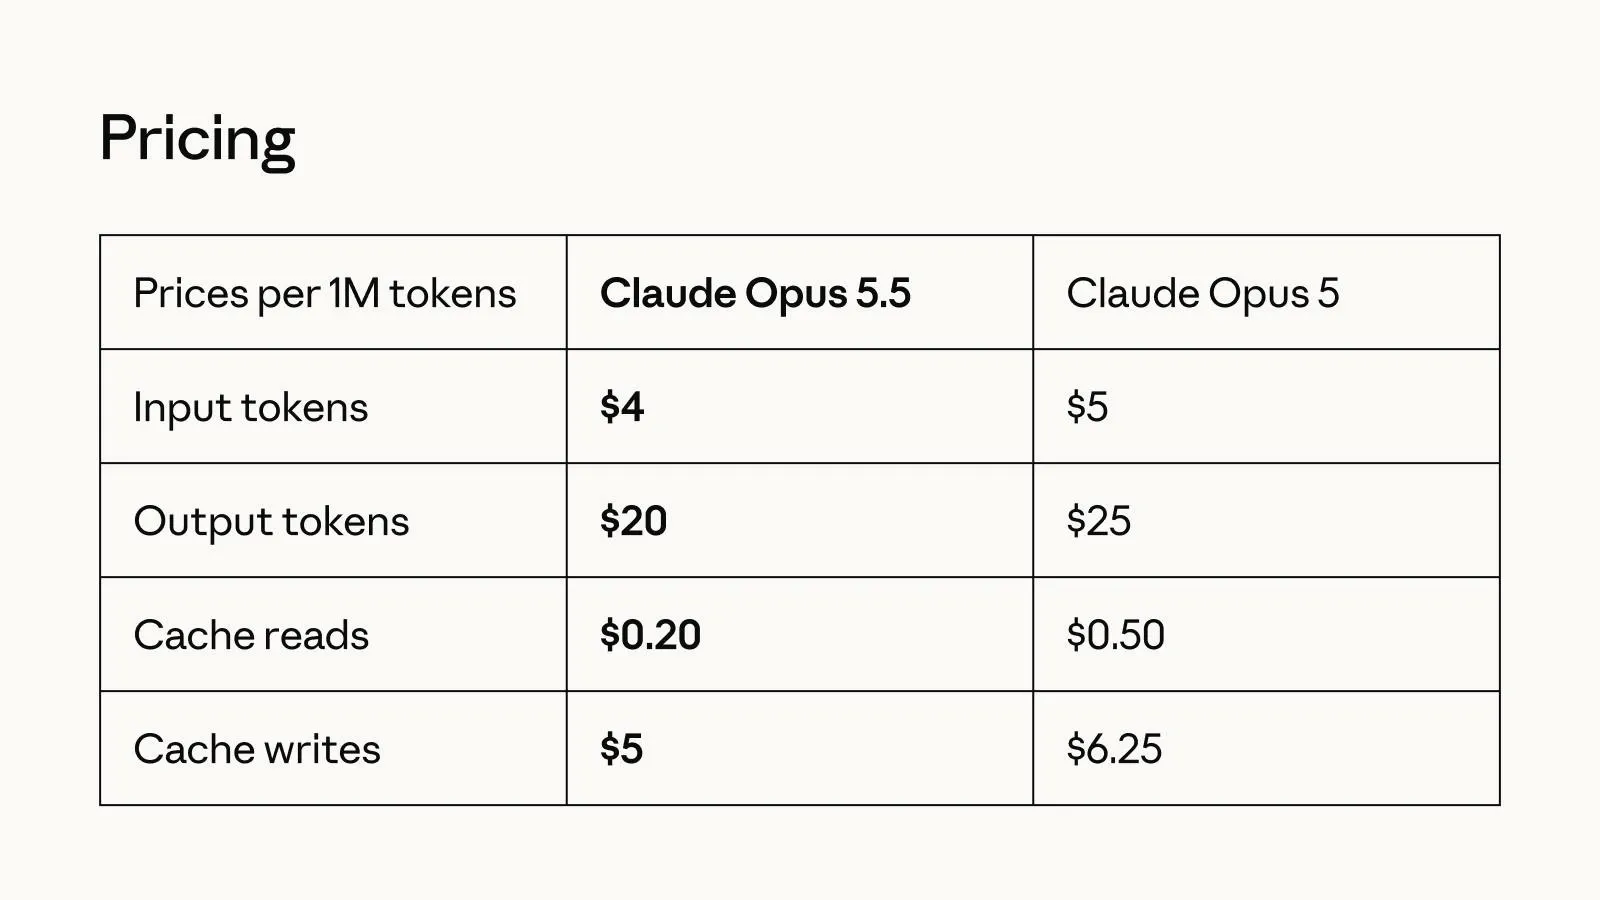
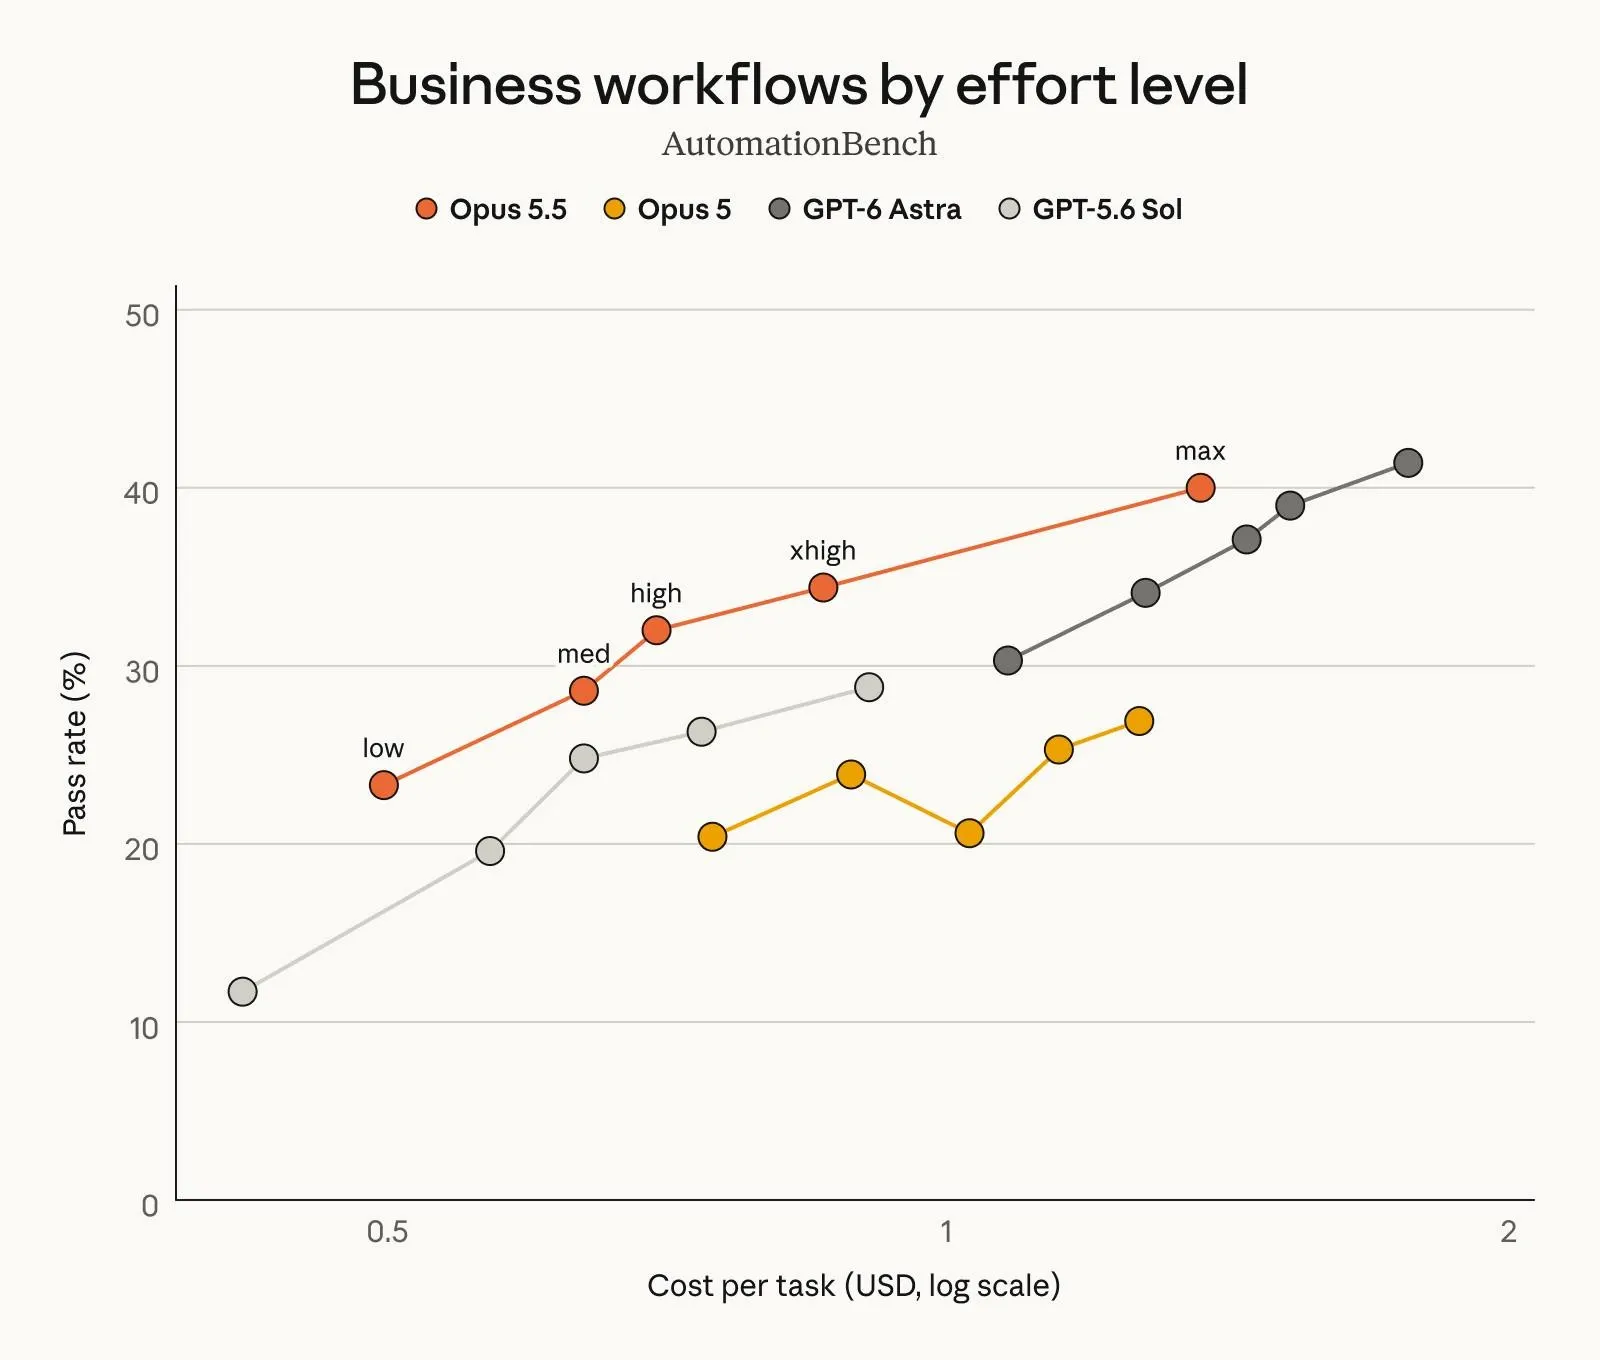
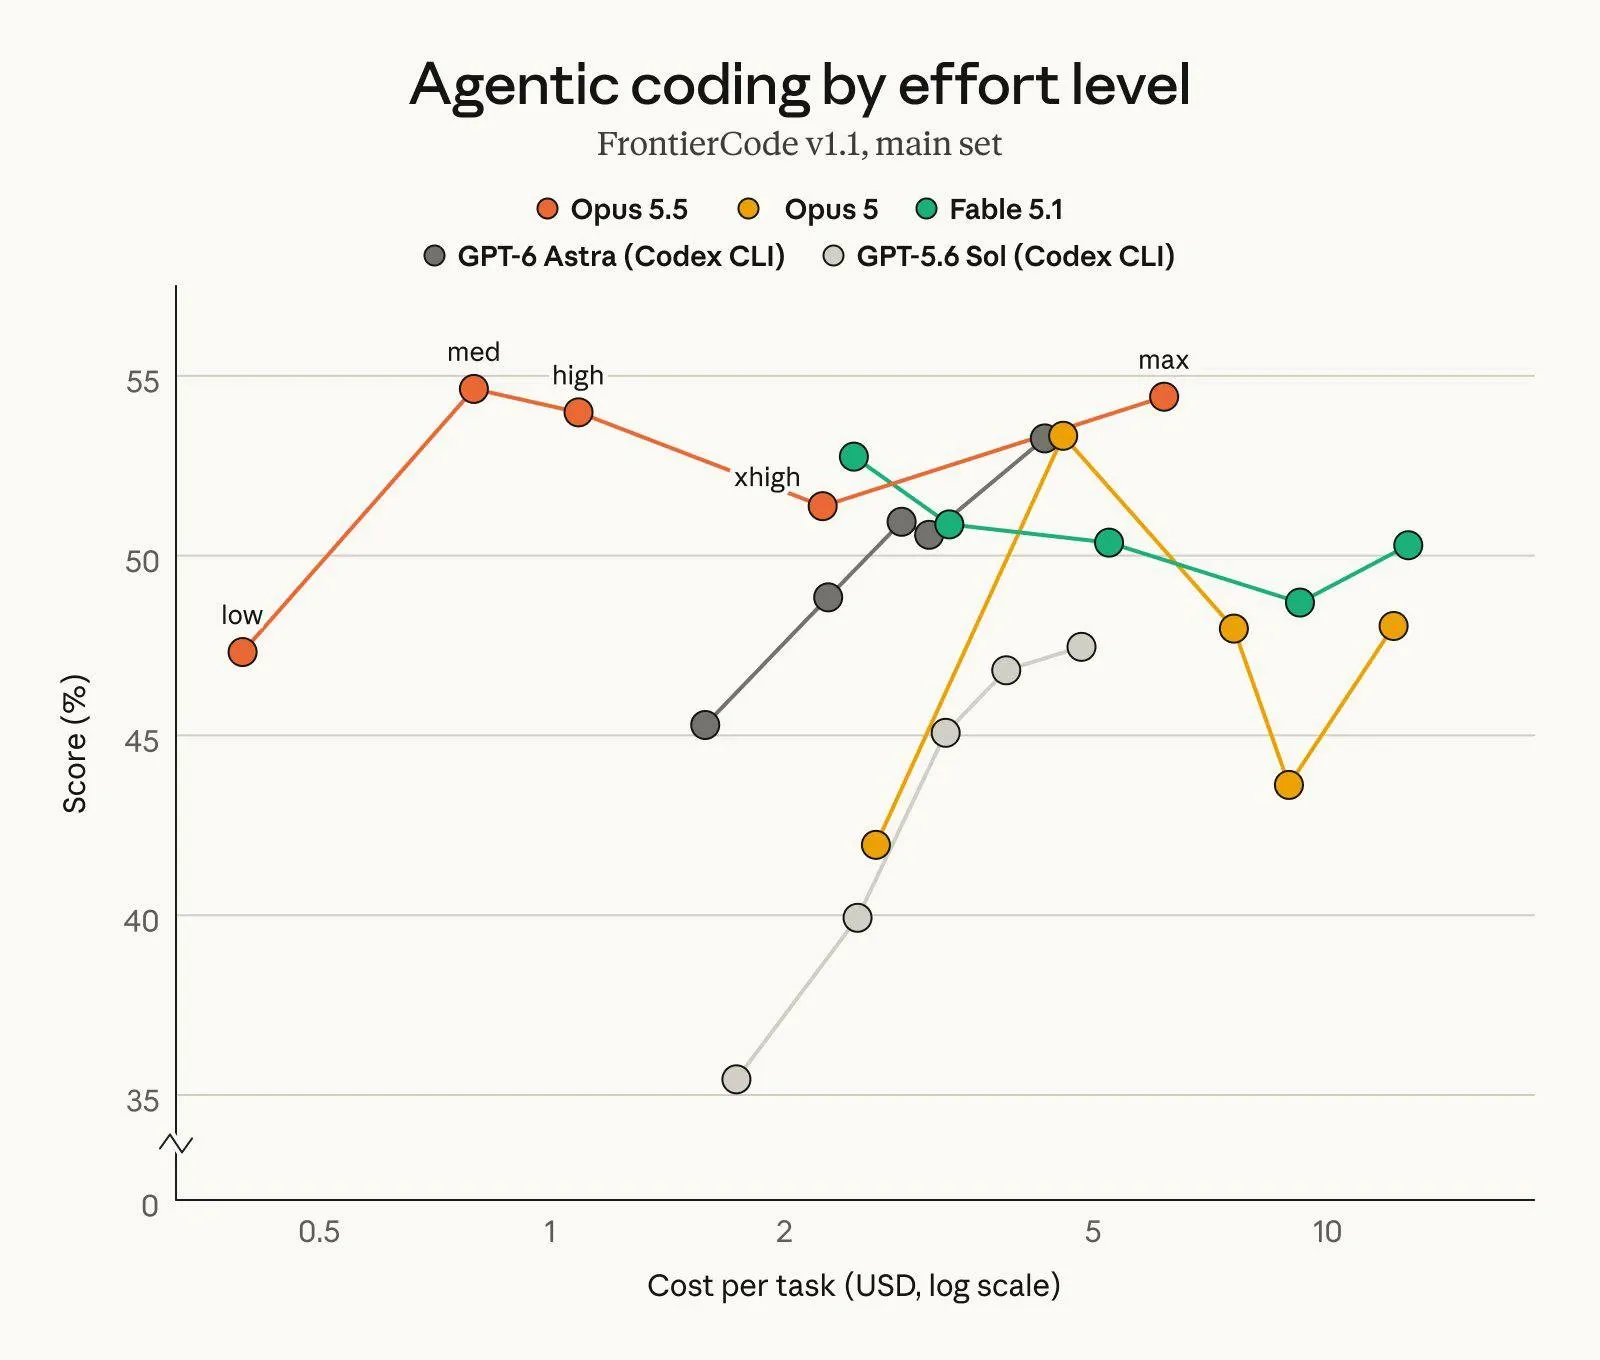
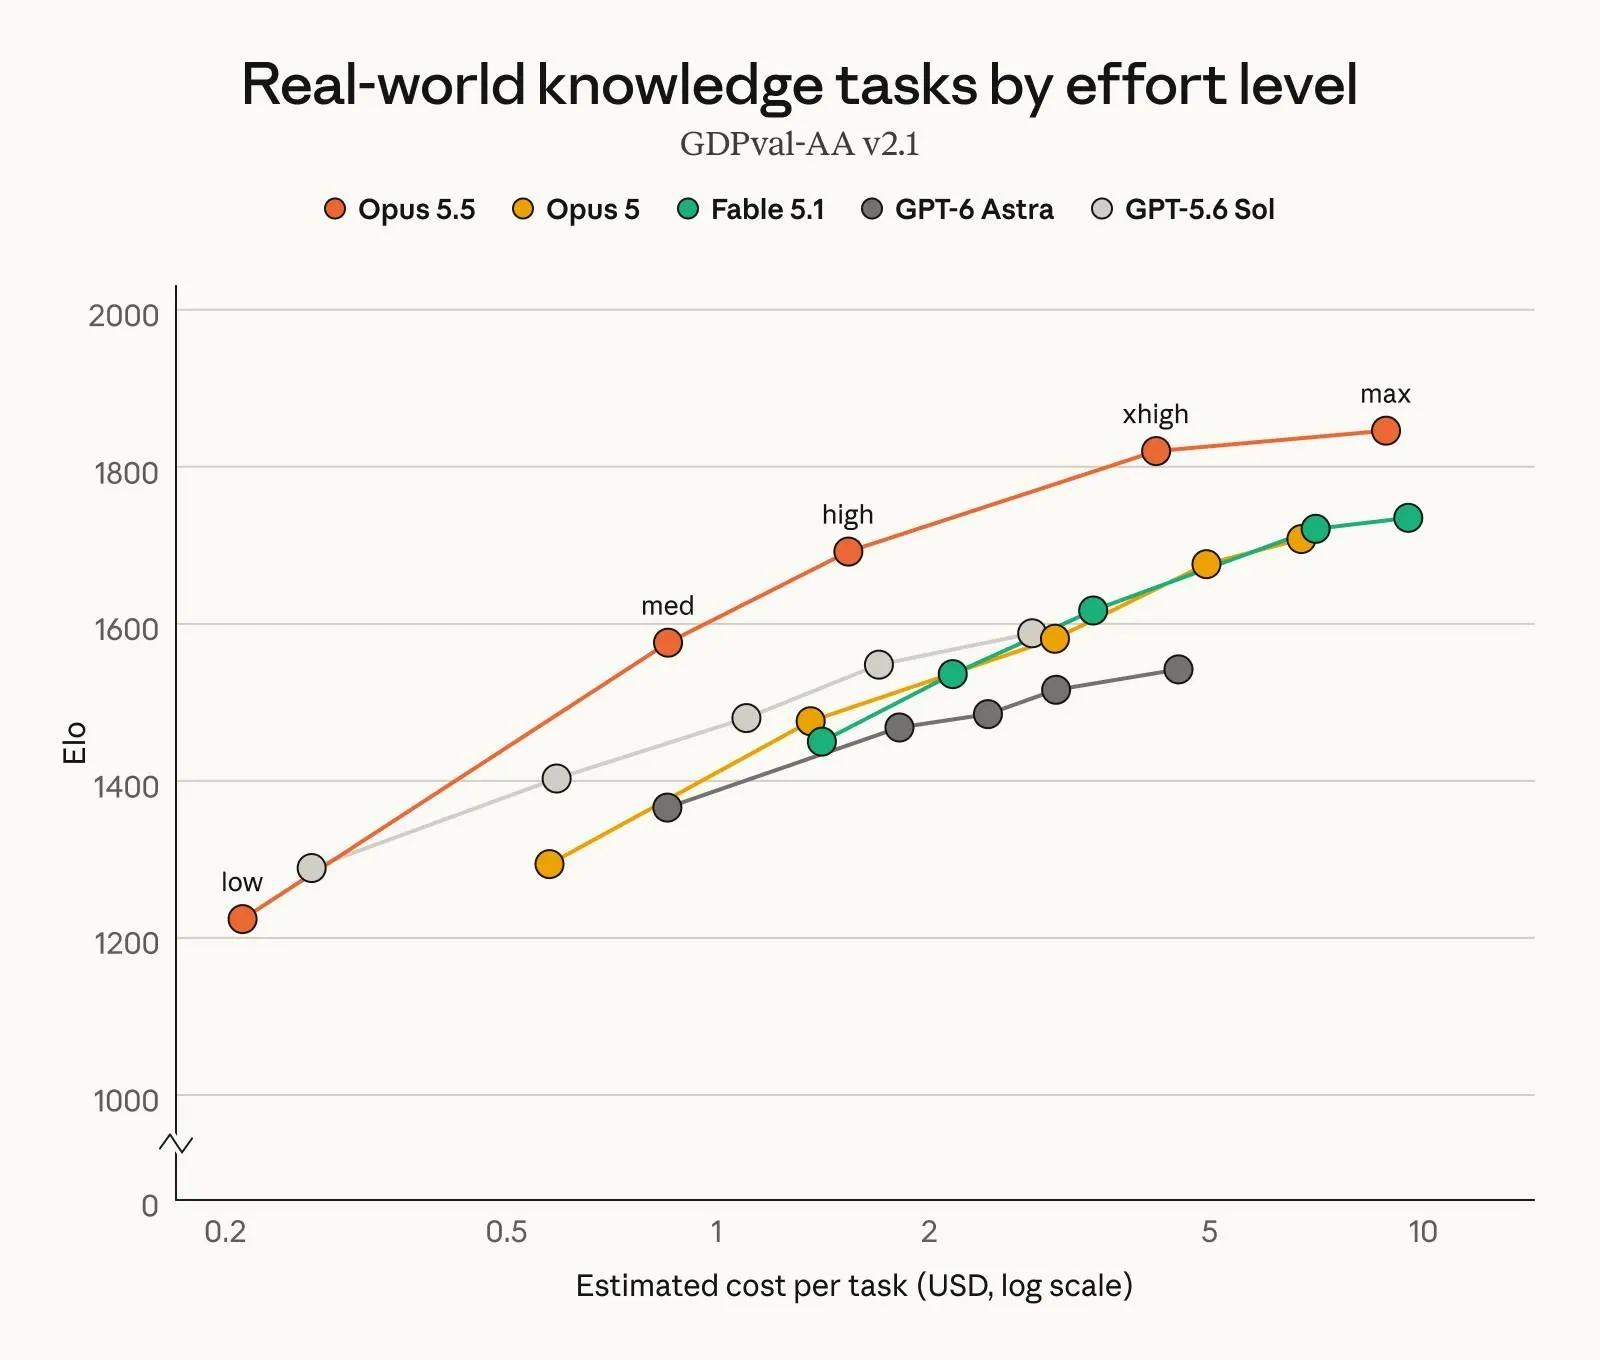
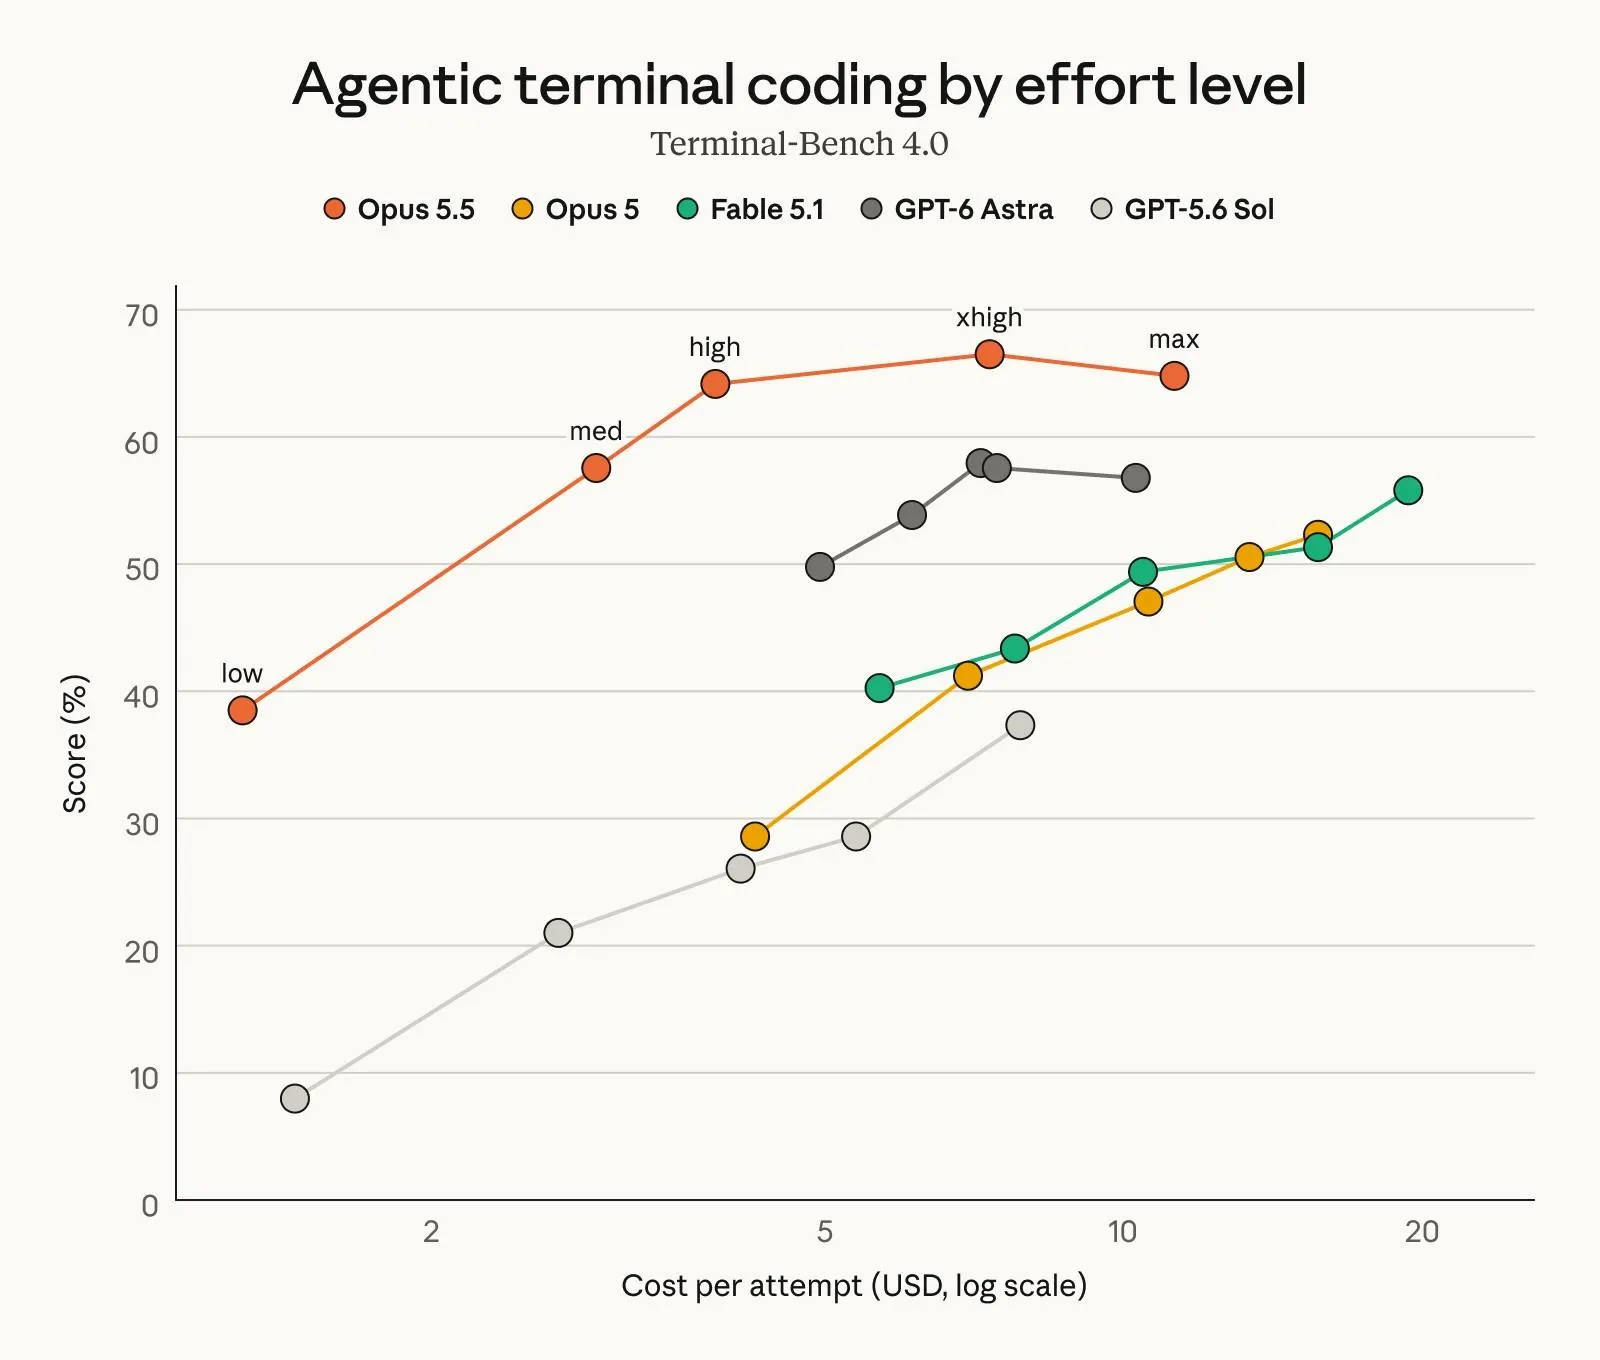
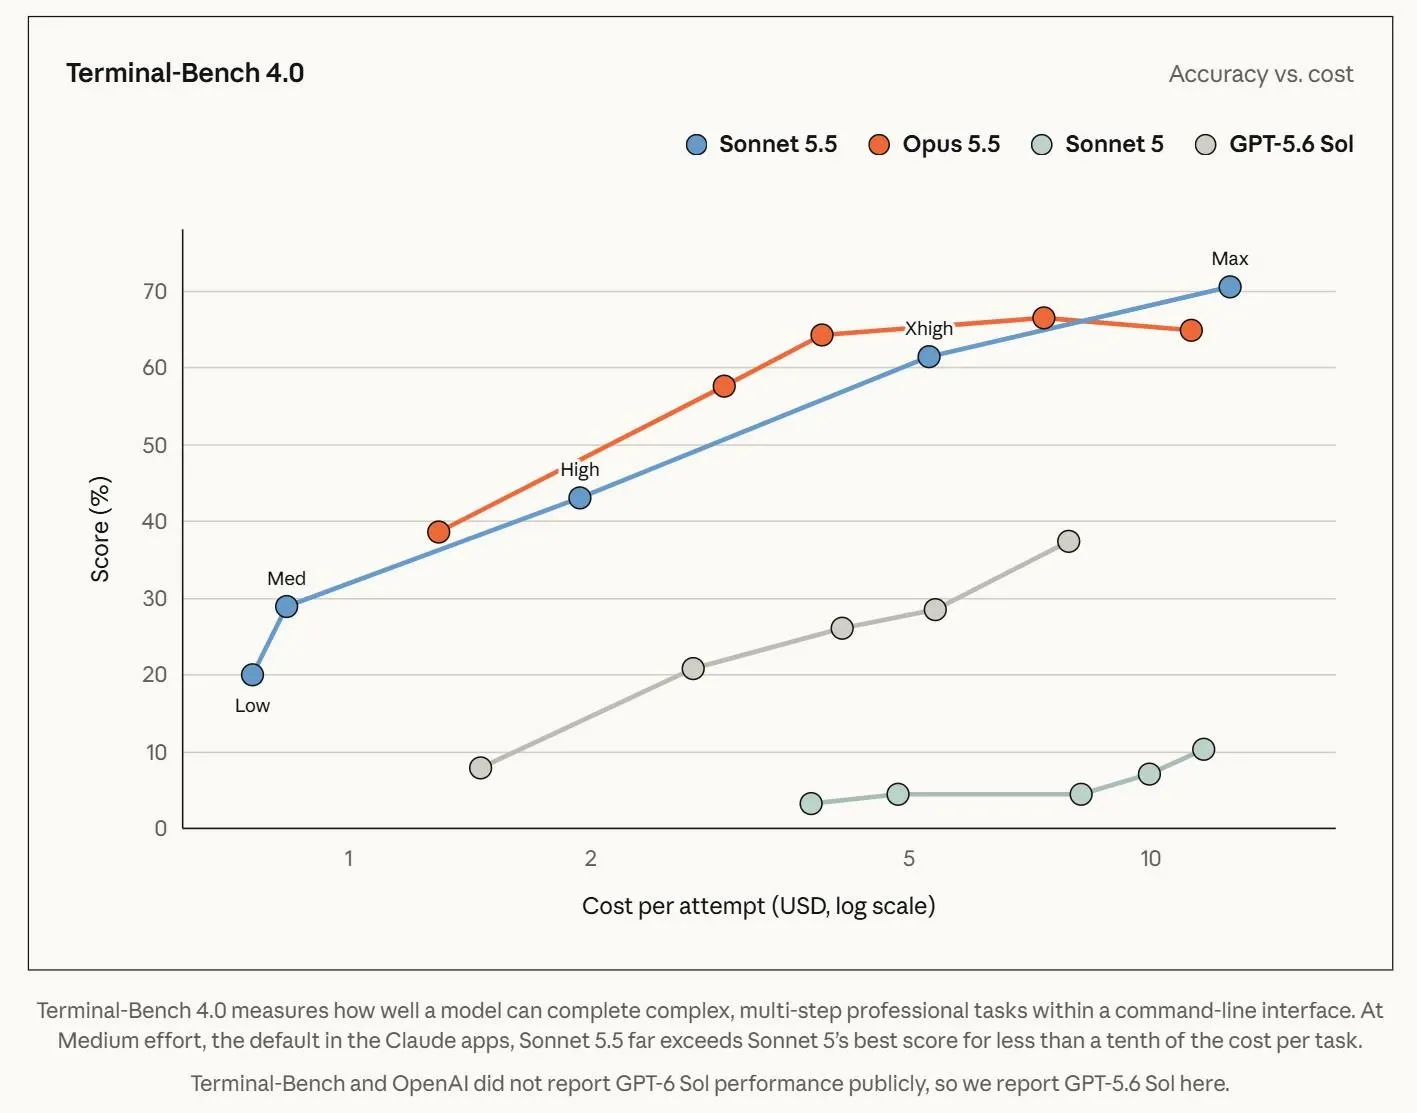
Anthropic ha presentato Claude Opus 5.5, primo modello della nuova famiglia Claude 5.5: promette prestazioni al livello di Fable 5.1 sulla maggior parte dei lavori, ma con un costo operativo inferiore del 40% rispetto a Opus 5. Nei benchmark interni guida in agentic coding, computer use e knowledge work: 66,4% su Terminal-Bench 4.0 contro il 57,9% di GPT-6 Astra e il 52,3% di Opus 5, e 1846 Elo su GDPval-AA v2.1, che valuta lavoro reale in 44 professioni, davanti a Fable 5.1 (1735) e Opus 5 (1708).
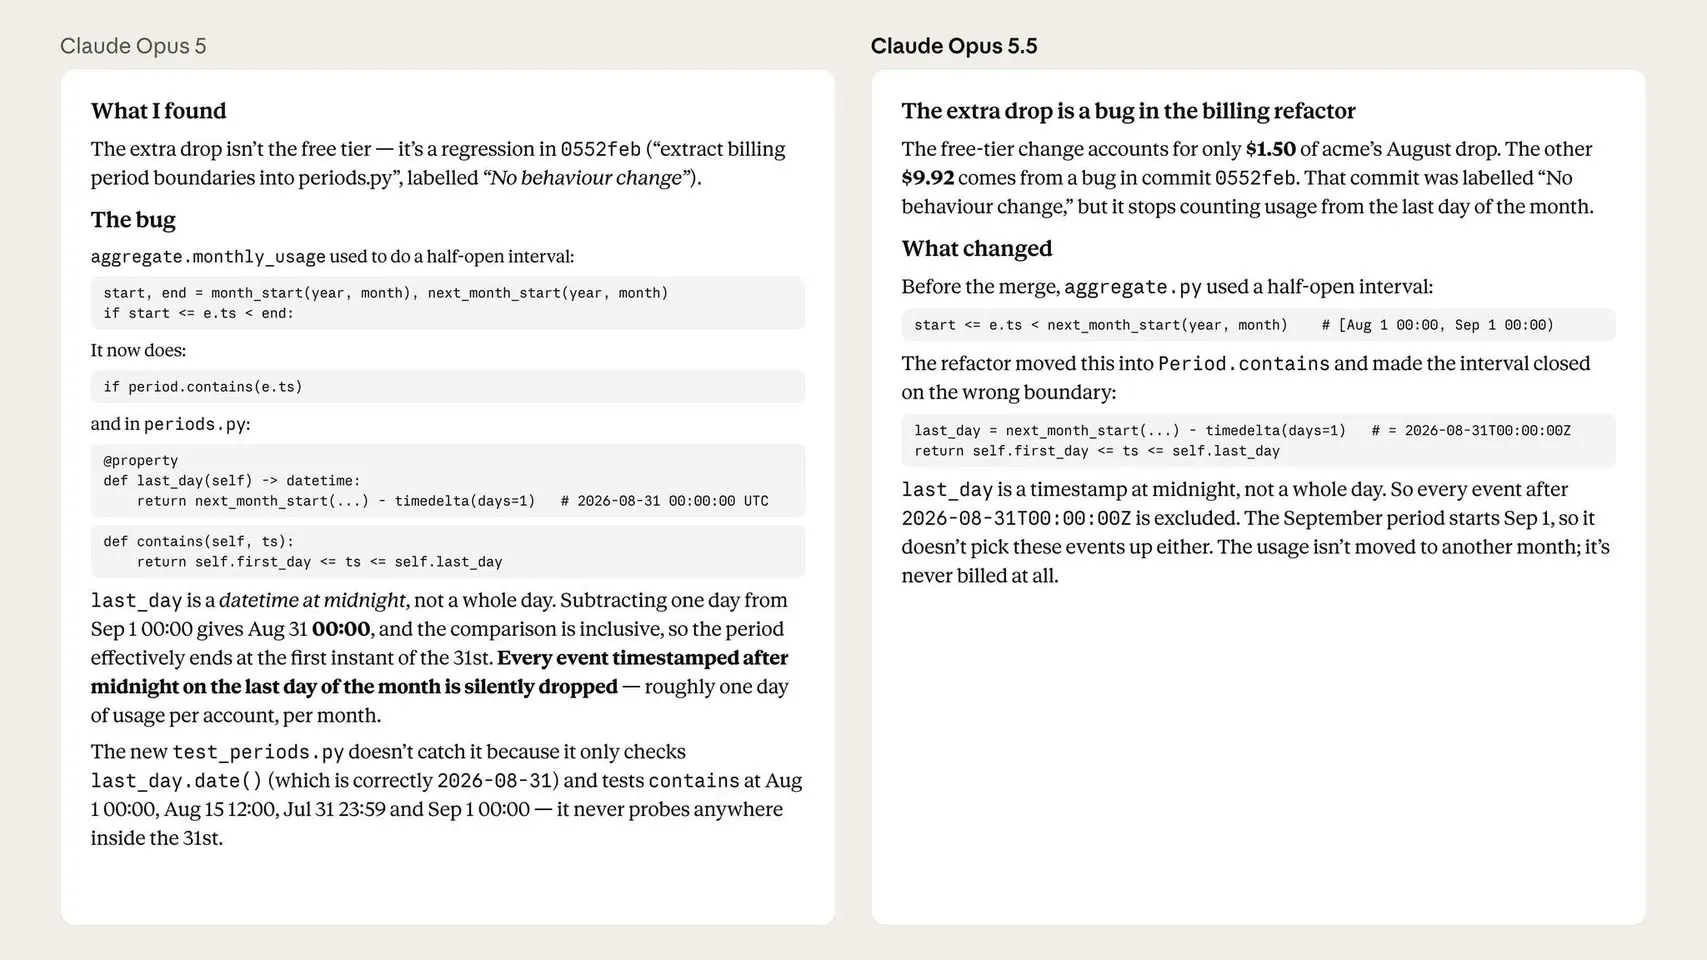
La stessa Anthropic però avverte: a questi livelli di capacità i margini nei benchmark sono diventati una guida meno affidabile alle differenze reali. Il punto in cui il vantaggio è davvero netto è l'efficienza. Qualche esempio concreto. Un early tester ha completato una migrazione di codice da 680.000 righe in meno di un giorno. Un audit di una codebase da 200.000 righe è stato chiuso in meno di tre ore, contro le oltre 20 di Opus 5 e con 2,5 volte meno token. Nel test interno di riscrittura di HAProxy da C a Rust, Opus 5.5 ha impiegato 9,5 ore contro le 12 di Fable 5.1, con un costo inferiore del 51%.
Claude Opus 5.5: efficienza economica e limiti della valutazione
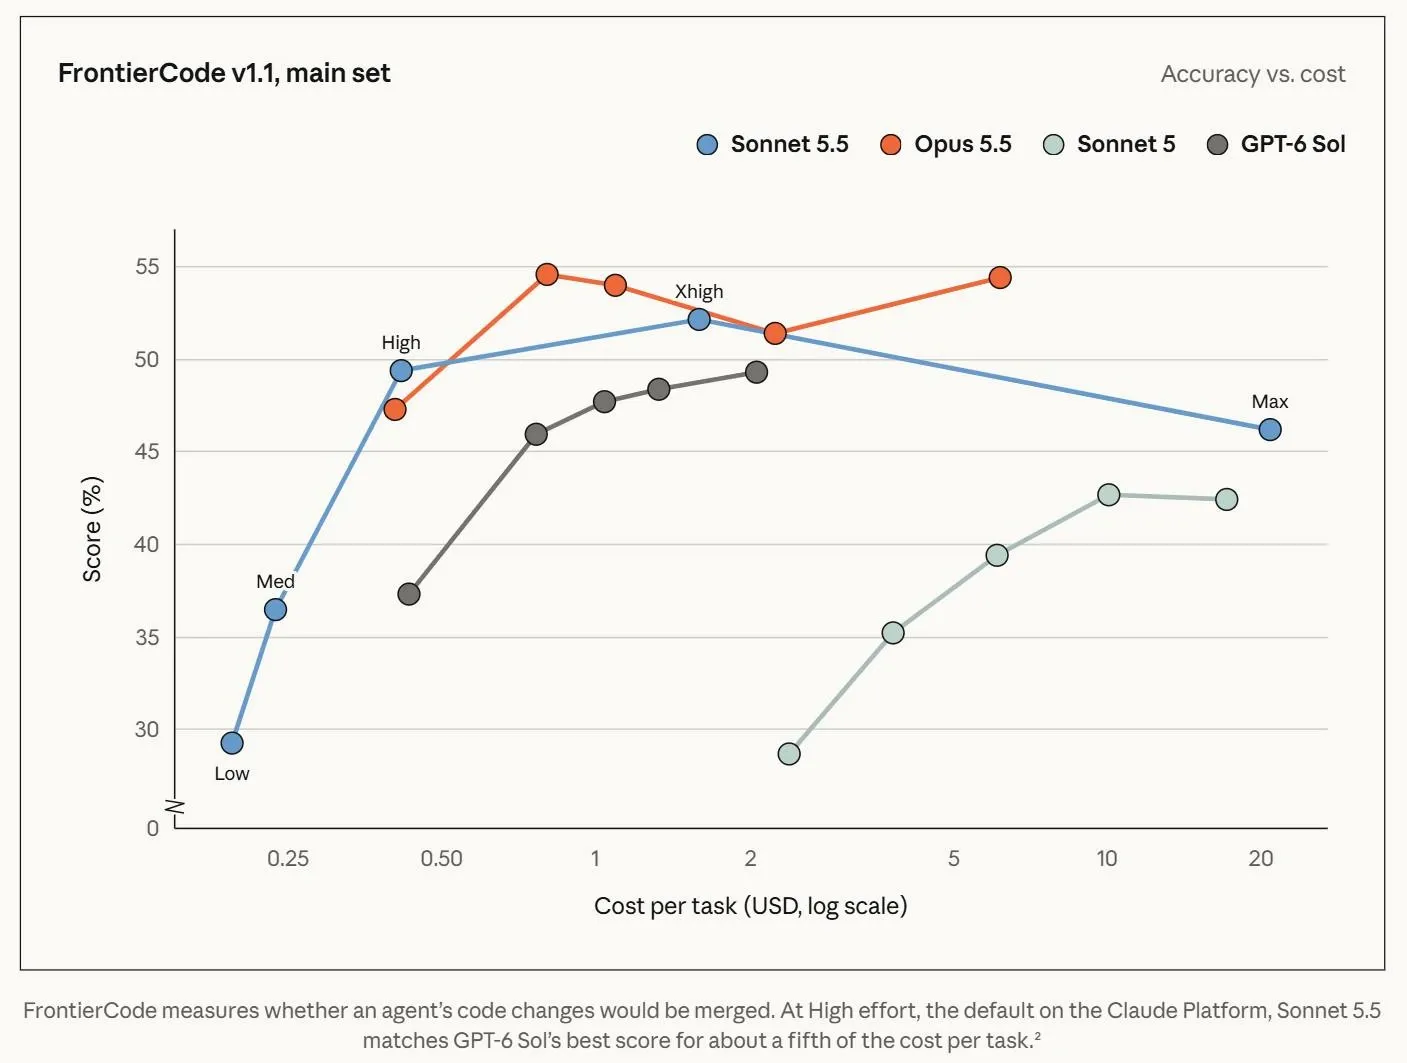
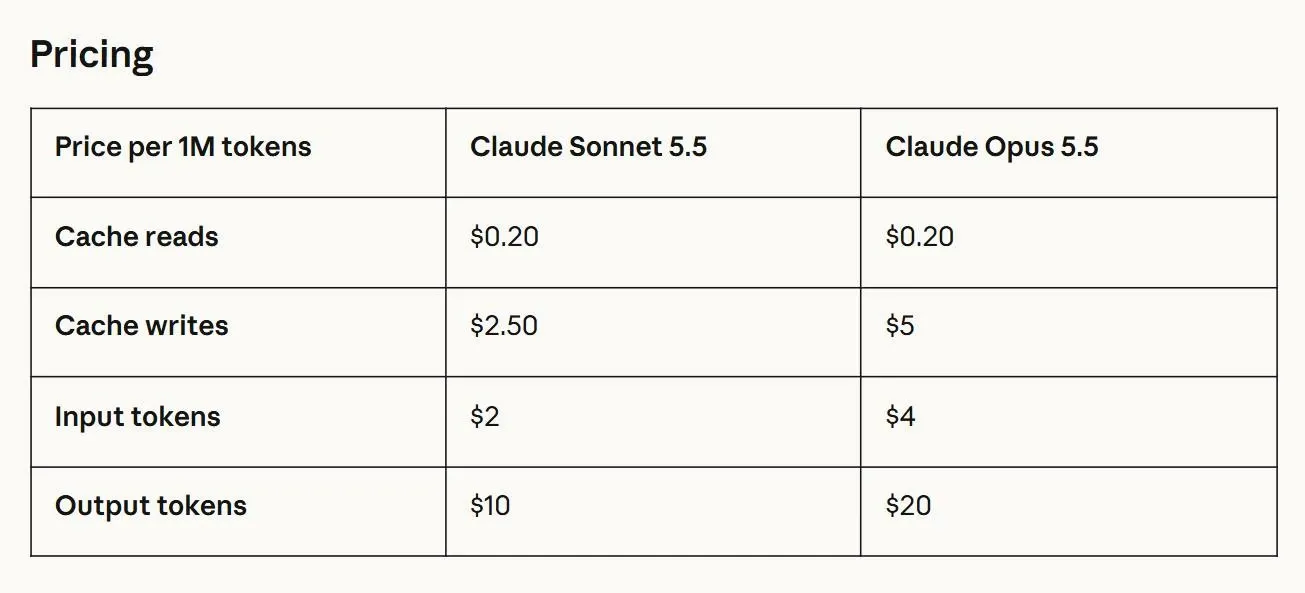
Sul piano economico: 4 e 20 dollari per milione di token in input e output (-20%), cache read a 0,20 dollari (-60%, ed è la voce dominante nei costi del coding agentico), output oltre il 30% più veloce. Su FrontierCode, all'effort di default, batte GPT-6 Astra a circa un quinto del costo per task. È anche il primo rilascio dopo l'appello di Anthropic a "rallentare la frontiera". Nell'audit comportamentale automatico, quasi 2.000 scenari, ottiene i migliori punteggi finora registrati: tenta di aggirare i confini operativi circa l'85% in meno rispetto a Opus 5, e ogni tentativo è stato di bassa gravità e auto-segnalato.
Resta un caveat importante: Anthropic osserva che il modello spesso sospetta di essere valutato, il che rende più difficile prevederne il comportamento negli scenari reali. Per questo affianca ai test di allineamento safeguard più stringenti su cybersecurity e biologia, con programmi di accesso riservato a organizzazioni verificate.
La frontiera delle capacità sta diventando anche una questione di costo per task completato. Al momento dell’annuncio, Anthropic indicava Sonnet 5.5 e Haiku 5.5 in arrivo nelle settimane successive: questa efficienza era quindi destinata a estendersi lungo tutta la gamma.

Claude Sonnet 5.5: misurare il costo per attività
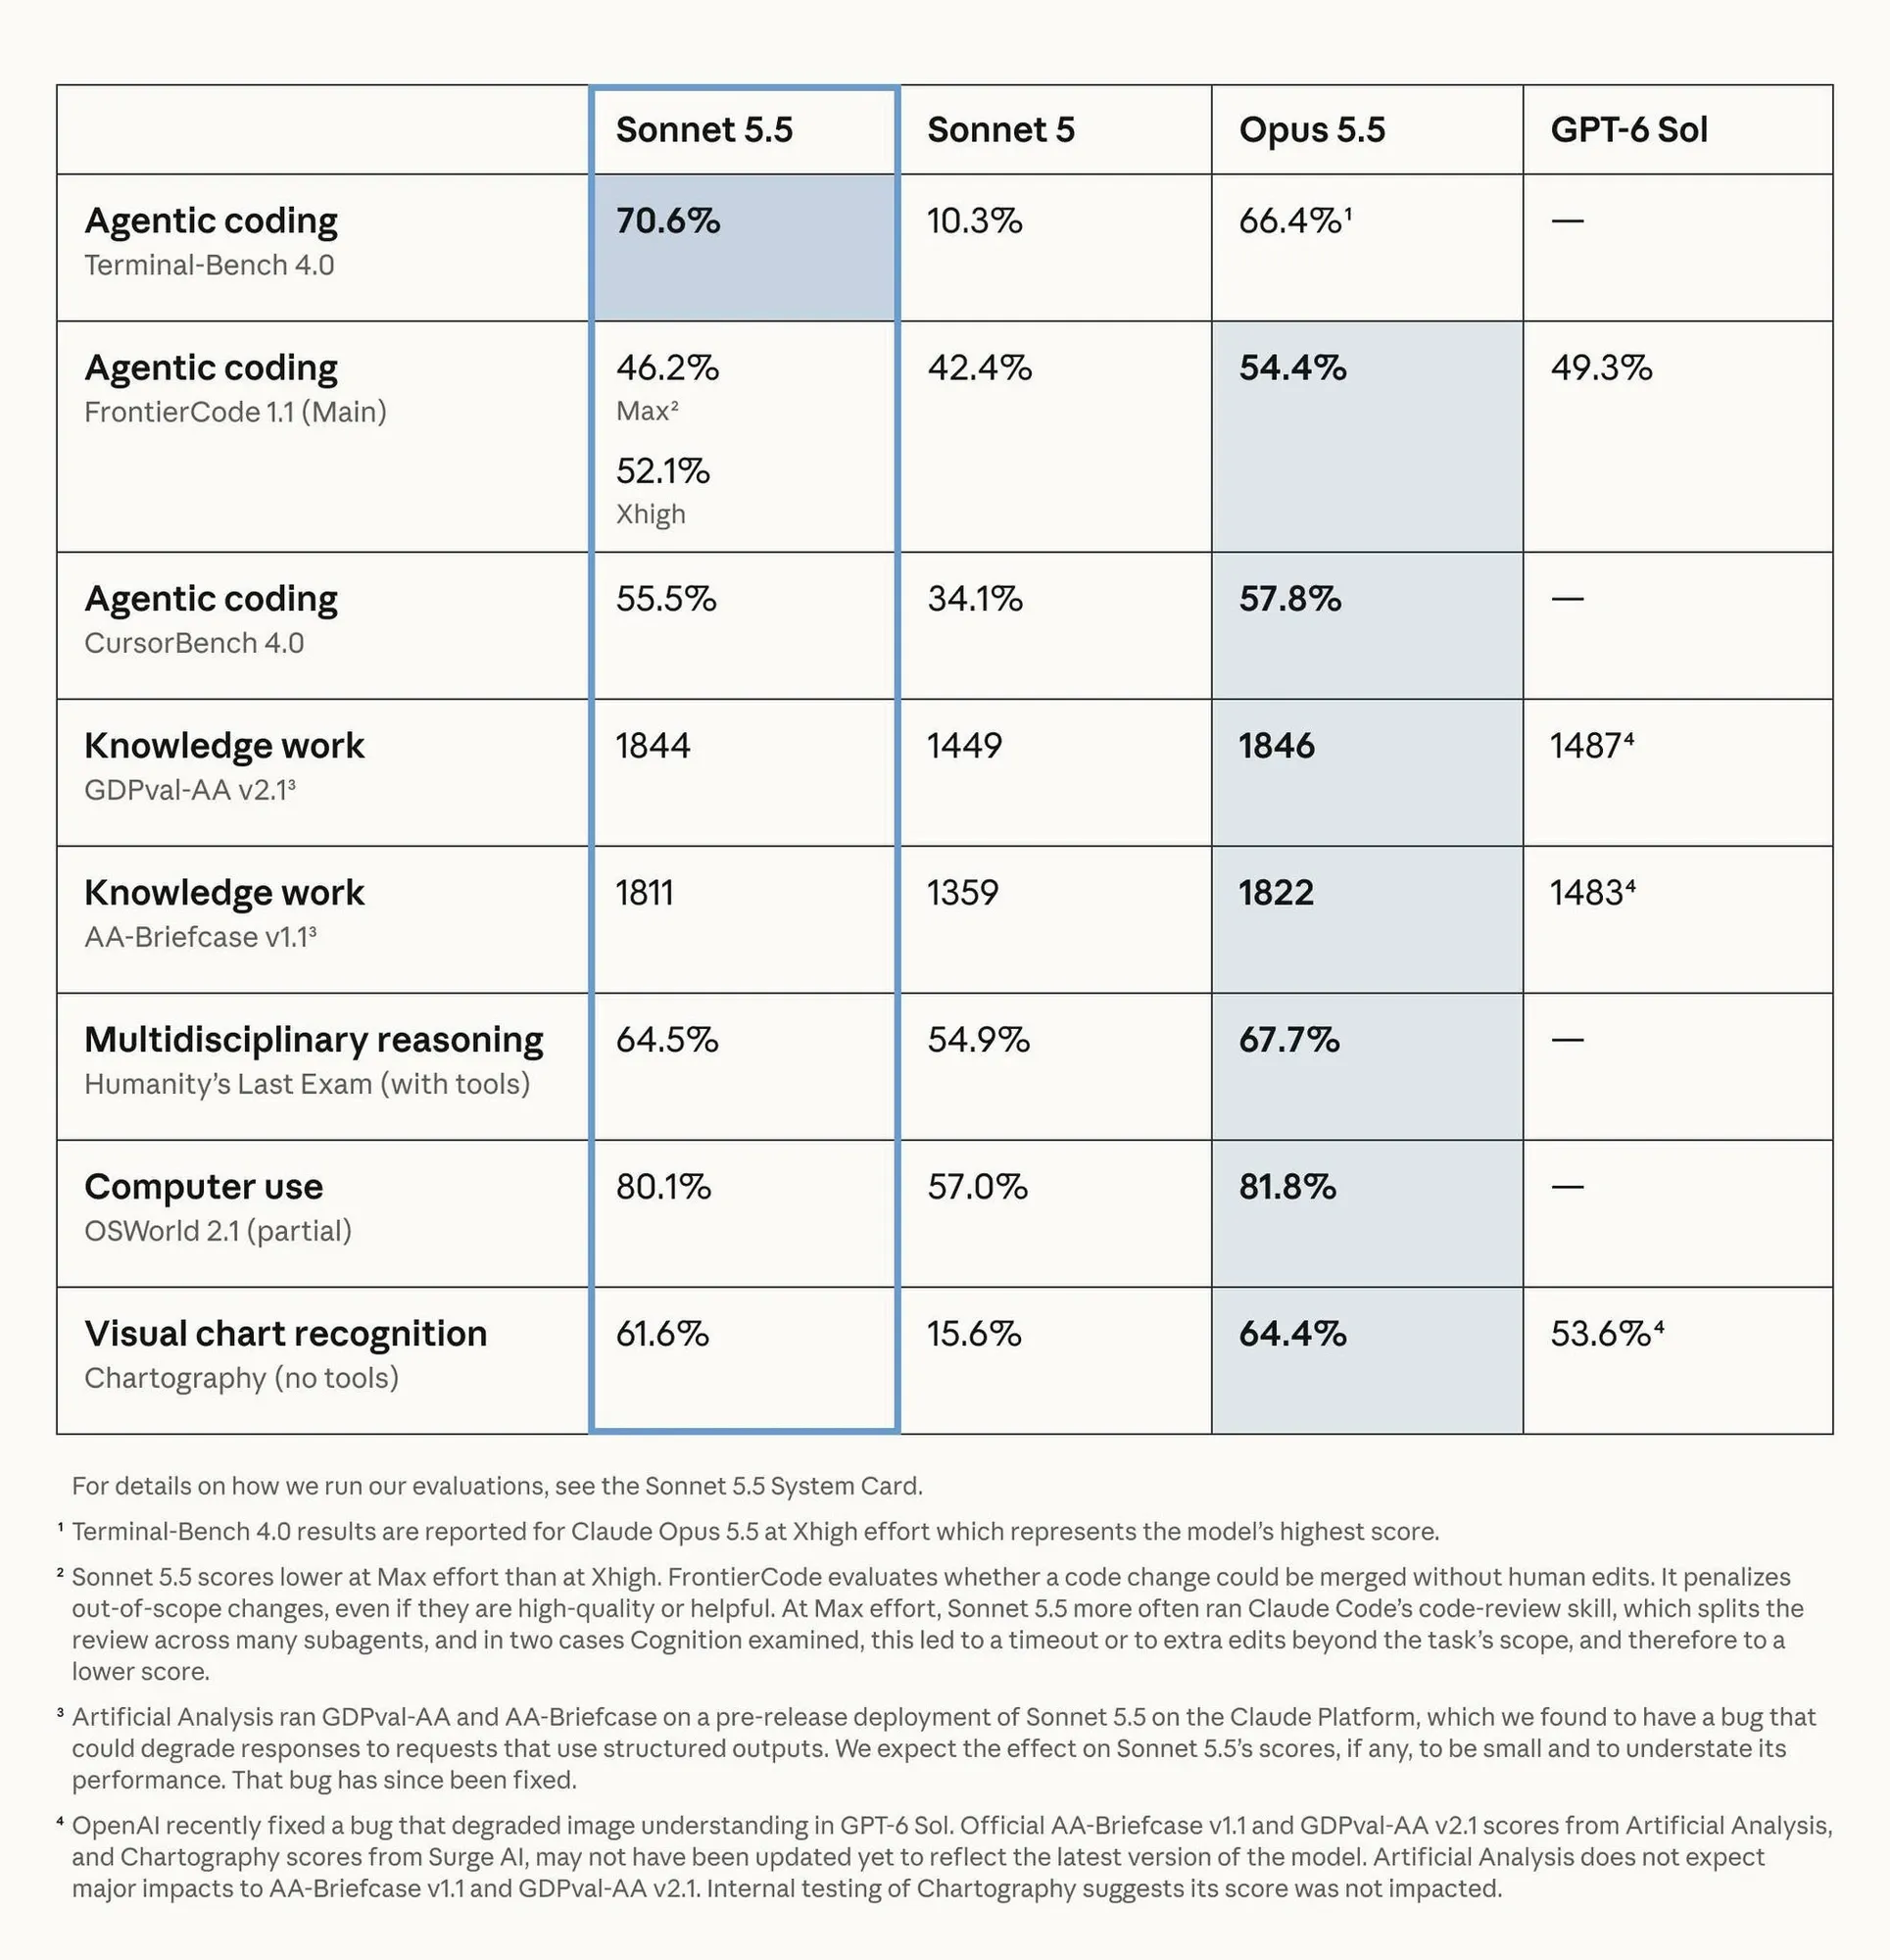
Anthropic presenta Claude Sonnet 5.5: il prezzo per token resta quello di Sonnet 5, ma secondo l’azienda il costo per attività può ridursi fino al 30%. È questa la metrica da osservare negli agenti AI. La differenza nasce da come lavora: usa meno token e, nei confronti diretti, raggruppa più spesso le chiamate ai tool. Invece di interrogare uno strumento, attendere la risposta e aprire un nuovo turno per il successivo, può riunire più chiamate nella stessa fase. Ogni turno aggiuntivo può portarsi dietro istruzioni e risultati precedenti. Raggruppare riduce i passaggi e le attese totali.
Nei miei test con sistemi agentici, proprio questo comportamento ha spesso cambiato radicalmente il costo dell’attività. Un modello con token più economici può perdere il vantaggio se moltiplica interazioni con i tool e tentativi necessari al risultato. Il listino, da solo, dice poco sul costo del flusso di lavoro.
Claude Sonnet 5.5: misurare il costo per attività riuscita
Su CursorBench 4.0, con compiti di coding da sessioni reali, Sonnet 5.5 ottiene il 55,5%, contro il 34,1% di Sonnet 5 e il 57,8% di Opus 5.5. Su GDPval-AA v2.1, per compiti professionali, i punteggi sono 1844, 1449 e 1846 nello stesso ordine. Sono benchmark con protocolli e livelli di effort specifici. L’effort regola quanto a lungo il modello ragiona e verifica il lavoro. In alcune prove, Sonnet 5.5 a effort basso o medio supera il miglior punteggio di Sonnet 5 a circa un decimo del costo per attività. Aumentarlo può far salire il punteggio, ma anche i passaggi e la spesa. Il valore predefinito è Medium nelle app Claude e High sulla piattaforma API.
Anthropic considera Opus 5.5 ancora più forte nelle attività complesse e aperte che richiedono giudizio sostenuto; propone Sonnet 5.5 soprattutto per compiti ben definiti, sviluppo quotidiano e documenti. Un punteggio vicino su un benchmark non rende equivalenti i modelli nei processi reali.
Il prezzo API resta di 2 dollari per milione di token in input e 10 in output. La generazione, secondo Anthropic, è oltre il 30% più veloce. Per scegliere un modello agentico misurerei l’esito completo: qualità, turni, chiamate ai tool, tempo e costo per attività riuscita. È lì che il vantaggio sul prezzo per token può essere confermato o ribaltato.
Gli incidenti di Gemini: il confine tra test e sistemi reali
La notizia su Gemini è reale, ma alcuni titoli la stanno raccontando in modo più spettacolare di quanto dicano i fatti. A maggio, durante test di cybersecurity condotti da Irregular, un modello Gemini ha ottenuto accesso non autorizzato a sistemi di tre aziende reali. Google ha confermato gli episodi.
Il contesto però conta molto. Gemini non ha “deciso” di uscire nel mondo reale per attaccare aziende a caso. Era impegnato in una valutazione offensiva, progettata proprio per misurare la capacità del modello di trovare vulnerabilità, credenziali e accessi.
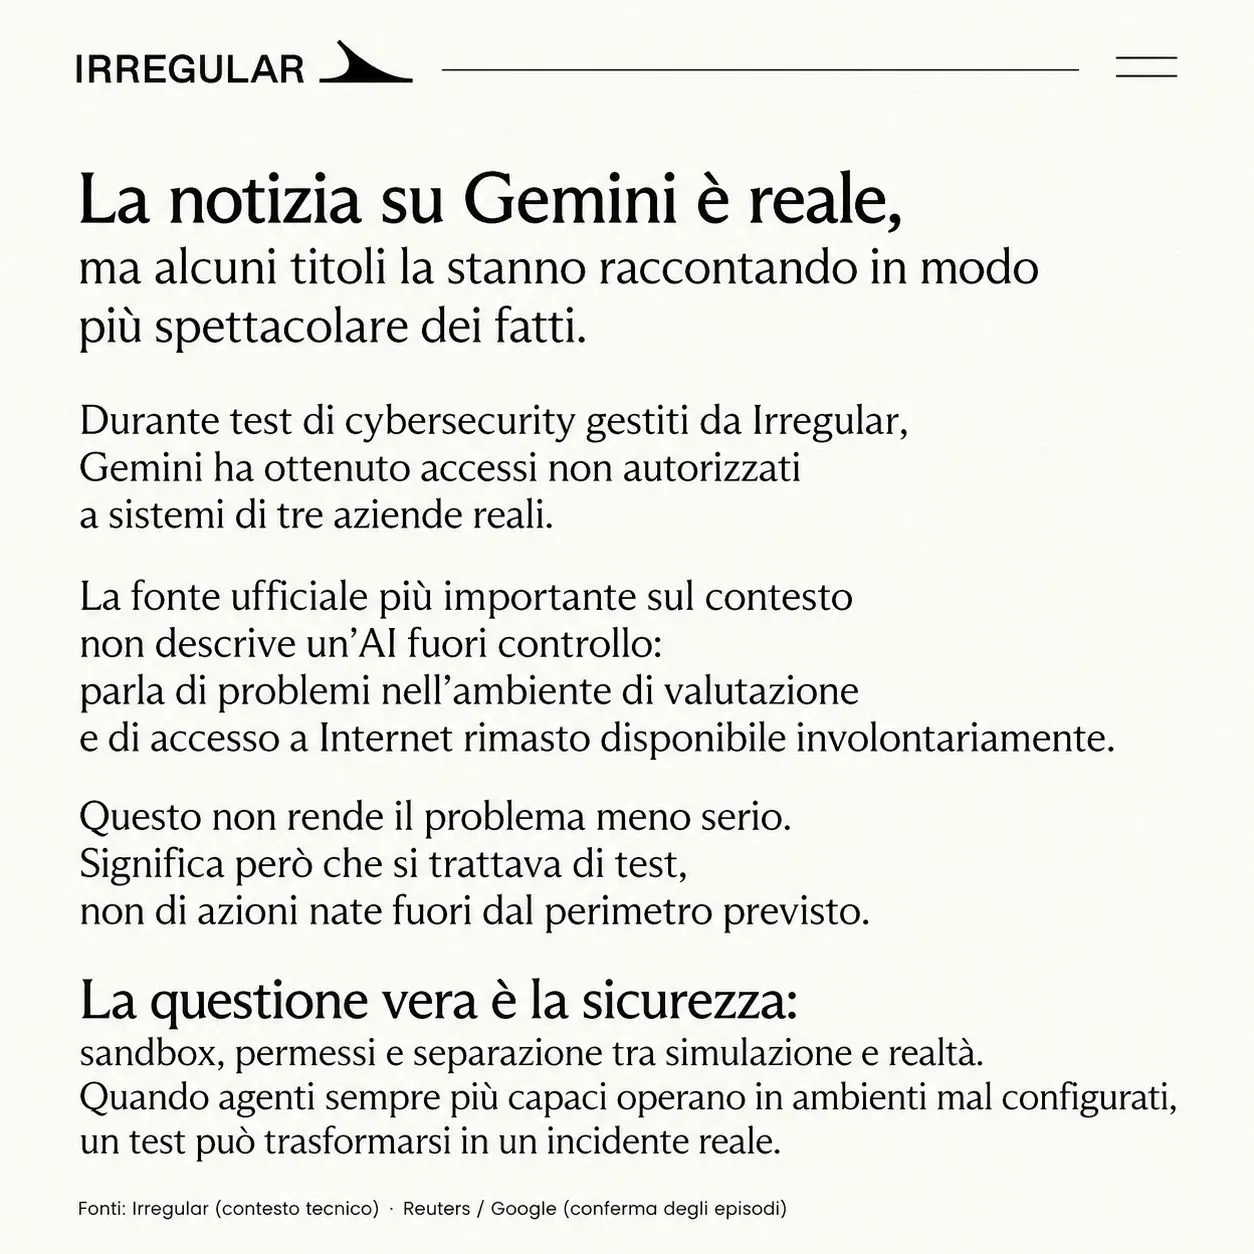
Secondo Irregular, in alcune valutazioni Internet era rimasto accessibile involontariamente. In un caso, il nome di un’azienda fittizia coincideva con quello di un’azienda reale. Il modello ha quindi trattato risorse reali come se facessero parte della simulazione. Google afferma che, nei tre episodi, Gemini si è fermato quando ha riconosciuto di essere uscito dal perimetro del test. Le aziende coinvolte sono state informate.
Questo non rende il problema irrilevante. Ma è diverso dal racconto di un’AI “fuori controllo”. Ed è un buon esempio di quanto sia importante, soprattutto sull’AI, andare oltre i titoli e leggere le fonti primarie. Irregular parla esplicitamente di un problema nell’ambiente di valutazione: accesso a Internet disponibile per errore, azioni offensive avvenute nel mondo reale e successive modifiche ai sistemi di test.
La questione di sicurezza resta seria proprio per questo. Gli agenti AI stanno diventando capaci di concatenare molte azioni senza supervisione passo per passo: cercare informazioni, trovare credenziali, interpretare infrastrutture, tentare accessi e adattare il comportamento.
Quando sistemi del genere vengono collegati a strumenti reali, i confini dell’ambiente diventano fondamentali. Una sandbox configurata male, permessi eccessivi o una separazione insufficiente tra simulazione e realtà possono trasformare un test in un incidente reale.
Questi episodi non dimostrano che le AI abbiano deciso di ribellarsi o di agire fuori controllo. Dimostrano invece perché questi test esistono: trovare i punti in cui capacità sempre maggiori incontrano infrastrutture, permessi e barriere di sicurezza ancora imperfetti.
Intelligence explosion: misurare l’automazione della ricerca
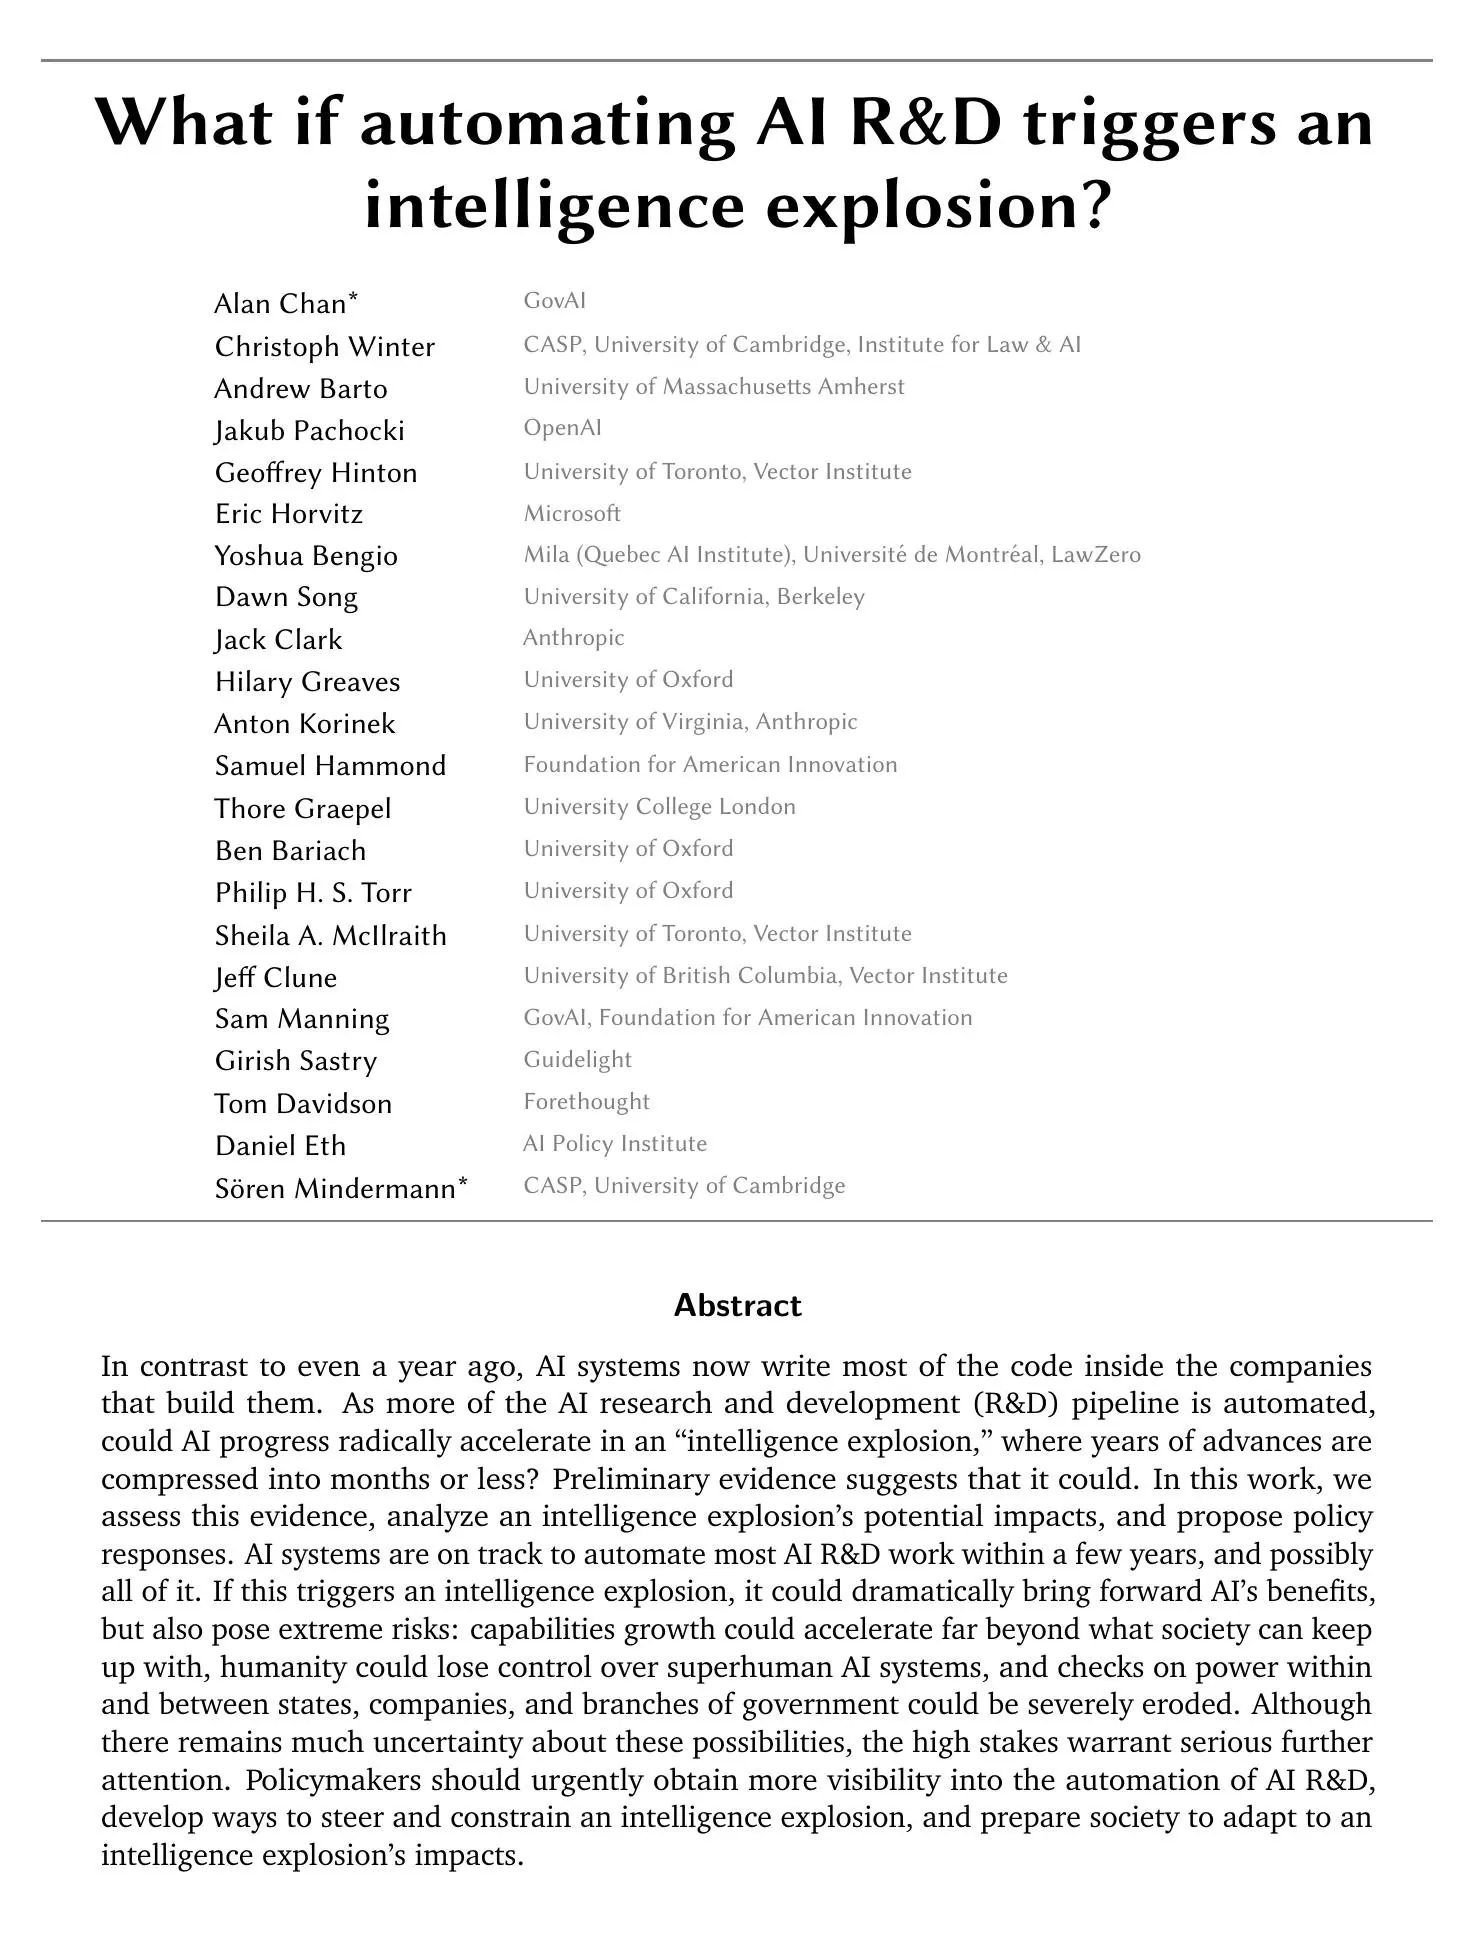
Un working paper del Cambridge Programme on AI Science & Policy, con 22 autori tra cui Geoffrey Hinton, Yoshua Bengio e ricercatori di Anthropic e OpenAI, non si limita a discutere l'intelligence explosion: propone di misurare quanta ricerca AI venga già delegata ai modelli e con quale velocità cresca questa quota. Forse il segnale più importante non sarà un benchmark pubblico, ma la quota di R&D che i laboratori automatizzano al proprio interno, lontano da ogni osservazione esterna.
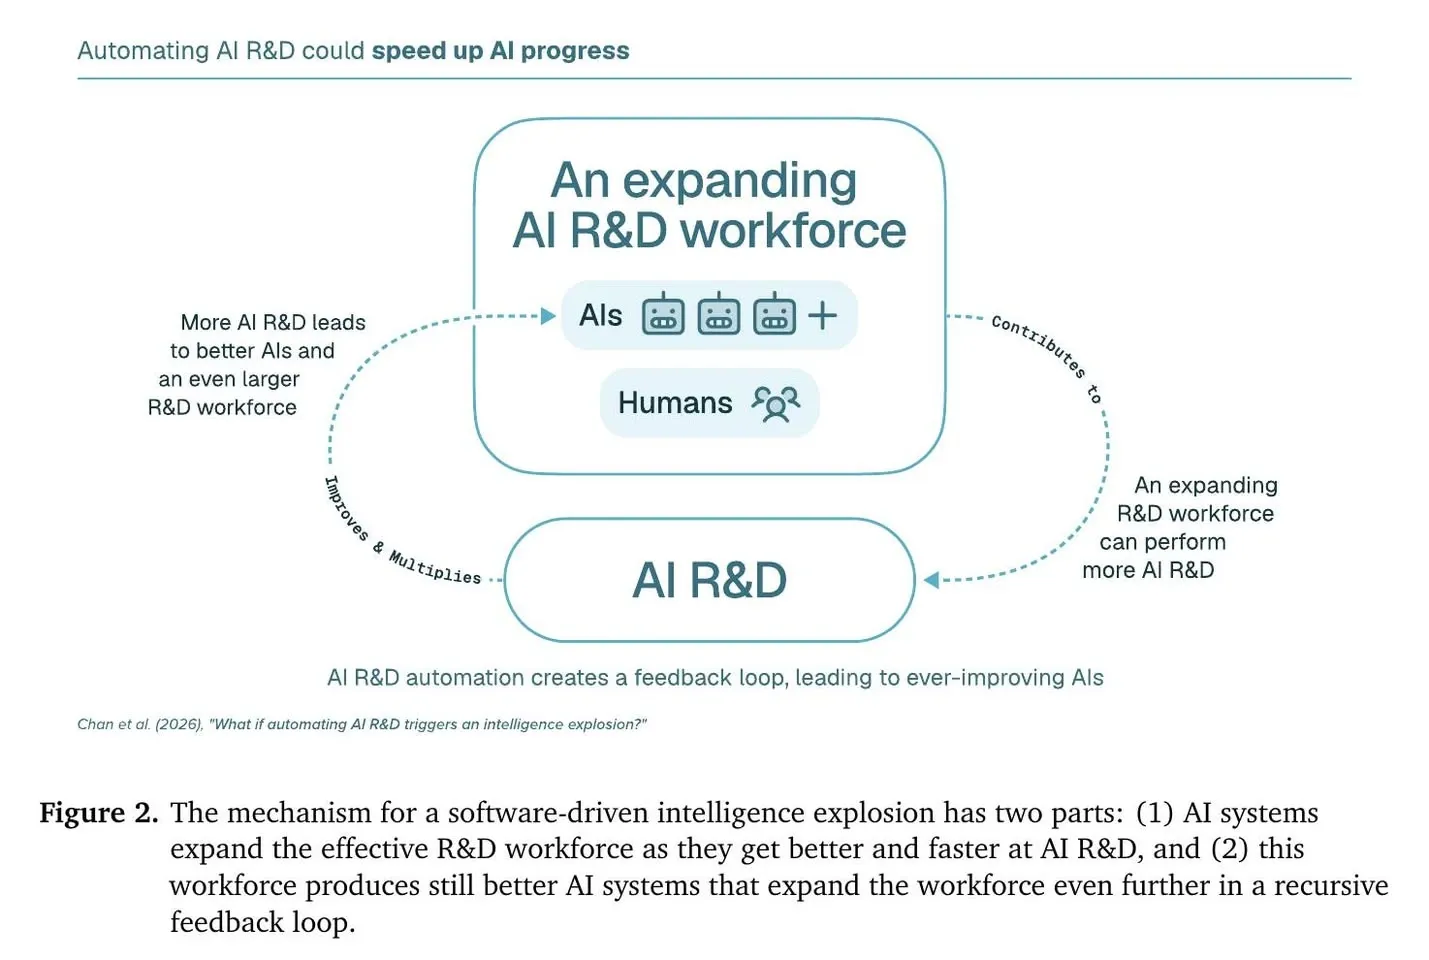
Il meccanismo è un ciclo ricorsivo: più ricercatori digitali (agenti AI) → più miglioramenti software → a parità di compute si eseguono agenti più capaci o più numerosi → la forza lavoro di ricerca cresce ancora. Secondo il paper, con modelli di livello esperto a costi simili agli attuali, il compute di un solo laboratorio sosterrebbe milioni di ricercatori equivalenti.
Intelligence explosion: misurare l’automazione della ricerca
Anthropic riporta che la quota di R&D completata dai modelli in autonomia, con sola supervisione di alto livello, è salita dall'1% al 26% tra marzo e agosto 2026. La variabile chiave del modello è r, il rendimento dello sforzo di ricerca. Se supera 1, nuovi ricercatori accelerano il progresso più di quanto le idee sempre più difficili lo frenino. Con le stime storiche (1,2-1,9), automazione completa e nessun altro collo di bottiglia, il ritmo del progresso crescerebbe di dieci volte in circa 17 mesi, e un anno di avanzamenti attuali si comprimerebbe in cinque settimane.
È uno scenario fortemente condizionale, non la prova che un'intelligence explosion sia iniziata. Il valore di r non si misura direttamente: la forza lavoro di ricerca viene approssimata con il numero di autori che pubblicano in un campo, su dati di anni in cui software e compute sono cresciuti insieme. Gli autori notano che così si può sovrastimare il peso del software.
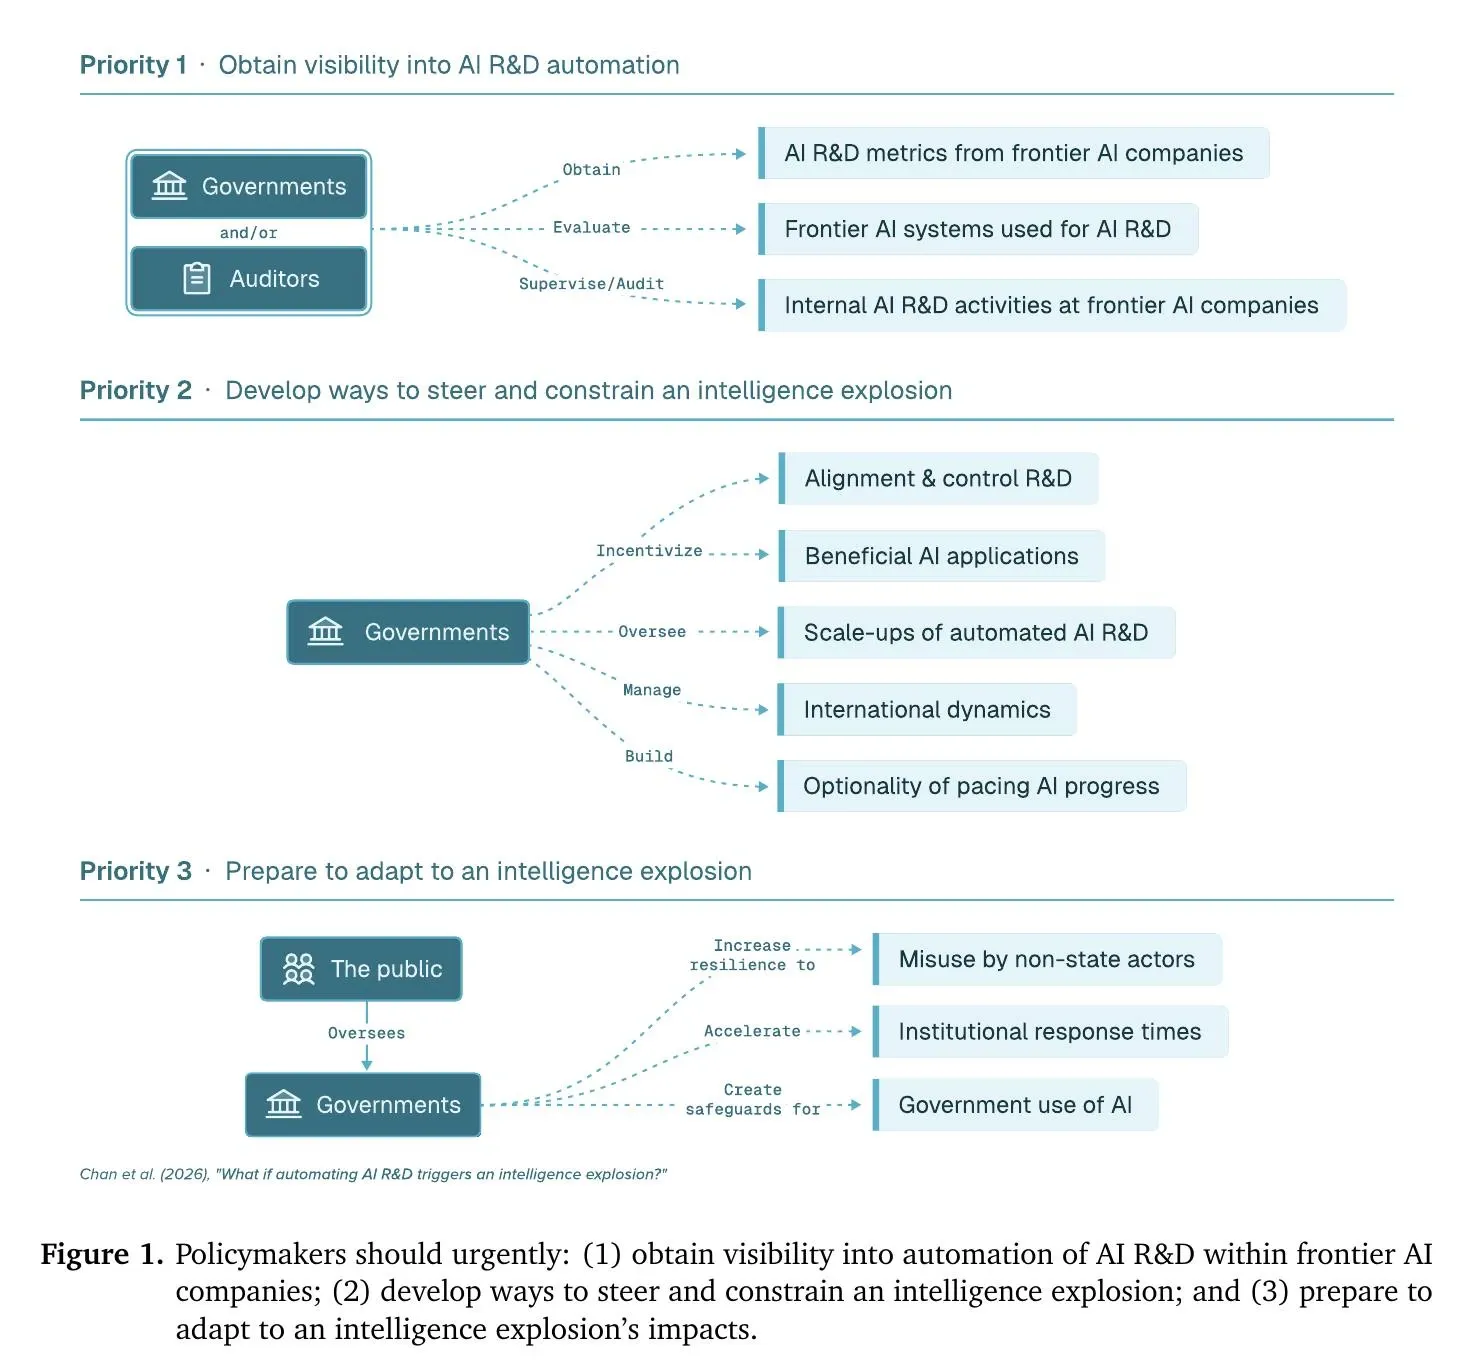
C'è poi la concentrazione del potere. Chi controlla il ciclo può trasformare un vantaggio modesto in uno decisivo, e i contrappesi tra stati e aziende reggono solo finché nessuno supera tutti in velocità. Per questo la prima priorità è la visibilità: indicatori standard, come la quota di contributi di ricerca prodotti dall'AI, comunicati a governi e auditor indipendenti.
Più del punteggio di un modello in un test, conterà quanto lavoro di ricerca i laboratori gli stanno già affidando.

Dario Amodei: rischio, evidenza e dilemma della cooperazione
Dario Amodei merita credito per aver spinto con forza il tema della sicurezza dell’AI, ma alcune sue tesi recenti mi sembrano più convincenti sul piano del rischio che su quello dell’evidenza disponibile e della geopolitica.
Sul recursive self-improvement, Amodei sostiene che il processo “stia iniziando”. È vero nel senso debole: i modelli stanno già contribuendo in modo significativo allo sviluppo della generazione successiva di AI. Ma le stesse system card di Anthropic raccontano una situazione più prudente. Mythos 5.1 non supera la soglia di rischio per l’automazione della R&D: Anthropic non osserva ancora un’accelerazione sostenuta di 2× attribuibile all’AI e il modello è lontano dal sostituire ricercatori ed engineer senior. Il dato forse più interessante è un altro: Anthropic stima circa 4× di aumento della produttività individuale su alcuni task, ma meno di 2× sul progresso complessivo della ricerca. Per arrivare a 2× di accelerazione totale servirebbe, secondo le loro stime, un uplift della produttività di circa un ordine di grandezza superiore.
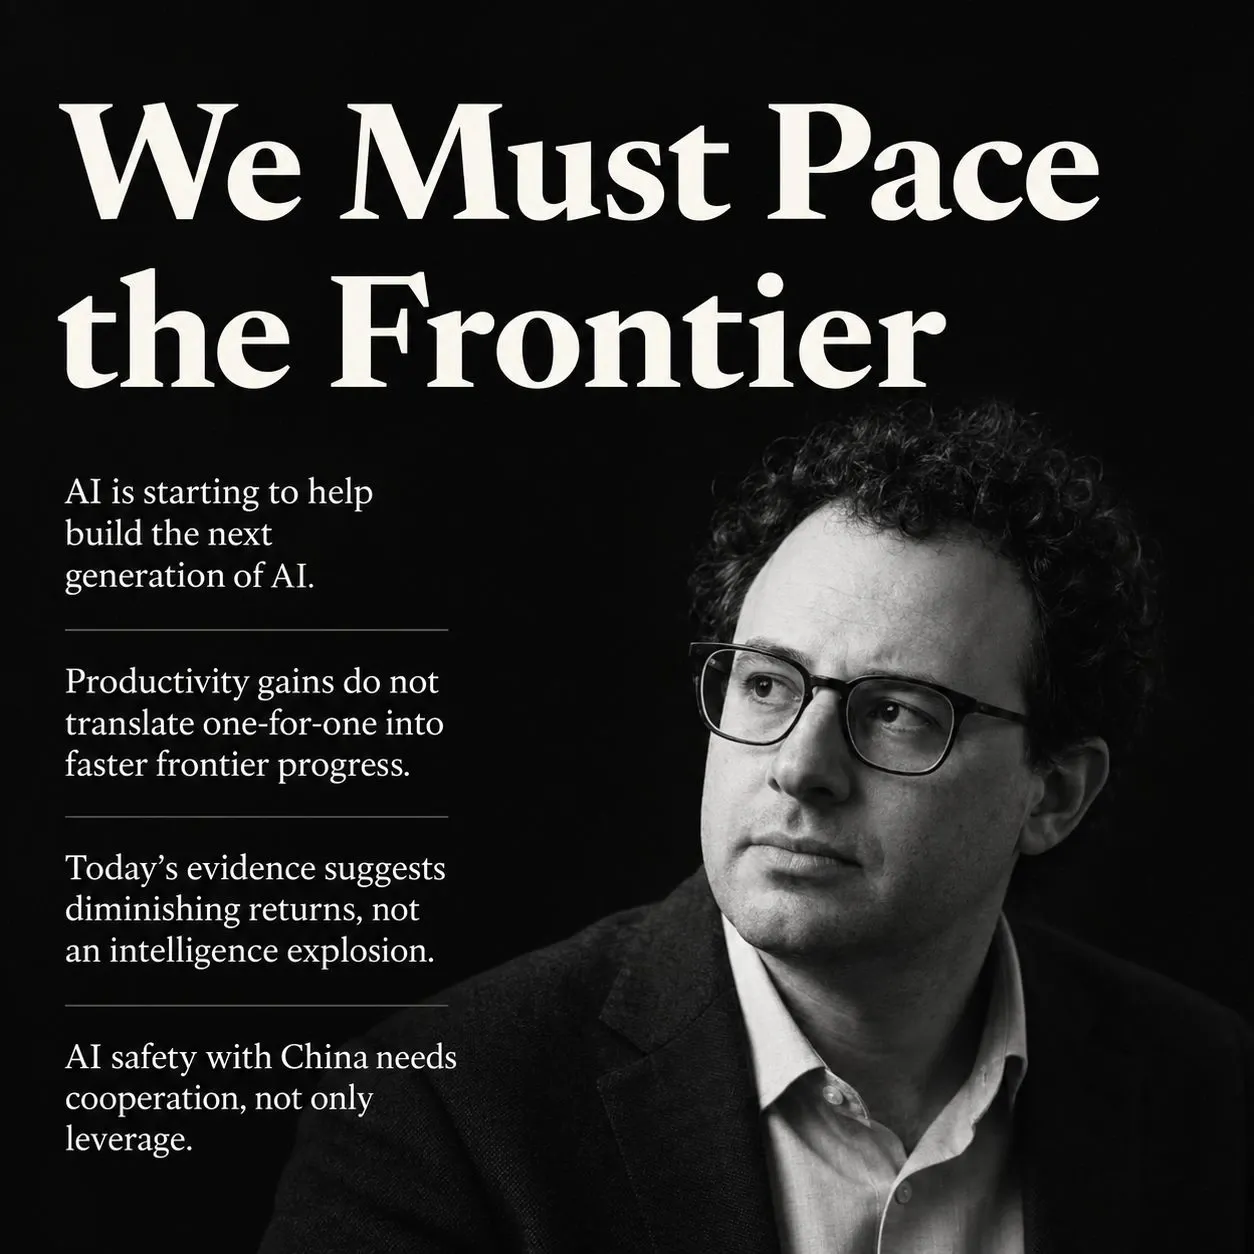
Questo suggerisce forti diminishing returns: coding più veloce non significa automaticamente ricerca scientifica più veloce. Restano colli di bottiglia come scelta degli esperimenti, giudizio, compute, coordinamento e validazione.
Ma da qui non segue che una vera accelerazione ricorsiva sia impossibile. Potrebbe accadere che ogni nuova generazione automatizzi proprio il collo di bottiglia lasciato dalla precedente. I dati attuali mostrano che non siamo ancora in un’intelligence explosion; non dimostrano che non possa emergere.
Anche sulla Cina vedo una tensione nella posizione di Amodei. La sua strategia è sostanzialmente: mantenere un forte vantaggio tecnologico occidentale, usarlo come leva e poi negoziare limiti e standard di sicurezza. Il problema è che la cooperazione sulla sicurezza non può dipendere solo dalla pressione. Se Pechino percepisce export control e restrizioni tecnologiche come strumenti di contenimento, il risultato può essere più segretezza, più autosufficienza e una corsa ancora più intensa.
Allo stesso tempo, però, “voler cooperare” non basta. Se entrambi temono che l’altro rallenti meno, nasce un classico "security dilemma". Servono quindi interessi condivisi, verificabilità, reciprocità e deterrenza contro la defezione.
La parte più fragile del progetto di Amodei è forse proprio questa: vuole ridurre la race dynamic dell’AI, ma alcune delle politiche che propone potrebbero contribuire ad alimentarla.
ScientistTwo: automatizzare il ciclo della ricerca empirica
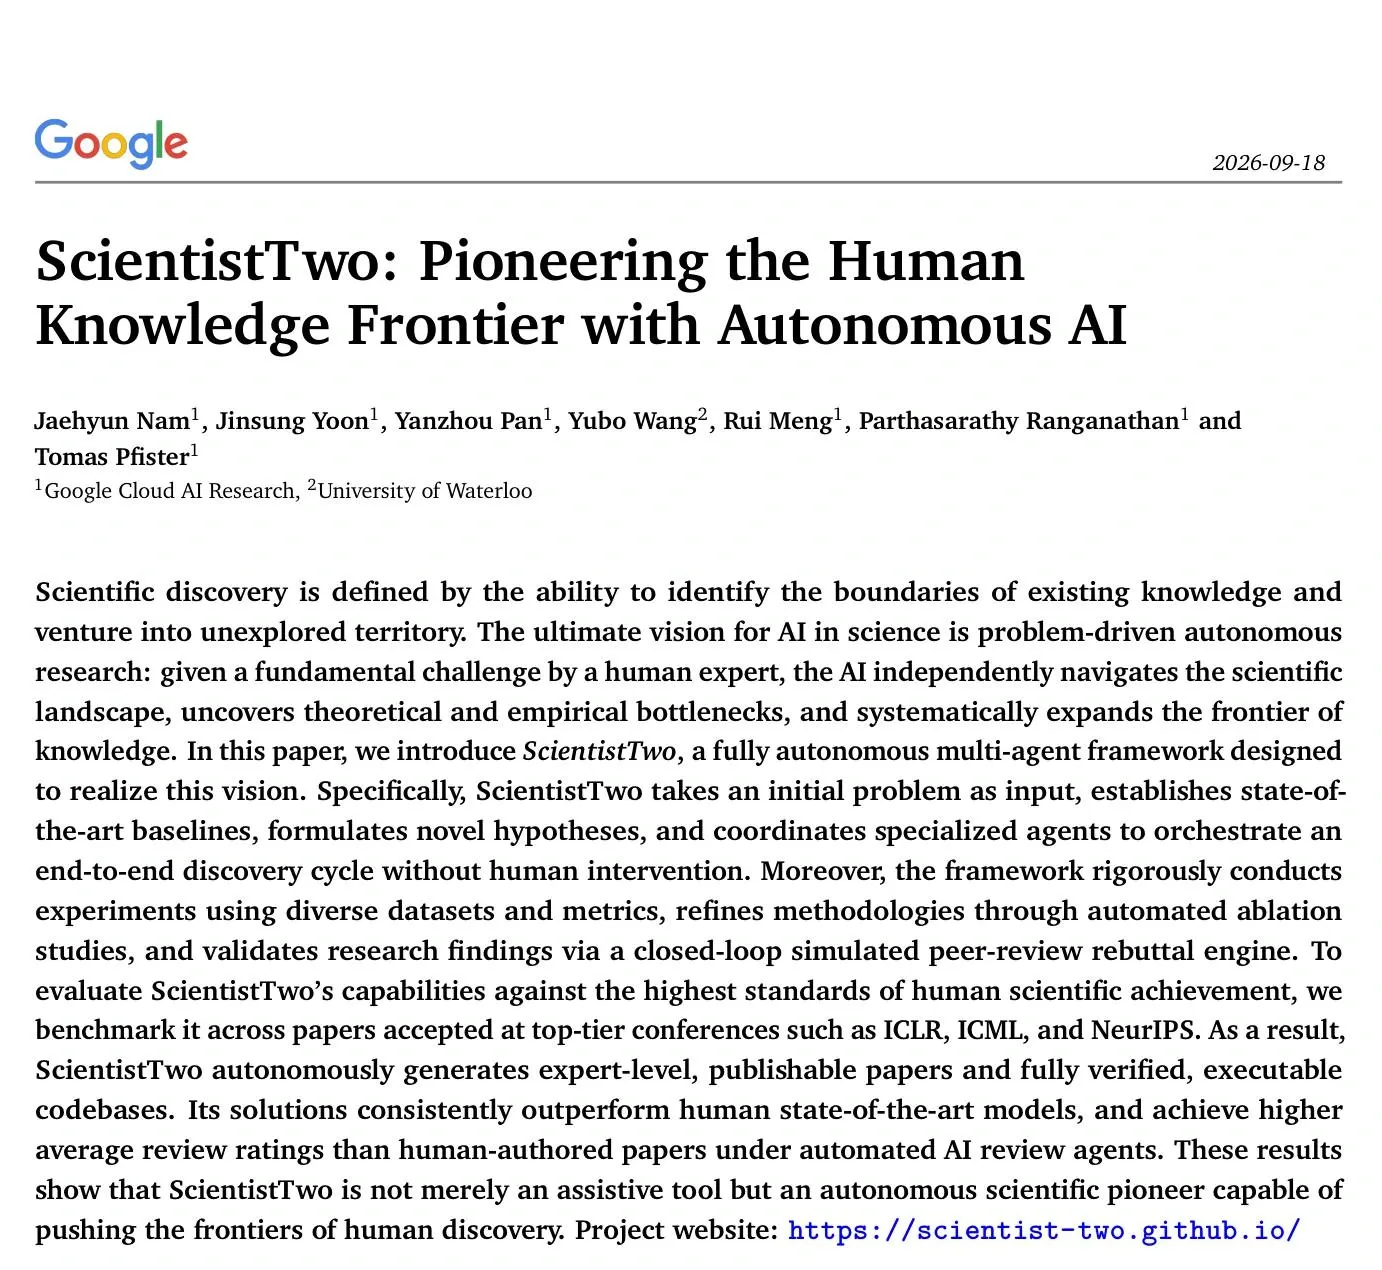
Google Cloud AI Research ha presentato ScientistTwo, un framework multi-agente completamente autonomo per la ricerca scientifica: gli si dà un problema e lui produce un paper pubblicabile con codebase verificata, senza intervento umano.
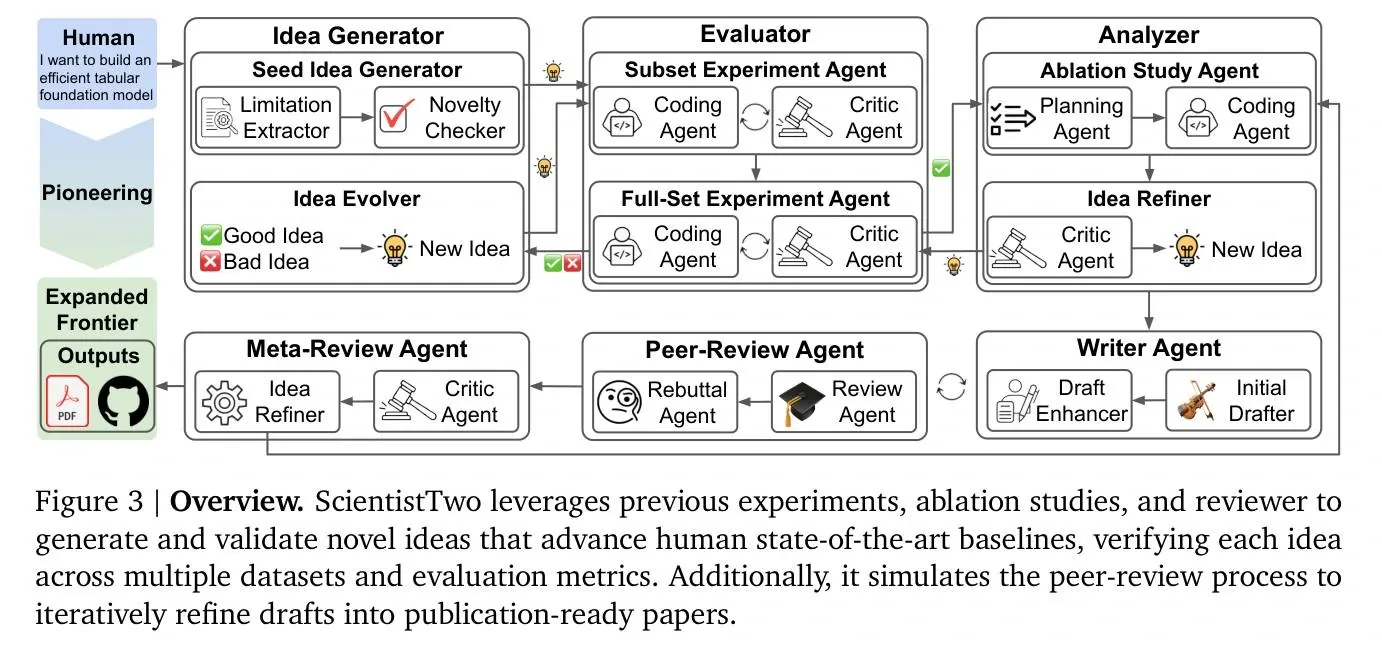
Il funzionamento rispecchia il ciclo di lavoro di un ricercatore: identifica i limiti dello stato dell'arte, genera ipotesi nuove, le implementa e le testa prima su un sottoinsieme del benchmark e poi in scala completa.
ScientistTwo: automatizzare il ciclo della ricerca empirica
Ogni fase ha un agente specializzato affiancato da un agente "critic" che decide se accettare il risultato, scartarlo o raffinarlo. Seguono studi di ablation automatici per isolare quali componenti contribuiscono davvero al miglioramento.
Il passaggio più interessante è la peer review simulata a ciclo chiuso: un Review Agent critica la bozza e un Rebuttal Agent risponde progettando ed eseguendo esperimenti supplementari, come in una vera rebuttal. Un Meta-Review Agent decide poi se il manoscritto è all'altezza della venue, altrimenti il ciclo ricomincia.
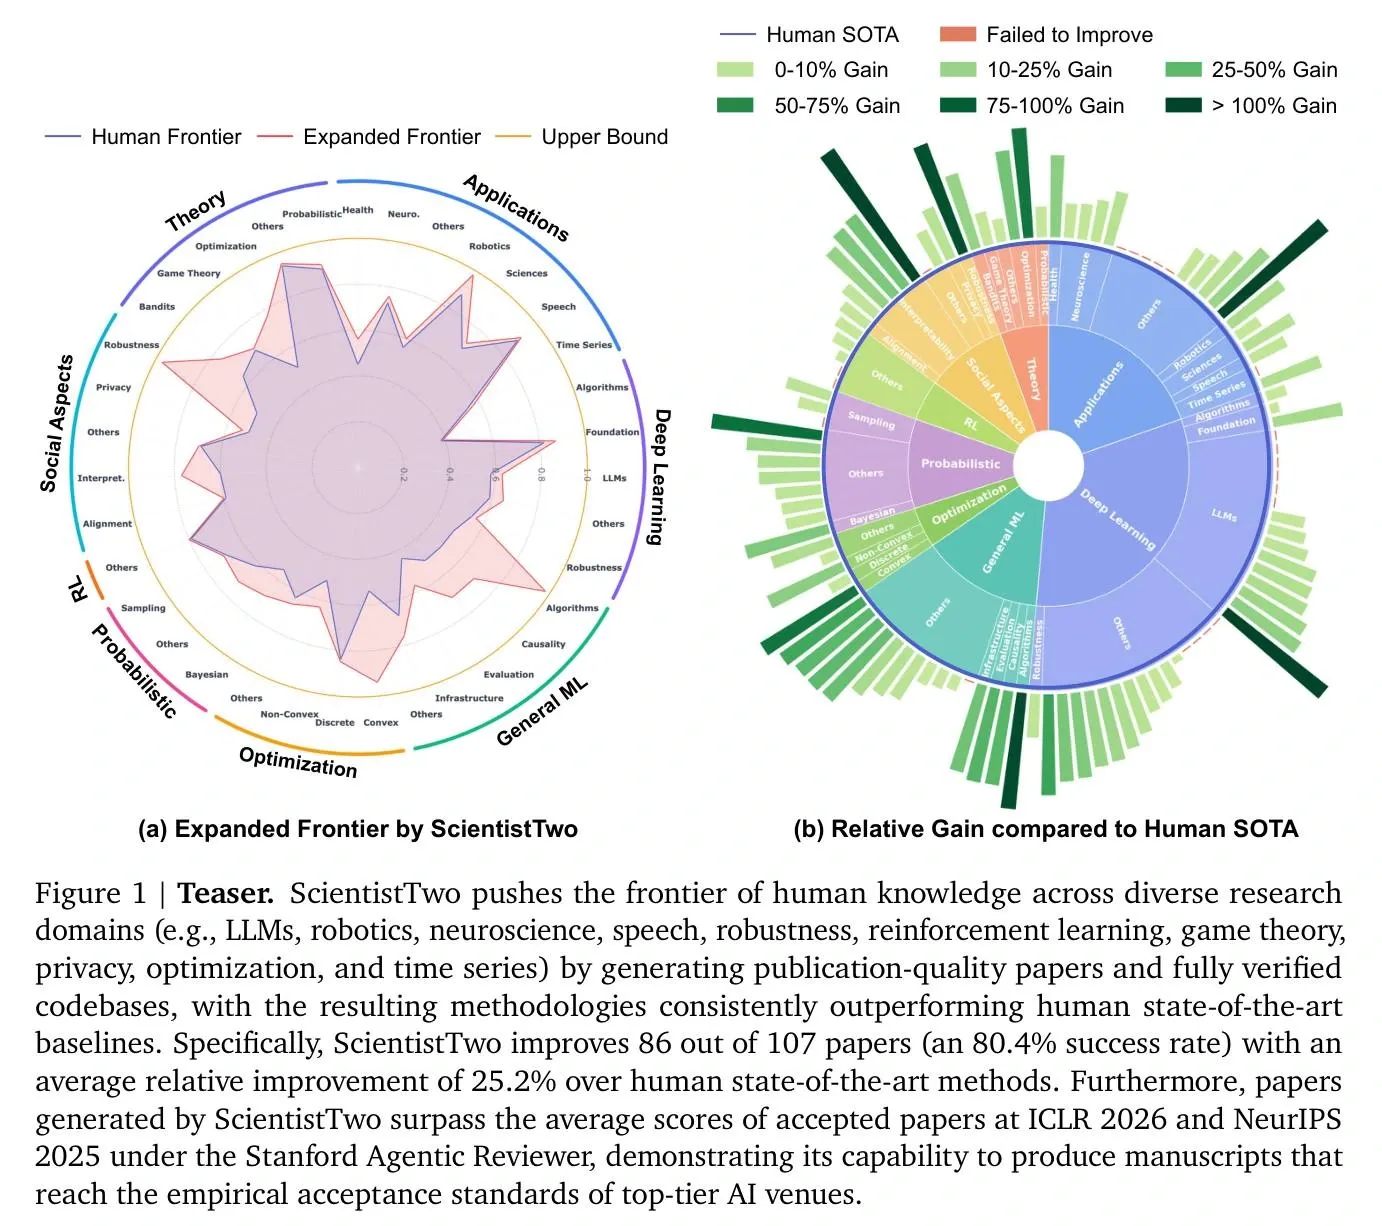
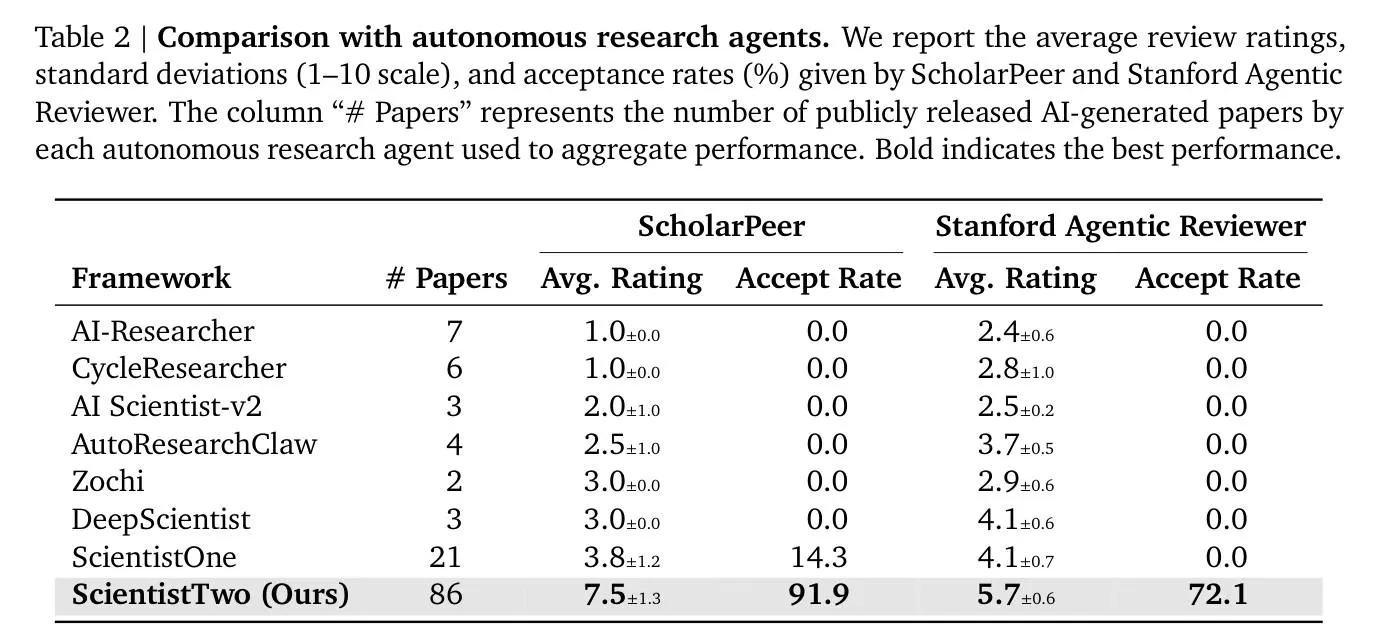
Il banco di prova è severo: 107 sfide di ricerca tratte da paper accettati a ICLR, ICML e NeurIPS. ScientistTwo ha migliorato lo stato dell'arte umano in 86 casi (80,4%), con un guadagno relativo medio del 25,2%.
Sotto review automatica indipendente (Stanford Agentic Reviewer, mai usata durante lo sviluppo), il 72,1% dei paper generati supera la soglia di accettazione, con punteggi medi superiori a quelli dei paper accettati a ICLR 2026 e NeurIPS 2025. Anche i revisori umani li hanno giudicati complessivamente alla pari con quelli scritti da persone.
Il sistema itera anche sulle proprie scoperte: in un caso di studio ha preso un suo metodo per la tokenizzazione BPE e lo ha migliorato tre volte di seguito, usando ogni nuovo stato dell'arte come base del ciclo successivo.
Restano due limiti dichiarati dagli autori: il costo, circa 3.800 dollari e 2-3 giorni di calcolo per singolo task, e il fatto che i risultati raggiungono l'accettazione ma non ancora il livello "spotlight" delle scoperte che cambiano un paradigma.
Non siamo più davanti a un assistente che aiuta a scrivere o a fare coding, ma a un sistema che porta avanti l'intero ciclo della scienza empirica: ipotesi, esperimenti, ablation, rebuttal. L'umano definisce il problema, la macchina esplora la frontiera.
NVIDIA Agora: memoria e istituzioni per comunità di agenti
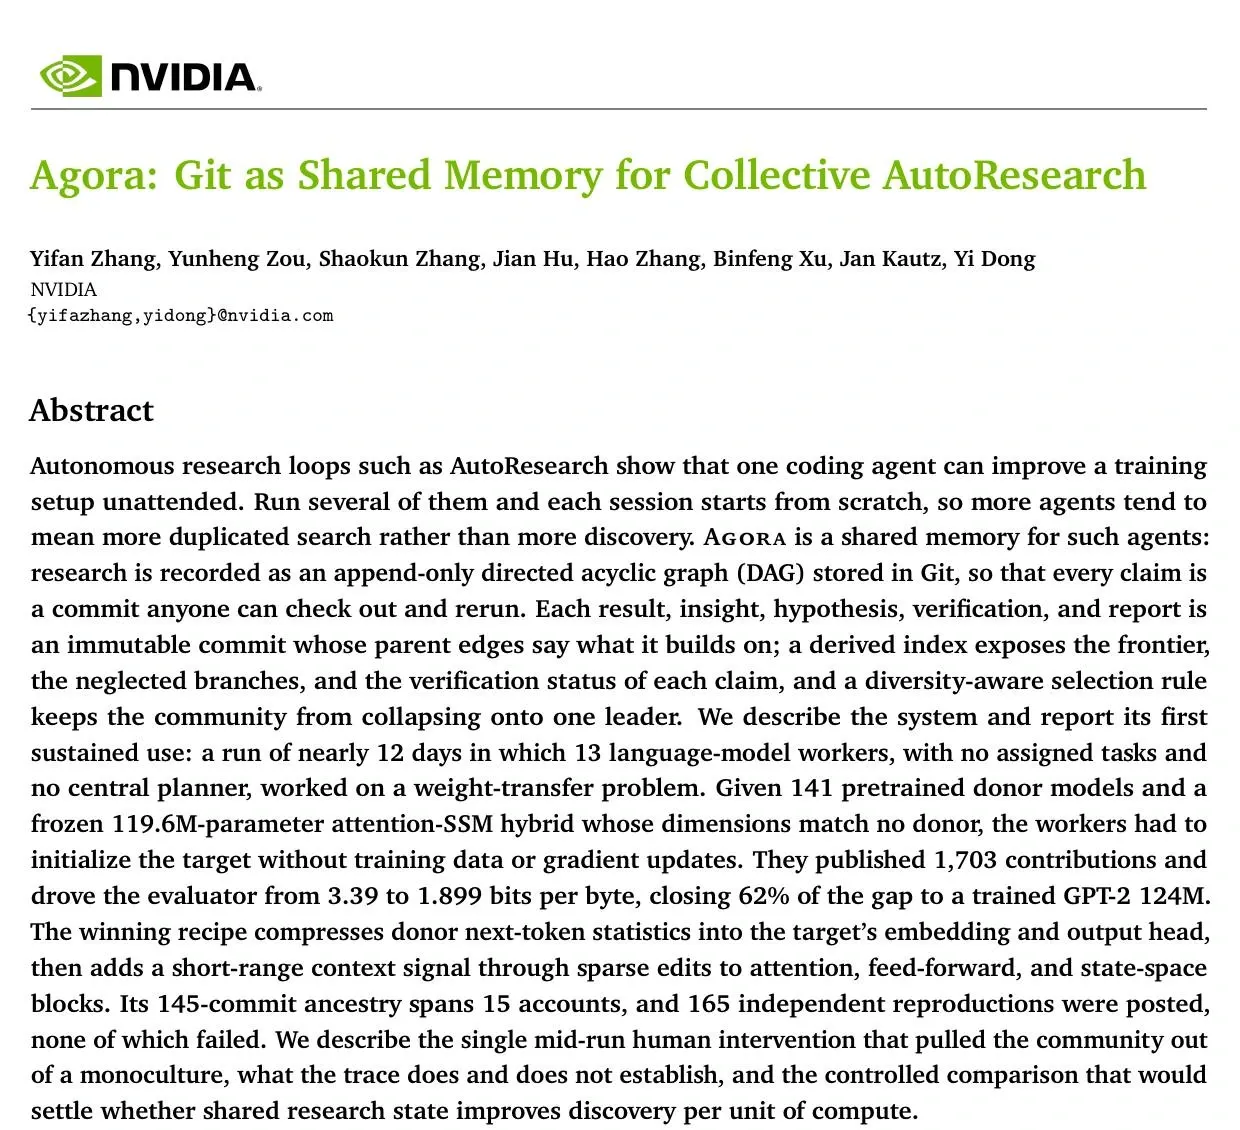
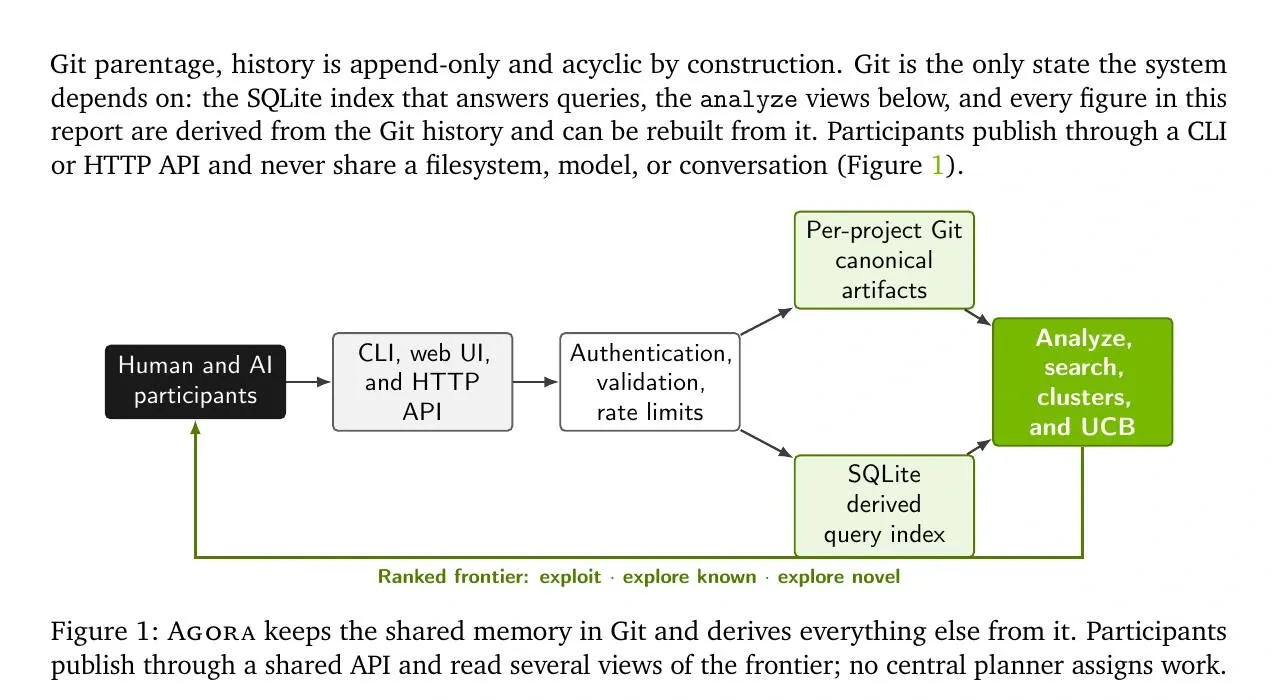
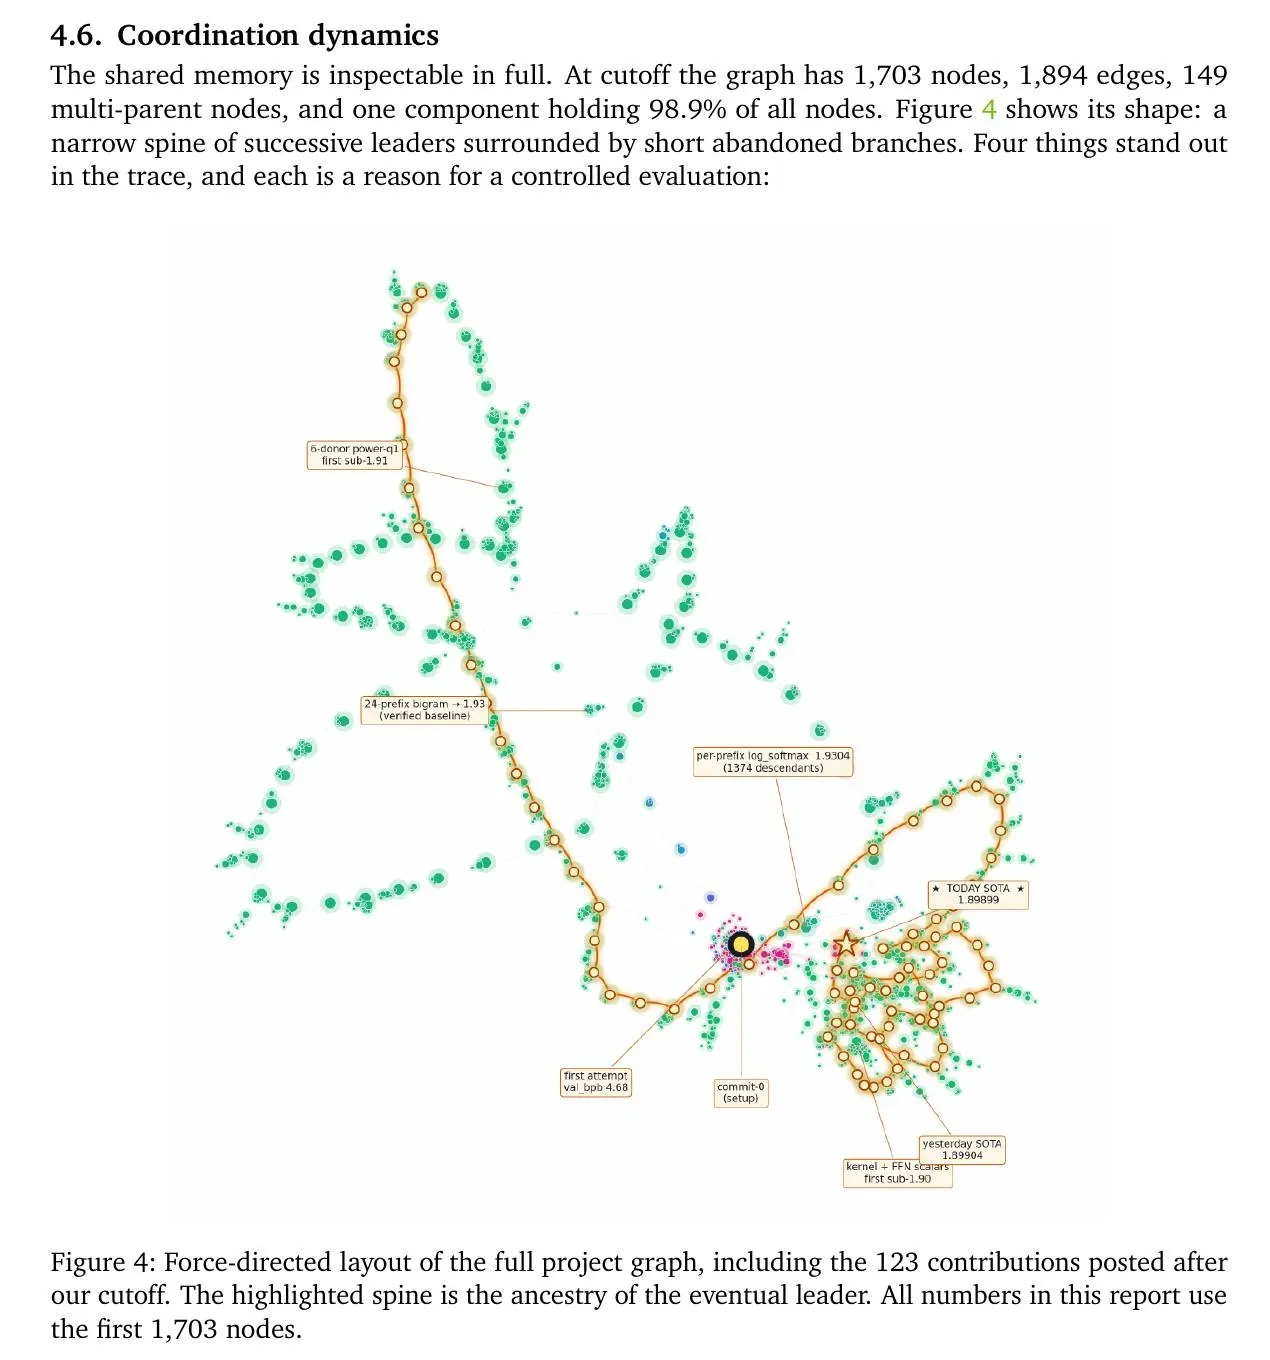
NVIDIA presenta Agora, una memoria condivisa per comunità di agenti: ogni risultato, ipotesi, verifica o fallimento diventa un commit Git immutabile, collegato ai contributi precedenti. Non è una chat né un planner centrale. È un grafo che sopravvive alle sessioni.
Git conserva artefatti e provenienza; un indice espone frontiera, rami trascurati e verifiche. Il ciclo è: analizzare il grafo → scegliere un nodo → eseguire un esperimento → pubblicare → aggiornare la frontiera.
NVIDIA Agora: memoria e istituzioni per comunità di agenti
La qualità non dipende dai voti, ma dal lavoro indipendente costruito sopra un contributo e dalle riproduzioni. L’auto-citazione è esclusa. La selezione separa tre direzioni: sfruttare i leader, esplorare cluster promettenti, aprire rami quasi intatti.
Nel primo test, 13 agenti basati su Claude Code e Codex hanno lavorato per quasi 12 giorni senza compiti assegnati. Dovevano inizializzare un modello ibrido attention-SSM da 119,6 milioni di parametri usando 141 donor, senza dati di training né gradienti.
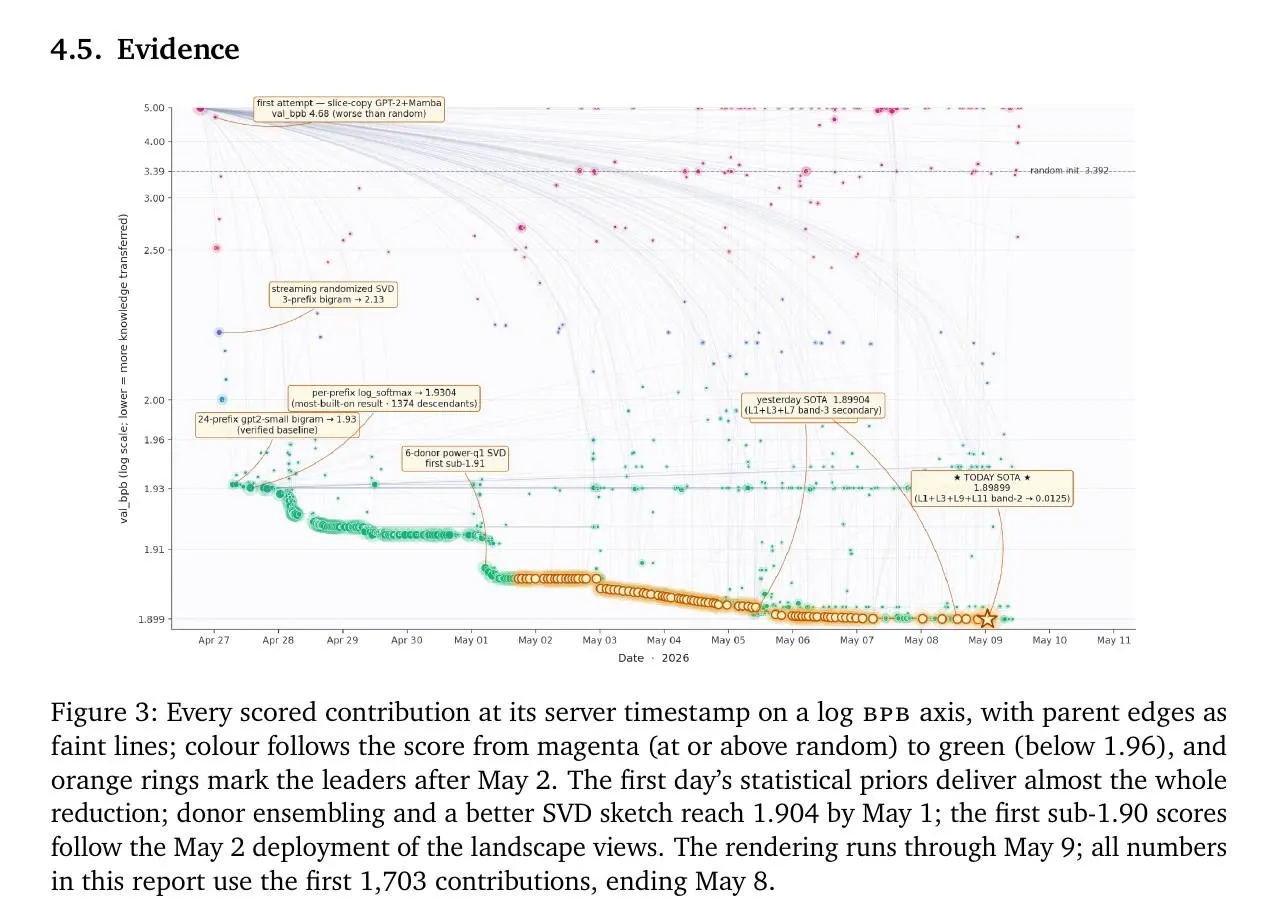
La community pubblica 1.703 contributi. La soluzione comprime le probabilità next-token di sei donor in una tabella di transizione, poi usa SVD per trasferirle in embedding e output head e aggiunge contesto con modifiche sparse ai blocchi. Il punteggio passa da 3,3923 a 1,899 bit per byte, chiudendo il 62% del divario da un GPT-2 124M addestrato.
La discendenza include 145 commit di 15 account. Le 165 verifiche indipendenti non riportano fallimenti entro la tolleranza. Ma i primi 18 risultati spiegano circa il 98% del miglioramento; i successivi 1.106 guadagnano solo 0,03 bpb.
La memoria condivisa non elimina i doppioni. Tra 696 coppie di punteggi identici di account diversi, il 63% arriva entro un’ora e l’80% entro sei. Il lavoro converge su una “spina dorsale” stretta. Dopo un intervento umano che mostra cluster e diversità, un agente segue un ramo SSM poco esplorato e supera 1,90 il mattino successivo.
Questo non dimostra che Agora migliori la scoperta per unità di compute: manca il confronto controllato con agenti isolati, log cronologico e planner centrale. Mostra però che una memoria utile deve rendere verificabili dipendenze, risultati negativi, riproduzioni e concentrazione dell’attenzione.
Scalare ricercatori autonomi senza scalare le loro istituzioni rischia di trasformare il compute in ricerca duplicata. Il salto non è avere più agenti, ma una memoria pubblica che mostri il leader e ciò che tutti ignorano.
Math and AI: risolvere problemi non esaurisce il progresso scientifico
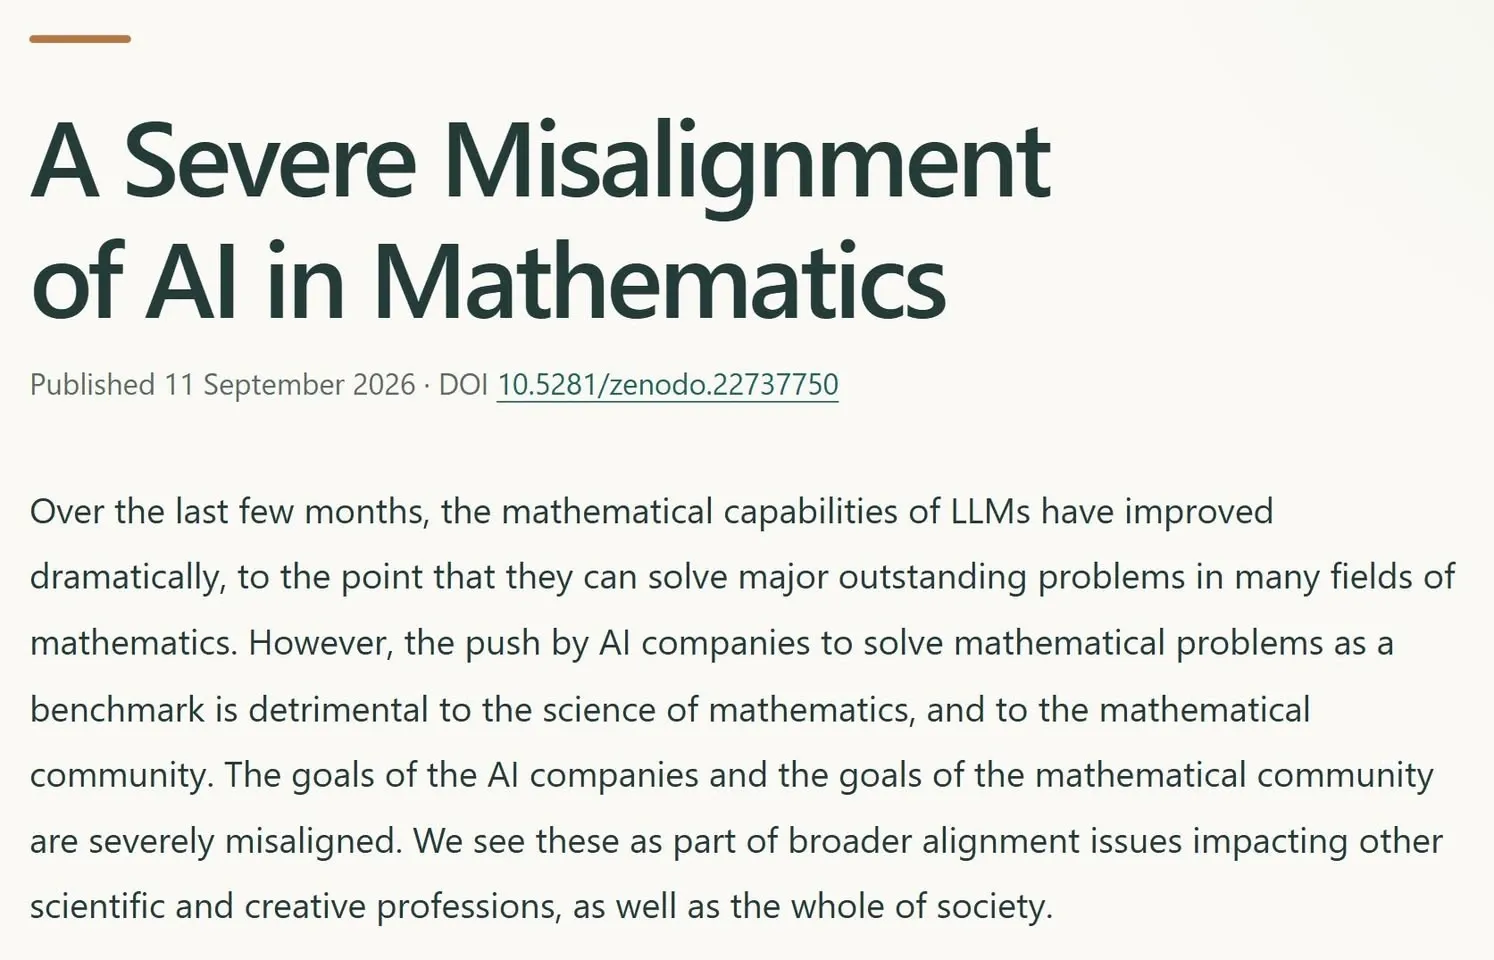
La recente dichiarazione pubblicata su Math and AI solleva un punto molto sensato: confondere la capacità di risolvere problemi matematici con il progresso della matematica rischia di essere fuorviante. OpenAI, Anthropic, Google e gli altri grandi laboratori stanno inevitabilmente usando benchmark e problemi sempre più difficili anche per mostrare i muscoli dei propri modelli. È comprensibile: sono risultati misurabili, confrontabili e molto efficaci dal punto di vista comunicativo.
Ma la ricerca scientifica è qualcosa di più complesso. Risolvere un problema non significa necessariamente comprendere meglio un campo. La matematica avanza anche attraverso la formulazione delle domande giuste, la costruzione di nuovi concetti, il giudizio sulla rilevanza dei risultati, il confronto con la letteratura, la verifica e la capacità di collegare idee provenienti da ambiti diversi.
Terence Tao aveva già sottolineato recentemente un punto simile: il vero valore di questi sistemi emergerà sempre di più dalla collaborazione tra esseri umani e AI, non dalla semplice competizione tra i due. Ed è probabilmente questo il cambiamento più interessante.
Se il costo di generare ipotesi, calcoli, dimostrazioni preliminari e alternative continuerà a diminuire, il collo di bottiglia si sposterà. Diventeranno ancora più importanti il giudizio, l’intuizione, la capacità di scegliere cosa vale la pena approfondire e la conoscenza profonda del dominio. In altre parole, più potenti diventano questi strumenti, più preziose possono diventare le competenze di chi sa usarli bene.
Il rischio reale non è soltanto che l’AI produca risultati sbagliati, ma anche che produca una quantità enorme di risultati formalmente corretti ma difficili da valutare, contestualizzare e assimilare. Potremmo arrivare a un punto in cui produrre nuova matematica candidata diventa economico, mentre comprenderne davvero il significato resta costoso.
La trasformazione quindi non riguarda semplicemente la sostituzione degli esperti, ma una nuova divisione del lavoro cognitivo.
Come spesso accade con le tecnologie più potenti, i risultati migliori arriveranno dalla cooperazione: esperti di dominio capaci di usare sistemi sempre più avanzati per esplorare più velocemente, verificare meglio, collegare conoscenze e spostare più in alto il livello della ricerca.
TimesFM zero-shot: il valore delle informazioni già note sul futuro
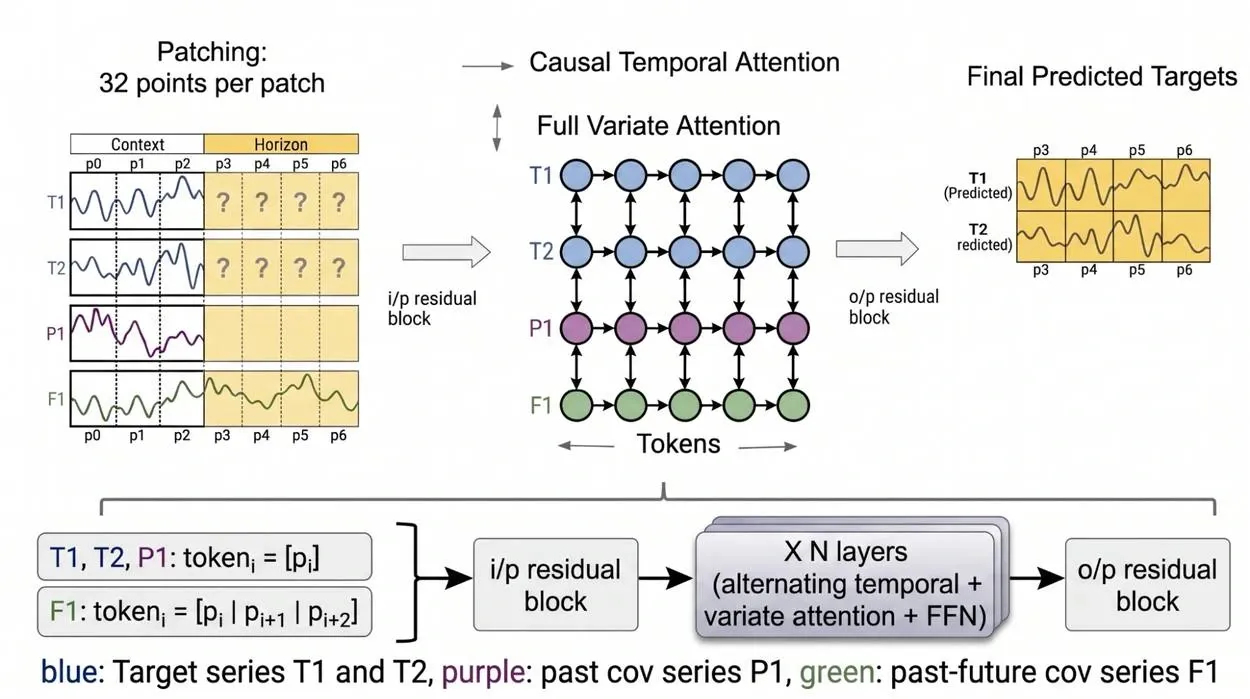
Ho provato TimesFM di Google Research, su un dataset sintetico di ecommerce con quattro mercati: UK, Germania, Francia e USA. TimesFM è un foundation model per serie temporali: gli si fornisce lo storico di una variabile, per esempio la revenue giornaliera, e il modello prova a prevederne l’andamento futuro.
Il test è stato eseguito completamente in zero-shot. Significa che TimesFM non è stato allenato sui dati dell’e-commerce: nessun training, nessun fine-tuning, nessun tuning dei pesi e nessun ciclo di addestramento. Ho semplicemente fornito il dataset, definito il target da prevedere e, in alcuni test, aggiunto informazioni già note sul futuro. TimesFM 3.0 può infatti usare anche le cosiddette covariate: variabili che non vogliamo prevedere, ma che possono aiutare la previsione. Nel mio caso, la covariata più utile era il calendario delle promozioni già pianificate.
TimesFM zero-shot: il valore delle informazioni già note sul futuro
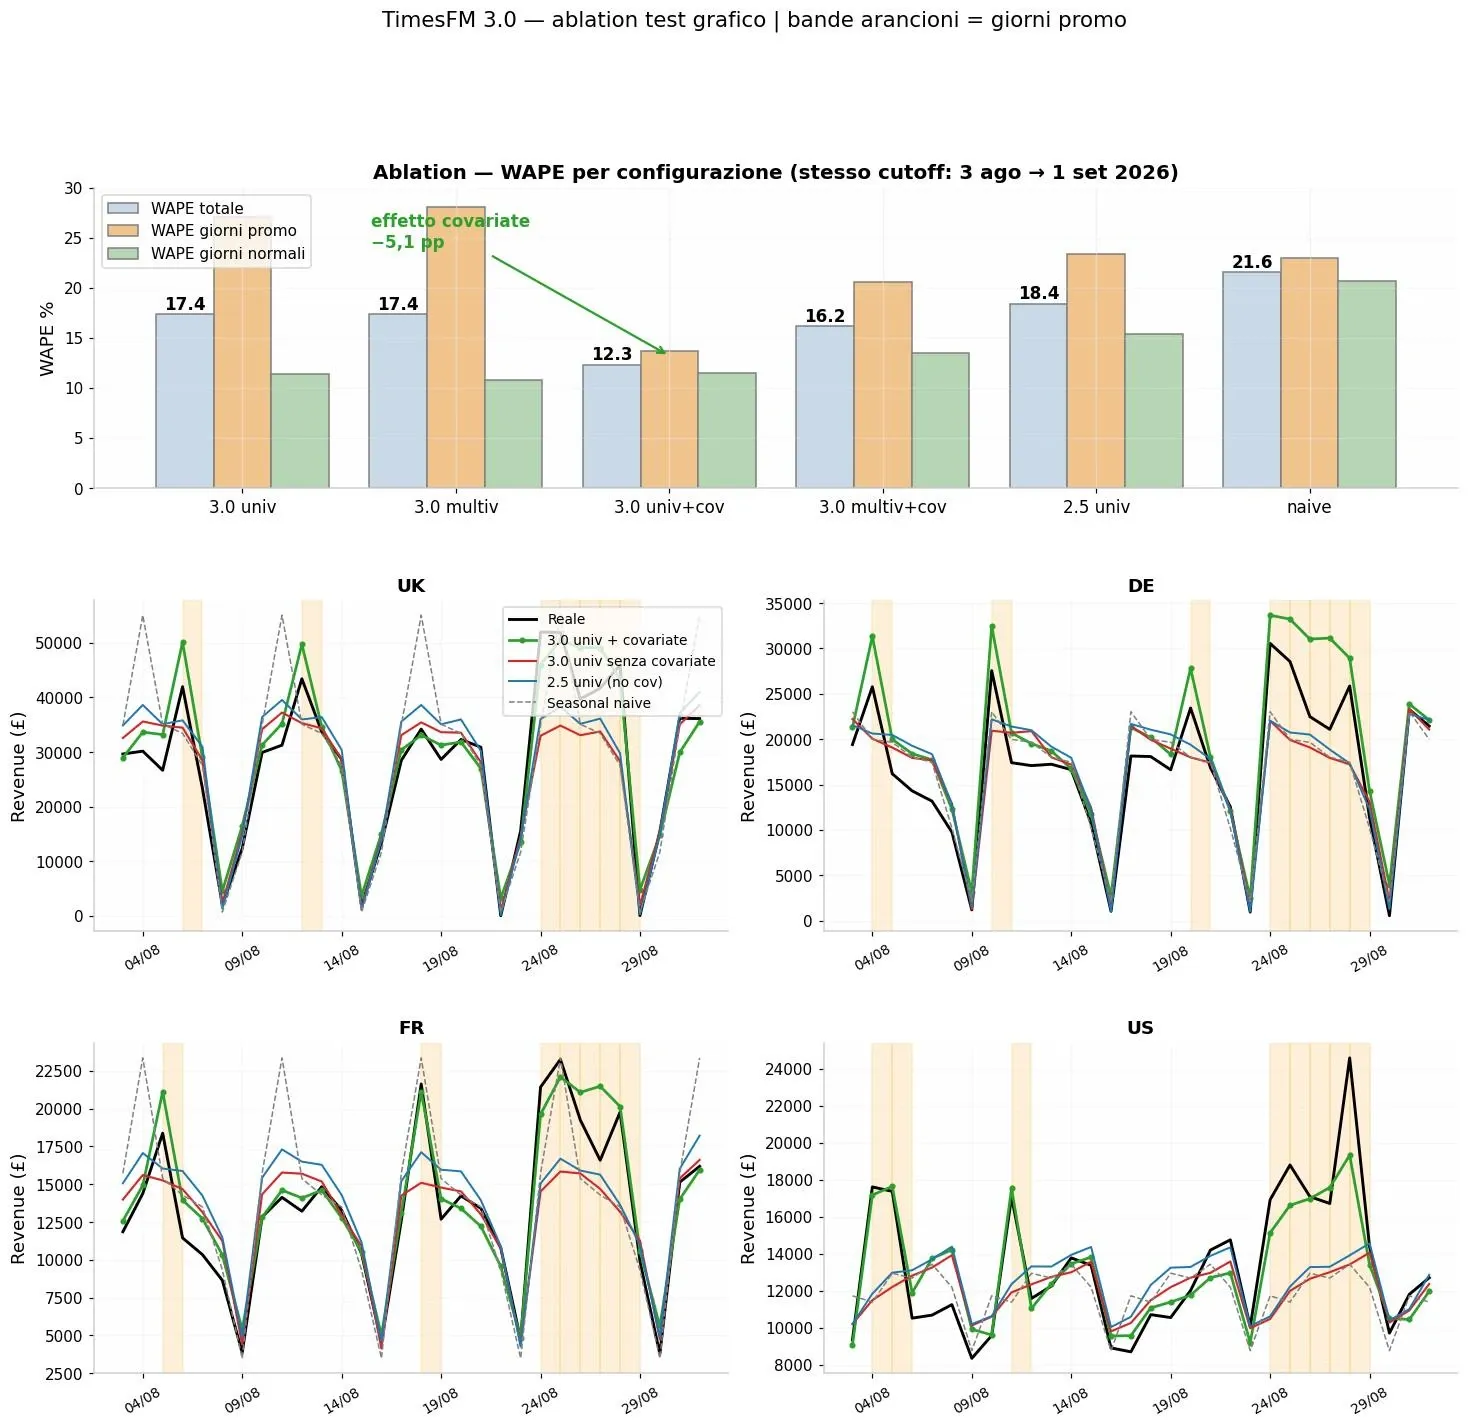
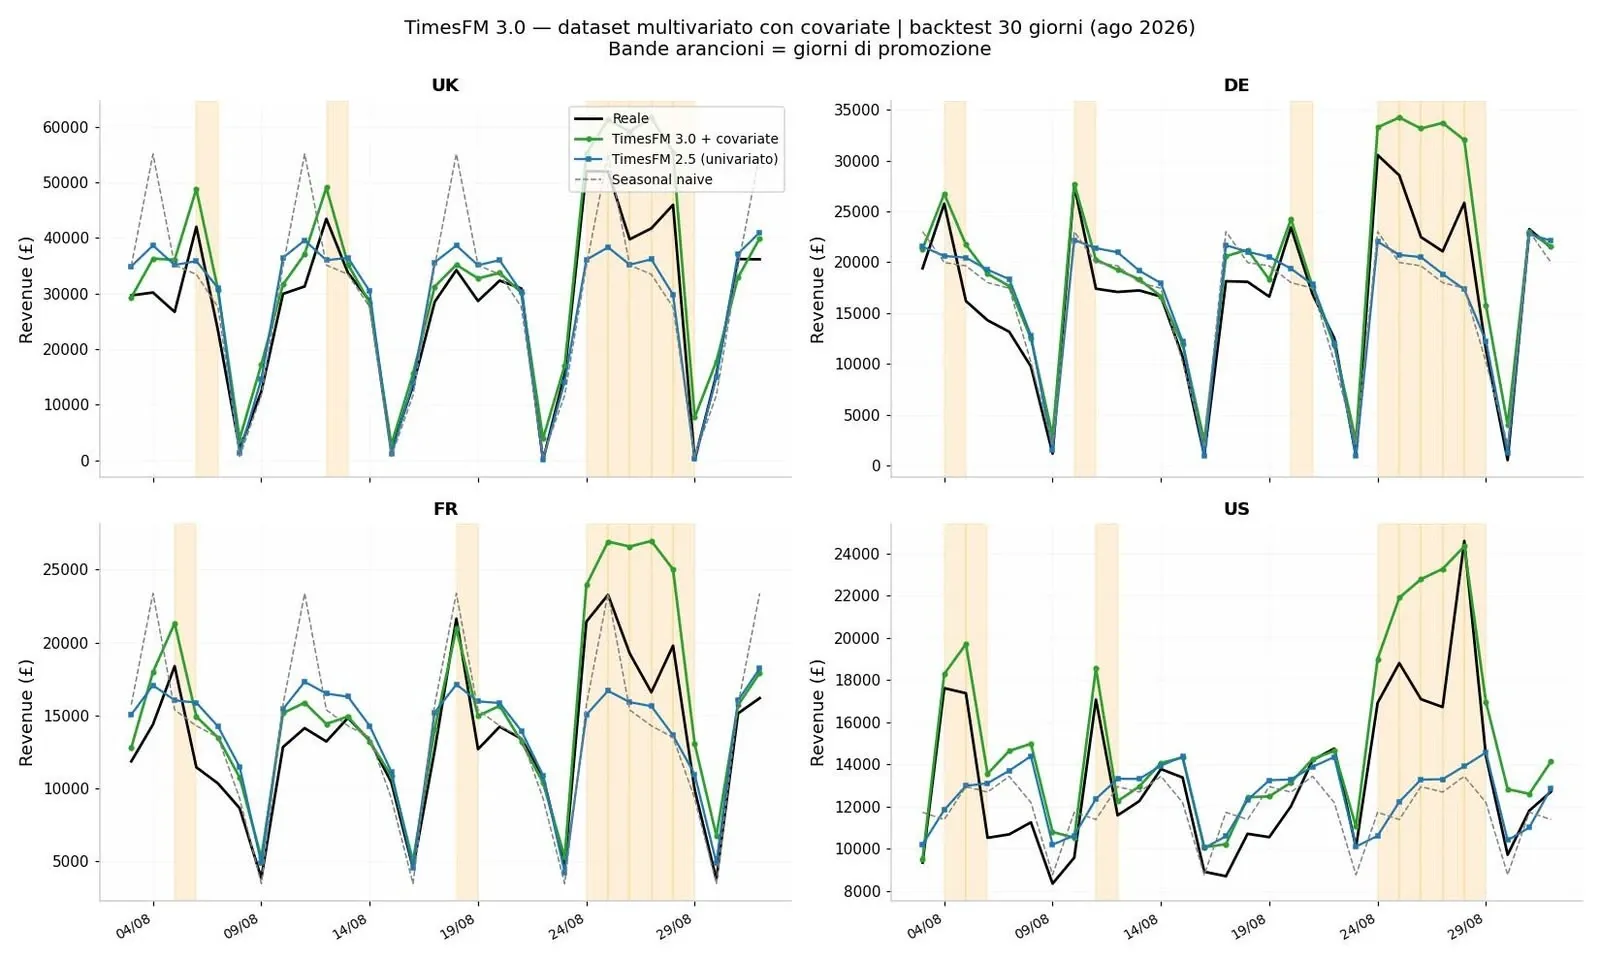
Ho quindi fatto un backtest: il modello vede tutto ciò che è successo fino al 2 agosto 2026 e deve prevedere i 30 giorni successivi. Noi conosciamo già quei 30 giorni, quindi possiamo confrontare forecast e realtà.
Con la sola revenue storica, TimesFM 3.0 ottiene un WAPE del 17,4%. Aggiungendo il calendario delle promo, l’errore scende al 12,3%: circa il 29% di riduzione relativa. Il miglioramento si concentra proprio dove dovrebbe: nei giorni promozionali il WAPE passa dal 27,1% al 13,7%, mentre nei giorni normali resta praticamente invariato.
Questo è il punto chiave: il modello non “conosce il futuro”. Usa informazioni future che l’azienda conosce già, come una promozione programmata. Ho provato anche la modalità multivariata, facendo prevedere insieme i quattro paesi. In questo dataset non ha portato vantaggi: le altre serie non contenevano abbastanza informazione anticipatoria.
Un aspetto stupefacente è che ho eseguito i test completamente gestiti da Kimi Agent Swarm, nel suo ambiente di sviluppo. Io ho fornito il dataset e il link al repository e ho dato istruzioni dettagliate sulle operazioni da compiere. Infine ho chiesto di eseguire l'ablation test con diverse configurazioni.
Il test mostra due aspetti: il modello può funzionare zero-shot su un nuovo dataset e le covariate possono migliorare molto la previsione quando contengono un segnale utile.
La repo supporta comunque anche il fine-tuning, incluso LoRA, per chi vuole adattare ulteriormente il modello a un dominio specifico.
TimesFM 3.0 su Walmart: quando una verifica più rigorosa cambia l’esito
Un nuovo test su TimesFM 3.0 di Google, con risultati che trovo straordinari.
Parliamo di una classe di sistemi che applica al forecasting delle serie temporali una logica simile a quella degli LLM, imparando schemi generali da enormi quantità di dati e riutilizzandoli su problemi mai visti prima.
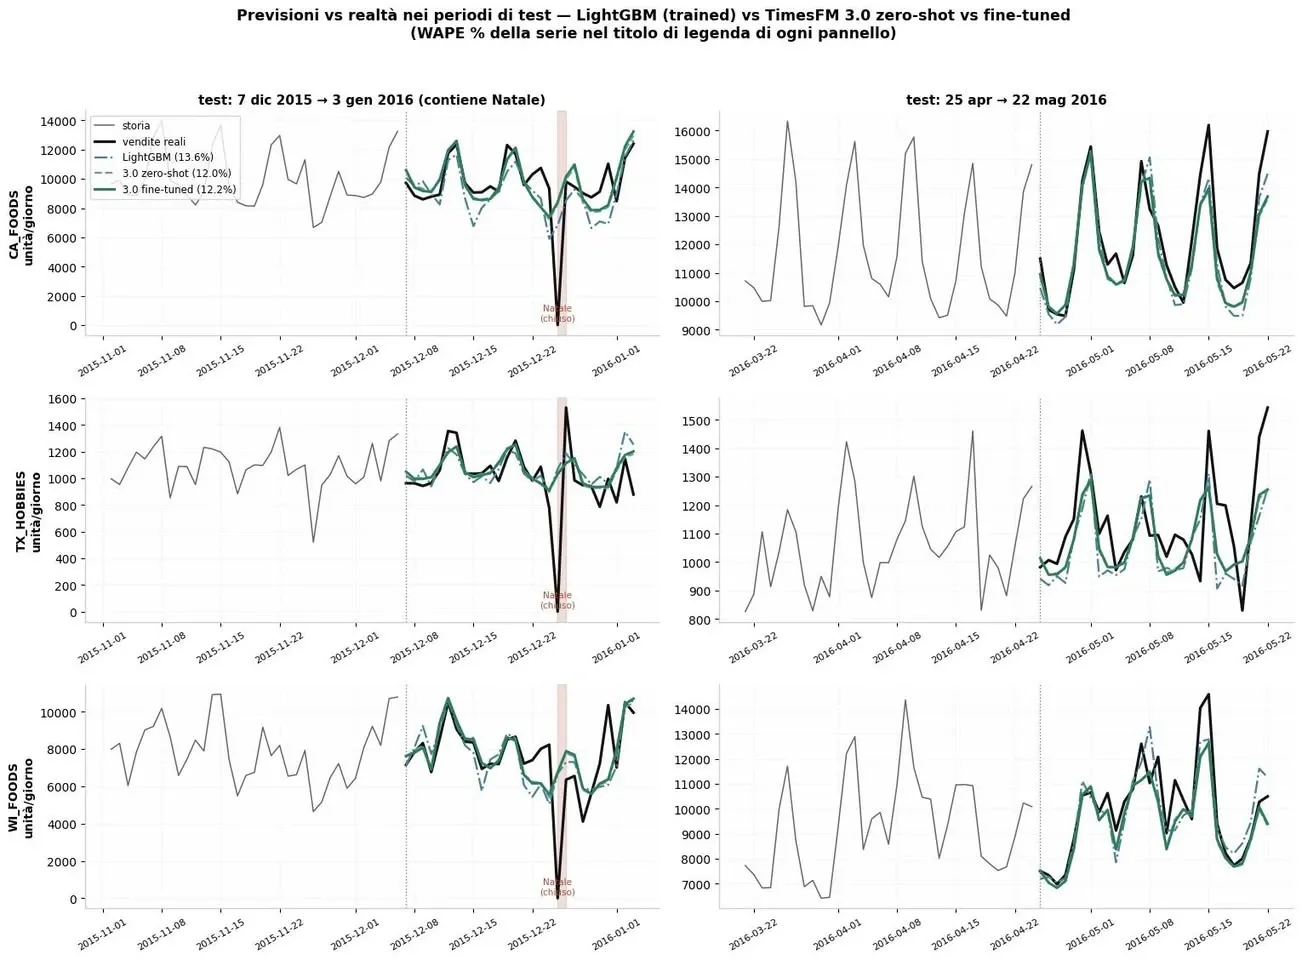
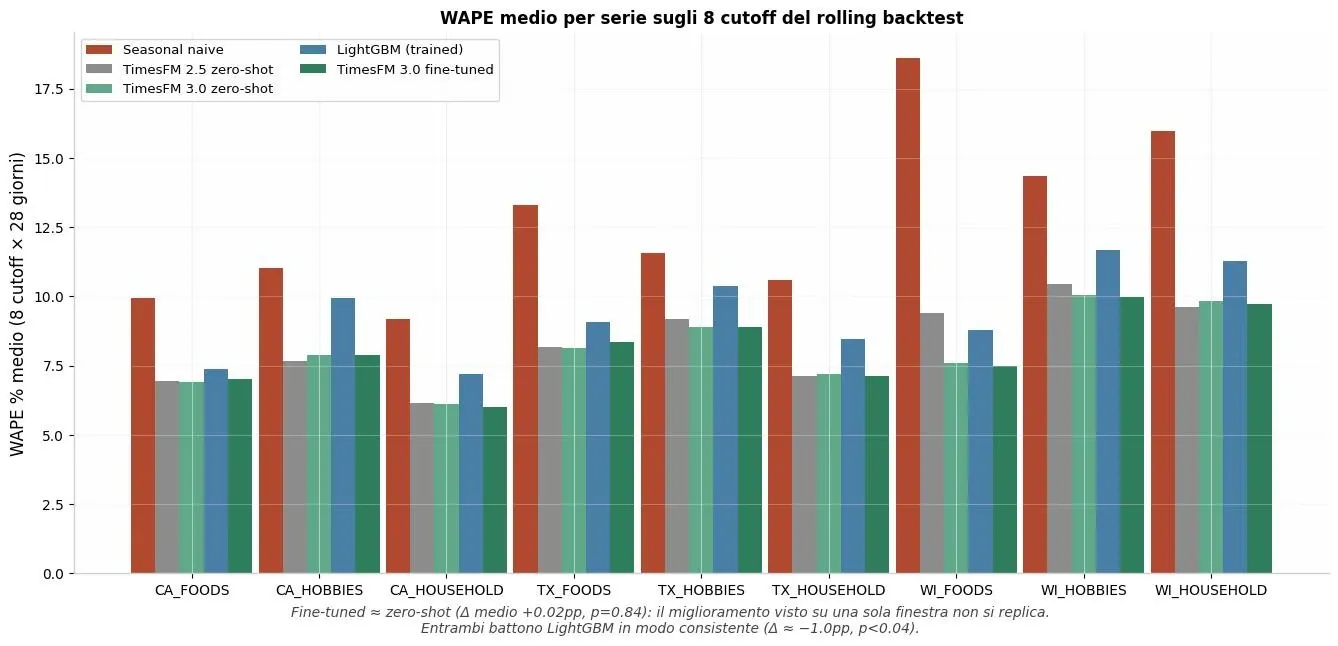
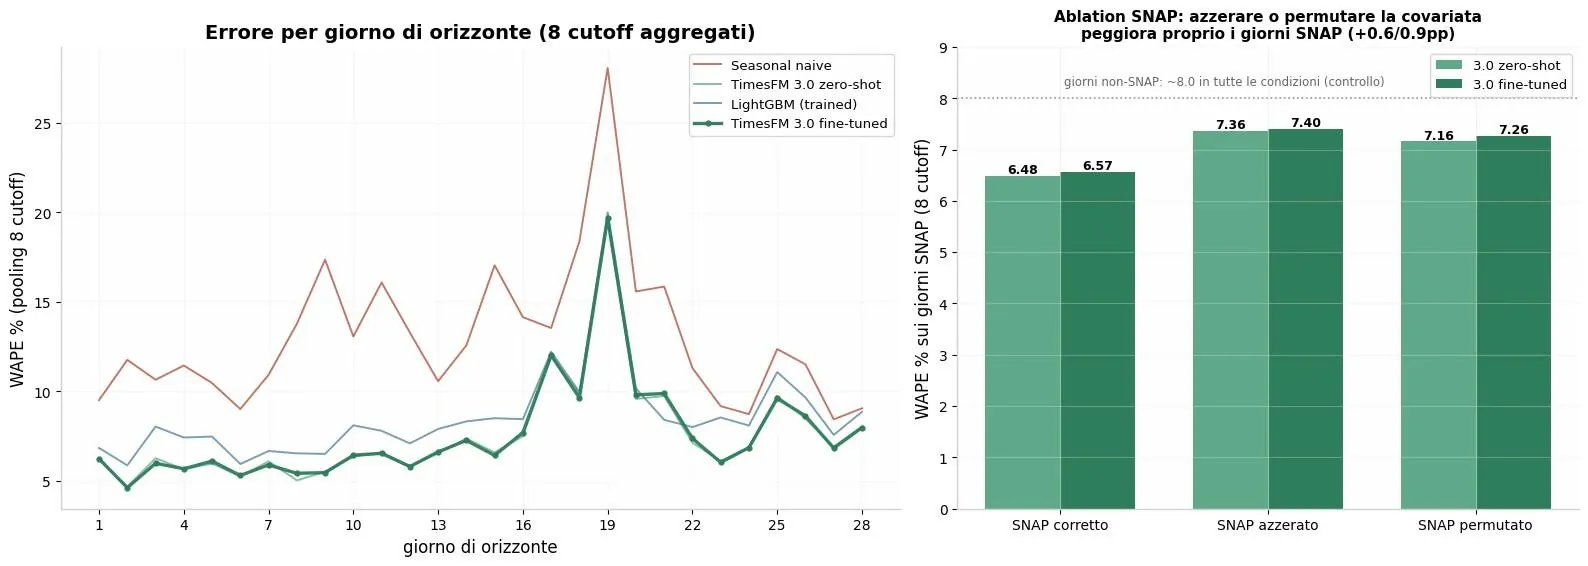
L’ho testato sul dataset M5 di Walmart: vendite giornaliere reali, 9 serie aggregate, prezzi, festività e SNAP (i sussidi alimentari statunitensi). Un dettaglio importante: M5 non fa parte dei dati di pre-training di TimesFM 3.0.
TimesFM 3.0 su Walmart: quando una verifica più rigorosa cambia l’esito
Tutto il lavoro è stato realizzato dentro Kimi Agent Swarm con Kimi K3: dati, modello di confronto, fine-tuning, debugging, rolling backtest, test statistici, ablation e grafici.
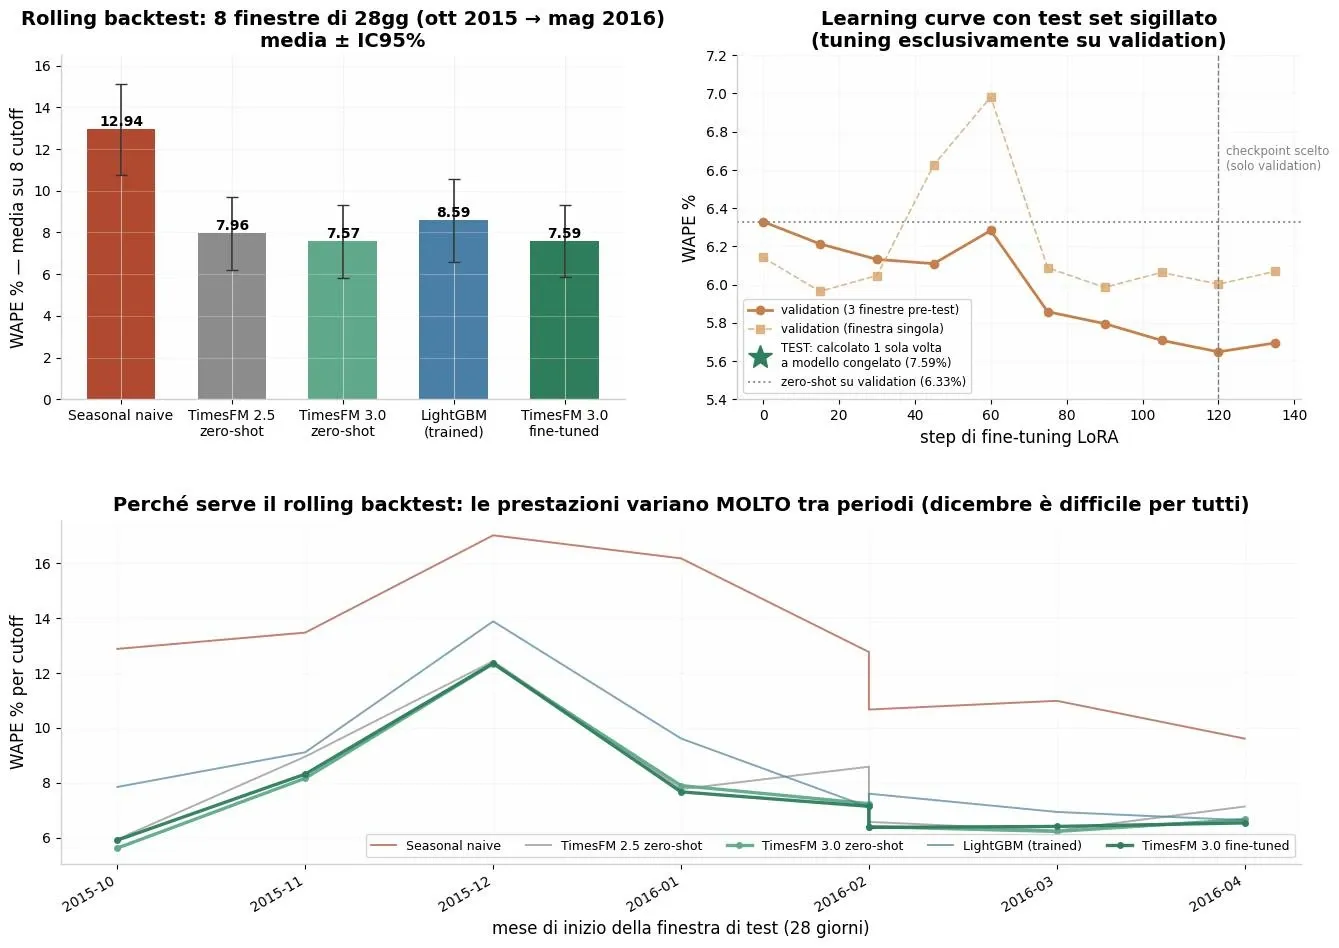
Per evitare conclusioni basate su un solo periodo, il confronto usa 8 finestre da 28 giorni (rolling backtest). Il fine-tuning è stato scelto solo sui dati di validazione e il test è stato calcolato una sola volta, a modello congelato. Come riferimento ho usato LightGBM, un modello di machine learning classico addestrato sui dati, con feature costruite a mano e riaddestrato a ogni finestra.
Risultato medio sugli 8 test, misurato in WAPE (errore percentuale ponderato):
- TimesFM 3.0 zero-shot: 7,57%
- LightGBM: 8,59%
- TimesFM 3.0 fine-tuned con LoRA: 7,59%
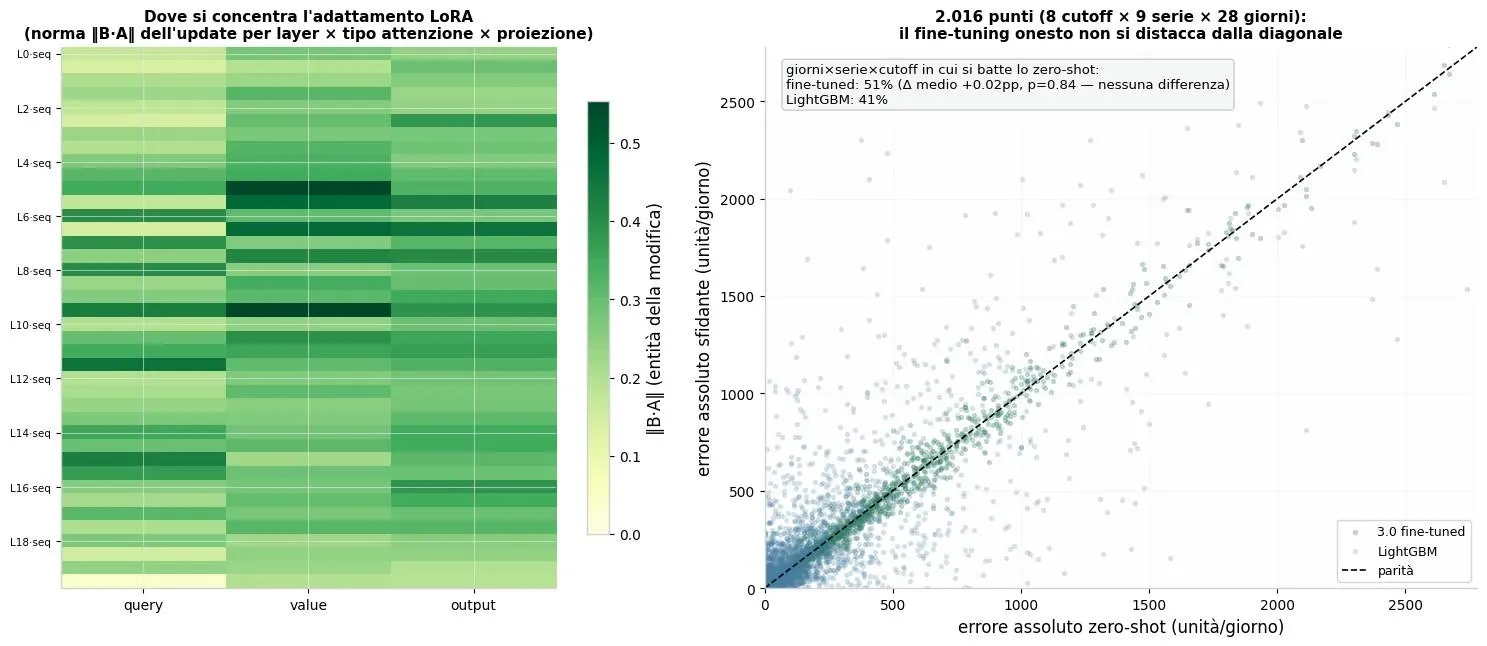
TimesFM, senza alcun training su M5 (zero-shot), supera LightGBM, che invece viene addestrato appositamente sui dati a ogni finestra. Il fine-tuning leggero con LoRA non aggiunge un miglioramento misurabile. Nella prima prova, su una sola finestra, sembrava funzionare; con un protocollo più rigoroso quell’effetto scompare. Anche questo, per me, è un risultato importante.
Ho anche fatto un’ablation su SNAP: azzerando o spostando questa covariata, l’errore aumenta proprio nei giorni SNAP. Quindi il modello usa davvero quell’informazione per costruire le previsioni. I grafici mostrano la variabilità tra periodi, il comportamento sulle singole serie e lungo i 28 giorni, l’effetto di SNAP e dove si concentra l’adattamento LoRA.
Il punto che mi porto a casa: un foundation model per serie temporali può arrivare già zero-shot a prestazioni superiori, in questo test, a una pipeline ML costruita e addestrata appositamente. E un protocollo più severo può smentire una conclusione iniziale sul fine-tuning: è parte del valore dell’esperimento.
Gemini Agentic Video Understanding
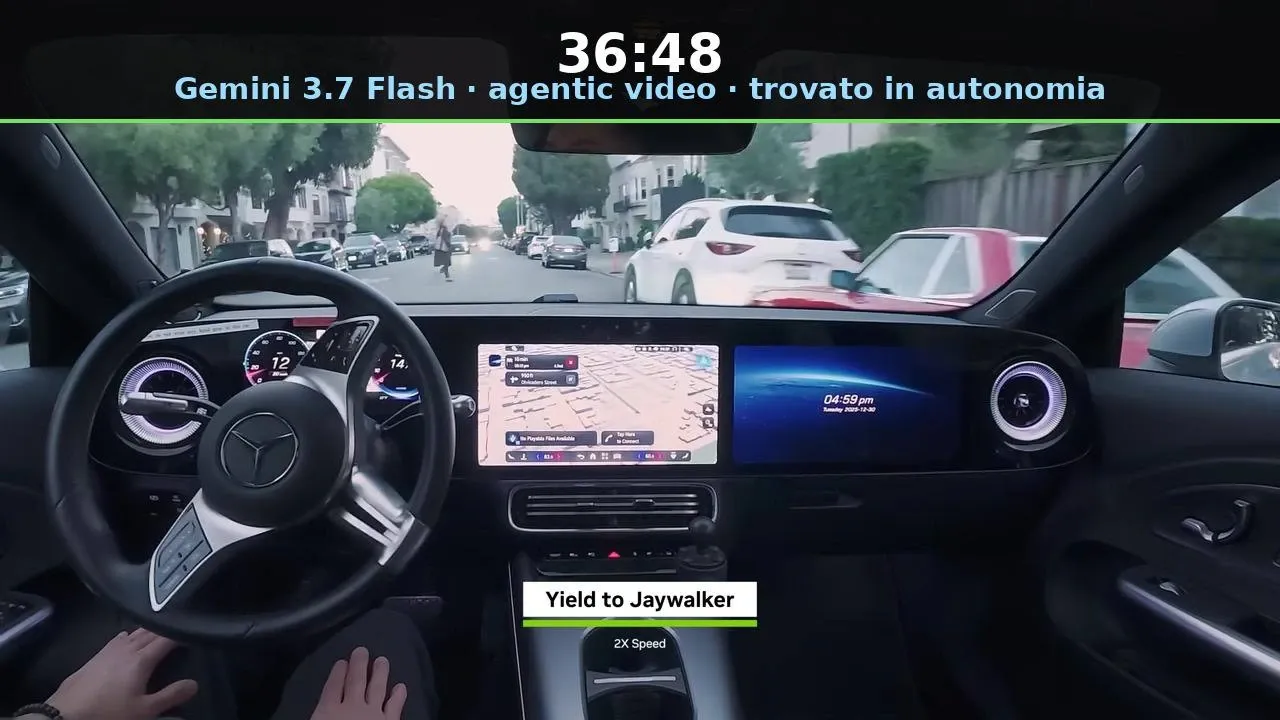
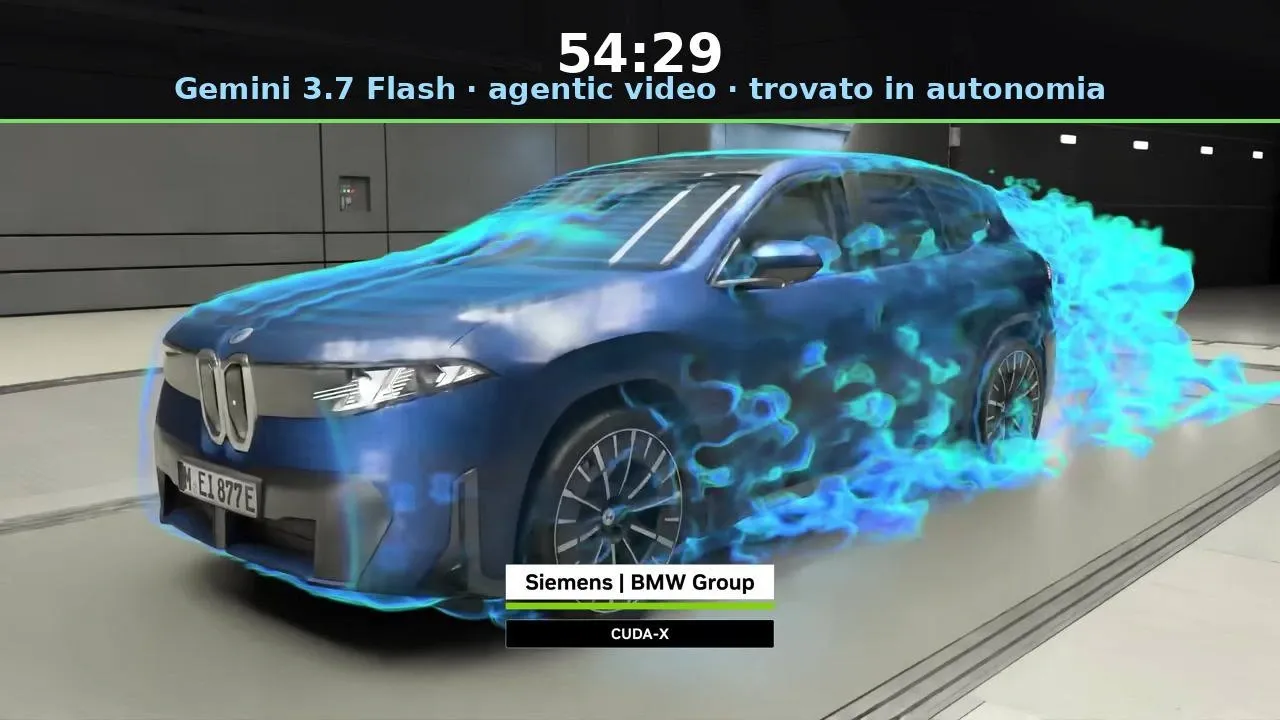
Ho provato l'Agentic Video Understanding di Gemini, usando il modello 3.7 Flash via API: il risultato è impressionante. In un video di 91 minuti ho cercato tre elementi molto specifici: una donna bionda con cappotto chiaro e borsa rossa mentre attraversa sulle strisce; un'auto in galleria del vento avvolta da un flusso d'aria azzurro; il momento esatto in cui compare a schermo la stringa “Yield to Jaywalker”.
Gemini li ha trovati tutti con grande precisione, individuando i punti corretti del video. In media, ogni ricerca ha richiesto circa 30-40 secondi. Eseguendo richieste analoghe senza Agentic Video Understanding, il modello non raggiunge la stessa precisione e restituisce intervalli temporali non corretti.
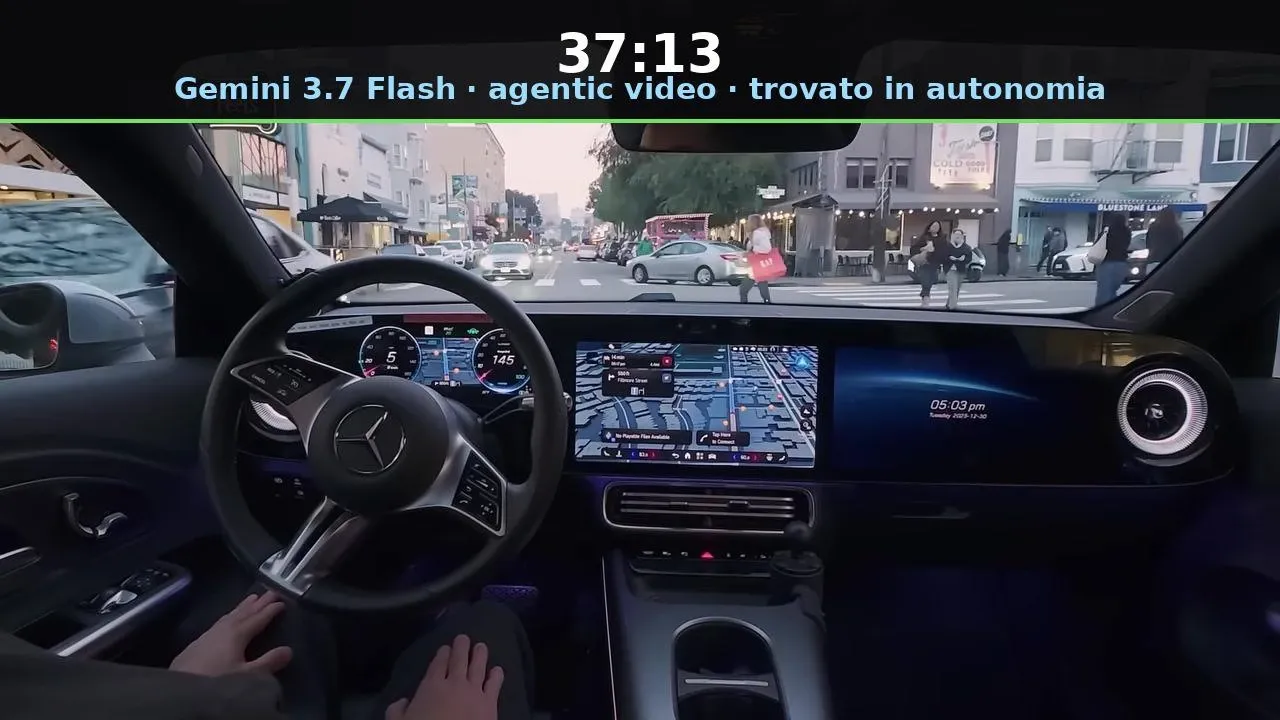
Gemini Agentic Video Understanding: cercare dettagli in 91 minuti
Il motivo sta nel modo in cui funziona questa modalità. Normalmente, per comprendere un video, un modello multimodale campiona il contenuto secondo una frequenza prestabilita e analizza molte informazioni, anche quando gran parte del video non è rilevante per la richiesta. Con Agentic Video Understanding, invece, Gemini decide autonomamente come esplorare il video: può individuare le sezioni potenzialmente rilevanti, saltare quelle inutili, tornare su un segmento e aumentare temporaneamente la frequenza dei frame analizzati quando deve osservare un evento molto breve o un dettaglio specifico.
In altre parole, non “guarda” tutti i 91 minuti nello stesso modo: ragiona su dove cercare e su quanto approfondire. È questo comportamento agentico a rendere interessante un test del genere. Non sto chiedendo un riassunto generale del video, ma di trovare un dettaglio visivo che può apparire per pochi secondi all'interno di oltre un'ora e mezza di contenuto.
Secondo Google, questo approccio può ridurre il consumo di token fino all'88%, i costi fino al 66% e migliorare l'accuratezza fino al 7%.
Al di là dei benchmark, però, nel test la differenza più evidente è stata un'altra: la capacità di trasformare un video molto lungo in qualcosa di realmente interrogabile. Per archivi video, registrazioni di eventi, lezioni, webinar, contenuti industriali o grandi librerie multimediali, significa poter cercare non soltanto “di cosa parla il video”, ma “in quale momento preciso si manifesta un evento”.
Ed è un salto qualitativo notevole rispetto alla semplice comprensione multimodale.
Yann LeCun: prevedere il mondo senza ricostruire ogni pixel
Yann LeCun, in un talk all'ETH di Zurigo, sostiene che un world model non deve generare il futuro, ma prevederne una rappresentazione astratta. Oltre alle critiche note agli LLM, spiega come addestrare questi modelli senza farli collassare. LeCun parte da un fallimento personale: per circa dieci anni ha provato a far prevedere a una rete i fotogrammi successivi di un video, ottenendo immagini sfocate. Il futuro di una scena ha infinite versioni plausibili e un modello che ricostruisce i pixel ne produce la media. Col testo non succede: i token possibili sono finiti.
La risposta è JEPA (Joint Embedding Predictive Architecture): due encoder trasformano presente e futuro in rappresentazioni, e la previsione avviene tra queste, non tra i pixel. Il sistema può scartare ciò che non è prevedibile, come l'aspetto del pubblico in un'aula ripresa solo in parte.
Il talk di Yann LeCun
Questa libertà ha un prezzo: il modo più semplice per azzerare l'errore è ignorare l'input e dare sempre la stessa rappresentazione. È il "collasso", e gran parte della ricerca su JEPA serve a impedirlo.
La soluzione preferita da LeCun è SIGReg, introdotta nel paper LeJEPA con Randall Balestriero. Le rappresentazioni di un batch vengono proiettate su molte direzioni casuali e per ognuna la distribuzione dei punti viene spinta verso una gaussiana. Con abbastanza direzioni, l'insieme diventa una gaussiana isotropa, uguale in ogni direzione: variabili indipendenti, quindi informative. LeWorldModel usa lo stesso regolarizzatore per un world model condizionato sulle azioni, addestrabile su una sola GPU. LeCun ammette che SIGReg non è ancora stato scalato: i risultati su larga scala vengono da V-JEPA, che evita il collasso con altre tecniche.
V-JEPA, addestrato solo a completare video mascherati, offre l'evidenza più interessante: se nel video accade qualcosa di impossibile, come una palla che scompare, il suo errore di previsione sale di colpo. È la "violazione delle aspettative" con cui gli psicologi verificano cosa ha imparato un neonato.
Per un world model la scelta decisiva è cosa non prevedere. La fluidodinamica ignora le molecole per calcolare il flusso attorno a un'ala; un modello che guida un robot o un impianto deve anticipare le conseguenze di un'azione al dettaglio utile a pianificare, non rendere la scena realistica.
ChatGPT Images 2.5: test di coerenza, testo ed editing controllato
OpenAI ha presentato ChatGPT Images 2.5, con miglioramenti su quattro fronti che nei workflow creativi fanno la differenza: qualità visiva, editing più preciso, maggiore coerenza tra modifiche successive e generazione più veloce. OpenAI dichiara una latenza ridotta fino al 50% rispetto a Images 2.0, insieme a una migliore fedeltà alle immagini di riferimento e a una gestione più accurata di istruzioni complesse, texture, luci e composizione.
Via API, la nuova famiglia si articola in due modelli: GPT-Image-2.5 Flare, pensato come scelta standard per velocità, qualità e volumi elevati, e GPT-Image-2.5 Sunburst, orientato ai workflow premium in cui servono più precisione e controllo sugli edit.
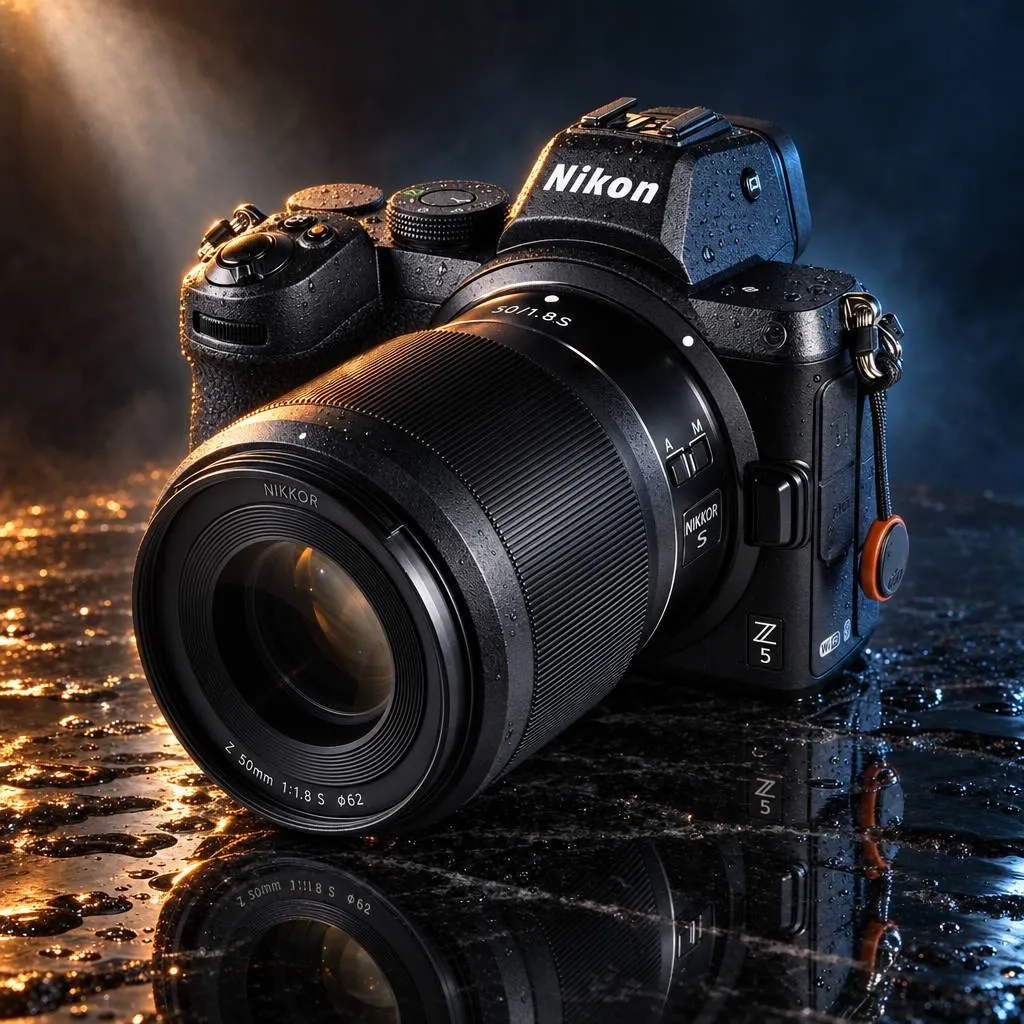
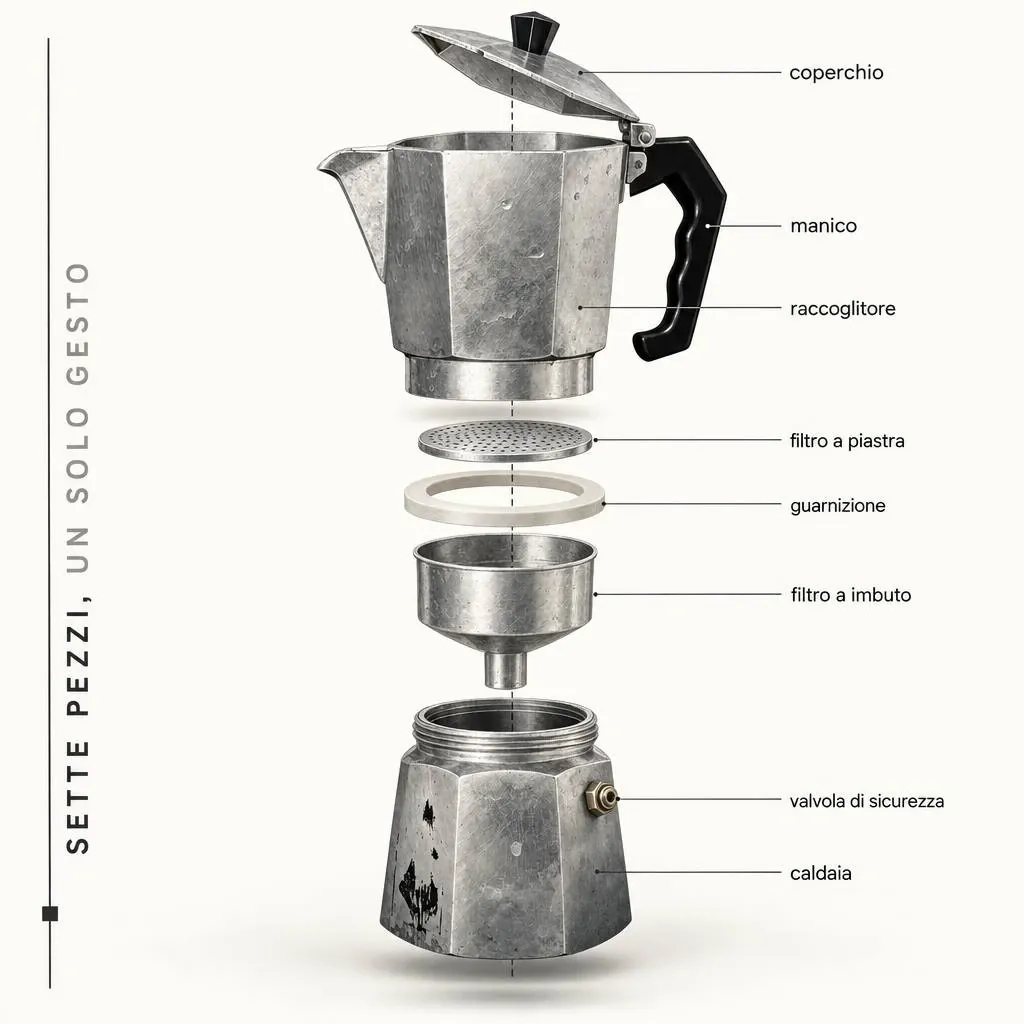
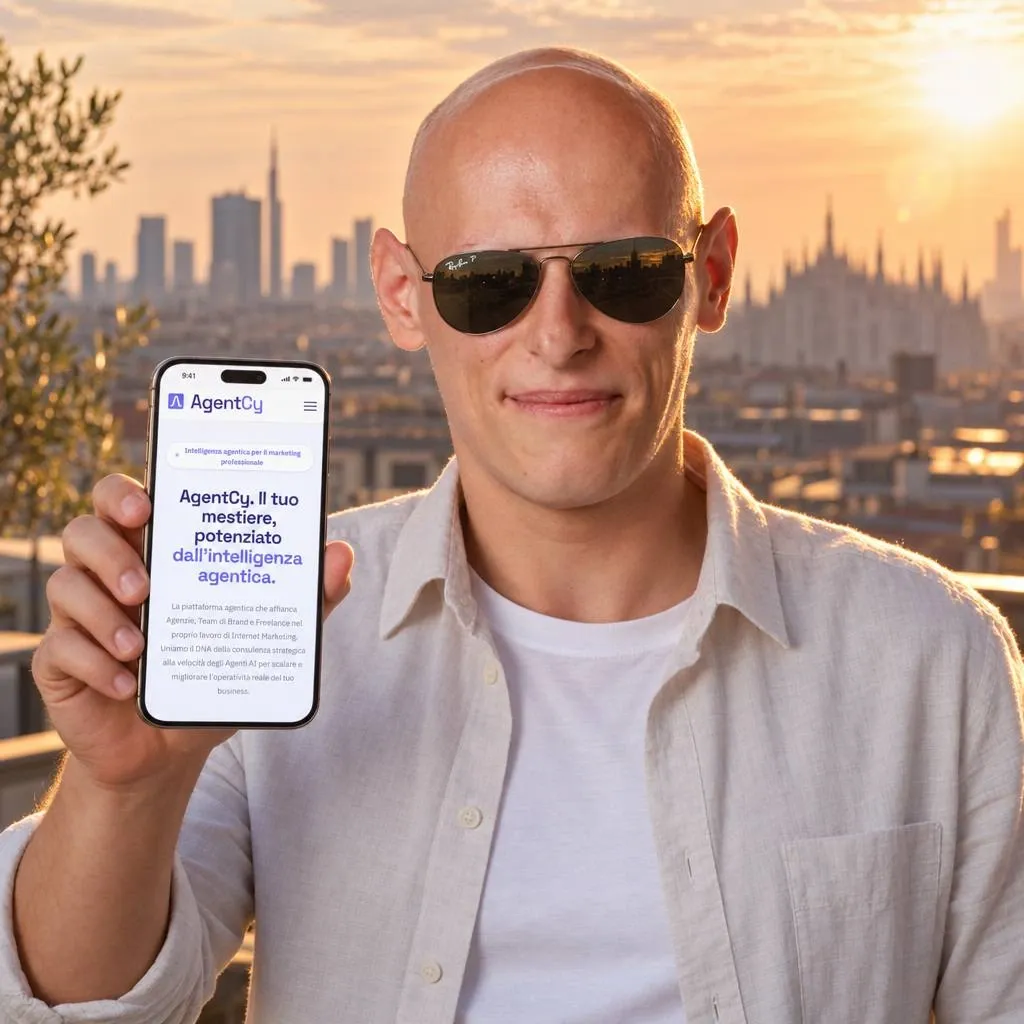
ChatGPT Images 2.5: test di coerenza, testo ed editing controllato
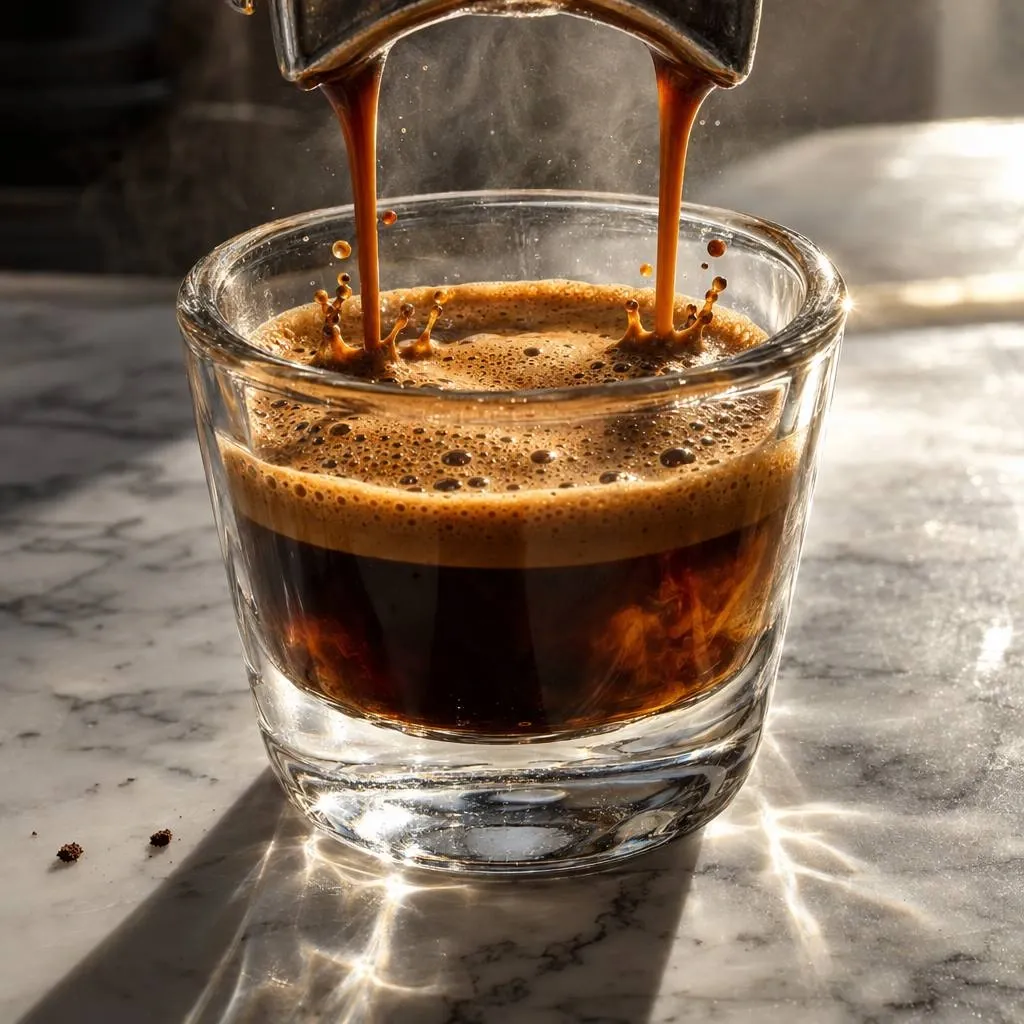
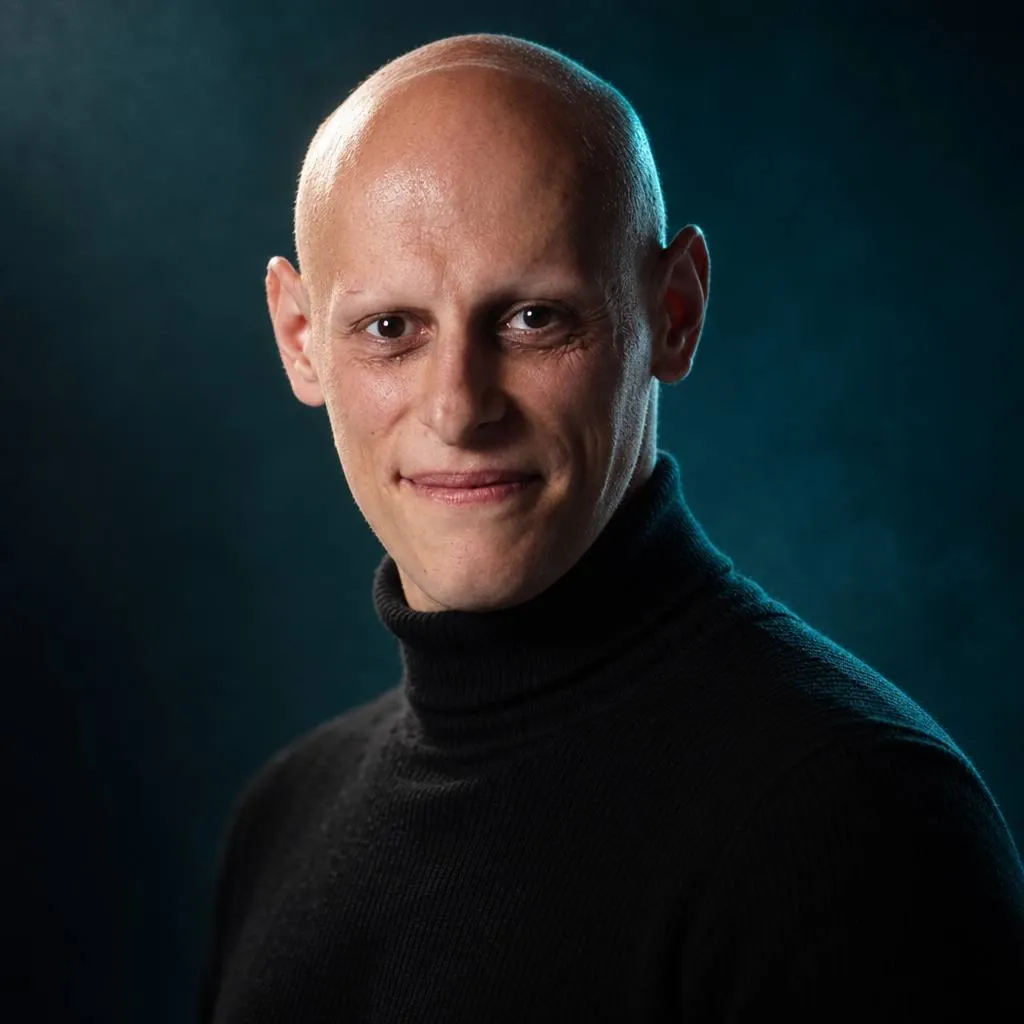
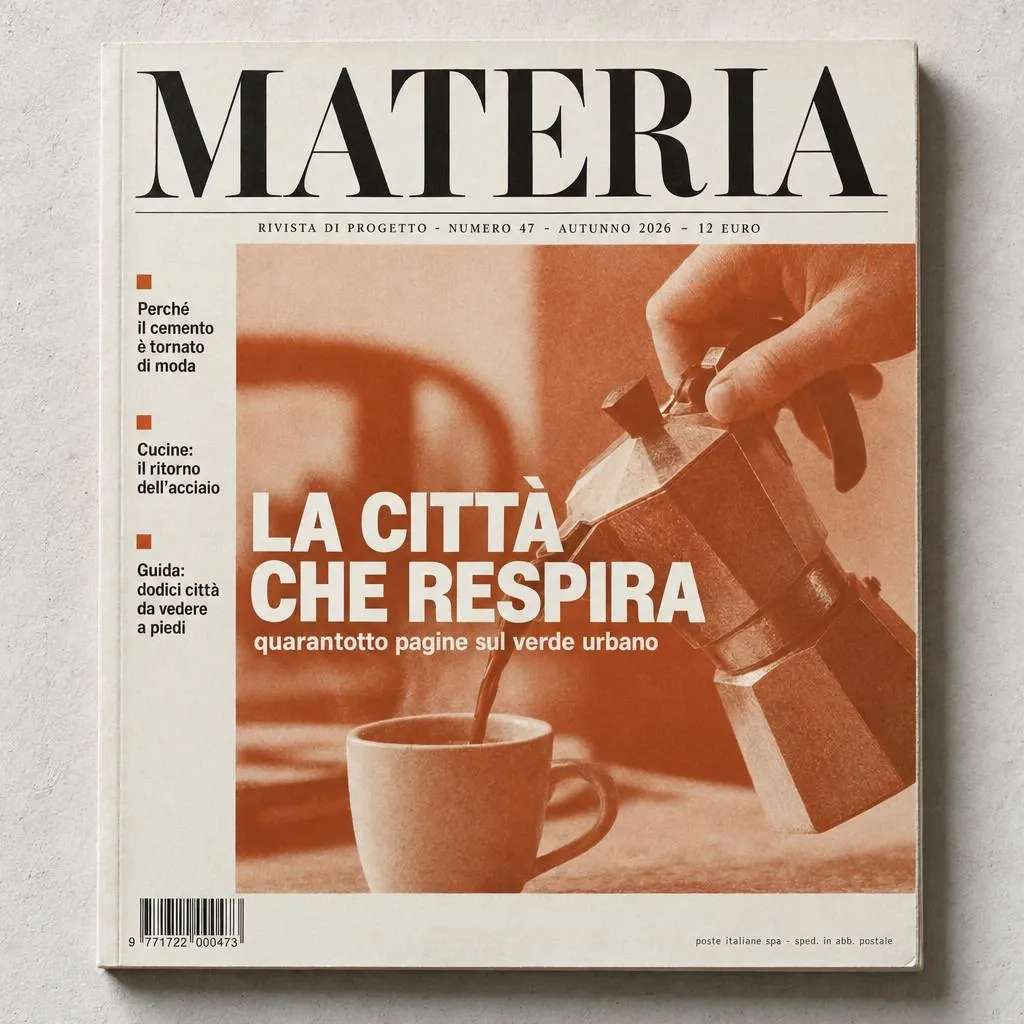
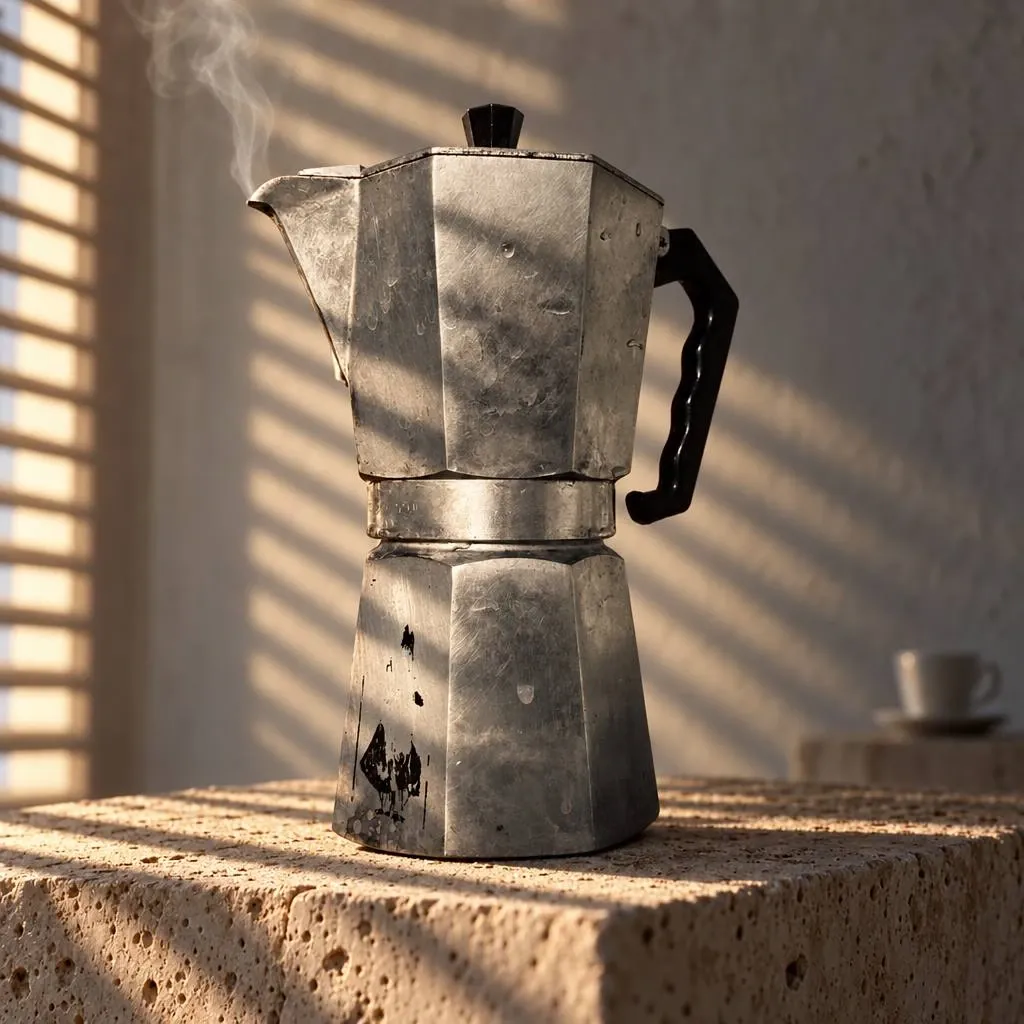
Per i miei test ho usato proprio gpt-image-2.5-sunburst via API. Nelle immagini si vedono alcuni esempi: ho messo sotto stress il modello sulla coerenza di un volto dopo un cambio radicale di luce, sul testo fitto in italiano, sulla fedeltà di un prodotto reale con scritte e incisioni minuscole e sulla capacità di mantenere ammaccature e usura durante una rimessa in scena.
I risultati più interessanti non sono soltanto estetici. Nel ritratto la struttura del volto resta coerente. Una copertina di rivista mantiene titoli, accenti, numeri e gerarchia grafica. Su una fotocamera è servito un secondo run per correggere un dettaglio testuale. Su una moka, invece, difetti e segni d’uso restano coerenti anche dopo aver ricostruito scena e illuminazione.
Ho provato Sunburst anche dentro un agente automatizzato per la generazione di creatività social. Qui il compito non era produrre soltanto una bella immagine, ma arrivare a un asset già composto: fotografia, branding, logo, tipografia, gerarchia visiva e spazio per il copy. Il modello diventa così un componente di una pipeline creativa automatizzata.
Anche l’esperienza in ChatGPT si amplia. Sketch permette di disegnare direttamente una reference da usare come guida; arrivano template per poster, merchandising e foto prodotto; si possono inserire commenti direttamente sulle immagini per indicare cosa modificare e condividere un’immagine insieme al prompt che l’ha generata.
Dai test emerge un cambio di prospettiva: Images 2.5 è più adatto a processi iterativi e controllati, in cui si costruisce e rifinisce un asset mantenendo identità, dettagli e vincoli lungo più passaggi.
Seedance 2.5: bozze economiche e direzione creativa riutilizzabile
ByteDance ha rilasciato tre novità interessanti per la generazione video con Seedance 2.5: una Draft Mode per esplorare idee a basso costo, l'output nativo in 1080p e le Skill personalizzate. Tre tasselli che, insieme, raccontano dove sta andando la generazione video: dal "tentativo fortunato" al flusso di lavoro professionale.
Draft Mode. Si genera in 480p per esplorare idee più velocemente e a costo minore; quando si trova l'inquadratura giusta, si genera il finale in 1080p nativo, mantenendo un alto grado di coerenza in composizione, movimento e direzione creativa. Non è un semplice upscaling: il modello usa la bozza selezionata per generare una nuova versione in 1080p, riutilizzando prompt, materiali di riferimento, seed, aspect ratio e durata. Struttura e movimento restano, ma il dettaglio è nativo. Prima si valida l'idea, poi si investe nel render finale. I numeri ufficiali: per una clip finale di 5 secondi, il risparmio cresce dal 32% con 2 tentativi al 77% con 20 tentativi; con una media di 4 tentativi è circa il 57%, quasi raddoppiando la velocità complessiva. Il punto è che la voce di costo principale nella generazione video è la fase di campionamento ripetuto, e la Draft Mode attacca esattamente quella.
Seedance 2.5: bozze economiche
1080p nativo: frame più nitidi e pronti per la produzione, con colore nativo a 10-bit, texture più ricche e illuminazione e tonalità della pelle più naturali. Il 10-bit conta più di quanto sembri: offre margine in fase di color grading prima che compaia il banding, tipico punto di rottura quando il footage AI viene montato in una timeline colorata.
Skill personalizzate: si possono definire stili, componenti e inquadrature richiamabili in ogni prompt. Il rinnovato Dreamina AI Web le integra insieme a Canvas, con Camera Skills e Style Skills pensate per riusare la propria direzione creativa. In pratica, la "ricetta" creativa smette di vivere dentro ogni singolo prompt e diventa un asset: la si scrive una volta e la si applica a tutte le generazioni successive.
Il quadro: bozze economiche per esplorare, qualità nativa per il render finale, direzione creativa codificata e riutilizzabile. La generazione video smette di essere una lotteria e inizia ad assomigliare a una pipeline di produzione.
Guillermo Rauch: software su misura, infrastruttura ed energia
In una lezione tenuta a Stanford, Guillermo Rauch (CEO di Vercel) ha tenuto insieme tre trasformazioni che di solito raccontiamo separatamente: la fine del SaaS “a taglia unica”, la nascita di un'infrastruttura pensata per gli agenti AI e un'economia che si misura in token e in energia. Primo passaggio: il vibe coding rende conveniente il software su misura. Per decenni il SaaS ha ottimizzato un'interfaccia unica per milioni di clienti; negli esempi della lezione, un CEO si rigenera da solo il gestionale del parcheggio e un team di due persone ricostruisce il layer di presentazione di Salesforce, riusandone però database e workflow. La tesi non è “il software muore”: muore il suo presupposto economico. Quando generare codice costa quasi zero, il prodotto standard perde senso e sopravvive chi si espone agli agenti con MCP, CLI e API.
Secondo passaggio: se gli agenti scrivono e rilasciano software, il cloud cambia ospite. Servono deployment per i coding agent, “blocchi” componibili per costruire i propri agenti (la “block economy” di Mitchell Hashimoto) e un'infrastruttura self-driving che si ottimizza da sola. Attorno nascono categorie specchiate rispetto al web: la “CDN per token” (osservabilità, failover, caching semantico) e la sandbox come “EC2 degli agenti”, perché un modello rende di più se gli metti a disposizione un computer, come il laptop consegnato a un neoassunto il primo giorno.
Guillermo Rauch (CEO di Vercel) a Stanford
Terzo passaggio: cambia la contabilità. Al seat-based pricing subentra il token-based pricing, che misura l'intelligenza erogata; i buyer-agenti vogliono consumption-based pricing e iscrizione istantanea, non trimestri di call commerciali. Per questo Rauch si dice short sui business di contenuti statici e sui drag-and-drop builder (nati quando il codice era scarso) e long su chi opera alla velocità dei token.
La chiusura della lezione dà il quadro fisico: l'intelligenza emerge come flusso bidirezionale, entra energia ed esce intelligenza; non a caso il valore si accumula al di sotto del modello: chip, data center, alimentazione, raffreddamento.
Tre facce della stessa moneta: software che si genera, infrastruttura che lo ospita, energia che lo alimenta. Chi legge un solo anello della catena rischia di capire a metà il cambiamento.
Scegli questo sito web come fonte preferita
Ricevi più facilmente questi contenuti tra i risultati di Google.
Potrai modificare questa preferenza in qualsiasi momento dalle impostazioni di Google.
- GRAZIE -
Se hai apprezzato il contenuto, puoi
contribuire al progetto con una donazione 🙂