tracetrim
Una libreria open source che impara, dalle esecuzioni di un agente AI, quali campi degli output dei tool gli servono davvero, e toglie il resto.
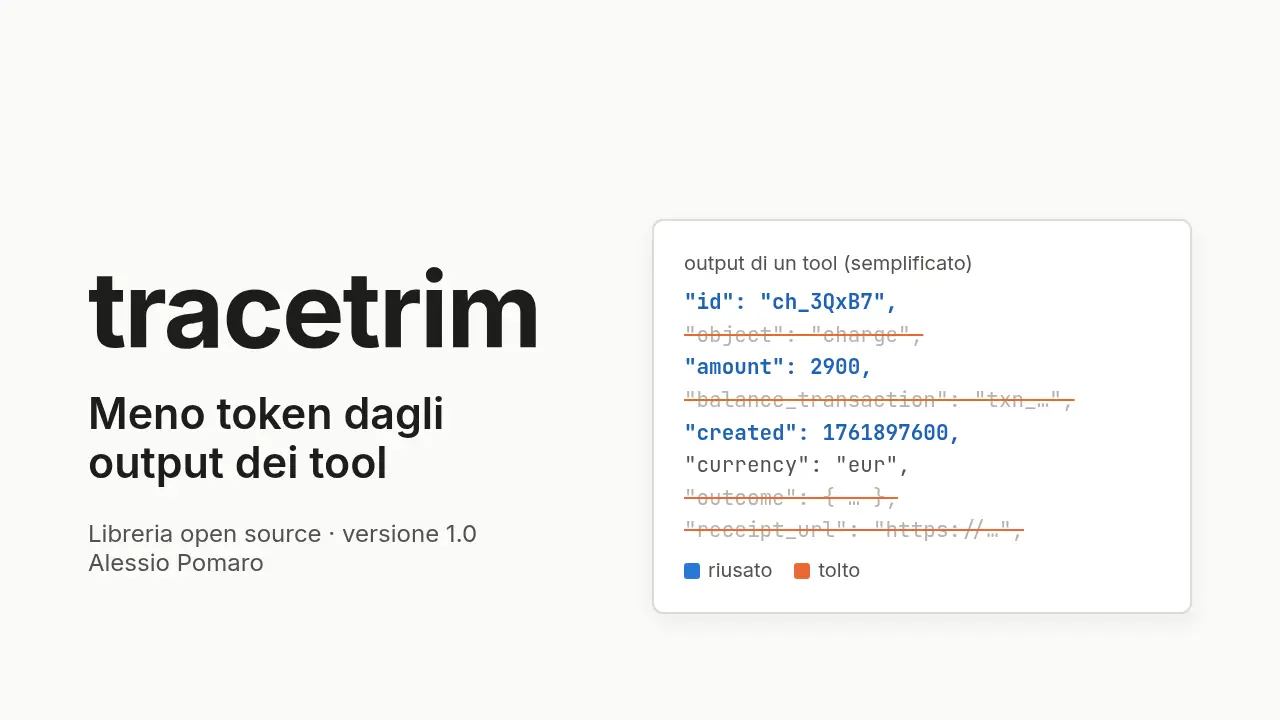
Gli agenti AI leggono molto più di quanto usano. Ogni volta che chiamano un tool ricevono una risposta scritta per i programmi: decine di campi, che il modello paga in token a ogni turno della conversazione, anche quando non gliene serve quasi nessuno.
tracetrim è una libreria open source che impara, dalle esecuzioni del tuo agente, quali campi degli output dei tool l'agente riusa davvero, e toglie il resto. Senza modificare l'agente, e con una via di ritorno per tutto ciò che ha tolto.
tracetrim in due minuti: il problema, l'idea, la telemetria e cosa dice lo studio
Come funziona
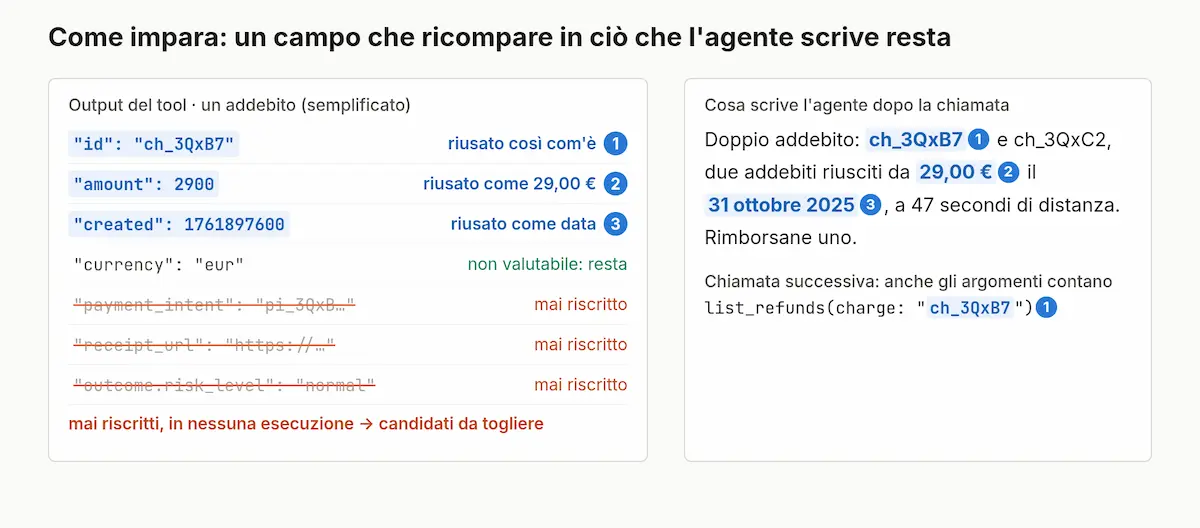
- Osserva. Nelle prime esecuzioni tracetrim non toglie nulla: registra cosa restituiscono i tool e cosa l'agente scrive dopo, nelle chiamate successive e nella risposta finale.
- Impara. Un campo che ricompare in ciò che l'agente scrive è riusato; uno che non ricompare mai è un candidato da togliere. Gli identificativi si tengono sempre, e i valori trasformati (una data riscritta, un importo convertito) si riconoscono.
- Toglie, con prudenza. Dalle esecuzioni successive i campi mai riusati non arrivano più al modello. Se all'agente serve un campo tolto, lo recupera con un tool apposito,
expand, e tracetrim lo impara: dalla volta dopo quel campo resta.
Il JSON viene anche riscritto in forma compatta fin dalla prima chiamata: nessun dato tolto, token risparmiati subito.
Cosa fa risparmiare
Le misure vengono dalla versione 2 del paper, con protocolli congelati prima delle esecuzioni:
- −30% e −24% del costo dell'API del modello per esecuzione su due agenti, recuperi compresi, con tutti i controlli automatici superati;
- quando un compito modificato ha avuto bisogno di campi tolti, l'agente li ha recuperati e tracetrim li ha tenuti dall'esecuzione successiva: 16 casi su 16;
- oltre a ciò che toglierebbero un minificatore e un filtro statico dei metadati fissato in anticipo, la proiezione appresa toglie un ulteriore 40–56% di ciò che resta, su tre agenti su cinque.
Dove aiuta di più: dove gli output dei tool sono grandi e il compito ne usa poco (dati SEO, letteratura scientifica, log di integrazione continua). Dove aiuta meno: dove l'agente cita quasi tutto ciò che legge; lì basta compattare il JSON, e tracetrim lo fa comunque.
Il paper dichiara anche cosa resta da dimostrare: un audit più severo ha trovato alcune diagnosi meno complete con il taglio, quindi la conservazione della qualità non è ancora stabilita, e manca una validazione su compiti nuovi. Sarà l'oggetto della versione 3.
Come si usa
pip install "tracetrim[measure,proxy]"Davanti ai server MCP che usi già. Per Claude Desktop, Claude Code, Cursor e VS Code, un comando fa tutto:
tracetrim init --host claude-code            # mostra cosa cambierebbe, senza scrivere nulla
tracetrim init --host claude-code --write    # copia di sicurezza, server spostati dietro tracetrim
init non stampa mai una chiave, verifica che la nuova configurazione si avvii e si annulla con tracetrim init --undo. Per gli altri host (per esempio l'OpenAI Playground) il proxy si avvia a mano, anche via HTTP.
Dentro un tuo agente con function calling, poche righe nel ciclo che esegue i tool:
from tracetrim.auto import AutoTrim
tt = AutoTrim("tracetrim-data/", min_runs=5)
result = tt.output(tool_name, arguments, raw_output)   # cosa passare al modello
tt.done(final_answer)                                   # a fine esecuzione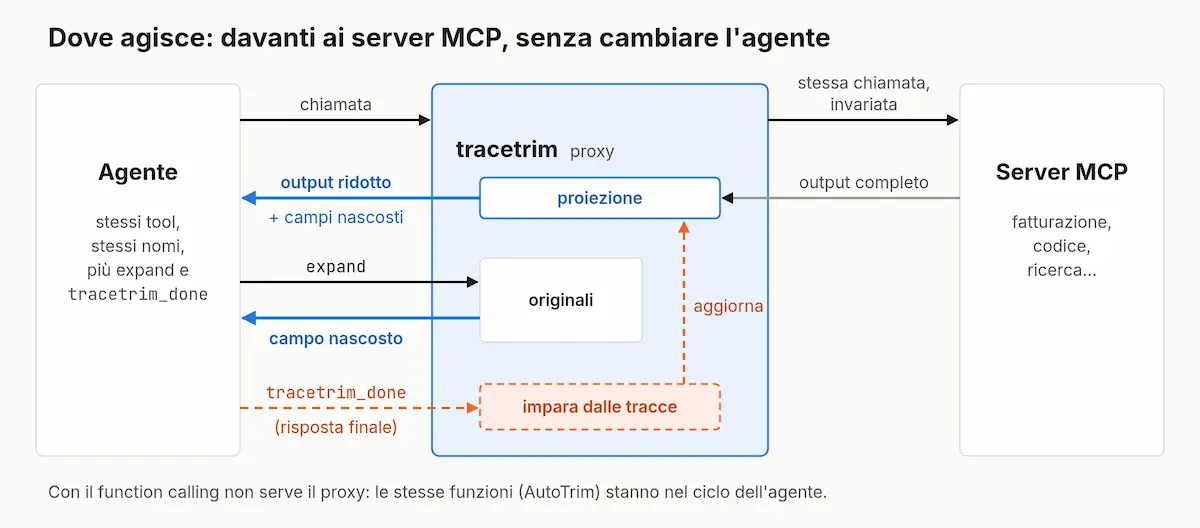
La skill: le istruzioni per l'agente, via MCP
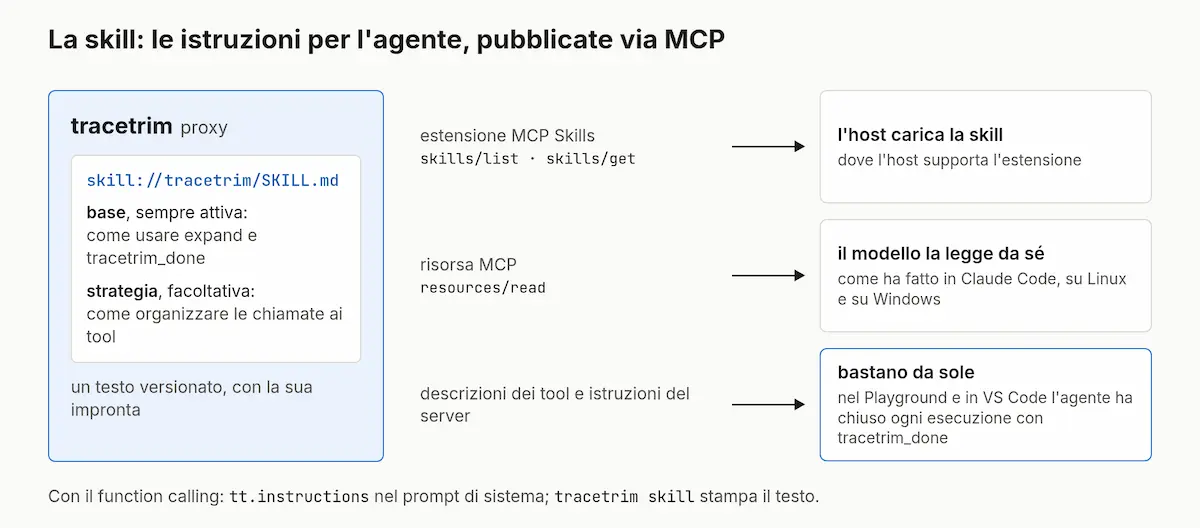
Per lavorare con tracetrim l'agente deve sapere due cose: che un campo tolto si recupera con expand, e che a fine compito deve chiamare tracetrim_done con la risposta, perché tracetrim impara proprio da quella. Queste istruzioni sono un testo unico e versionato, la skill di tracetrim, che il proxy pubblica con l'estensione Skills di MCP all'indirizzo skill://tracetrim/SKILL.md.
La skill ha due livelli. La base, sempre attiva, spiega expand e tracetrim_done. La strategia, facoltativa (--skill-strategy), insegna a organizzare le chiamate ai tool: lanciare insieme quelle indipendenti, raggruppare gli input. Sui modelli che fanno una chiamata per turno può accorciare molto il lavoro (nel paper, su un caso, da 17 a 6 turni); sui modelli che raggruppano già le chiamate non cambia nulla. Per questo è spenta di default.
Il supporto delle skill via MCP negli host è ancora agli inizi, e tracetrim non dipende da esso: la skill arriva al modello per tre strade, e la più semplice, le descrizioni dei tool con le istruzioni del server, basta da sola. Con il function calling il testo si aggiunge al prompt di sistema con tt.instructions.
La telemetria
Dalla prima esecuzione tracetrim tiene aggiornato un report, in italiano e in inglese: quali tool riempiono il contesto, quanto pesano le definizioni dei tool a ogni turno, quali campi l'agente non usa mai, quanto del risparmio viene dal formato e quanto dai campi tolti. Le azioni sicure le applica da solo, le altre le propone a te.
Il report di telemetria: dove vanno i token e cosa cambiare
Dove è stato verificato
- OpenAI Playground: tool, chiusura delle esecuzioni e
expandverificati; - Claude Code, su Linux e su Windows: configurato con
tracetrim init, verificato; - VS Code (Copilot Chat, modalità agente): configurato con
tracetrim init, verificato; - Claude Desktop e Cursor: supportati da
init, non ancora verificati dal vivo.
Il dettaglio, con date e modalità: docs/hosts.md.
Il paper
Agents Read More Than They Use: Learning Tool-Output Projections from Execution Traces, and When They Pay Off
Alessio Pomaro, preprint, versione 2, 2026.
- Ultima versione: doi.org/10.5281/zenodo.23953933
- Versione 1 (…and Where They Fail): doi.org/10.5281/zenodo.23953934, raccontata nell'articolo Agenti AI: quanti token degli output dei tool vanno sprecati?
Codice e dati
- Codice: github.com/alepom/tracetrim (licenza MIT)
- Pacchetto: pypi.org/project/tracetrim
- Software, protocolli e dati: doi.org/10.5281/zenodo.23954124
- Cosa resta stabile nelle versioni 1.x: STABILITY.md
- Novità versione per versione: CHANGELOG