Agenti AI: quanti token degli output dei tool vanno sprecati? Il mio paper e tracetrim
Quanto possiamo alleggerire gli output dei tool senza peggiorare le risposte degli agenti AI? Ho condotto uno studio e sviluppato tracetrim, una libreria open source che apprende i filtri dalle tracce. Nel paper metto alla prova la soluzione per capire quanti token permette di risparmiare.
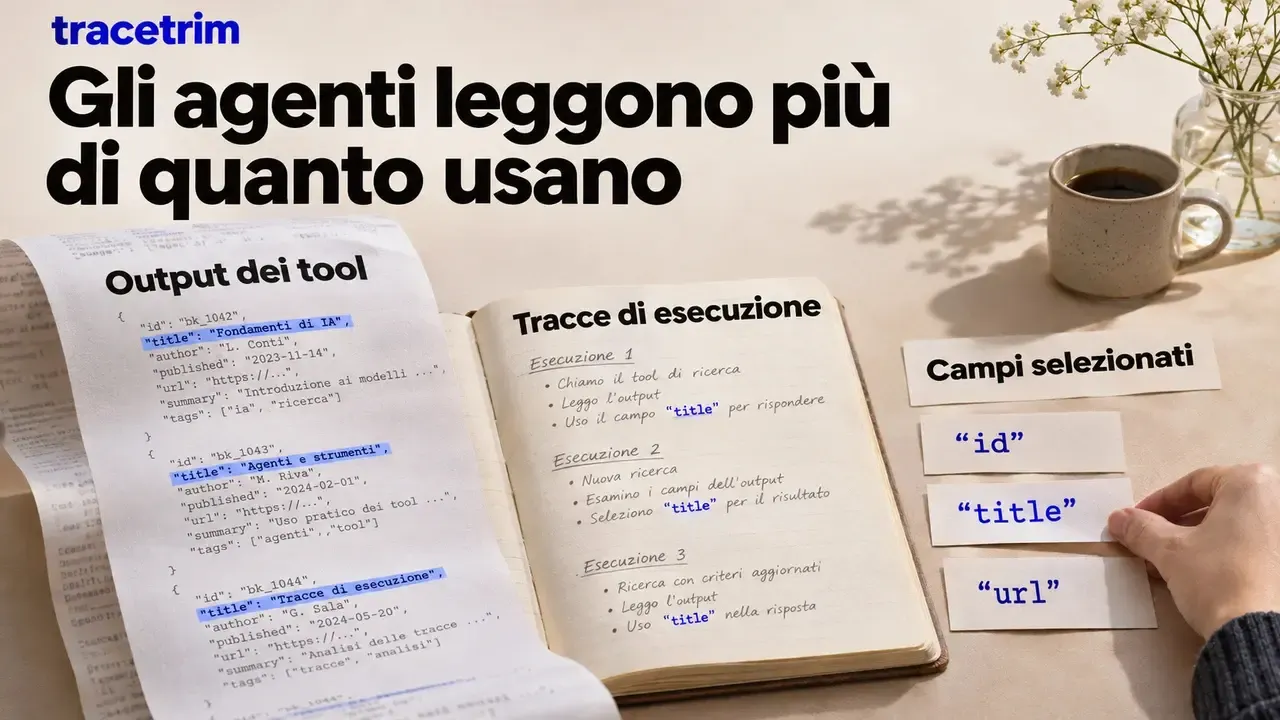
Gli agenti AI non si limitano più a rispondere: cercano dati, leggono pagine, interrogano gestionali e repository di codice, usando strumenti esterni, i tool. Con MCP collegarne di nuovi è diventato semplice, e un agente può averne a disposizione decine.
Ogni chiamata ha però un costo che si vede poco. La risposta del tool entra nel contesto del modello e si paga in token, in quella chiamata e in tutti i turni successivi dell'elaborazione. Su una singola esecuzione è un "dettaglio"; quando l'agente lavora su scala, con centinaia o migliaia di esecuzioni, diventa una voce di costo che pesa, e un contesto pieno di dati che il modello deve comunque leggere.
Cos'è l'output di un tool?
È la risposta che un tool restituisce all'agente: di solito un JSON scritto per i programmi, non per i modelli. Una ricerca su un'API di dati SEO, un addebito in un sistema di pagamenti, una issue in un repository di codice arrivano con decine di campi, spesso annidati. L'agente li legge tutti, anche quando per il compito ne servono pochi.
Per ridurre questo costo, il lavoro più efficace spesso non è comprimere: è scegliere quali campi passare all'agente. Di solito lo si fa manualmente, scrivendo un filtro per ogni tool. Funziona, ma bisogna sapere quali campi utilizzare, tool per tool e compito per compito.
La domanda che mi sono posto è semplice:
quella scelta si può imparare guardando come l'agente ha lavorato nelle esecuzioni precedenti? E dove sbaglia, se sbaglia?
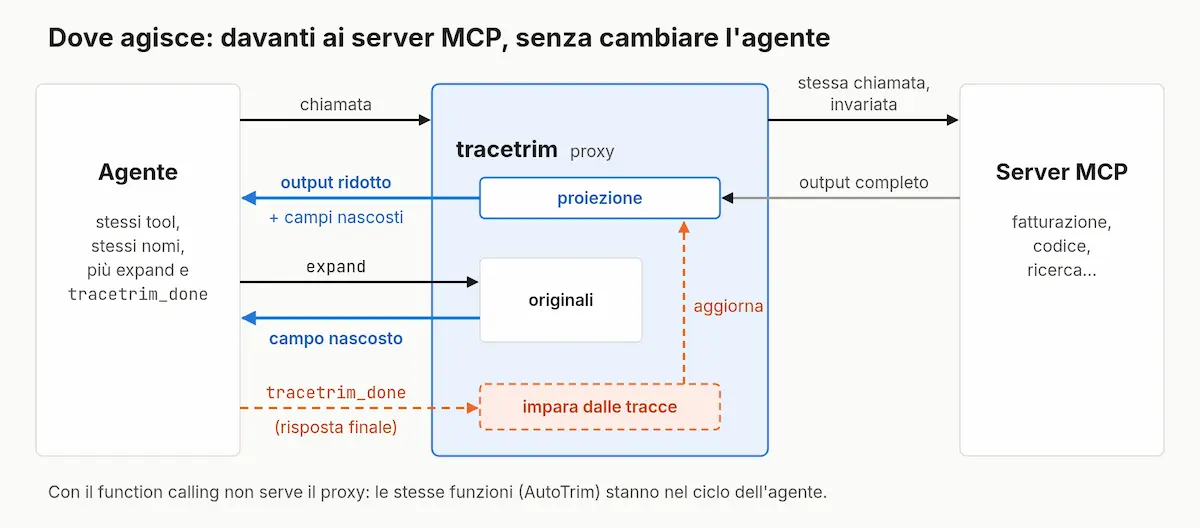
Da questa domanda sono nati uno studio esplorativo e tracetrim, una libreria open source che porta l’idea negli agenti già esistenti. Si inserisce nel percorso tra l’agente e i suoi strumenti, osserva le esecuzioni e apprende quali campi delle risposte vengono riutilizzati. Può quindi consegnare al modello output più leggeri, lasciando recuperabili i dati nascosti.
Il software include anche un report di telemetria: permette di capire quali strumenti riempiono il contesto e dove intervenire, anche senza attivare i filtri. Il paper misura quanto questo approccio può far risparmiare e, soprattutto, dove sbaglia: un dato che non ricompare nella risposta può comunque essere servito per prendere una decisione.
tracetrim: il problema, l'idea, la telemetria e cosa dice lo studio
Il paper
Lo studio esplorativo è pubblicato come preprint su Zenodo:
"Agents Read More Than They Use: Learning Tool-Output Projections from Execution Traces, and Where They Fail".
In breve:
- osserva cinque agenti: tre su API reali (un piano editoriale e un'analisi delle lacune di contenuto con i dati di ricerca di DataForSEO, una scansione della letteratura scientifica sul catalogo OpenAlex) e due su server MCP simulati, i cui dati seguono le descrizioni OpenAPI pubbliche dell'API di Stripe (supporto alla fatturazione) e dell'API REST di GitHub (triage dei fallimenti della CI), sempre riportati a parte;
- segue due studi con protocollo fissato prima di ogni esecuzione: ipotesi, metriche e regole decise in anticipo, ogni modifica successiva dichiarata con data e motivo;
- misura il risparmio su esecuzioni mai viste: il filtro si impara da alcune esecuzioni e si prova su quella esclusa;
- rende pubblici codice, protocolli e dati pubblicabili (GitHub, Zenodo), e ogni numero del paper è generato da uno script.
È un preprint: non è passato dalla revisione di una rivista. Quello che segue è una descrizione semplificata; per i dettagli, i numeri completi e i limiti rimando al paper.
L'idea: imparare dalle tracce
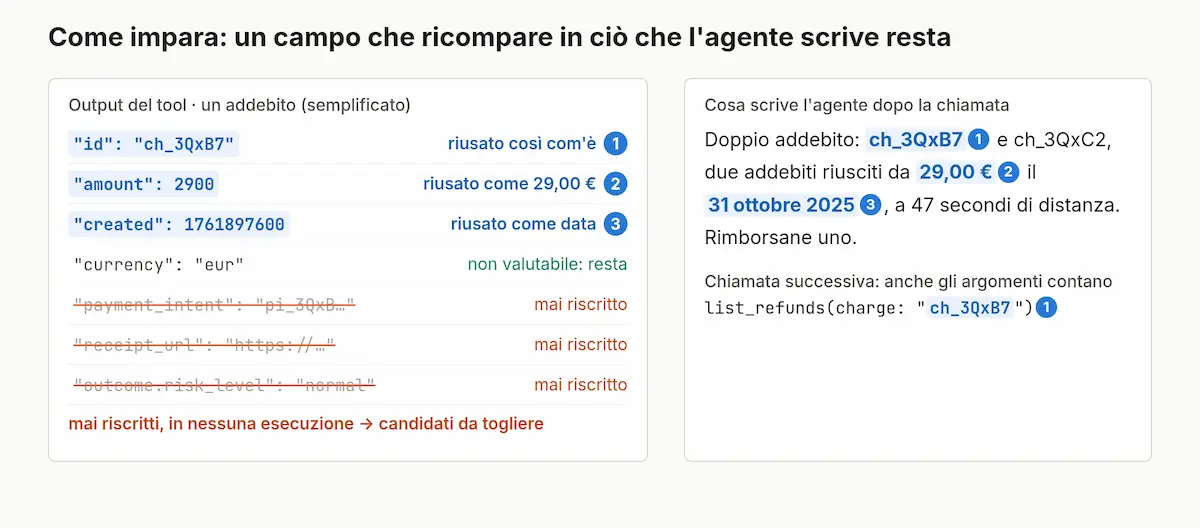
Se un valore restituito da un tool ricompare più avanti, negli argomenti delle chiamate successive o nella risposta finale, l'agente lo ha riusato in modo visibile. Se un campo non ricompare mai, in nessuna esecuzione dello stesso compito, è un candidato da eliminare. Per ogni tool si ottiene così un filtro, che nel paper si chiama proiezione: l'elenco dei campi da mantenere.
Il riconoscimento non è letterale: un timestamp riscritto come data o un importo in centesimi scritto in euro contano come riuso. Ci sono però campi che il rilevamento non sa giudicare (numeri piccoli, valori vero/falso, etichette brevi): la versione prudente del filtro li mantiene.
Cosa è emerso
1. Gli agenti riusano in modo visibile una piccola parte di ciò che ricevono. I campi riusati, insieme alle chiavi dei record, valgono il 32% dei token restituiti dai tool nel piano editoriale e il 19% nella scansione della letteratura (casi reali); il 17% e il 18% nei due casi simulati. Su esecuzioni mai viste, la prima versione del filtro, nella forma prudente, ha tolto il 63% e il 70% dei token dei tool in quei due casi reali, il 69% e il 77% nei simulati.
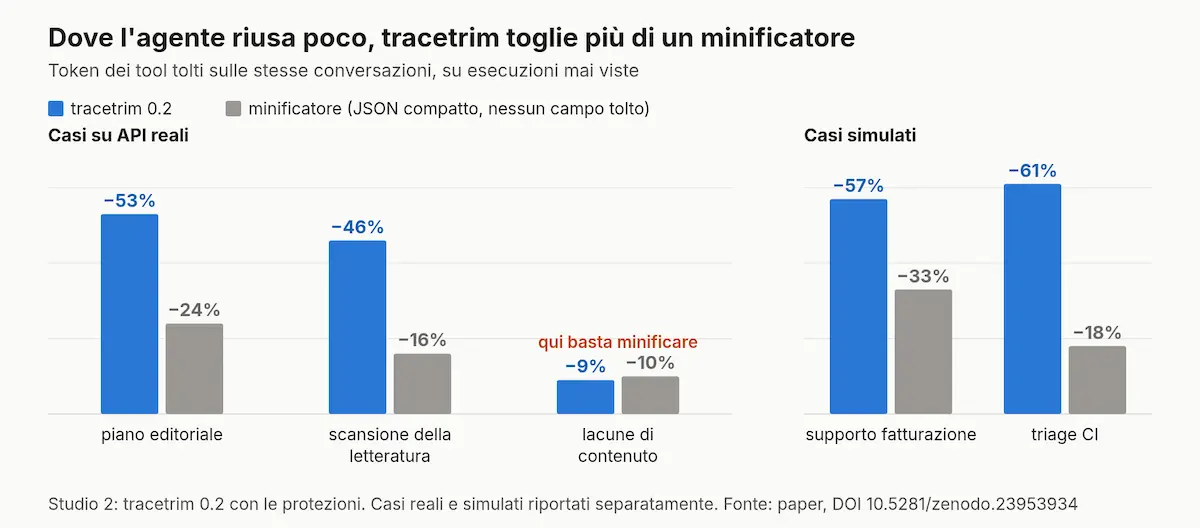
2. Più di un minificatore, tranne dove l'agente riusa quasi tutto. Un minificatore riscrive il JSON in forma compatta senza togliere nessun campo: è il termine di paragone minimo. Sulle stesse conversazioni, la versione 0.2, valutata nel secondo studio e dotata delle protezioni descritte più avanti, toglie:
- nel piano editoriale il 53%, contro il 24% del minificatore; nella scansione della letteratura il 46%, contro il 16% (casi reali);
- nel supporto fatturazione il 57%, contro il 33%; nel triage CI il 61%, contro il 18% (casi simulati).
Anche partendo da JSON già minificato, toglie ancora il 39% e il 35% nei due casi reali, il 36% e il 53% nei simulati. Le lacune di contenuto sono l'eccezione: lì l'agente riusa quasi tutto ciò che riceve, il filtro toglie il 12% (il 9% con le protezioni) e il minificatore fa meglio, con il 10%.
Come ulteriore termine di paragone, sulle stesse conversazioni, Headroom 0.39.1, una libreria open source di compressione del contesto usata senza stato e in configurazione aggressiva, toglie tra il 17% e il 28% sui due casi reali e tra il 31% e il 33% sui due simulati.
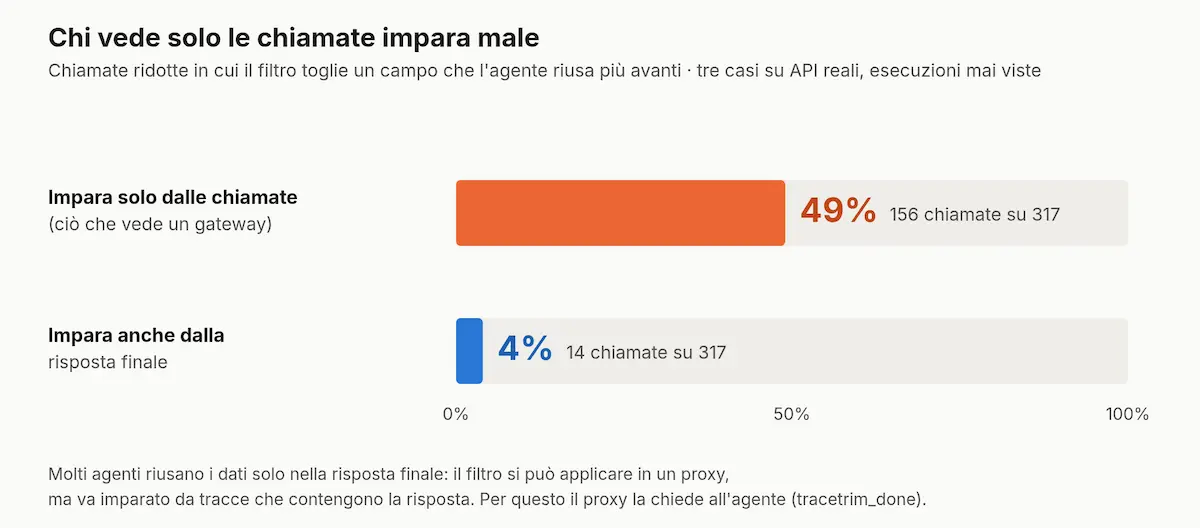
3. Il filtro va imparato dalle tracce complete. Un gateway messo tra agente e tool vede solo le chiamate. Se il filtro impara solo da quelle, nei tre casi reali toglie un campo riusato nel 49% delle chiamate ridotte (156 su 317); se vede anche la risposta finale, nel 4% (14 su 317). Molti agenti riusano i dati solo nella risposta. Il filtro si può applicare in un proxy, ma va imparato da tracce che contengono la risposta.
4. Dal vivo, con expand, si risparmia anche sul conto. Nelle esecuzioni dal vivo l'agente aveva un tool in più, expand, per recuperare i campi nascosti. I token in input fatturati sono scesi del 56% nel piano editoriale (caso reale) e del 32% nel supporto fatturazione (caso simulato). Gli agenti hanno usato expand, ma non sempre: in un'esecuzione l'agente non ha recuperato un dato nascosto e ha sbagliato un ticket in più rispetto alle esecuzioni senza filtro. E ricontrollando a posteriori i volumi di ricerca riportati nel piano editoriale, 179 su 180 sono confermati e uno è stato scritto senza fonte: i controlli automatici non potevano accorgersene.
Dove fallisce, e perché
Rigiocando le stesse conversazioni con le risposte filtrate, sono emersi tre modi precisi in cui il filtro perde informazione:
- Valori trasformati. La data di fine abbonamento arriva come timestamp e l'agente la scrive "20 novembre". Il filtro non riconosce la data riscritta, conclude che il campo non serve e lo toglie: l'agente risponde al cliente in modo vago.
- Campi usati solo per decidere. L'agente legge il titolo di una issue per capire quale problema riguarda, ma nella risposta scrive solo il numero. Il filtro toglie i titoli, e l'agente non riesce più a collegare un fallimento alla issue giusta.
- Identificativi inventati. È il risultato più serio. Senza il campo con l'identificativo di un articolo, l'agente non ha scritto "non disponibile": ha inventato identificativi in sequenza, partendo dall'esempio che aveva nelle istruzioni.
Da qui le due protezioni della versione 0.2: gli identificativi si tengono sempre e i valori trasformati si riconoscono (date, importi, URL ridotti a identificativo). Hanno riparato i fallimenti esaminati, sulle stesse conversazioni. Non è una validazione indipendente, e un quarto meccanismo resta aperto: il motivo di un pagamento rifiutato arriva in inglese, l'agente lo traduce in italiano, e il filtro non riconosce la traduzione.
Come si usa tracetrim
Dallo studio è nata tracetrim, una libreria open source che applica ciò che ha funzionato: il filtro prudente, gli identificativi sempre tenuti, i valori trasformati riconosciuti ed expand sempre disponibile. Si installa da PyPI:
pip install "tracetrim[measure,proxy]"Con i server MCP, tracetrim fa da intermediario. Nel suo file di configurazione si inseriscono i server che l’agente già utilizza, con i rispettivi endpoint o comandi di avvio e le modalità di autenticazione. Poi si collega l’agente a tracetrim al posto dei server originali. Un solo proxy può gestirne diversi: presenta i loro strumenti e inoltra ogni chiamata al server corretto. Può funzionare localmente oppure essere esposto attraverso un endpoint HTTP raggiungibile dall’applicazione che ospita l’agente.
tracetrim proxy --servers mcp.json --auto tracetrim-data/Immaginiamo un agente che prepari un piano editoriale interrogando DataForSEO. Nelle prime esecuzioni tracetrim consegna al modello gli output completi e osserva quali valori vengono riutilizzati nelle chiamate successive e nella risposta finale. Raccolte abbastanza esecuzioni complete — cinque nella configurazione predefinita — può iniziare ad applicare i filtri previsti dalla modalità automatica. Se alcuni campi risultano candidati alla rimozione, DataForSEO continua a restituirli, ma tracetrim può nasconderli prima che arrivino al modello.
Nascondere non significa rendere irrecuperabile. Il risultato filtrato contiene una nota con i campi o i gruppi nascosti e un riferimento alla chiamata. L’agente può usare il tool expand per recuperarli dalla risposta originale conservata, finché disponibile, senza interrogare nuovamente DataForSEO. Deve però riconoscere quando gli servono: la presenza di expand non garantisce che lo faccia sempre.
Per apprendere, al proxy serve anche la risposta finale. Nelle istruzioni dell’agente va quindi richiesto di chiamare il tool tracetrim_done, passando il testo completo della risposta prima di mostrarla all’utente. Non basta aggiungere quel nome al messaggio. La chiamata consegna la risposta e chiude l’esecuzione; quelle chiuse senza risposta contribuiscono alla telemetria, ma non all’apprendimento dei filtri automatici.
Con il function calling, l’integrazione avviene nel codice. AutoTrim entra nel ciclo che esegue gli strumenti: espone expand, riceve gli output attraverso tt.output(...) e la risposta finale attraverso tt.done(risposta). Qui la chiusura può essere gestita direttamente dal programma. In una configurazione ibrida, proxy MCP e AutoTrim possono produrre due report distinti, in cartelle separate; per una telemetria unificata occorre raccogliere tutte le chiamate attraverso un’integrazione comune.
Di base, gli output filtrati restano JSON, serializzato in forma compatta. È possibile attivare anche una ricodifica strutturale in formato TOON oppure il backend Headroom: sono opzioni aggiuntive sperimentali, da verificare sul proprio compito. Le azioni applicate automaticamente e le proposte da valutare manualmente sono descritte nel report.
In una prova con un agente reale sul caso di fatturazione simulato, la modalità automatica ha tolto il 44% dei token dei tool, sia via MCP sia con il function calling. In ciascuna delle cinque esecuzioni di entrambe le modalità, tutti e cinque i ticket hanno superato il test a parole chiave. È una verifica, non una valutazione sotto protocollo: le misure sono quelle del paper.
La telemetria, e come usarla per ottimizzare
Dalla prima esecuzione tracetrim tiene aggiornato un report di telemetria, in italiano e in inglese: quanto pesa ogni tool, quali campi l'agente non riusa mai, quante chiamate falliscono, e una lista di suggerimenti. È utile anche senza filtrare nulla.
Il report di telemetria
Nell'esempio qui sotto, cinque esecuzioni del caso di fatturazione simulato: i token restituiti dai tool passano da 91.483 a 38.682 (−58%) con il filtro prudente, su esecuzioni escluse dall'apprendimento. In 9 chiamate su 50 sarebbe servito un campo tolto: è per questo che expand resta attivo.
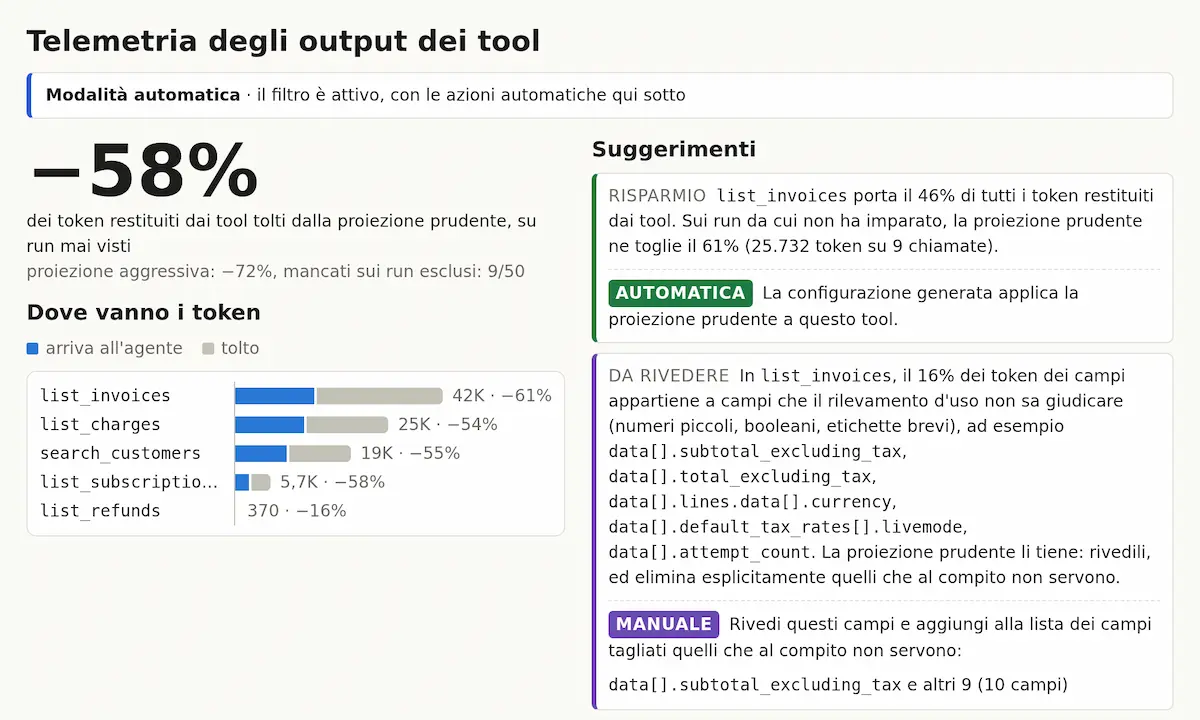
I suggerimenti sono di due tipi. Quelli automatici (AUTOMATIC, nel report in italiano AUTOMATICA), cioè filtro prudente, JSON compatto ed expand, la modalità automatica li applica da sola. Quelli manuali (MANUAL, MANUALE) restano a chi conosce il compito: per esempio i campi che il rilevamento non sa giudicare, da togliere solo se si è sicuri che non servano.
Il percorso che consiglio è in quattro passi:
- Lasciar lavorare la modalità automatica, sul traffico normale dell'agente.
- Controllare le risposte, e quante volte l'agente usa
expand: se lo usa spesso su un tool, lì il filtro toglie qualcosa che serve. - Decidere le azioni manuali: campi da togliere a mano, descrizioni dei tool da correggere.
- Congelare la configurazione quando convince: è un file JSON leggibile, da rivedere e versionare come il resto del codice. Da lì in poi il proxy parte con quella, al posto della modalità automatica:
tracetrim proxy --servers mcp.json --config tracetrim-data/report.config.json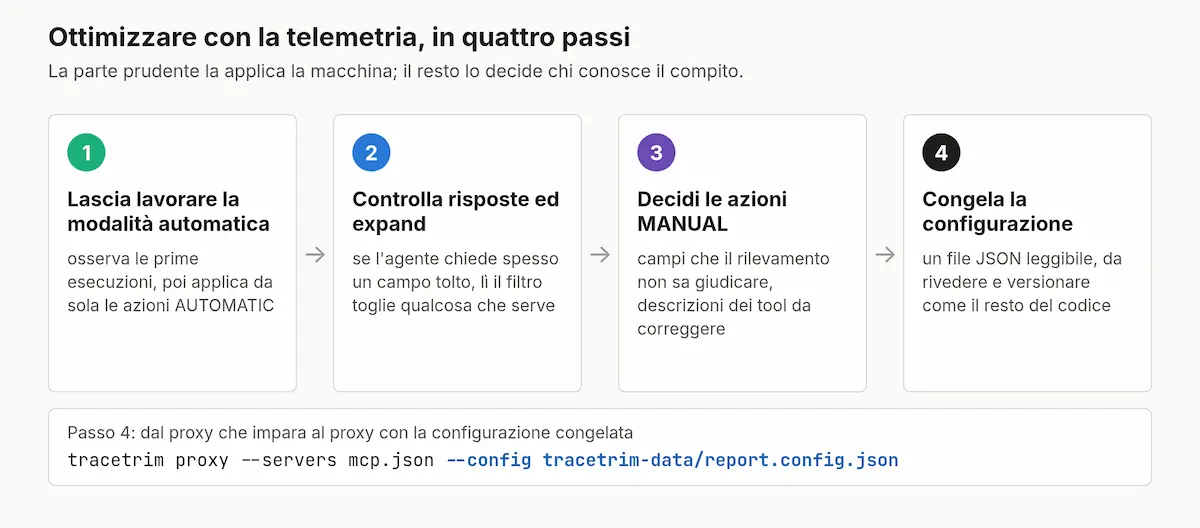
Allora, conviene?
Una regola pratica, valida per compiti simili a quelli provati:
- l'agente riusa una piccola parte di ciò che riceve (cataloghi, pagamenti, risultati di ricerca con molti campi) → un filtro imparato dalle tracce toglie molto più di un minificatore;
- l'agente riusa quasi tutto → basta minificare;
- in ogni caso: identificativi protetti,
expandsempre disponibile, e il filtro trattato come una proposta da rivedere, non come un interruttore. La parte prudente può applicarla una macchina; il resto lo decide chi conosce il compito.
Cosa questo studio non dice
È uno studio esplorativo, con poche esecuzioni per caso e un solo modello: non so se altri modelli riusino gli output dei tool allo stesso modo. Il riuso che misuro è quello visibile nel testo: ciò che l'agente usa solo per ragionare non si vede, ed è proprio lì che il filtro sbaglia. Le protezioni sono state progettate sui fallimenti trovati e provate sulle stesse conversazioni: servono compiti, esecuzioni e modelli nuovi per dire quanto spesso la qualità delle risposte resti la stessa. Due casi su cinque sono simulati: la forma dei dati è realistica, il contenuto no. E la modalità automatica è successiva agli studi: è stata verificata con un agente vero, non misurata con un protocollo.
Il prossimo passo naturale è ripetere la misura su compiti e modelli nuovi, con le protezioni fissate in anticipo.
I riferimenti
Paper
"Agents Read More Than They Use: Learning Tool-Output Projections from Execution Traces, and Where They Fail", Alessio Pomaro, preprint, 2026.
 Pomaro, Alessio

Codice e dati
- Libreria e codice dello studio: GitHub (MIT)
- Installazione:
pip install "tracetrim[measure,proxy]"(PyPI) - Software, protocolli e dati: Zenodo, DOI 10.5281/zenodo.23954125
Lo studio è indipendente: non ha rapporti con DataForSEO, OpenAlex, Stripe, GitHub o gli autori di Headroom.
Per citarlo:
Pomaro, A. (2026). Agents Read More Than They Use: Learning Tool-Output Projections from Execution Traces, and Where They Fail. Preprint. https://doi.org/10.5281/zenodo.23953934
Scegli questo sito web come fonte preferita
Ricevi più facilmente questi contenuti tra i risultati di Google.
Potrai modificare questa preferenza in qualsiasi momento dalle impostazioni di Google.
- GRAZIE -
Se hai apprezzato il contenuto, puoi
contribuire al progetto con una donazione 🙂