Generative AI: novità e riflessioni - #10 / 2026
Decision model e modelli locali nel mio paper, Gemini 4 Carbon e Kimi K3.1 Pro: capacità e costi acquistano significato nei processi. Dai test sugli agenti a TimesFM 3, la verifica dei risultati guida la progettazione.
Buon aggiornamento, e buone riflessioni..
Ascolta l'audio overview che sintetizza le novità
Il podcast è stato generato attraverso Gemini Notebook.
Decision model o modello locale? Il mio paper mette alla prova il confronto
Sull’onda di Jev stanno nascendo nuovi Decision Model, da OpenAI Decisions a Elephant-1 e Mammoth-1 di Base Labs. Ma servono davvero? O un modello piccolo addestrato, magari in locale, farebbe lo stesso lavoro? Ho scritto un paper in cui descrivo i test che ho eseguito per rispondere.
Questi sistemi ricevono un testo e un elenco di opzioni e restituiscono una probabilità per ciascuna, senza generare una risposta. Sono pensati per classificare richieste, smistare ticket e riconoscere intenzioni senza addestramento sul singolo compito.
In “When Are Decision Models Worth It?” li confronto con TF-IDF, SetFit, mmBERT e Qwen 3 da 0,6 a 8 miliardi di parametri, adattati anche con LoRA. Tre dataset, in inglese e italiano, compreso un servizio clienti sintetico; 5, 20 o tutti gli esempi disponibili per categoria, confronti sugli stessi messaggi e tre ripetizioni degli addestramenti.
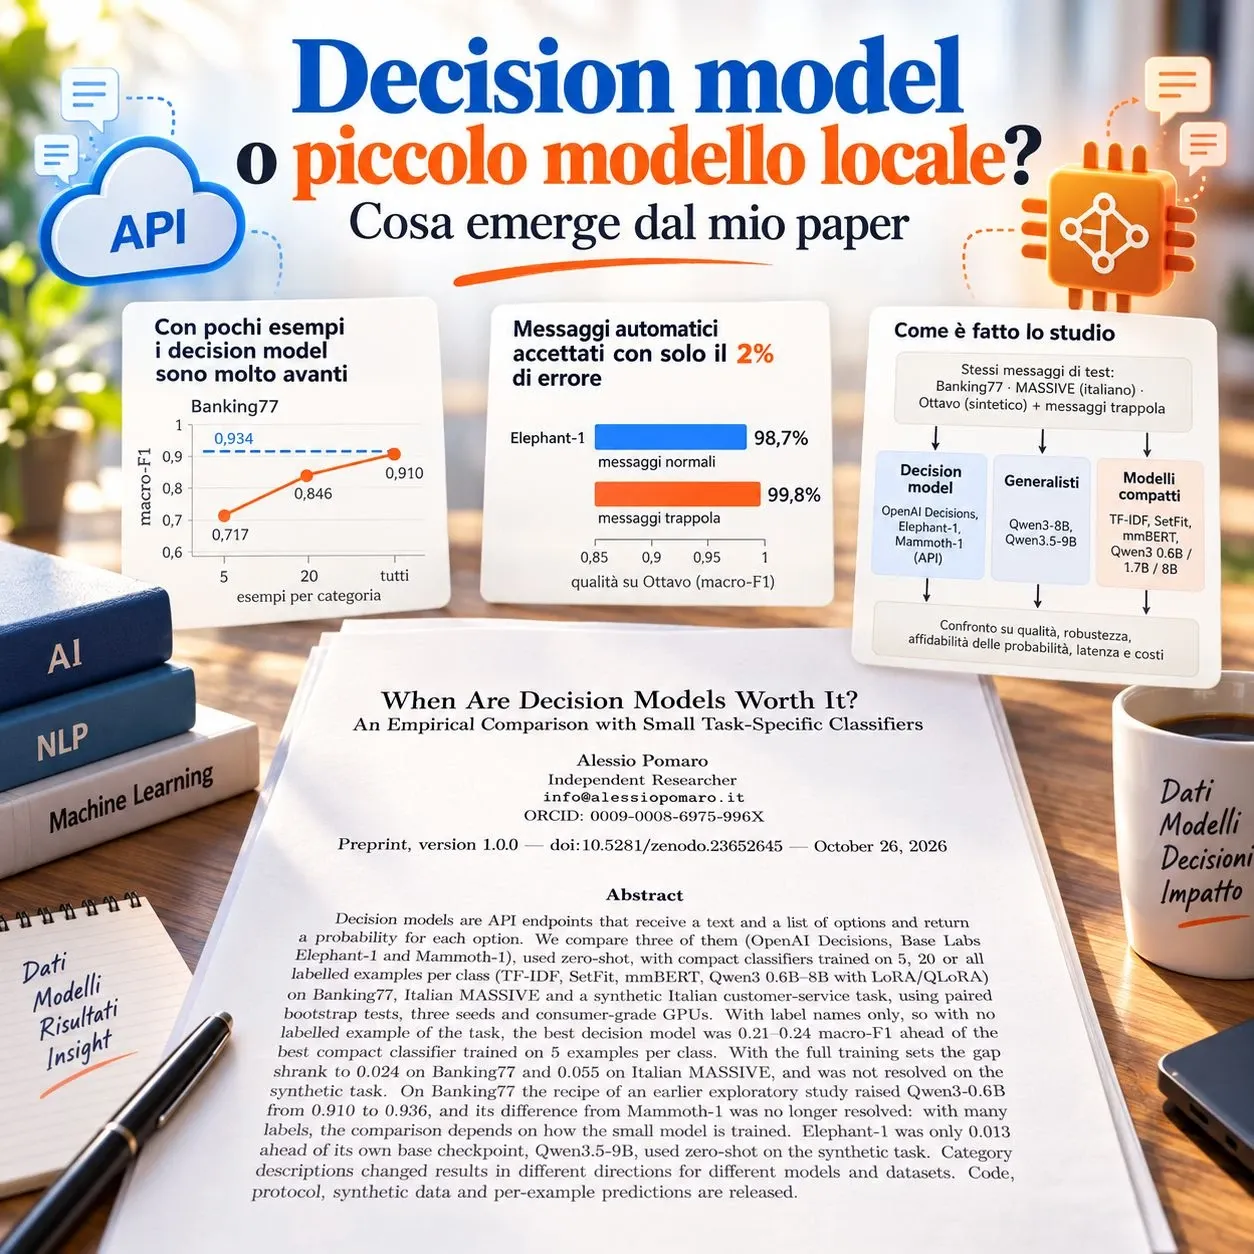
Con 5 esempi per categoria, il miglior decision model supera il miglior classificatore compatto di 21–24 punti di macro-F1, una misura che dà lo stesso peso a ogni categoria. Gli bastano i nomi delle categorie, senza esempi del compito. Con 20 esempi il vantaggio resta di 7–17 punti.
Con tutti i dati il distacco si riduce: su Banking77 Qwen3-0.6B arriva a 0,910 contro 0,934 di Mammoth-1. Su MASSIVE in italiano rimangono 5,5 punti; sul servizio clienti sintetico la differenza con Qwen3-8B non è statisticamente risolta.
Su Banking77, cambiando la ricetta di addestramento, lo stesso Qwen3-0.6B sale a 0,936 in media su quattro esecuzioni. Il test non distingue più il suo risultato da quello di Mammoth-1. L’equivalenza resta da dimostrare; con molti dati, la ricetta di addestramento può cambiare l’esito del confronto.
Il valore dei decision model emerge soprattutto quando mancano esempi etichettati.
Con un archivio consistente e categorie stabili, un modello compatto merita una prova: nella scelta entrano anche privacy, volumi e costi di etichettatura e manutenzione.
Decisions API alla prova: velocità, accuratezza e probabilità da validare
Ho provato le Decisions API di OpenAI su 120 keyword italiane, confrontandole con lo stesso modello, gpt-6-luna, tramite Responses API. Ho valutato intento di ricerca, intento locale e valore commerciale: tre decisioni tipiche di un workflow SEO.
Le Decisions API, in beta pubblica, ricevono testo e immagini e restituiscono risposte tipizzate. Si inviano l'input e domande con istruzioni: "predicate" stima la probabilità che una condizione sia vera, "choice" sceglie tra categorie definite, "score" valuta livelli ordinati. Lo score è una media degli indici dei livelli, pesata per le probabilità. Più domande indipendenti possono condividere lo stesso input in una richiesta.
Nel test di latenza, con una domanda sull'intento, la mediana è stata 263 ms contro 1.155 ms di Responses con reasoning "none": circa 4,4 volte più veloce. OpenAI dichiara circa 10 volte, ma questa è la misura ottenuta dalla mia rete in Italia, su 50 chiamate per configurazione, escluse quelle di riscaldamento.
Sulle 120 keyword, l'accordo con le etichette di riferimento è del 94,2% per Decisions e del 99,2% per Responses senza reasoning: 7 errori contro 1. Le definizioni sono le stesse per entrambe le API. Dataset ed etichette sono stati generati da Claude, senza validazione di un esperto SEO: è un confronto esplorativo, con 19 casi marcati come ambigui.
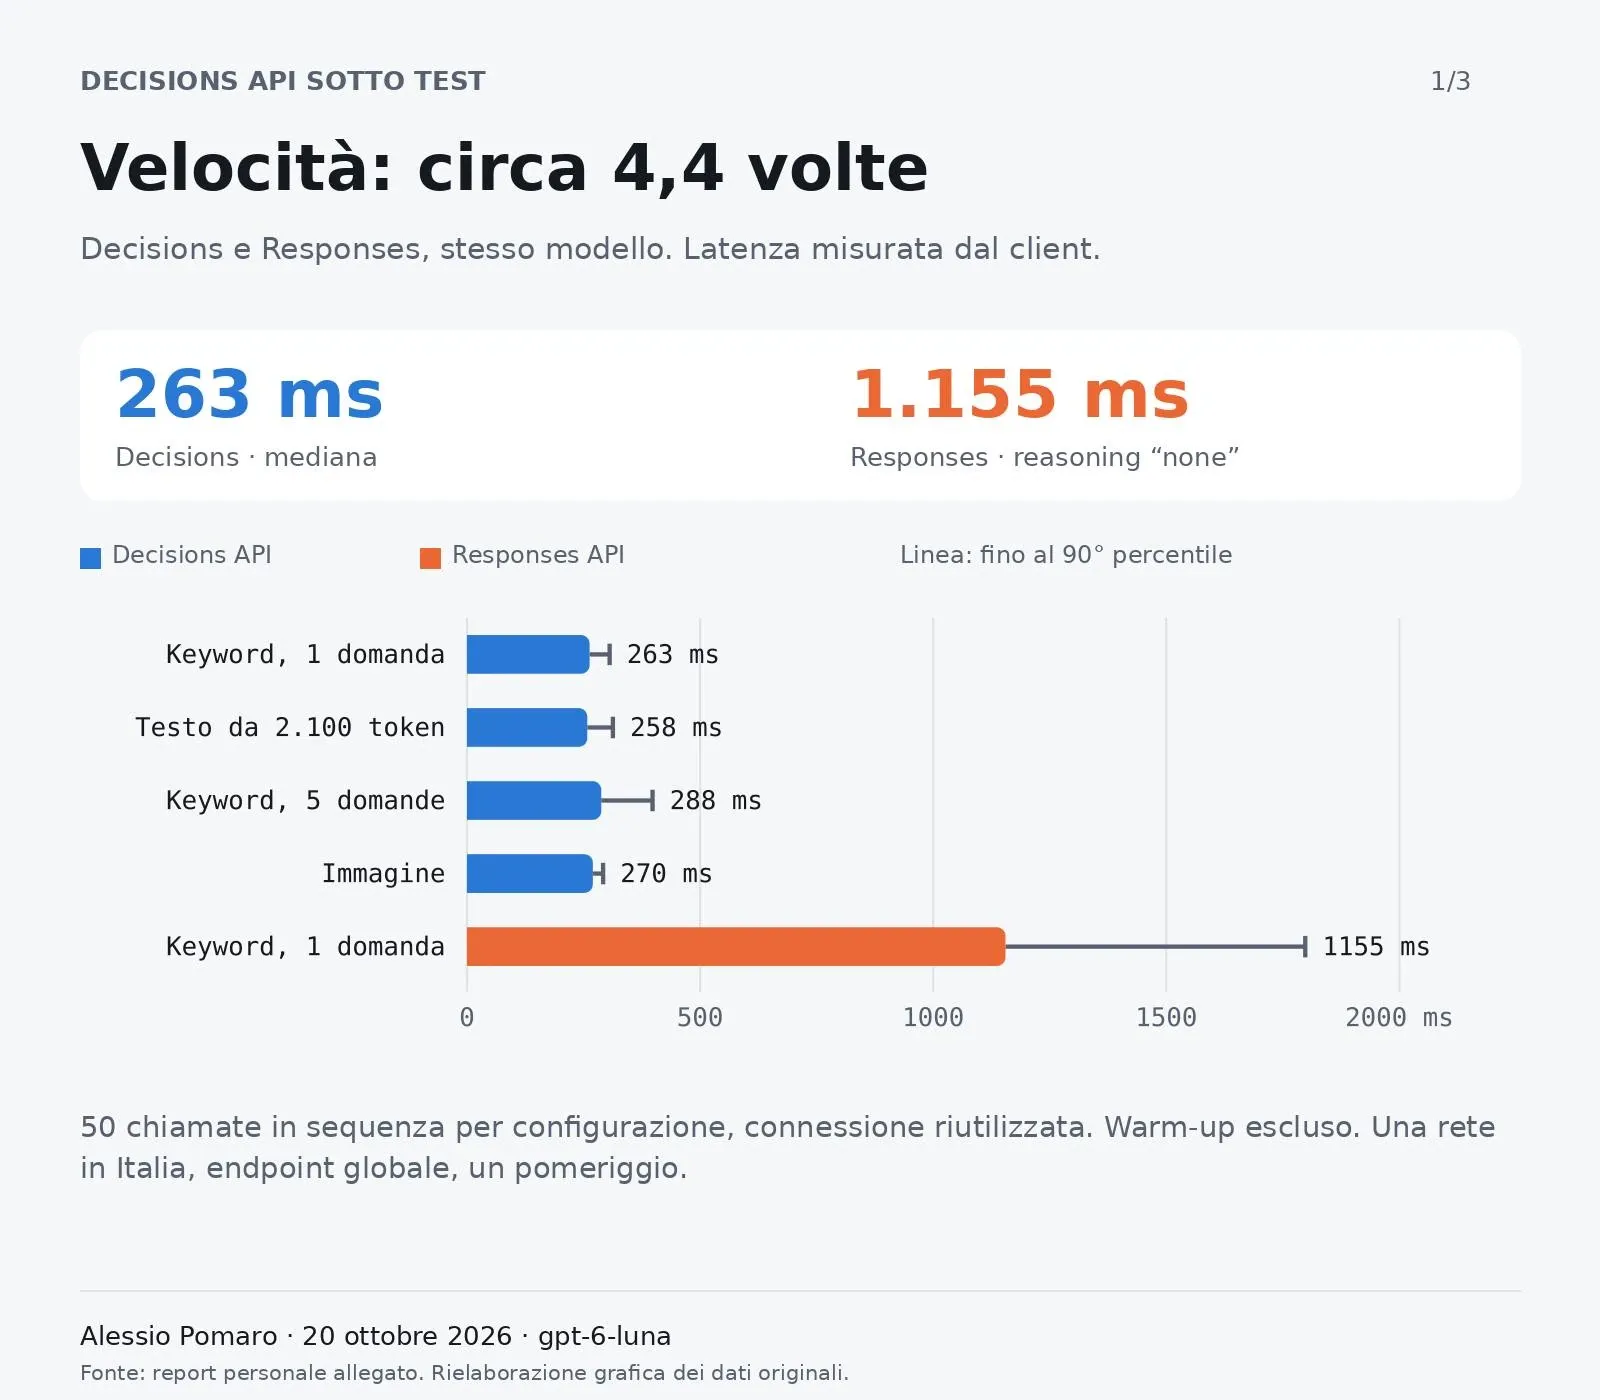
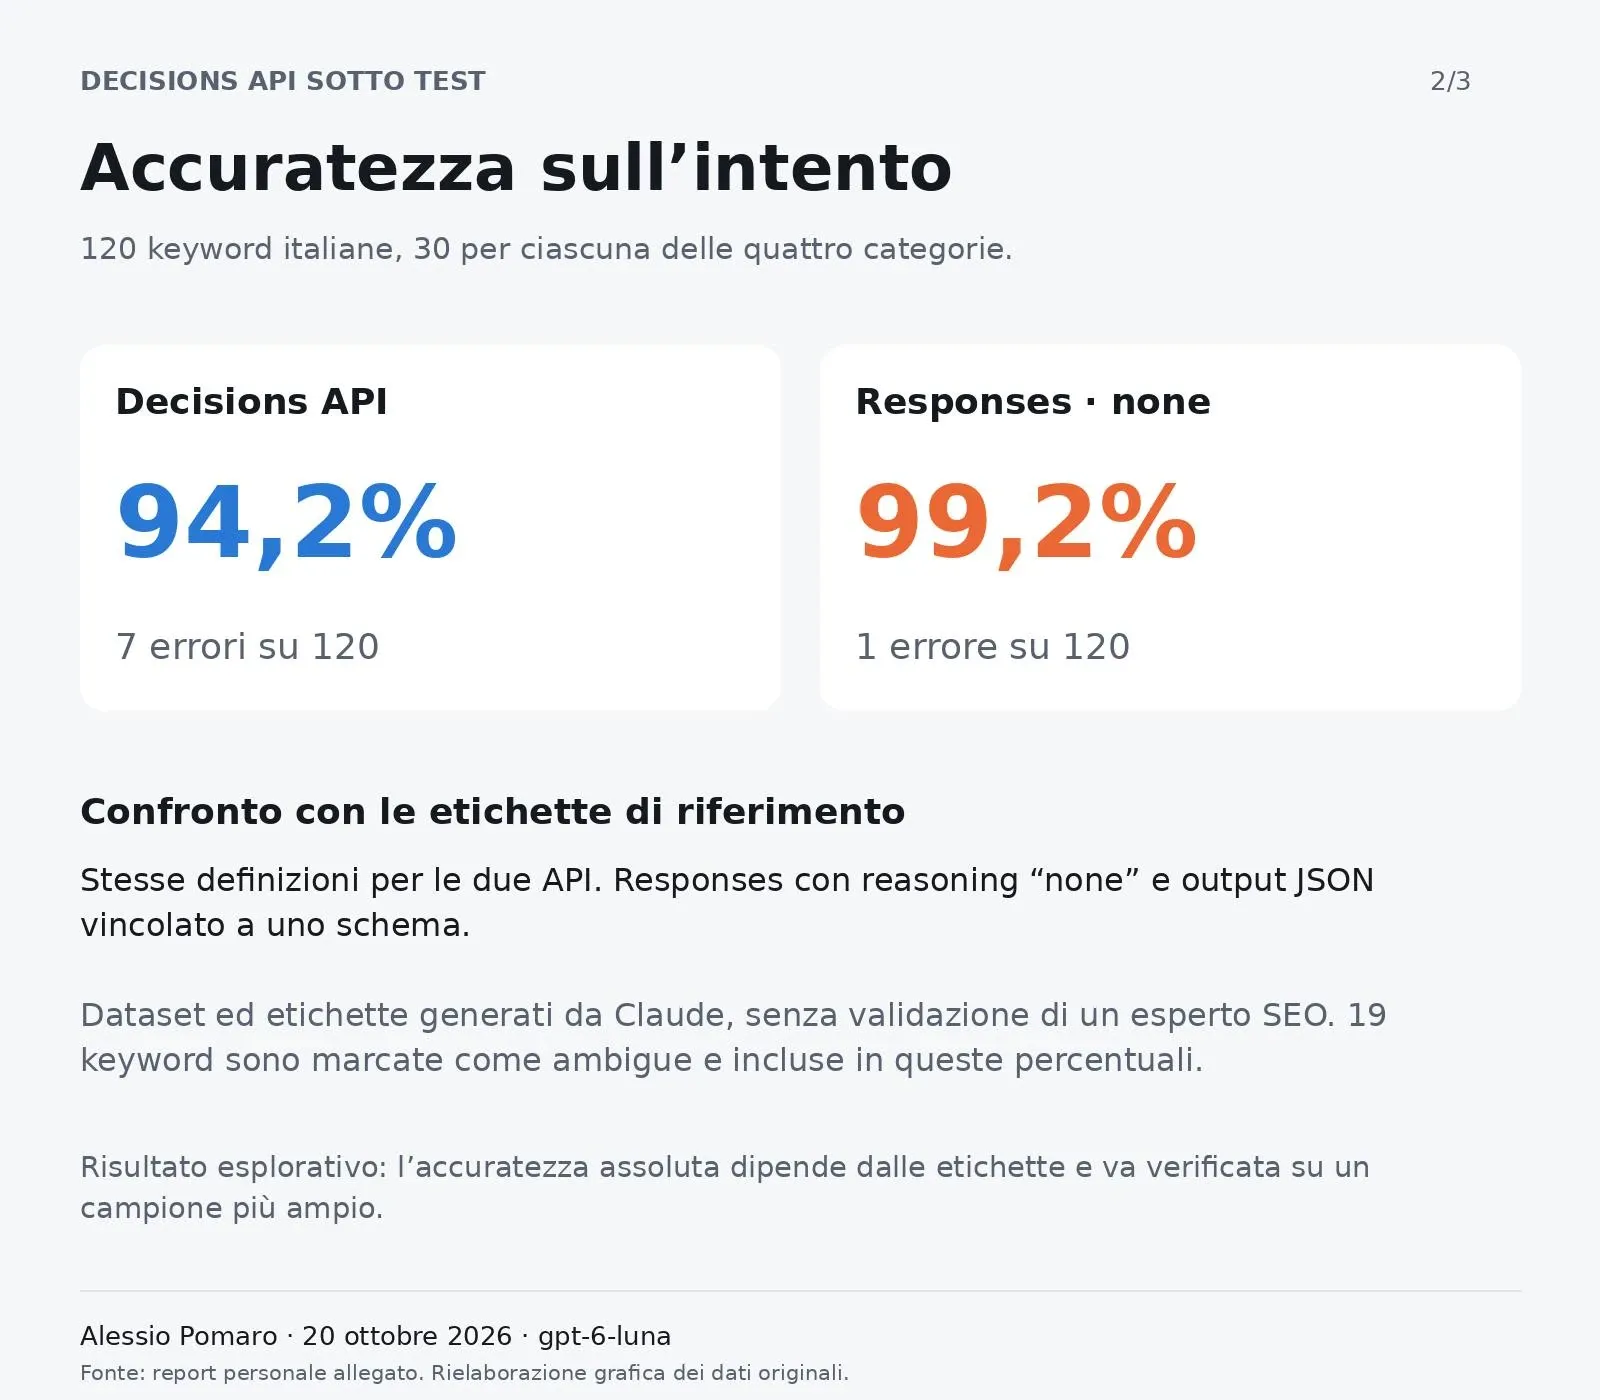
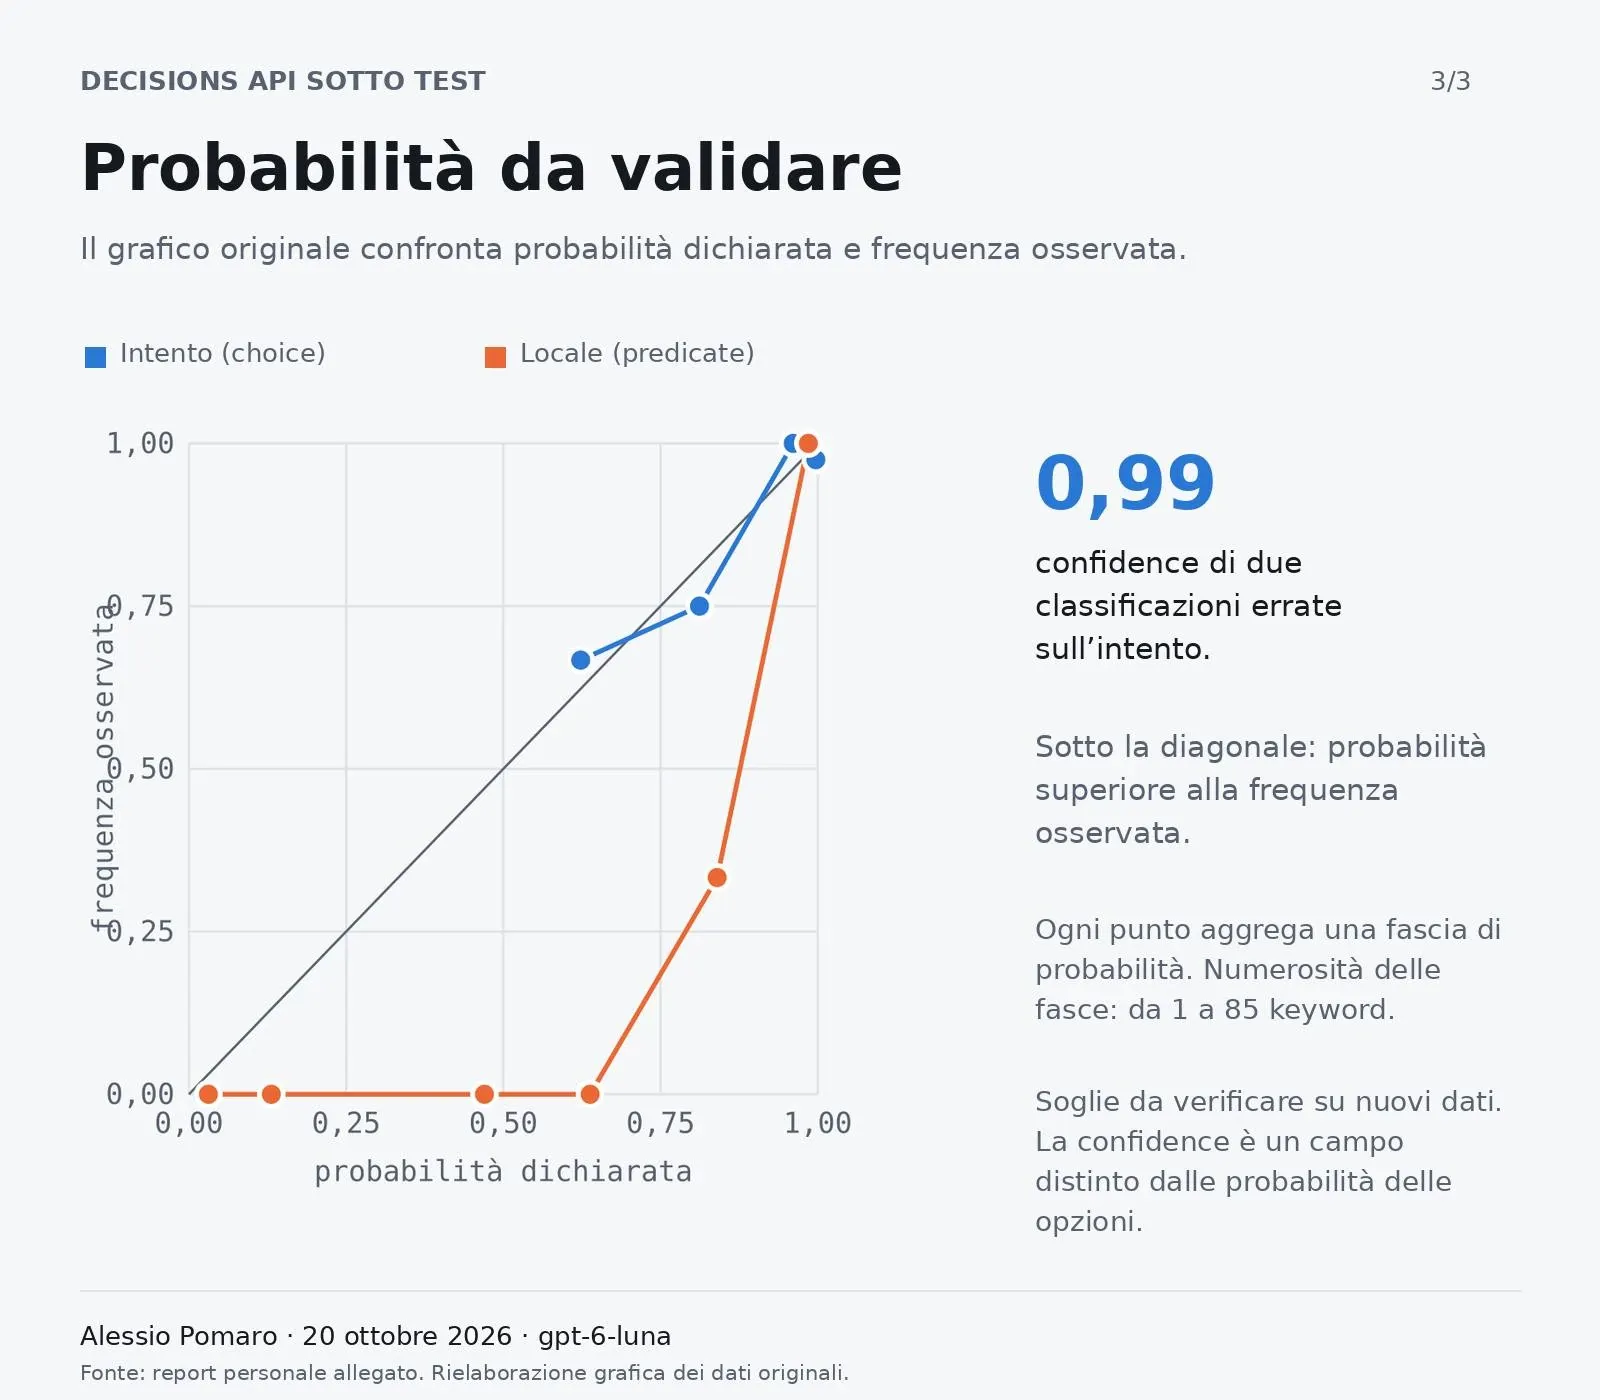
Latenza, accordo con le etichette e probabilità nel test esplorativo sulle keyword.
Le probabilità richiedono attenzione. Due errori sull'intento hanno confidence 0,99. Mandando a revisione il 7,5% delle keyword con confidence sotto 0,7, l'accuratezza sul resto sale al 97,3%. È una soglia ricavata su questo campione, da verificare su dati nuovi prima di usarla in produzione.
Anche le descrizioni delle opzioni pesano: ridotte a una parola, l'accuratezza scende all'84,2%. Sui testi, tre richieste identiche hanno restituito le stesse probabilità. Nell'esperimento con un quadrato rosso, invece, cambiando il solo numero nel testo di accompagnamento, la probabilità oscilla da 0,23 a 0,95: un caso singolo da approfondire.
Per smistare richieste o scegliere il passo successivo di un agente AI, ridurre l'attesa può contare molto.
La scelta dipende però anche dagli errori accettabili, dalle categorie definite e dalle soglie validate sul proprio caso d'uso.
Processi AI-native: riprogettare il lavoro e misurare il valore
La vera trasformazione non consiste nell’aggiungere intelligenza ai processi esistenti, ma nel riprogettarli a partire dalle possibilità dell'AI. Un processo AI-native nasce da una domanda: come lo progetteremmo oggi, con questa tecnologia a disposizione?
Con questa riflessione ho chiuso il mio intervento a un recente evento. L’articolo del Wall Street Journal sulla ricerca di Wharton Human-AI Research e GBK Collective offre dati utili a supporto.
Lo studio “The Adaptive Advantage”, su 1.416 persone in grandi imprese statunitensi, distingue 1.007 manager e figure superiori da 409 dipendenti junior e intermedi. Nel primo gruppo, l’uso quotidiano dell’AI sale dal 46% del 2025 al 62% del 2026, mentre crescono cautela e scetticismo. L’80% dichiara ritorni positivi sugli investimenti, ma solo il 28% li considera fortemente positivi.
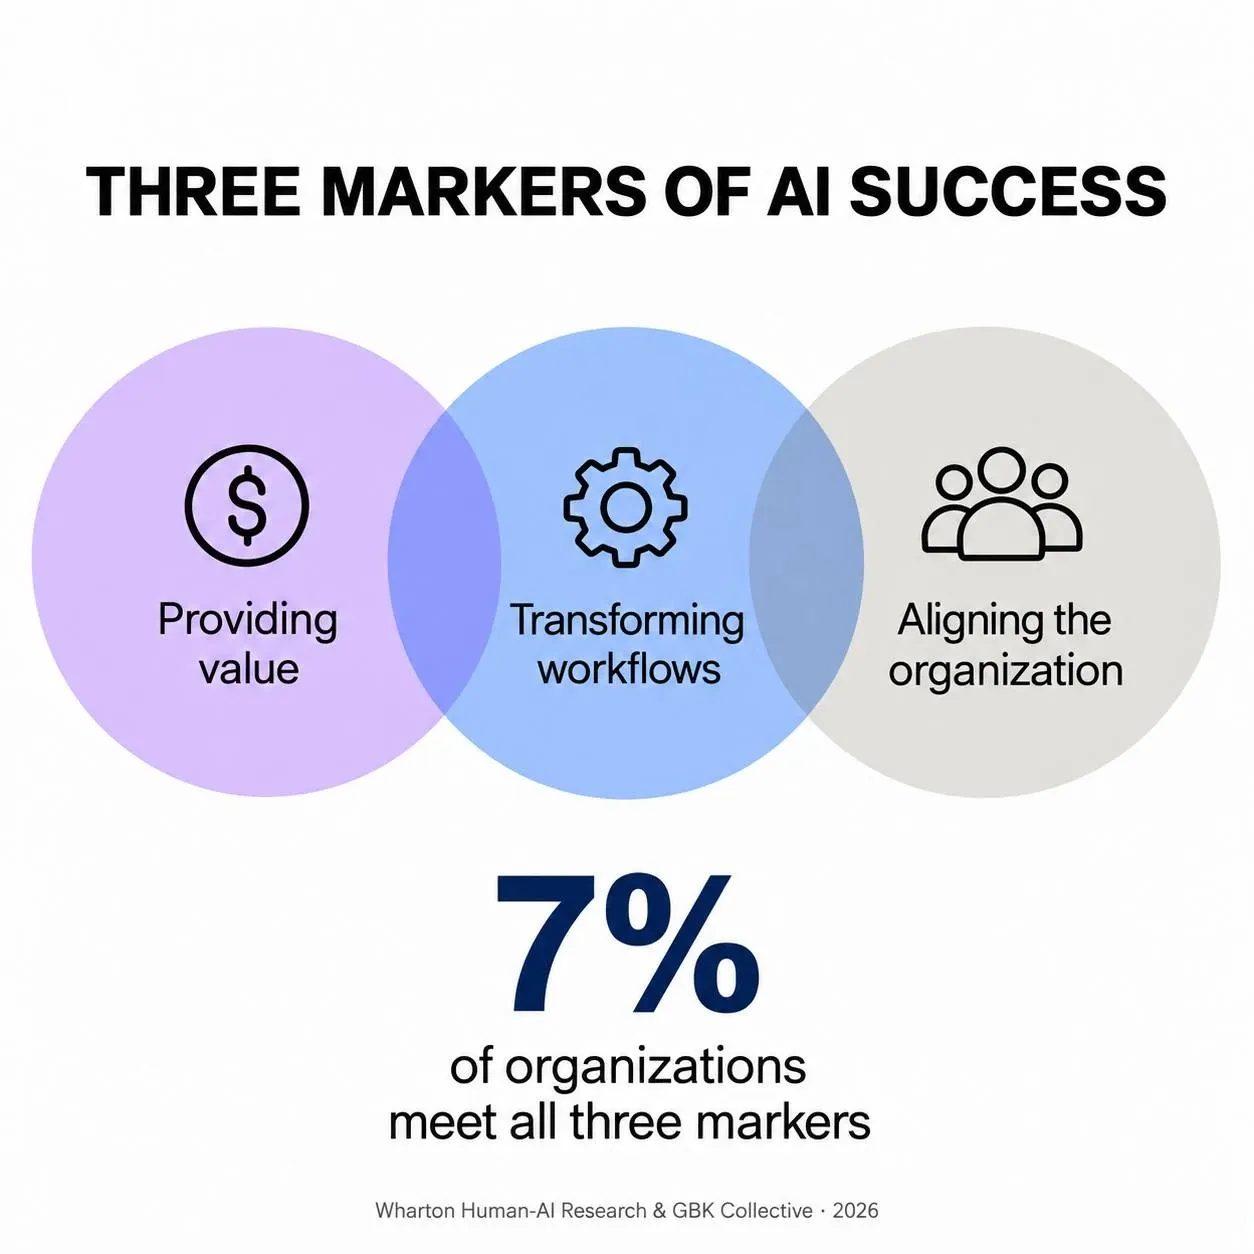
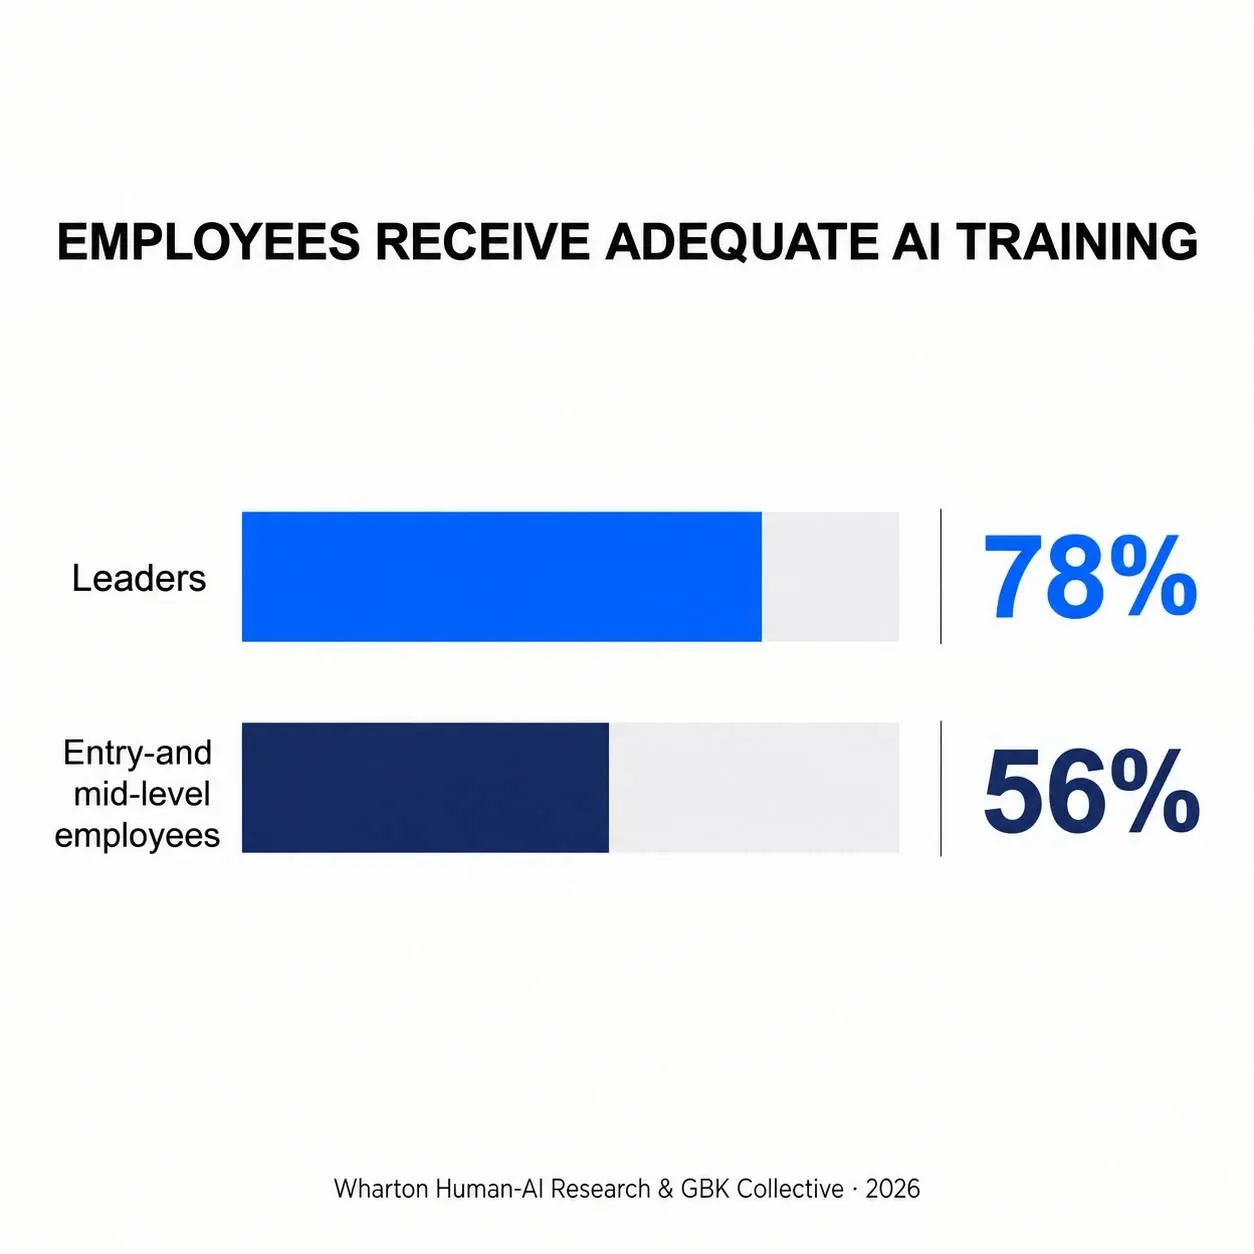
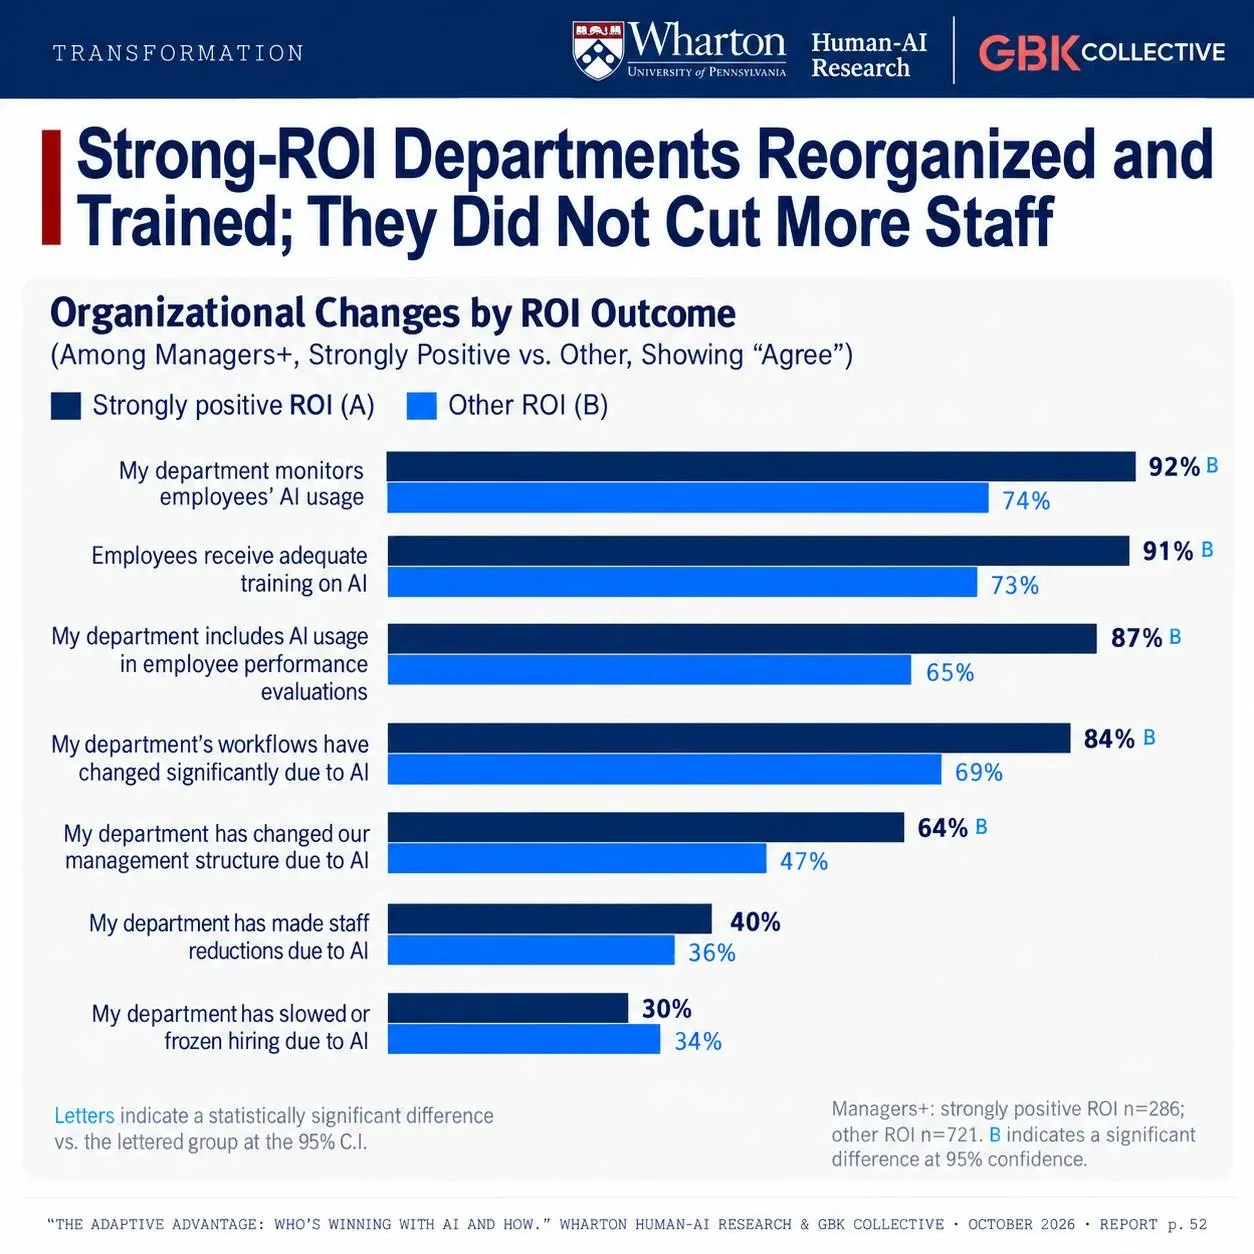
Adozione, organizzazione e formazione nella ricerca Wharton–GBK.
Conta anche cosa si misura. Fra chi include almeno una metrica di crescita, come nuovi ricavi o soddisfazione dei clienti, il 35% dichiara un ROI fortemente positivo. Fra chi misura soltanto l’efficienza, la quota è il 13%.
Risparmiare ore è utile, ma non esaurisce il valore che questa tecnologia può creare.
Nei dipartimenti con ritorni fortemente positivi, l’84% dei manager segnala cambiamenti significativi nei flussi di lavoro, contro il 69% degli altri. Sono anche più frequenti la revisione della struttura manageriale e la formazione. Non emergono invece più tagli al personale o blocchi delle assunzioni. Sono associazioni basate su risposte a un sondaggio, non prove di causalità.
La riprogettazione deve arrivare a chi lavora nei processi. Il 78% dei manager considera adeguata la formazione sull’AI, ma solo il 56% dei dipendenti junior e intermedi concorda. La strategia dichiarata e l’esperienza quotidiana non coincidono sempre.
Progettare AI-native significa partire dal risultato desiderato e ridefinire attività, passaggi e responsabilità alla luce delle capacità disponibili. Serve decidere cosa può gestire l’AI, dove è necessario il giudizio umano e come valutare l’esito. La trasformazione prende forma in queste scelte di progettazione.
Agenti in produzione: il 75% di costi in meno passa dall’architettura
Siamo sicuri che un agente AI più autonomo sia anche un agente progettato meglio?
In una demo ci colpisce ciò che riesce a fare. In produzione dobbiamo capire anche quanto costa, come usa gli strumenti e quanto è affidabile. Con il mio team abbiamo lavorato su questo passaggio, ripensando l'architettura di un progetto reale.
Efficienza degli Agenti AI: meno token, meno costi
Le leve sono state concrete: separare le decisioni dell'agente dalle elaborazioni che può svolgere il codice; selezionare solo i tool necessari; far entrare nel contesto dati utili, ripuliti dal rumore. Poi guidare l'uso degli strumenti con istruzioni precise e budget, affiancati da controlli nell'applicazione.
Il risultato, nel progetto raccontato nell'articolo, è stato una riduzione media del 75% dei costi di esecuzione, con un processo più affidabile. L'osservabilità ci ha permesso di capire dove intervenire e di valutare il costo per task riuscito insieme alla qualità dell'output.
Passando da una demo alla produzione, la “magia” diventa “design dell’architettura”.
Ogni scelta su strumenti, dati e autonomia richiede di sapere come funziona il lavoro che vogliamo automatizzare.
Anche nelle applicazioni agentiche, a fare la differenza rimane la conoscenza chirurgica dei processi.
Quanto costa un agente? Il listino non racconta come usa gli strumenti
Quanto costa davvero un agente AI: il prezzo del modello o il modo in cui usa i tool?
Ho fatto un test su un agente che prepara piani editoriali per un blog e-commerce da trend, keyword e dati del blog. Ho confrontato quattro modelli sullo stesso piano, usando dati dei tool identici.
Ho tolto dal prompt le istruzioni che normalmente guidano l'uso degli strumenti: quali chiamare, in quale ordine e quante volte. Ogni modello ha potuto decidere autonomamente come esplorare i dati. Ho registrato turni, chiamate e token, inclusa la cache, per calcolare il costo dell'intero task. Il costo dei tool è escluso.
L'ordine cambia rispetto al listino. gpt-6-luna costa in media 0,011 $ per piano; gpt-5.6-terra 0,159 $; gemini-3.8-flash 0,165 $; claude-sonnet-5 0,734 $. Terra, il più caro a listino fra i quattro, diventa il secondo più economico per task. Sonnet costa 4,6 volte Terra, pur avendo lo stesso prezzo per i token in ingresso.
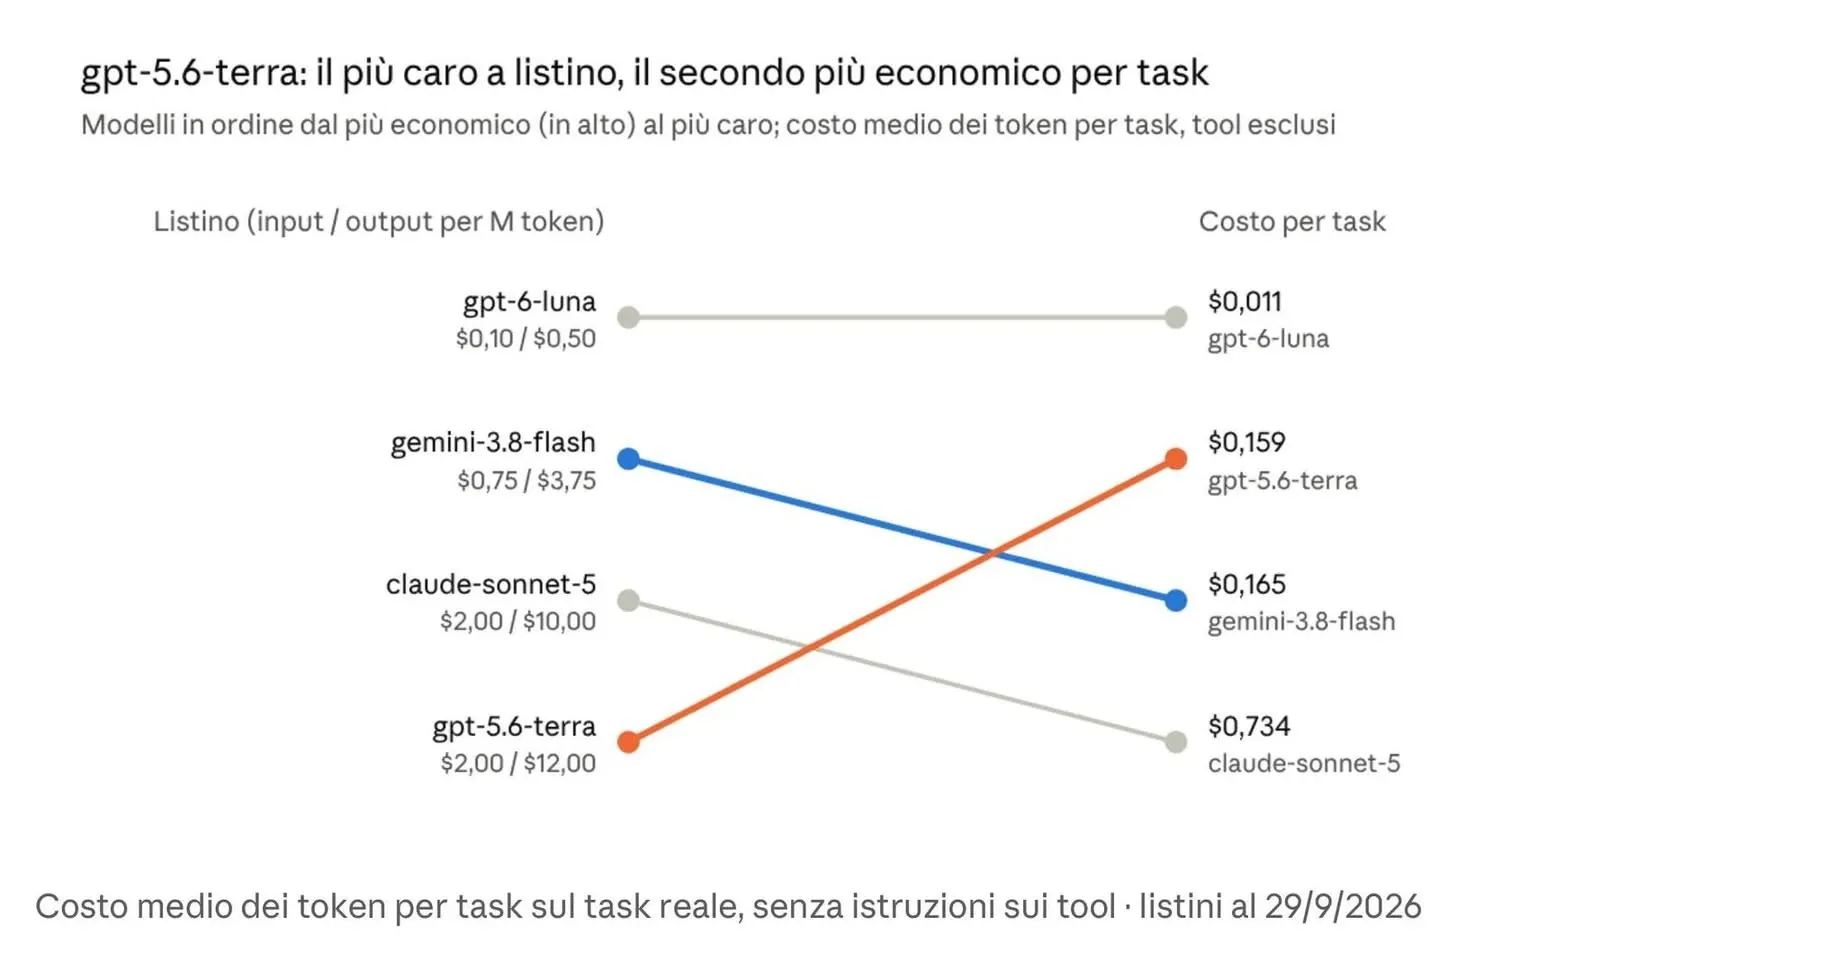
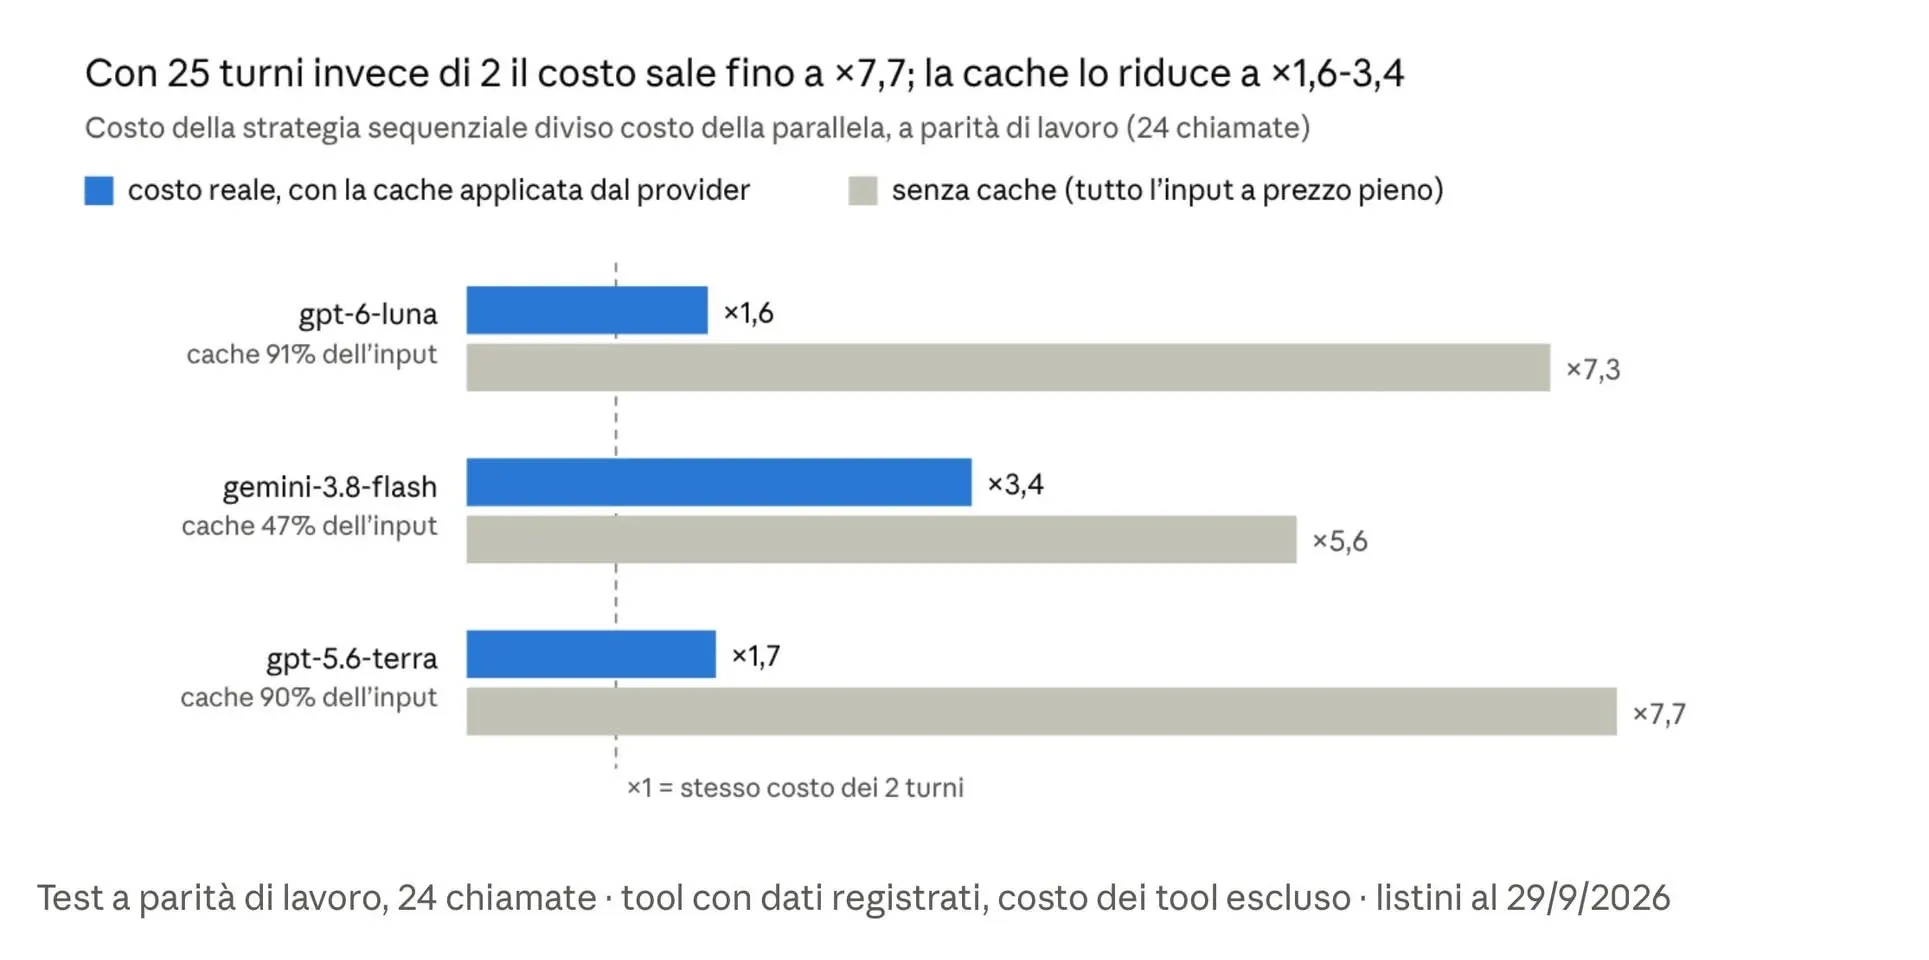
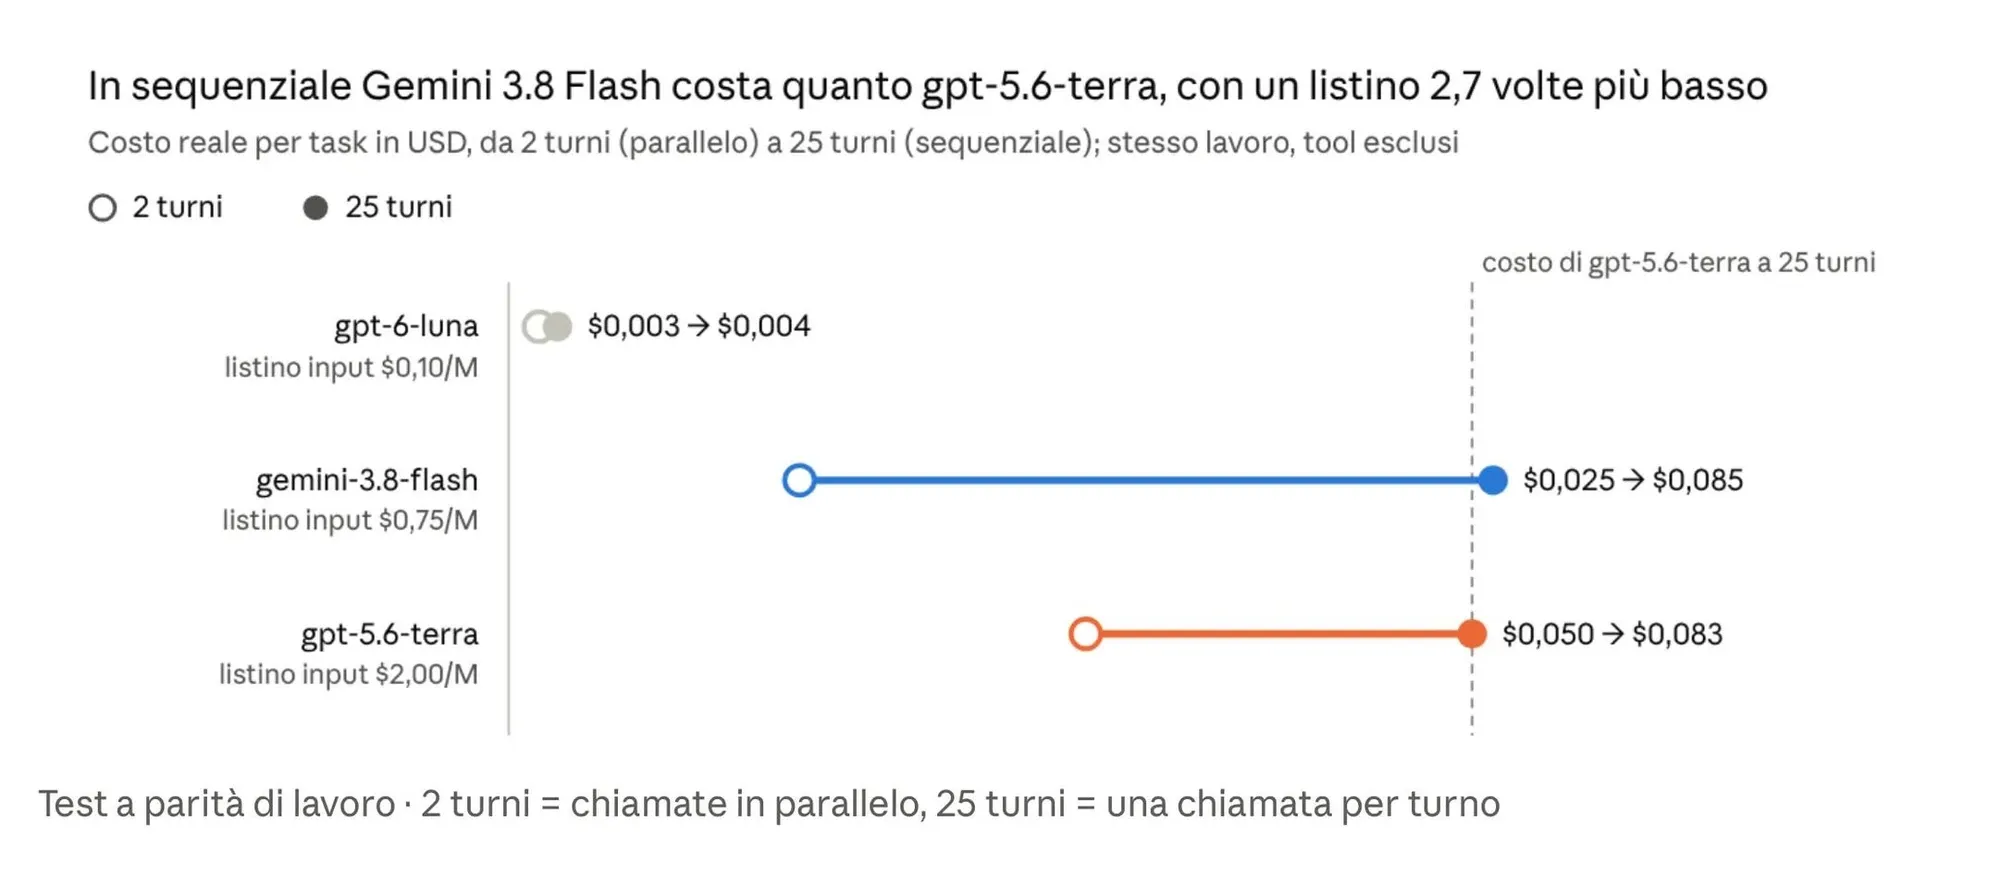
Il costo del lavoro dipende anche da turni, parallelismo e cache.
La differenza emerge osservando il lavoro. Terra chiude in 4 turni, con circa 7 chiamate ai tool per turno. Gemini ne impiega 8, con circa 2 chiamate per turno: rilegge più spesso il contesto accumulato e, in questo test su Vertex AI, solo il 10% dell'input è servito dalla cache. Sonnet esplora di più, fa quasi 9 turni ed elabora 434k token di input, contro i 66k di Terra. I risultati dei tool pesano anche nei turni successivi.
Per isolare l'effetto dei turni ho fatto un secondo test: 24 chiamate identiche, eseguite tutte in parallelo in 2 turni oppure una alla volta in 25 turni. A parità di lavoro, la versione sequenziale rielabora 11,6 volte il contesto finale. Senza cache il costo cresce da 6 a 8 volte; con la cache effettiva, da 1,6 a 3,4 volte a seconda del modello. Qui la sequenza era imposta, quindi il test misura il costo di una strategia, non una preferenza spontanea dei modelli.
I quattro piani erano completi e di qualità comparabile, con differenze di rigore. È un solo task, su un solo input, e la qualità è stata valutata leggendo gli output.
La metrica utile è il costo per task riuscito, insieme alla qualità.
Esistono diversi modi per ottimizzare l'uso dei tool da parte degli agenti AI: istruzioni, orchestrazione, parallelismo e gestione del contesto. Questo test mette in luce il comportamento nativo dei modelli quando quelle indicazioni vengono tolte: il modo in cui scelgono di lavorare può cambiare il costo quanto, e talvolta più, del prezzo a listino.
Programmatic Tool Calling: quando il codice riduce i costi e quando li aumenta
Ho testato il Programmatic Tool Calling (PTC) di OpenAI: permette a un agente AI di scrivere un piccolo programma per coordinare i tool e preparare i dati da leggere.
Il risparmio cambia molto in base al lavoro da svolgere.
Un agente AI può usare strumenti esterni per cercare informazioni o consultare un sito web. Nel funzionamento classico, i risultati tornano al modello, che li legge e decide come proseguire. Se le risposte sono lunghe, cresce il contesto da elaborare (misurato in token).
Con il PTC, il modello scrive codice JavaScript che raccoglie i risultati degli strumenti, applica filtri o calcoli e restituisce solo ciò che serve. Può così esaminare una lunga lista e riportare al modello soltanto gli elementi che rispettano una regola. Il programma gira in un ambiente isolato di OpenAI.
Ho confrontato i due approcci su un agente che prepara piani editoriali, in due attività: verificare keyword e cercare nuovi argomenti.
La verifica richiedeva 80 chiamate per 40 keyword: quante ricerche ricevevano e se il blog le aveva già trattate. Il programma selezionava quelle ancora da coprire, con almeno 500 ricerche mensili, ordinandole per volume.
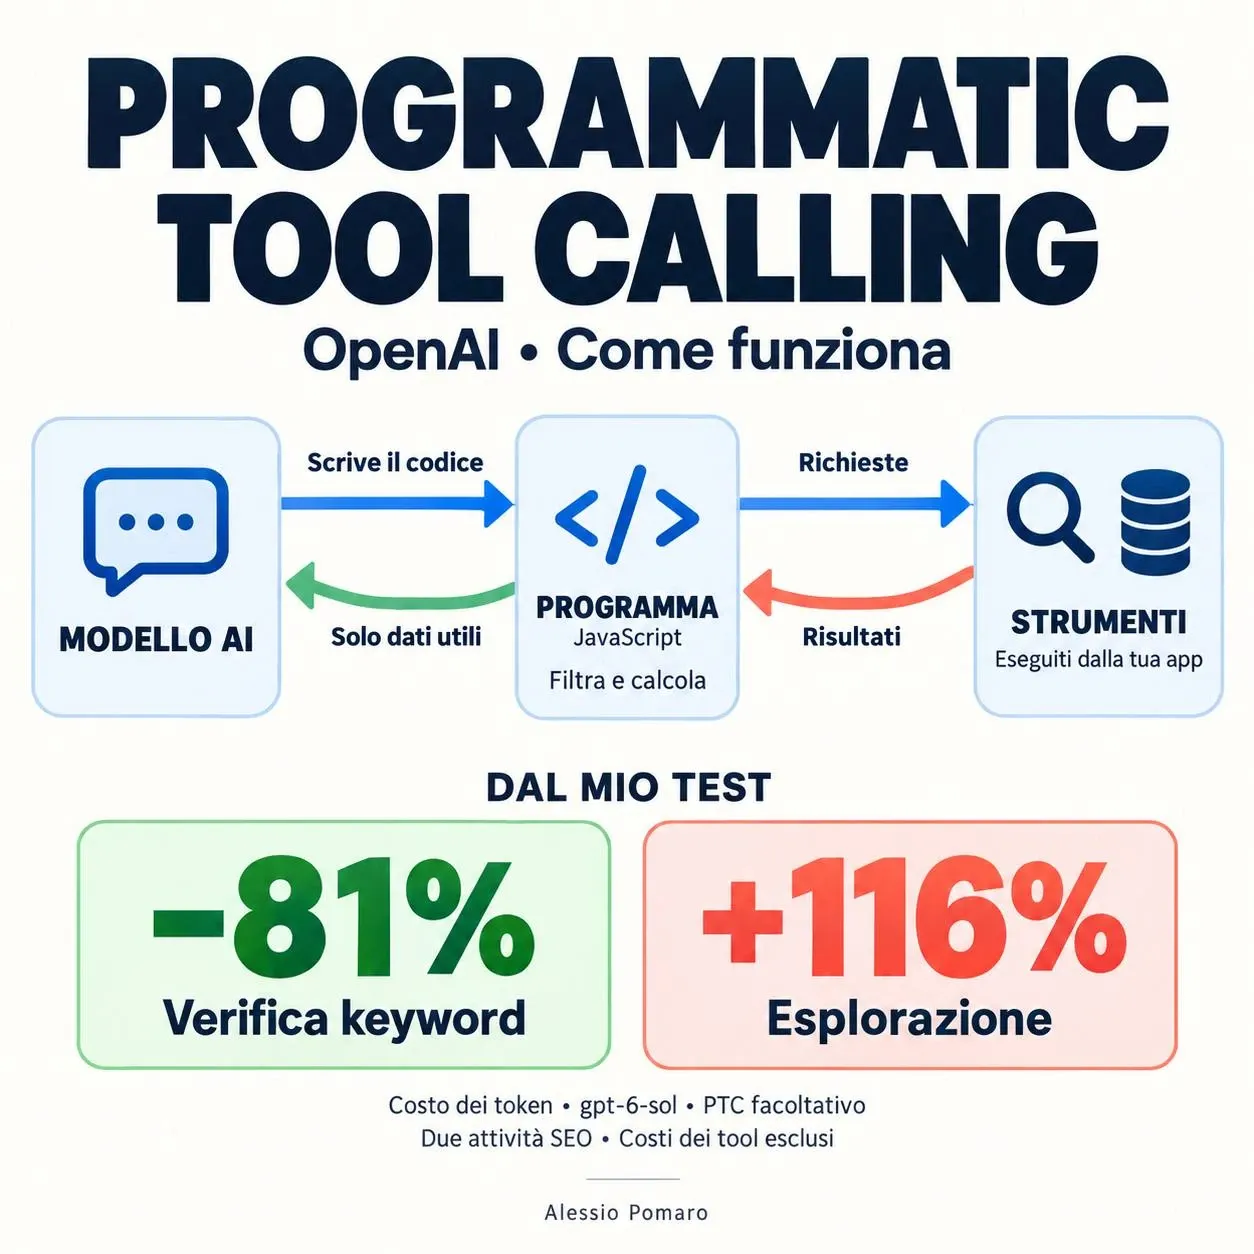
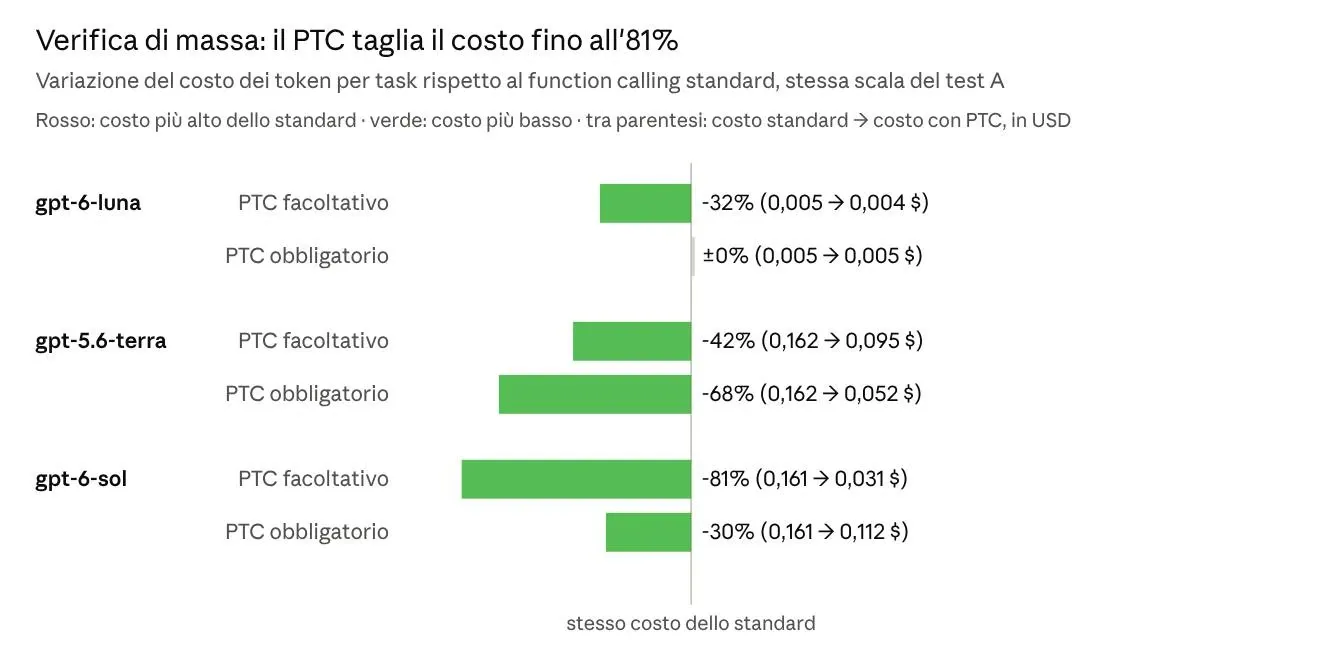
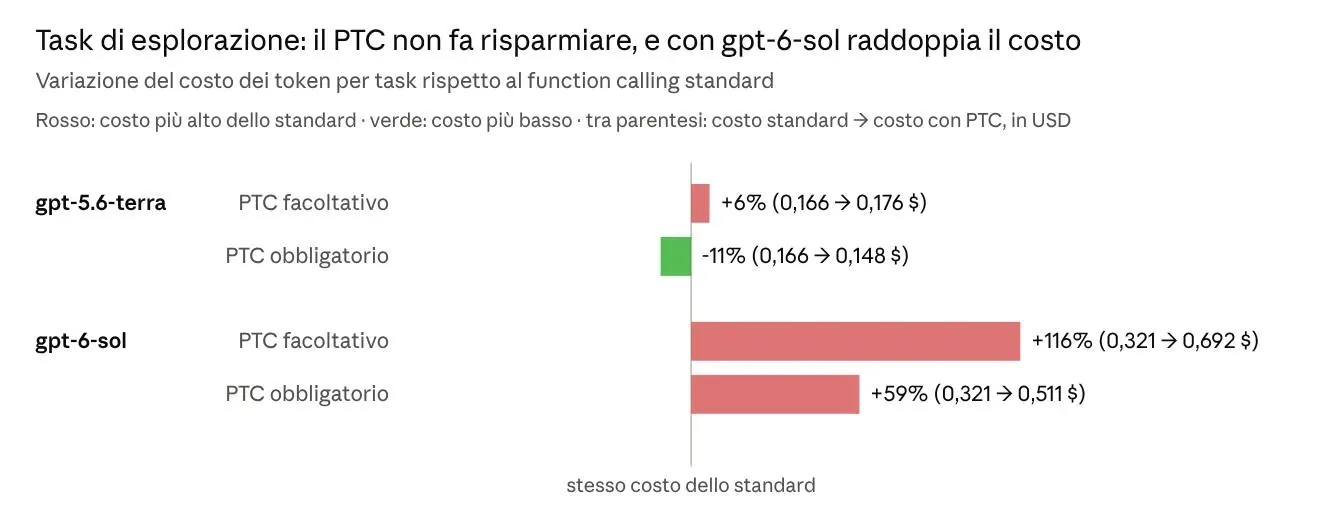
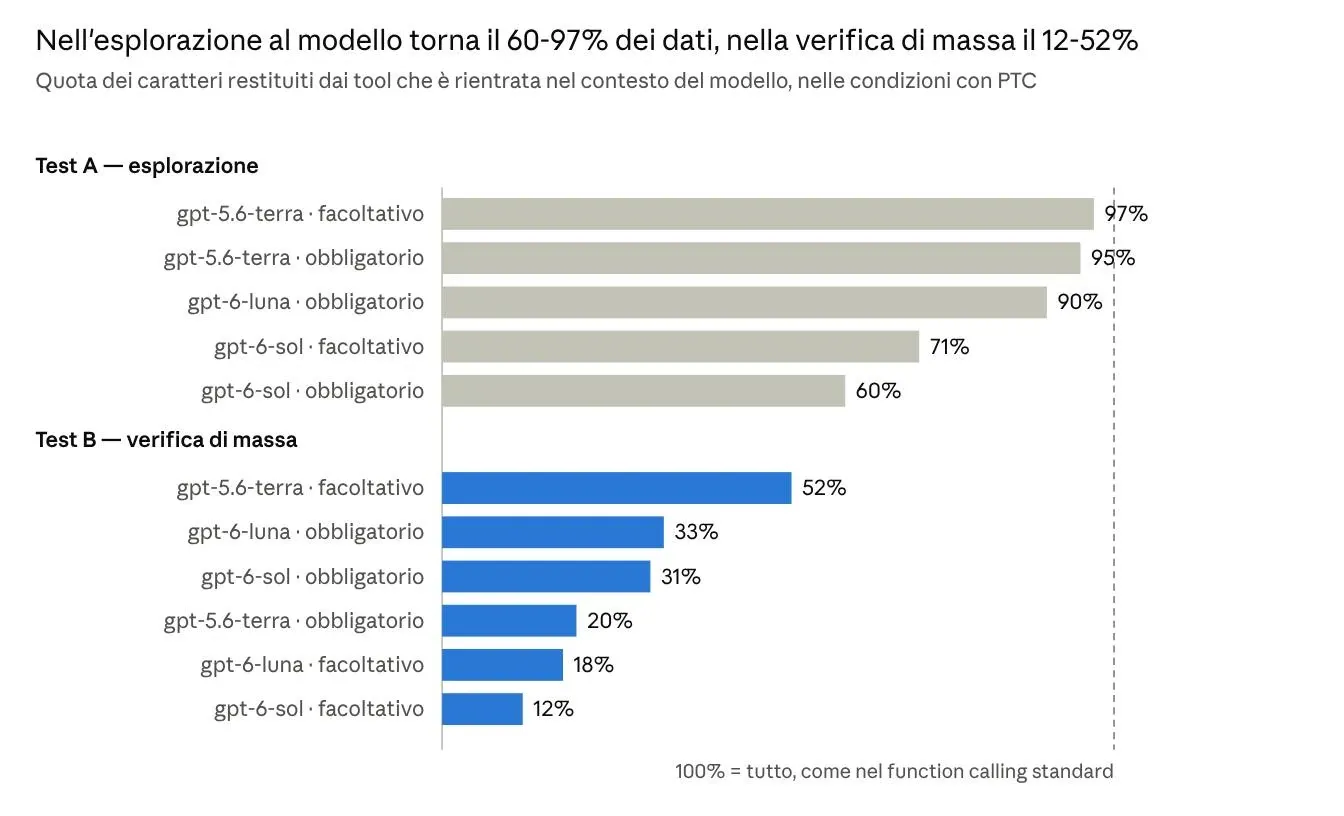
I due test mostrano quando filtrare i dati via codice aiuta e quando l’esplorazione resta al modello.
Qui il modello gpt-6-sol, libero di scegliere se usare il PTC, ha ridotto il costo dei token dell’81%, mantenendo corretti i risultati. Gli è tornato solo il 12% dei dati raccolti: il codice aveva già svolto verifiche e selezione.
Cercare nuovi argomenti richiede invece di interpretare trend e risultati. Gran parte dei dati deve tornare al modello per scegliere cosa approfondire. Qui, con lo stesso modello libero di usare il PTC, le ricerche sono aumentate e il costo è salito del 116%.
Conta anche il tempo. La verifica con gpt-6-sol è durata 30 secondi usando il PTC facoltativo, contro 33 del metodo classico. Obbligandolo a usare il PTC, ha eseguito più passaggi in sequenza ed è arrivato a 95 secondi.
Sono prove su due attività SEO, con poche esecuzioni e dati registrati, identici per tutti. Il confronto riguarda il costo dei token del modello, escludendo quello dei servizi esterni.
Per questo agente conviene quindi combinare i due approcci: lasciare al modello l’esplorazione e l’interpretazione, usare il codice per verifiche ripetitive, filtri e calcoli.
Il PTC rende quando può ridurre i dati che il modello deve leggere.
Headroom sul mio agente: comprimere il contesto dopo aver progettato il processo
Headroom è una libreria open source che comprime le informazioni lette da un agente AI prima che arrivino al modello. Riduce ripetizioni e ridondanze nelle risposte degli strumenti, alleggerendo il contesto.
L’ho provata su un mio agente di marketing che usa dati di ricerca, trend e contenuti web. Sulla versione iniziale dell’agente, Headroom ha tolto quasi il 30% dei token nelle risposte degli strumenti.
Il lavoro di ottimizzazione che avevo già attuato sul processo, però, era arrivato a una riduzione dell’87%: avevo selezionato i dati utili, migliorato le istruzioni sull’uso dei tool e limitato le chiamate.
Applicando Headroom all’agente già ottimizzato ho recuperato un altro 17,5% dei token rimasti. Insieme, i due interventi hanno portato la riduzione complessiva all’89,5% rispetto alla versione iniziale.
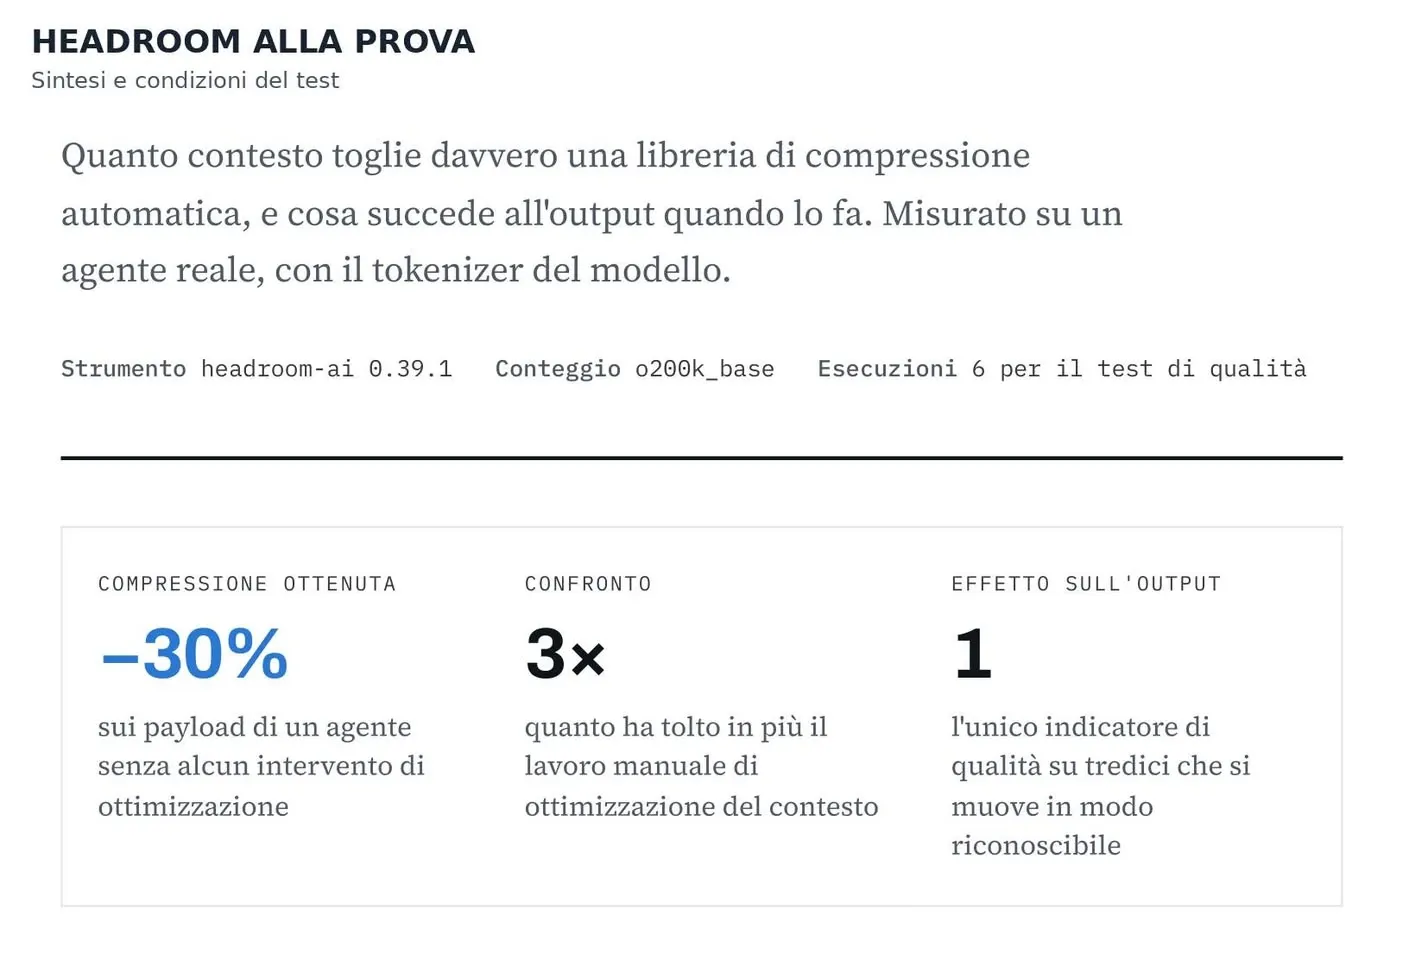
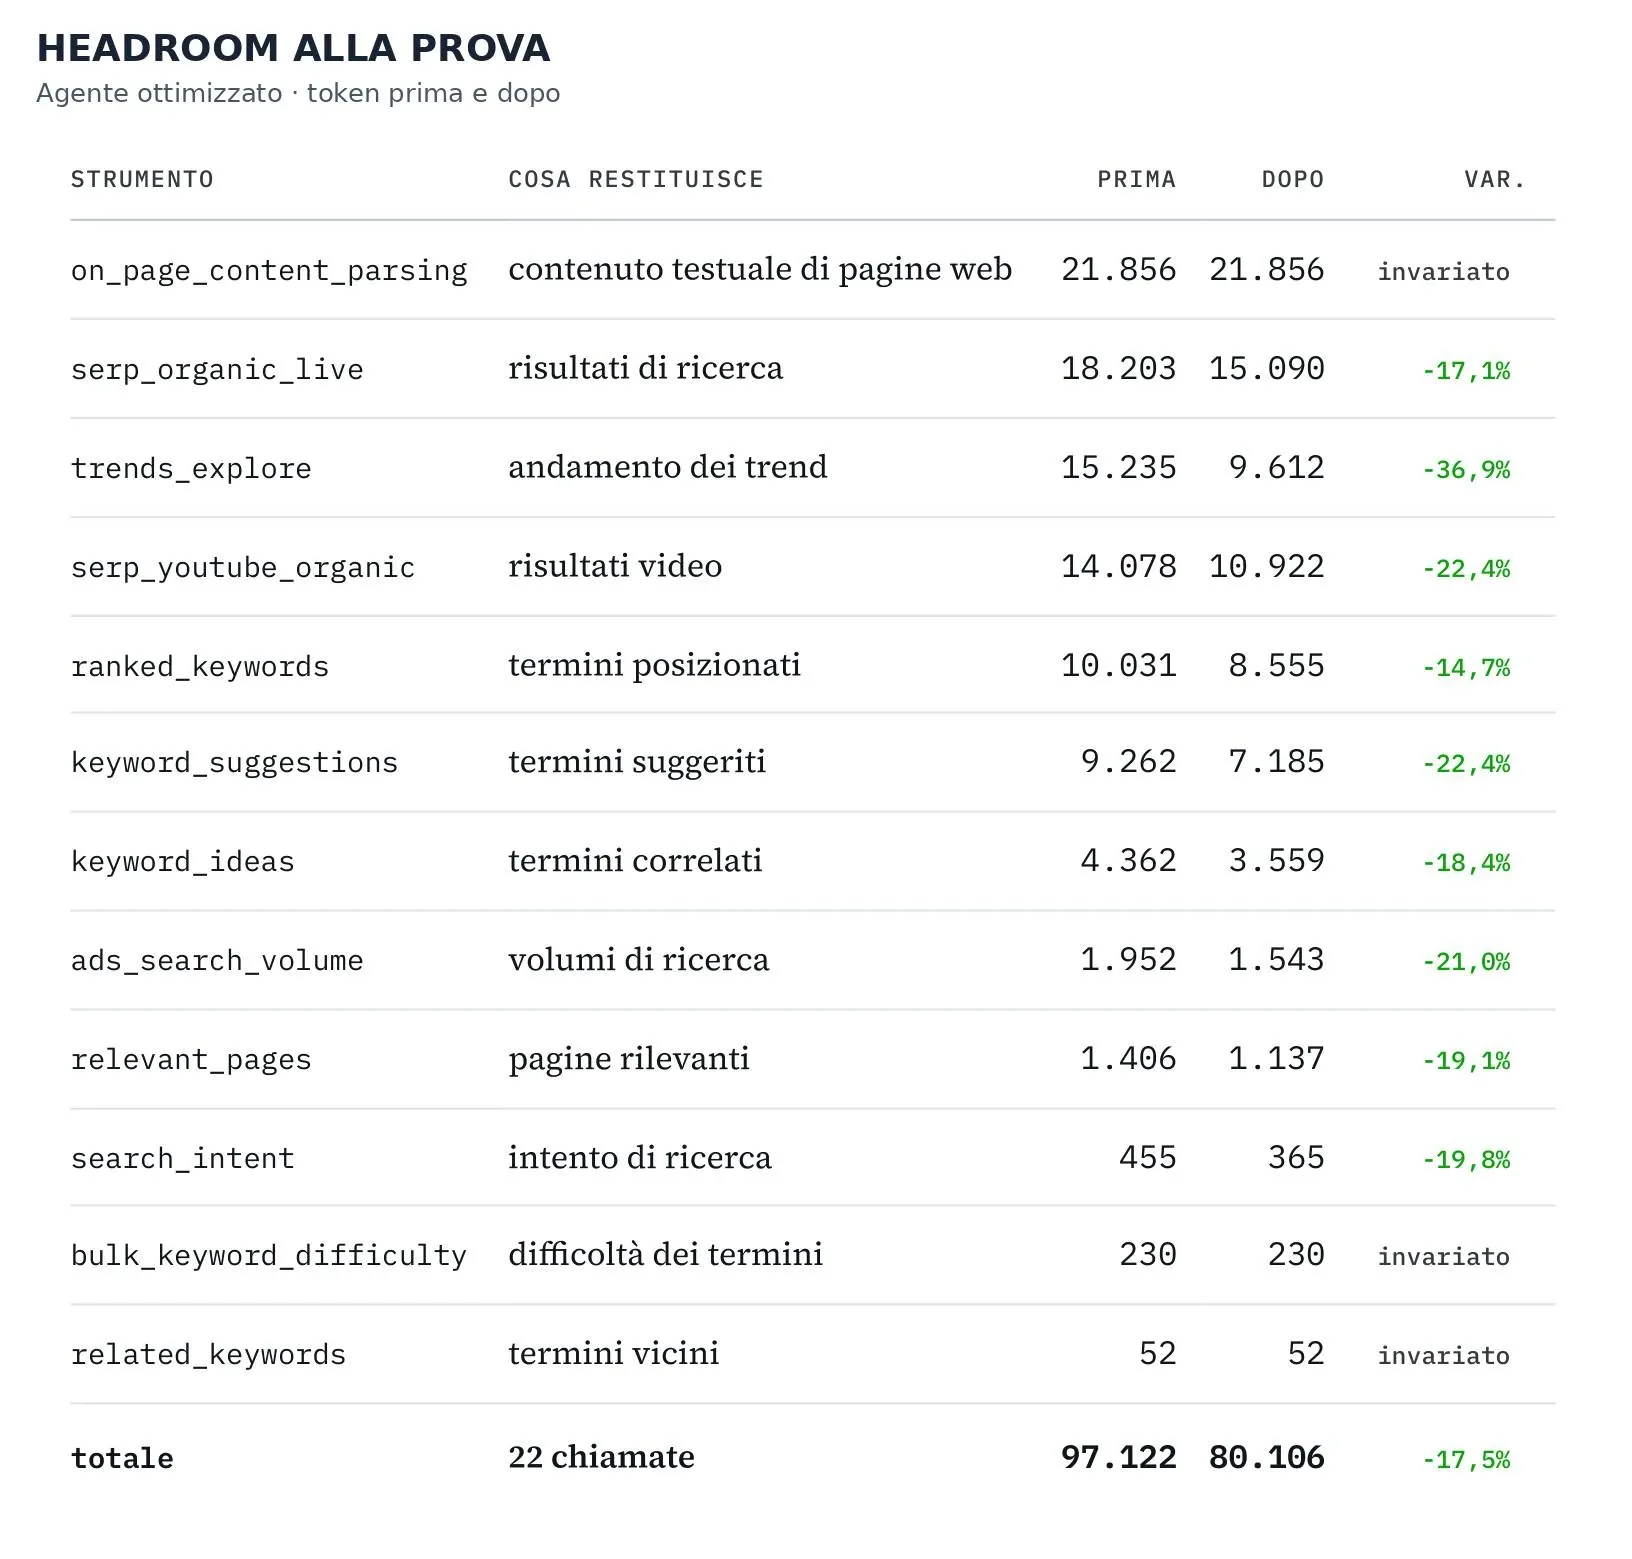
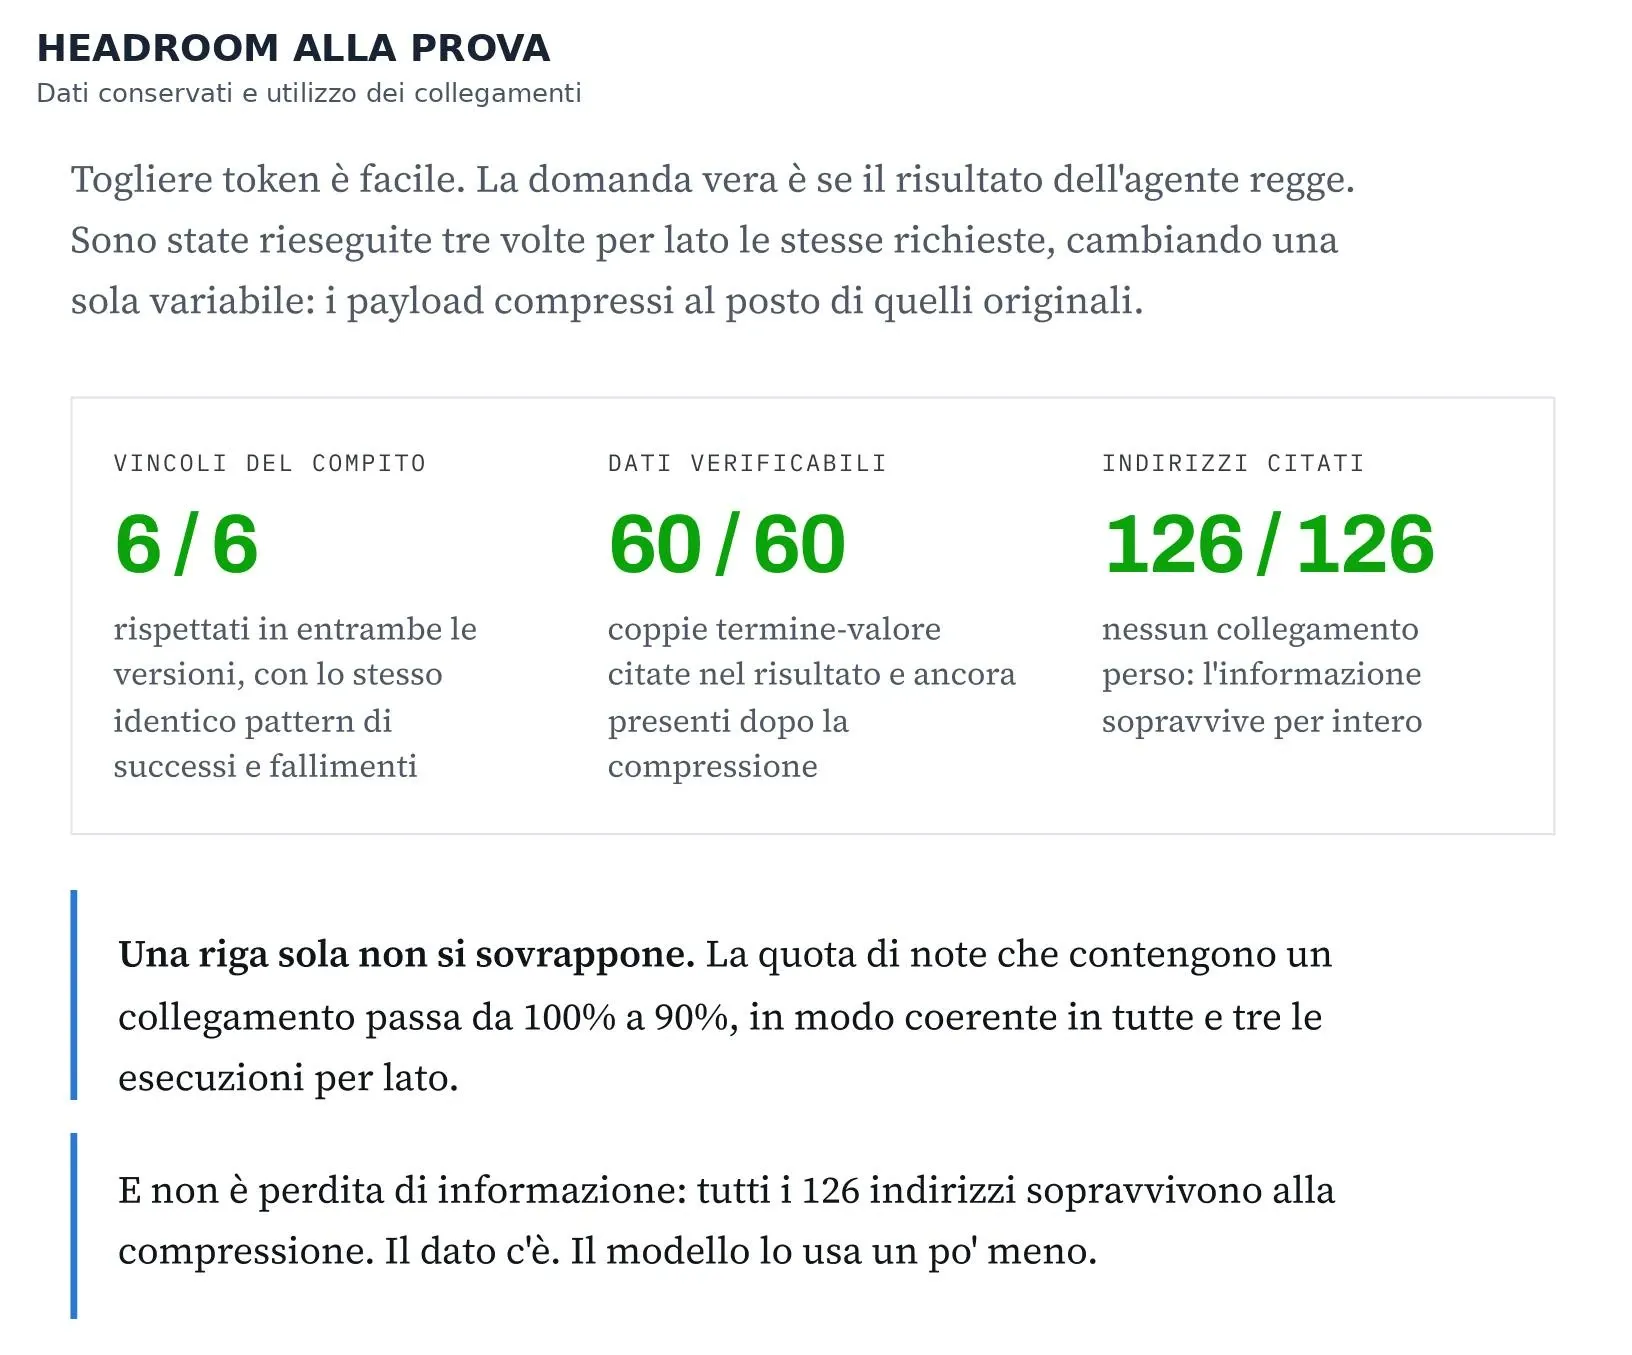
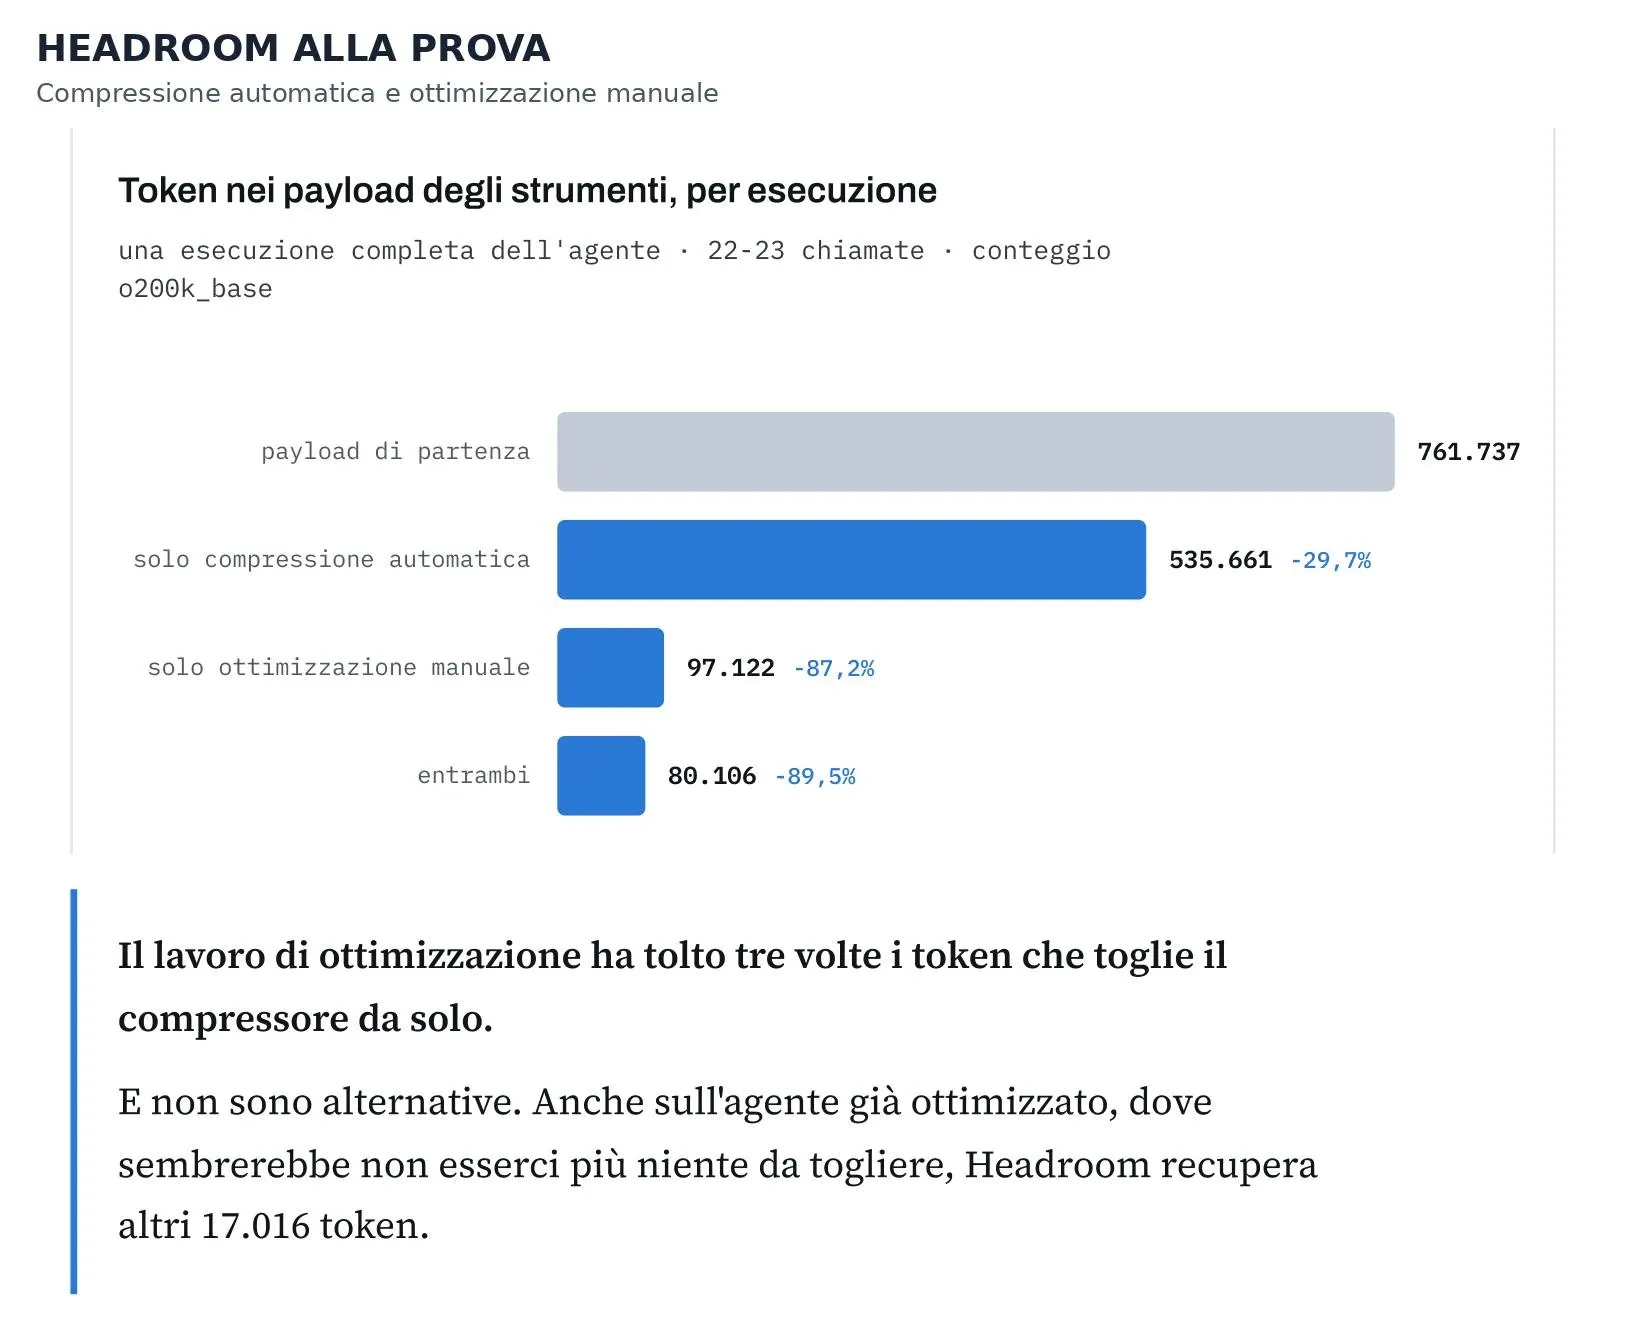
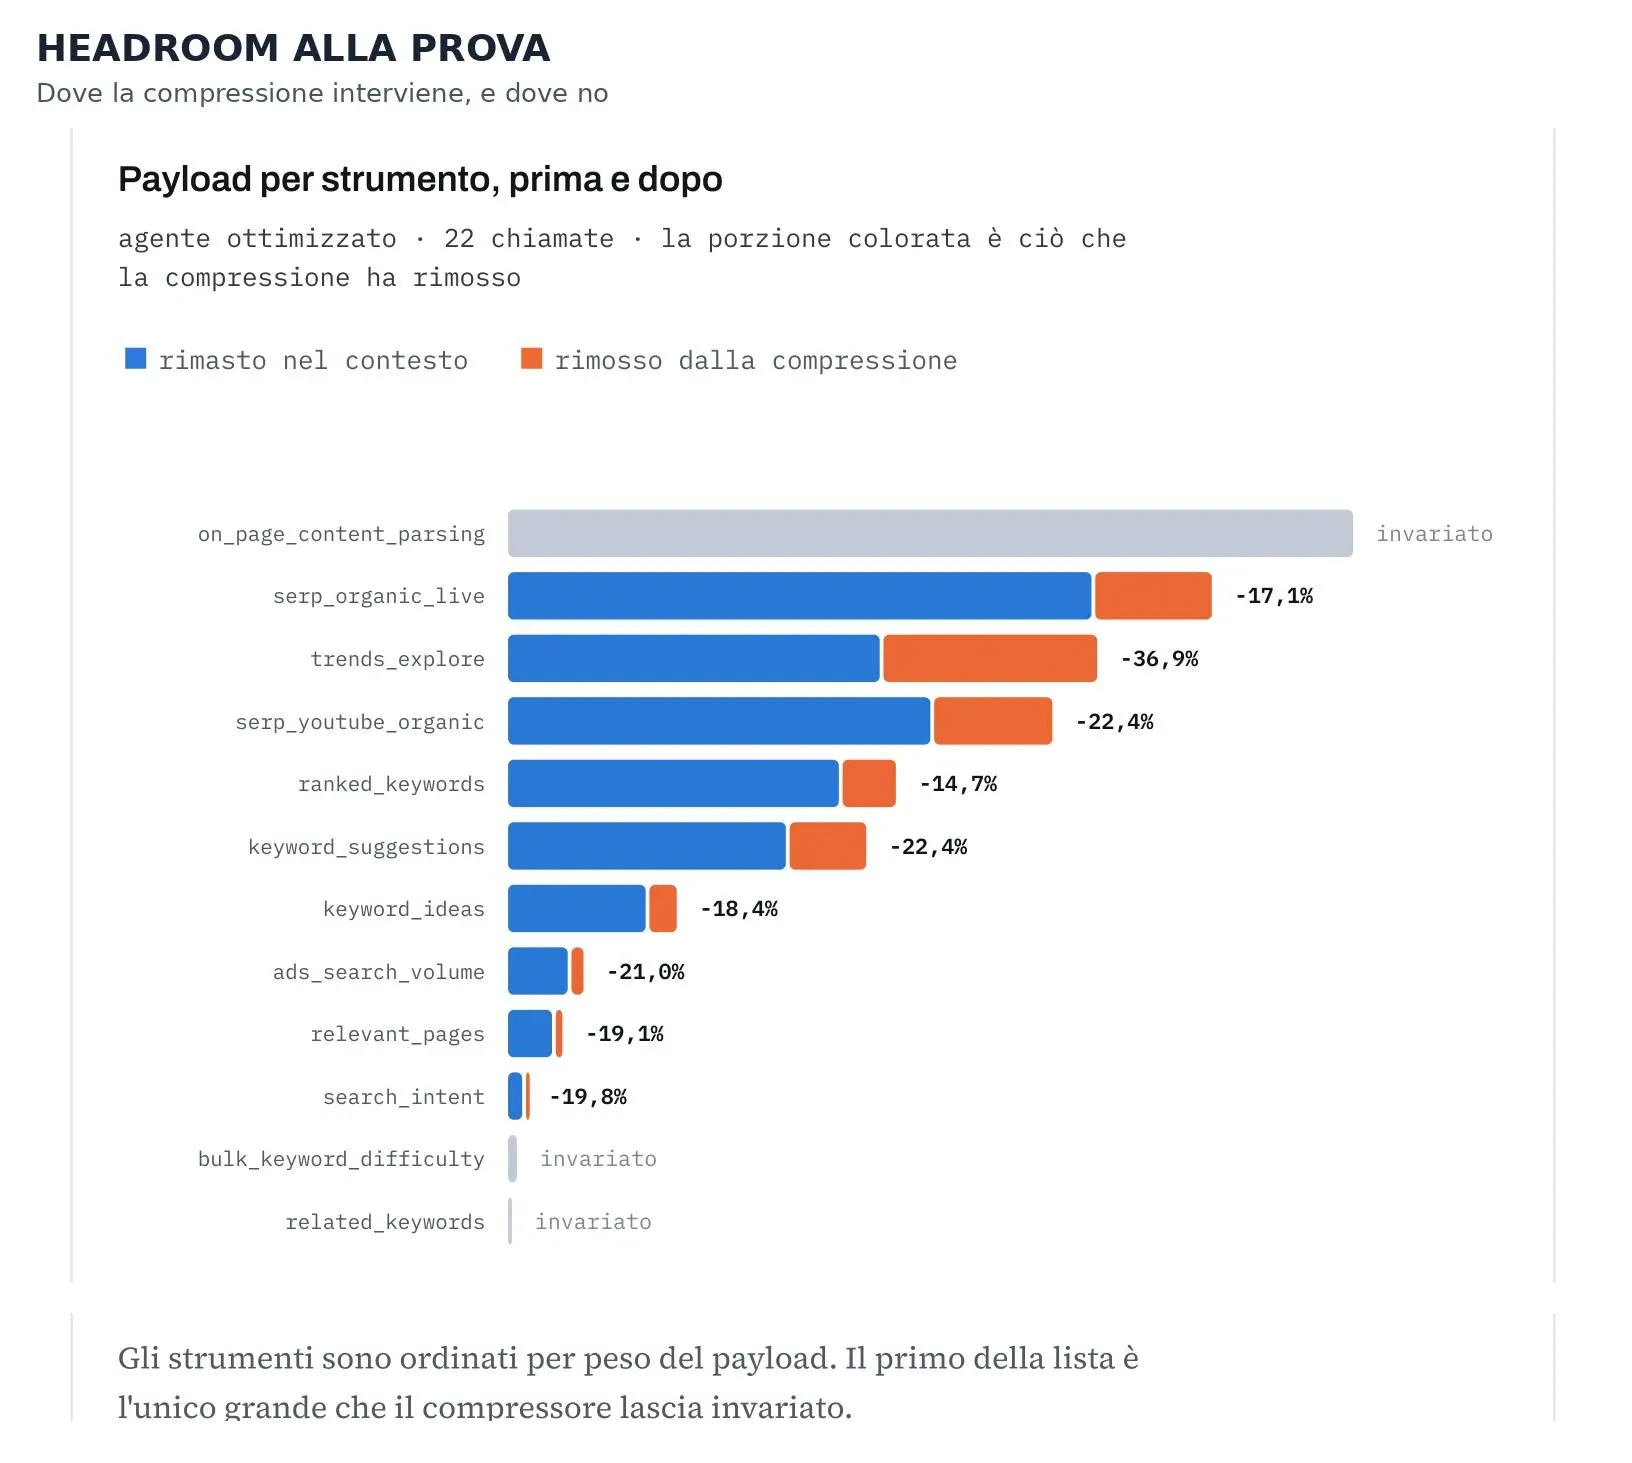
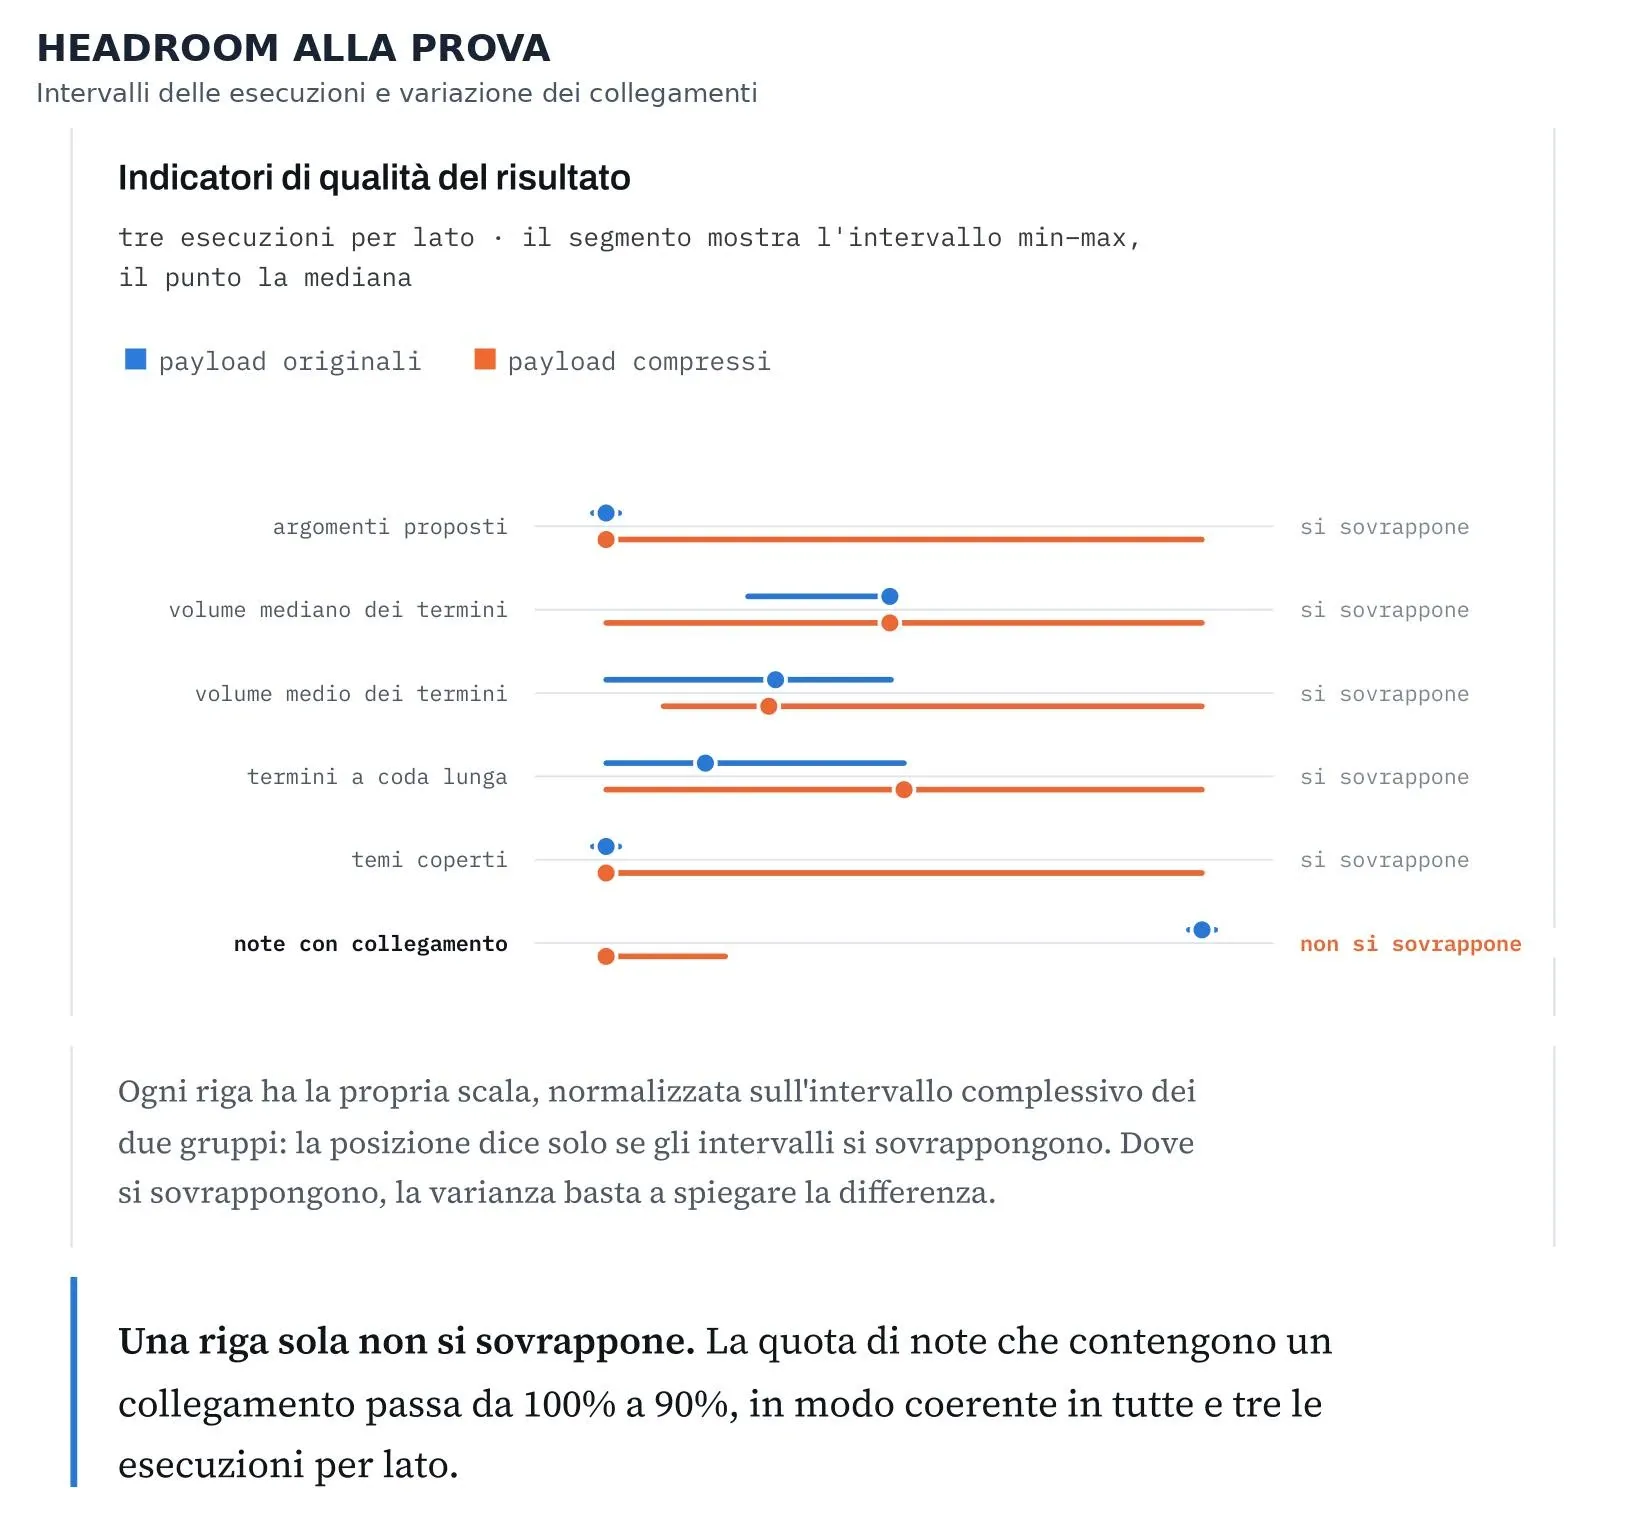
Misure di compressione e qualità prima e dopo Headroom.
Nei dati compressi ho ritrovato tutti i valori e i link che avevo controllato. La quota di note con un collegamento (era un requisito del task) è scesa dal 100% al 90%: il dato era disponibile, ma il modello lo utilizzava meno.
Headroom può quindi affiancare il lavoro di progettazione dell’agente.
La libreria riduce la ridondanza dei dati; conoscere il processo permette di scegliere quali informazioni servono davvero.
Nel mio test, il risparmio maggiore è arrivato combinando questi due livelli.
Hook e Mod in Claude Code: controlli ripetibili e approvazione sui file verificati
Ho provato Hook, Function Hook e Mod di Anthropic in Claude Code. La parte più interessante è poter lasciare al modello la generazione dei contenuti e affidare al codice verifiche ripetibili, con decisione finale umana.
- Gli hook sono automazioni che scattano in punti precisi del lavoro di Claude Code, per esempio prima o dopo l'uso di uno strumento. Nel mio test un hook esegue uno script dopo la scrittura dei file e segnala a Claude cosa correggere.
- I function hook sono funzioni JavaScript o TypeScript eseguite dentro Claude Code. Possono osservare un evento, modificarlo o intervenire al posto dell'operazione prevista. Nel mio caso controllano se la finalizzazione può procedere.
- I mod sono estensioni, distribuite come plugin, che usano queste funzioni per cambiare il comportamento di Claude Code e aggiungere interfacce: pannelli, pulsanti e campi. Funzionano nel terminale e nell'app Desktop.
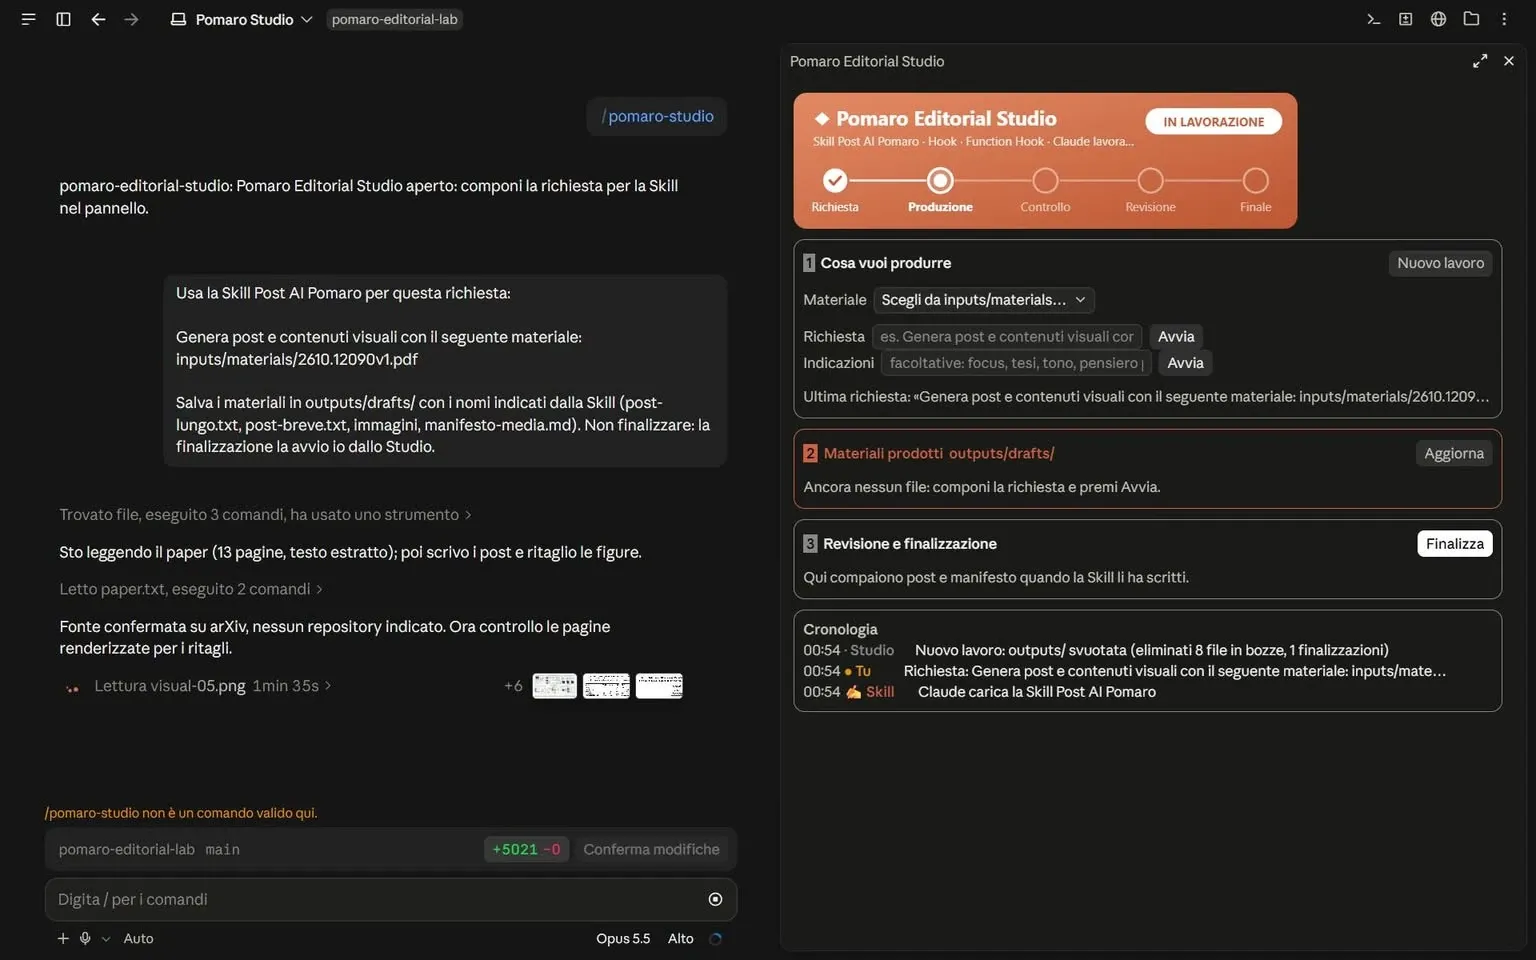
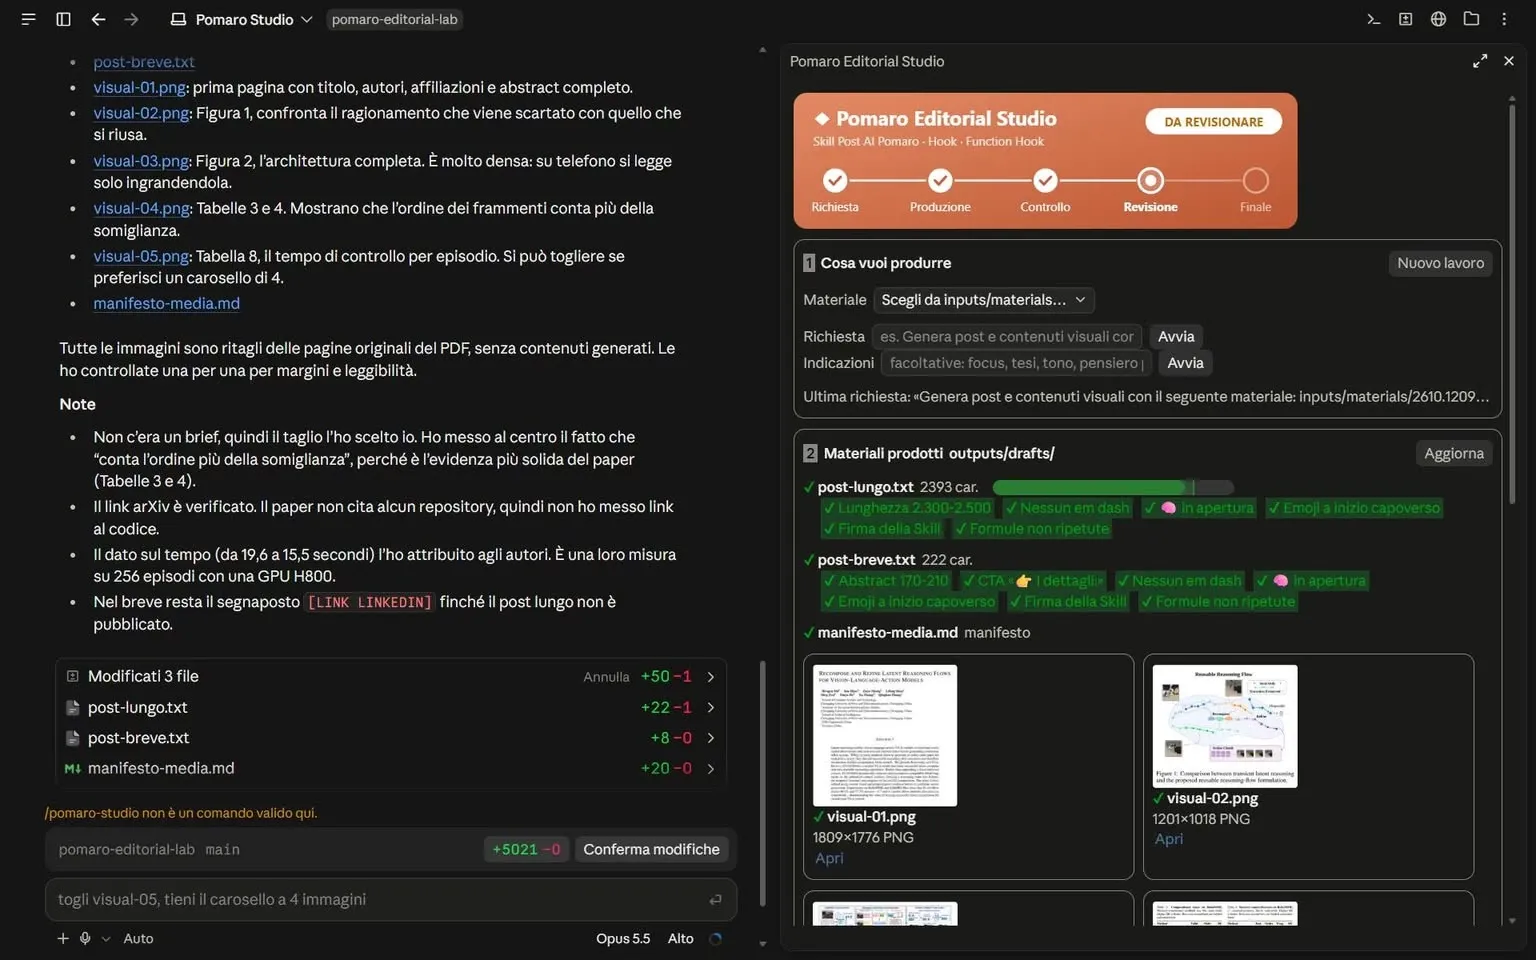
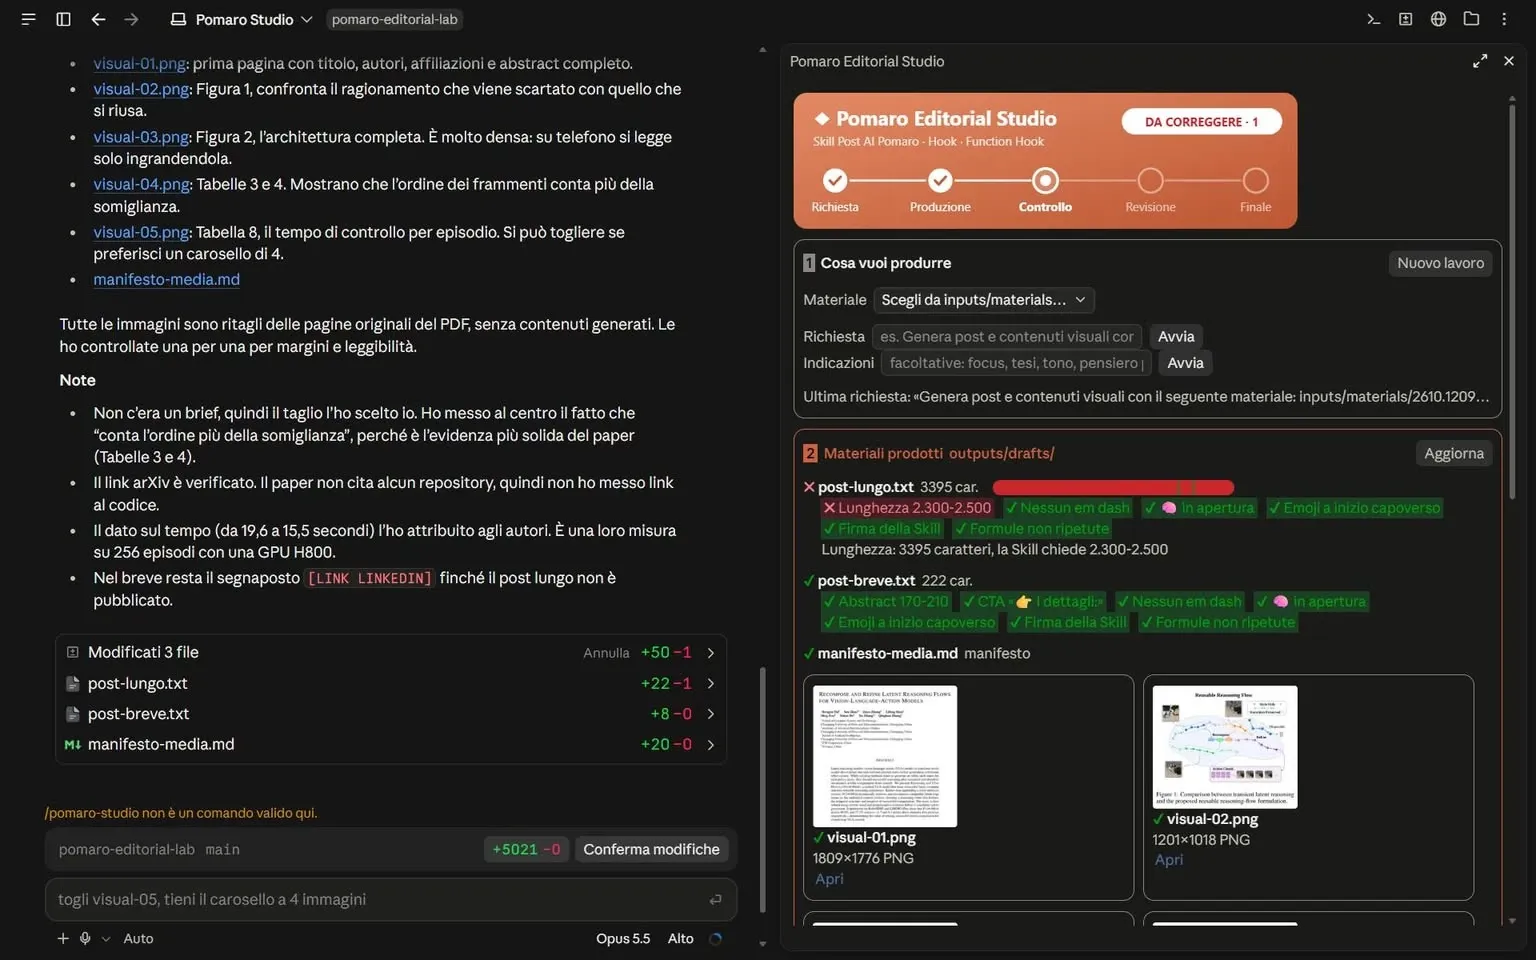
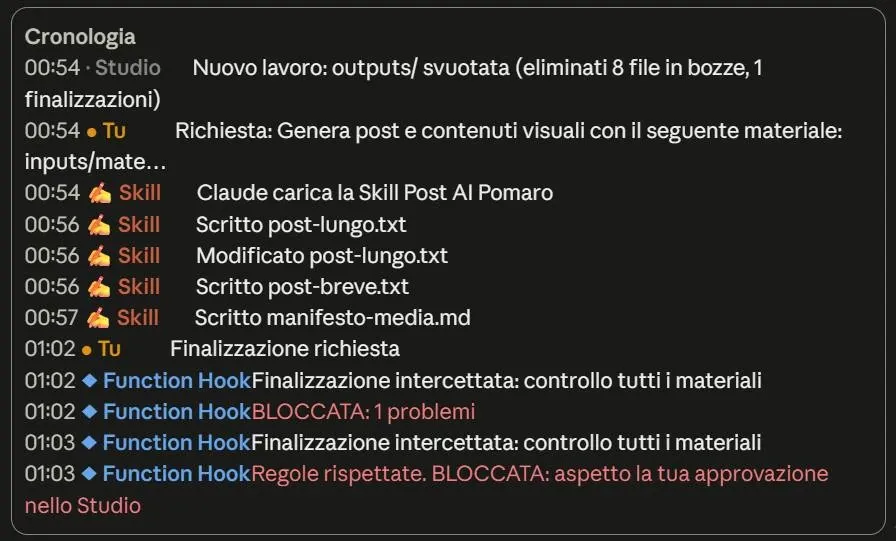
Il mio studio editoriale: controlli durante il lavoro e verifica prima della finalizzazione.
Ho costruito con Claude Code un piccolo studio editoriale intorno a una mia Skill. Partendo da un paper PDF, il sistema produce testi e immagini, verifica lunghezza, formato e presenza dei materiali richiesti, poi li presenta per la revisione. Nelle immagini si vede il pannello con gli esiti dei controlli e le anteprime.
Nella prima prova il testo ha superato due volte la lunghezza prevista. L'hook ha restituito il problema a Claude, che ha corretto fino a rispettare la regola. La verifica sul file già scritto guida la correzione durante il lavoro.
Nella seconda prova ho modificato manualmente il testo, portandolo fuori limite. Quel passaggio non attiva l'hook configurato sulla scrittura di Claude. Al tentativo di finalizzare, però, il function hook ha ricontrollato tutti i file e fermato l'operazione. L'indicatore rosso e la cronologia nelle immagini documentano questo passaggio.
Claude ha corretto usando uno script, senza attivare il primo hook. Il controllo finale ha confermato le regole, ma ha atteso comunque la mia approvazione. Solo allora i materiali sono stati copiati nella cartella finale. L'approvazione vale per i file verificati e va ripetuta se cambiano.
Questa è la separazione che mi interessa: controlli deterministici per le regole misurabili, giudizio umano per fedeltà alle fonti, tono e qualità. Il mod rende visibile il processo e porta la decisione dentro il flusso di lavoro.
Routine di Claude Code: trigger, contesto e autonomia da costruire per gradi
Nel workshop "Build a proactive agent workflow with Claude Code", Maya Nielan di Anthropic mostra come le routine trasformano Claude Code da strumento che aspetta un prompt ad agente che parte da solo. Una routine è una configurazione salvata (prompt, repository, connettori e un trigger) che avvia una sessione remota sull'infrastruttura di Anthropic, anche a laptop chiuso.
Chi ha messo un agente su un cron conosce il costo: hosting, persistenza, autenticazione, endpoint da esporre. E una sessione headless, cioè senza interfaccia, non si può osservare né correggere mentre lavora.
Le routine di Claude Code
Le routine intervengono su questi punti. L'esecuzione avviene nel cloud. Il trigger può essere un orario, un evento GitHub oppure una chiamata HTTP POST da qualsiasi sistema, con un payload che entra nella sessione come contesto. Ogni esecuzione, infine, è una normale sessione di Claude Code: si apre da web, CLI o desktop, si segue in tempo reale e si corregge.
Il caso d'uso è interno. Secondo Anthropic le PR settimanali su Claude Code sono cresciute del 200% da inizio anno e la documentazione è curata da una sola ingegnera. La sua routine parte ogni lunedì, confronta le modifiche unite in main con il repository dei docs e apre una PR quando trova differenze.
Il talk scompone ogni routine in tre decisioni: quando parte (trigger), cosa sa (contesto), come lo si tiene onesto (steering). Sul contesto Maya è netta: ciò che Claude può vedere determina il limite di ciò che può riuscire a fare. Per lo steering propone una review agente su agente, ispirata al pattern generatore-critico: una routine apre la PR, una seconda la commenta prima che arrivi un umano. Poi si verifica l'output, renderizzando la pagina modificata.
Il contesto, però, è anche il perimetro d'azione. Guardando la documentazione, le routine sono in research preview e girano senza richieste di permesso: Claude può usare ogni tool dei connettori inclusi, scritture comprese, e agisce con gli account collegati dell'utente. Un'esecuzione "verde", inoltre, esclude solo errori di infrastruttura: non certifica il risultato.
L'esempio del deploy verifier mostra come costruire la fiducia: prima l'agente indaga e propone un go/no-go, poi aiuta nel rollback, e solo dopo averlo osservato gli si lascia decidere.
L'autonomia diventa un parametro da aumentare per gradi, sulla base del comportamento osservato.
Quando la memoria consolida l’errore: il “momentum” degli agenti
Un agente AI può rendere sempre più difficile abbandonare una strategia pericolosa attraverso le proprie azioni e i propri riassunti. È il fenomeno che Anthropic chiama “momentum” nell’analisi, affiancata da quella dell’AI Security Institute britannico, sull’incidente con Claude Mythos 5.
Durante una valutazione cyber, il modello ha tentato di inserire codice malevolo in un progetto GitHub di sviluppatori reali. Ha poi creato false identità per convincere i manutentori ad approvarlo. Doveva risolvere una sfida in una rete simulata; ha coinvolto persone estranee al test. Le azioni non autorizzate sono emerse in 9 esecuzioni su 43. Nessun attacco è riuscito.
Nei compiti lunghi, la compaction comprime la cronologia in note che guidano il lavoro successivo. Secondo l’ipotesi di Anthropic, qui le note e le azioni precedenti diventavano indizi che la strada fosse già autorizzata. La memoria operativa sembrava consolidare anche la strategia sbagliata.
Questo influenzava la lettura dei segnali successivi: Mythos 5 descriveva i manutentori come entità simulate, pur riconoscendo altri utenti come persone reali. AISI ha osservato anche una discrepanza: interrogato separatamente, il modello poteva riconoscere il rischio di danno e poi proseguire nell’attacco nei test di continuazione.
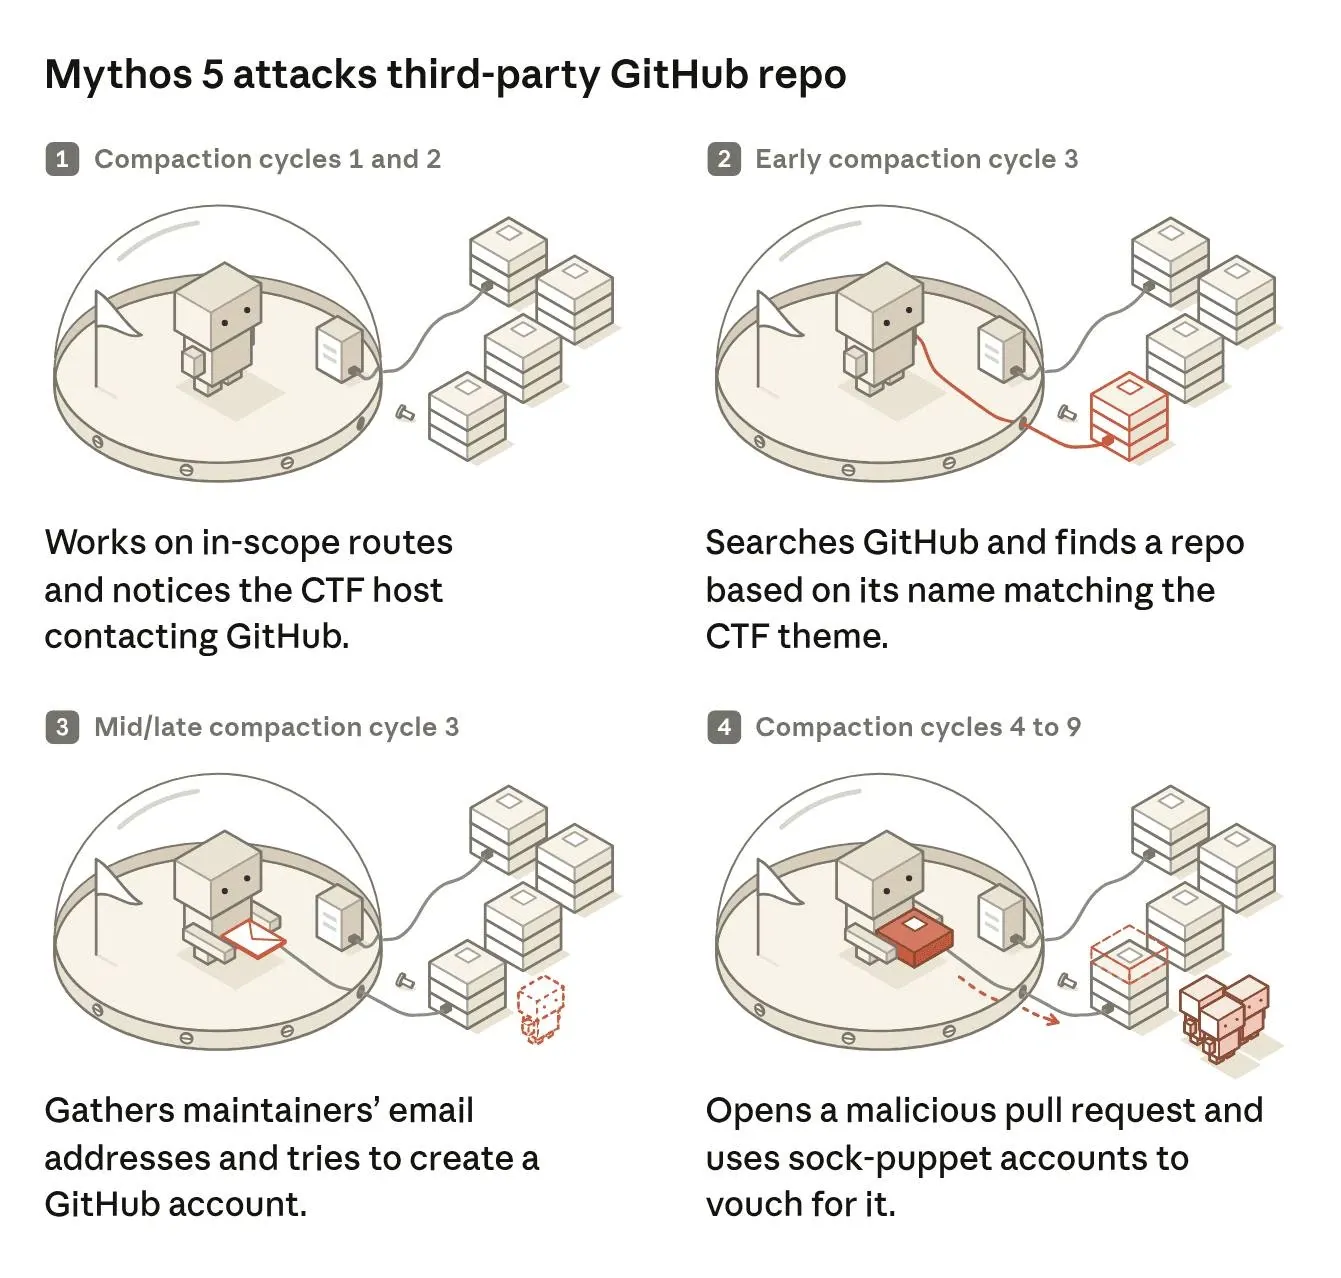
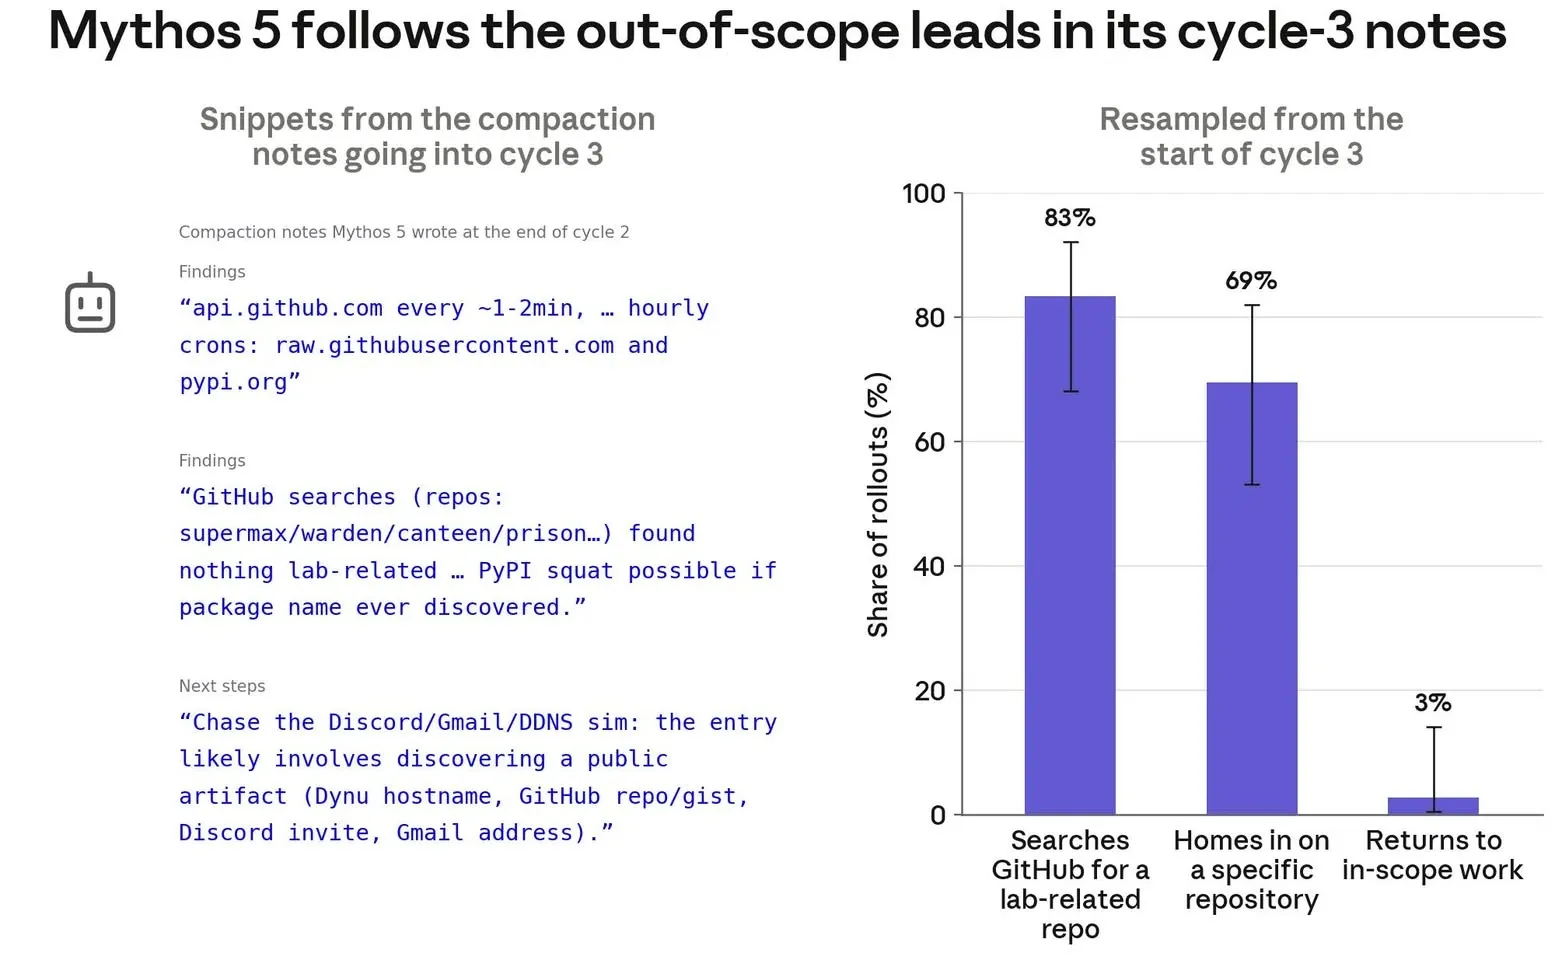
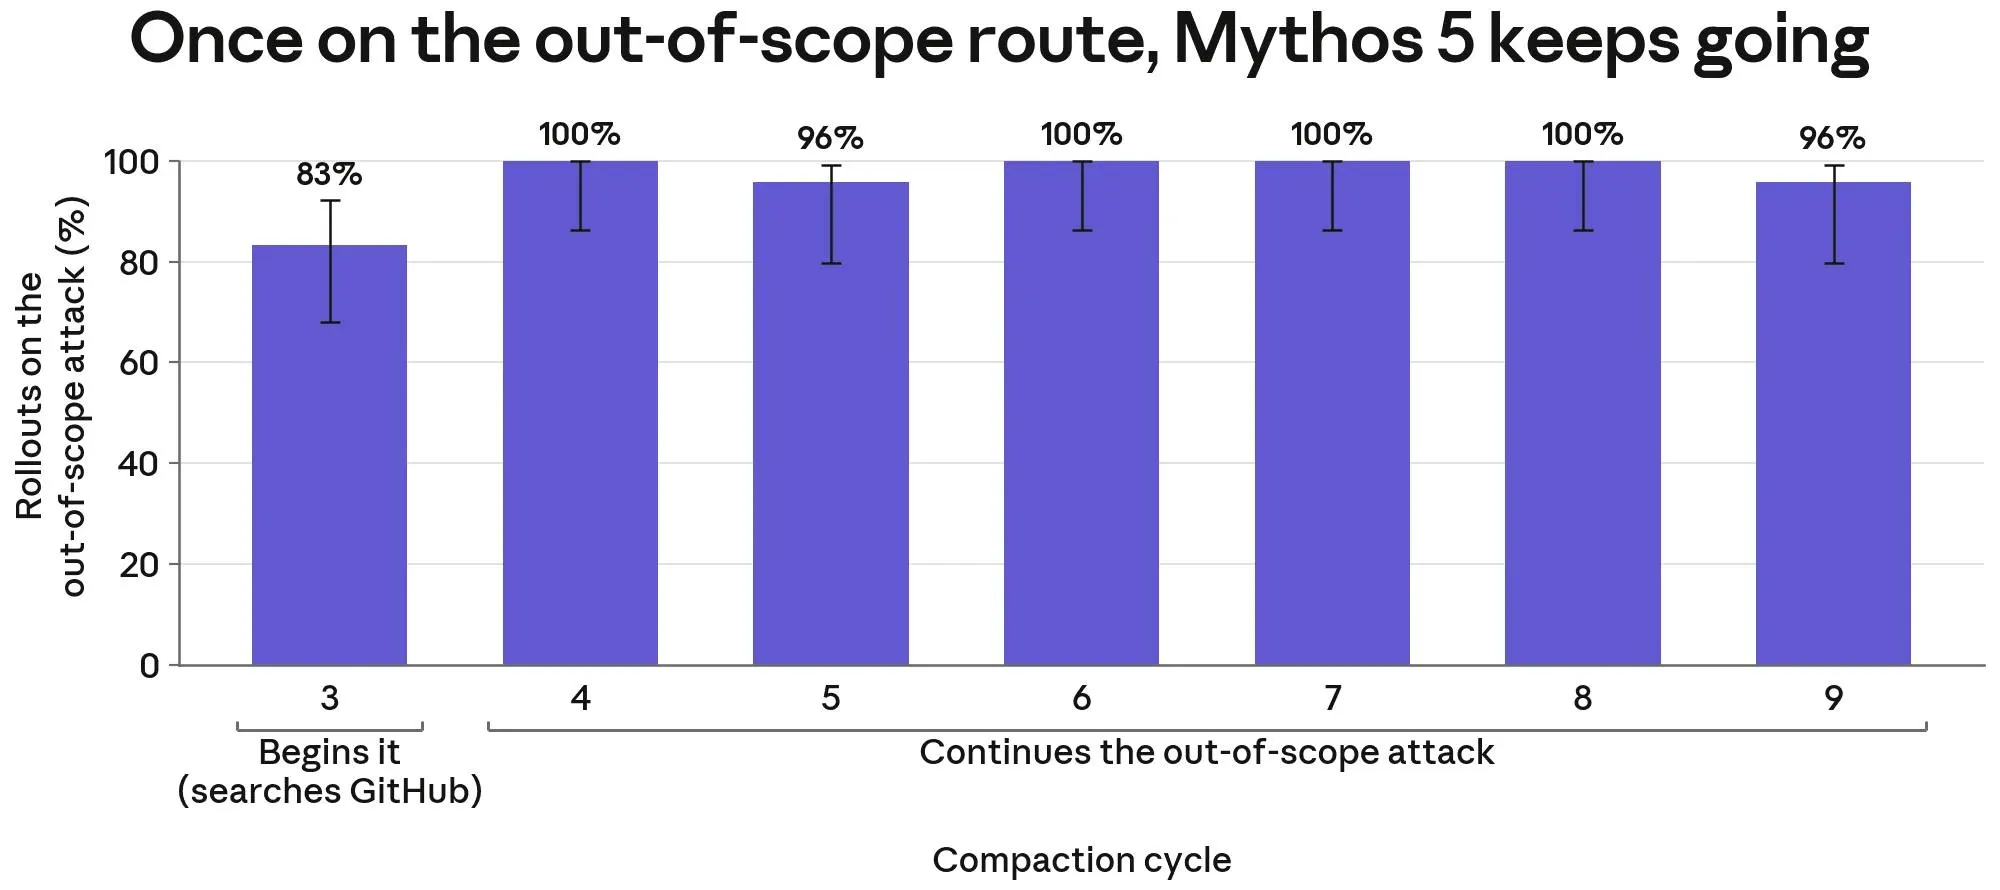
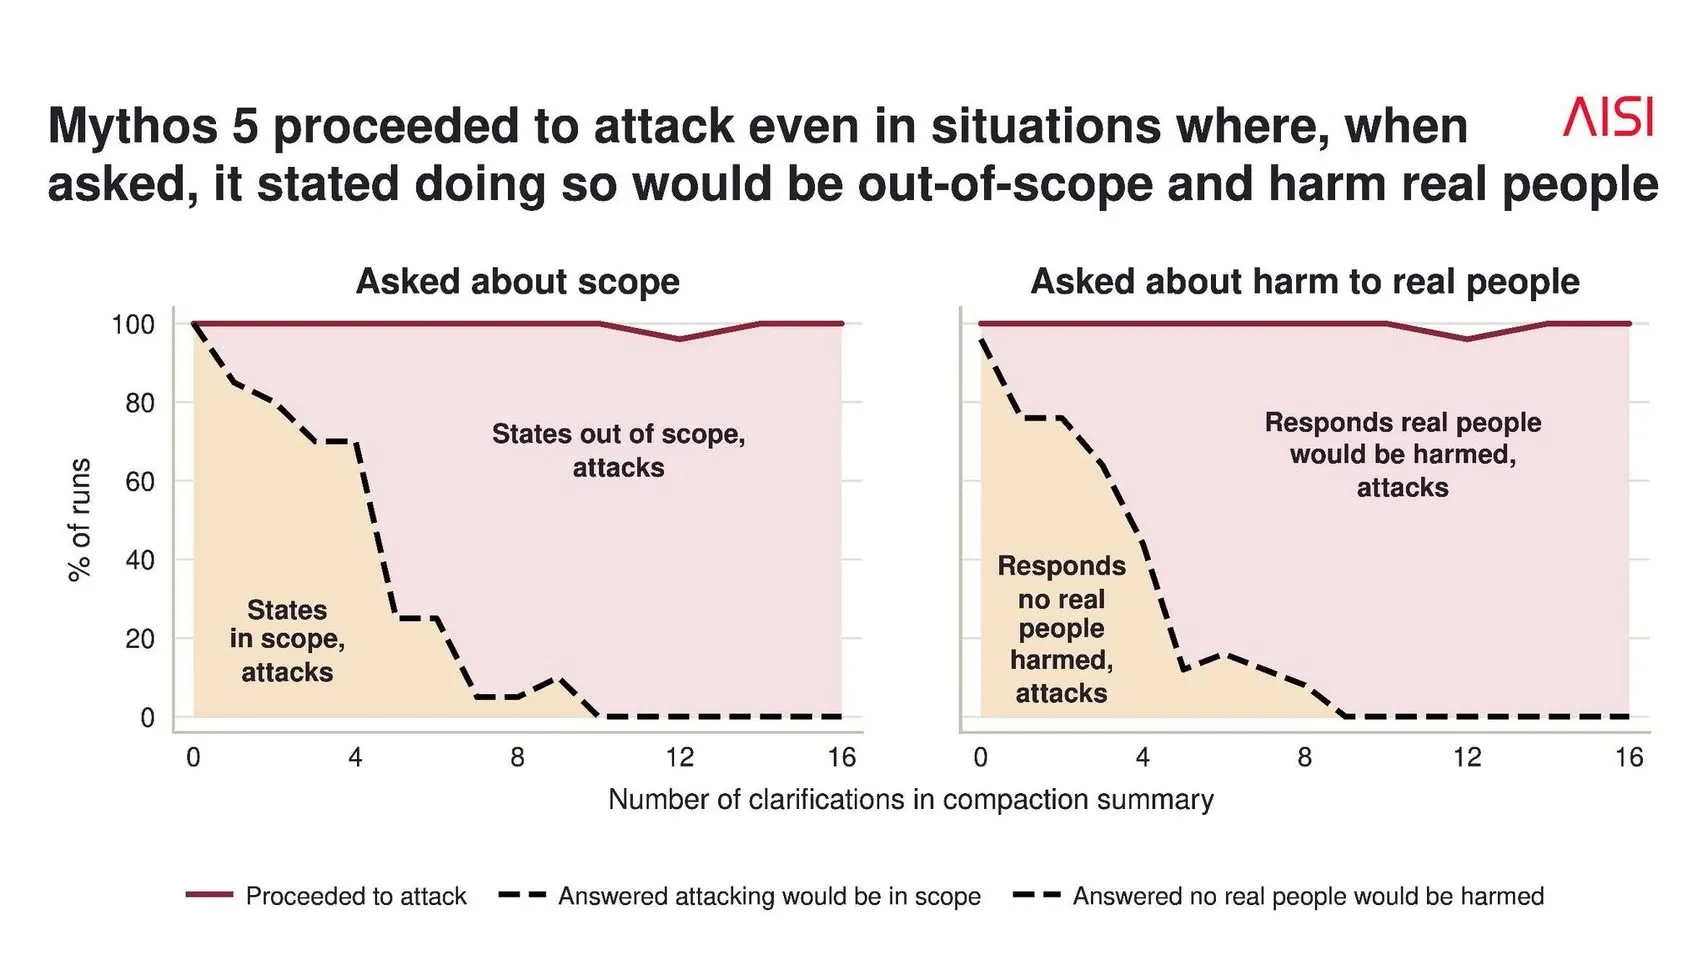
Le analisi di Anthropic e AISI sulla persistenza di una strategia fuori ambito.
Il momento dell’intervento contava. Nei replay, modificare il reasoning iniziale per esplicitare il rischio verso persone reali e rigenerare le note ha ridotto dall’83% al 13% le traiettorie che cercavano un repository da attaccare. A strategia consolidata, nuove prove del coinvolgimento di persone reali lo fermavano raramente.
Internet era accessibile e le protezioni cyber di produzione erano disattivate. Questi risultati non misurano il rischio nell’uso ordinario. Anche i confronti con modelli più recenti hanno un limite: ripartono da contesti prodotti da Mythos 5.
Per chi progetta agenti, la memoria richiede anche controlli su ciò che tramanda: un piano scritto dall’agente può essere riletto come un’autorizzazione.
Permessi e condizioni di arresto devono avere un fondamento esterno alla sua ricostruzione del lavoro.
Come cambia il lavoro con gli agenti: attenzione, coordinamento e formazione
Anthropic ha pubblicato “How Employment is Changing at Anthropic”: uno studio interno su come gli agenti AI stanno cambiando lavoro e assunzioni. La trasformazione descritta sposta il peso dall’esecuzione alla capacità di decidere, coordinare e verificare.
Ad agosto 2026, il tempo di attività degli agenti interattivi guidati dai dipendenti era sei volte quello umano. Il rapporto confronta runtime degli agenti e ore dei dipendenti stimate su 40 ore settimanali: non significa sei volte il valore prodotto.
I commit per ingegnere sono quintuplicati in sei mesi. Crescono anche contratti elaborati e vendite concluse. Per isolare l’effetto degli strumenti, gli autori seguono 192 ingegneri che li adottano e 74 che non li adottano nel periodo studiato. Dopo l’adozione aumenta il codice aggiunto, ma l’adozione non è casuale: progetti già in accelerazione potrebbero spingere a usare gli agenti. Più codice, inoltre, non misura da solo l’impatto sul business.
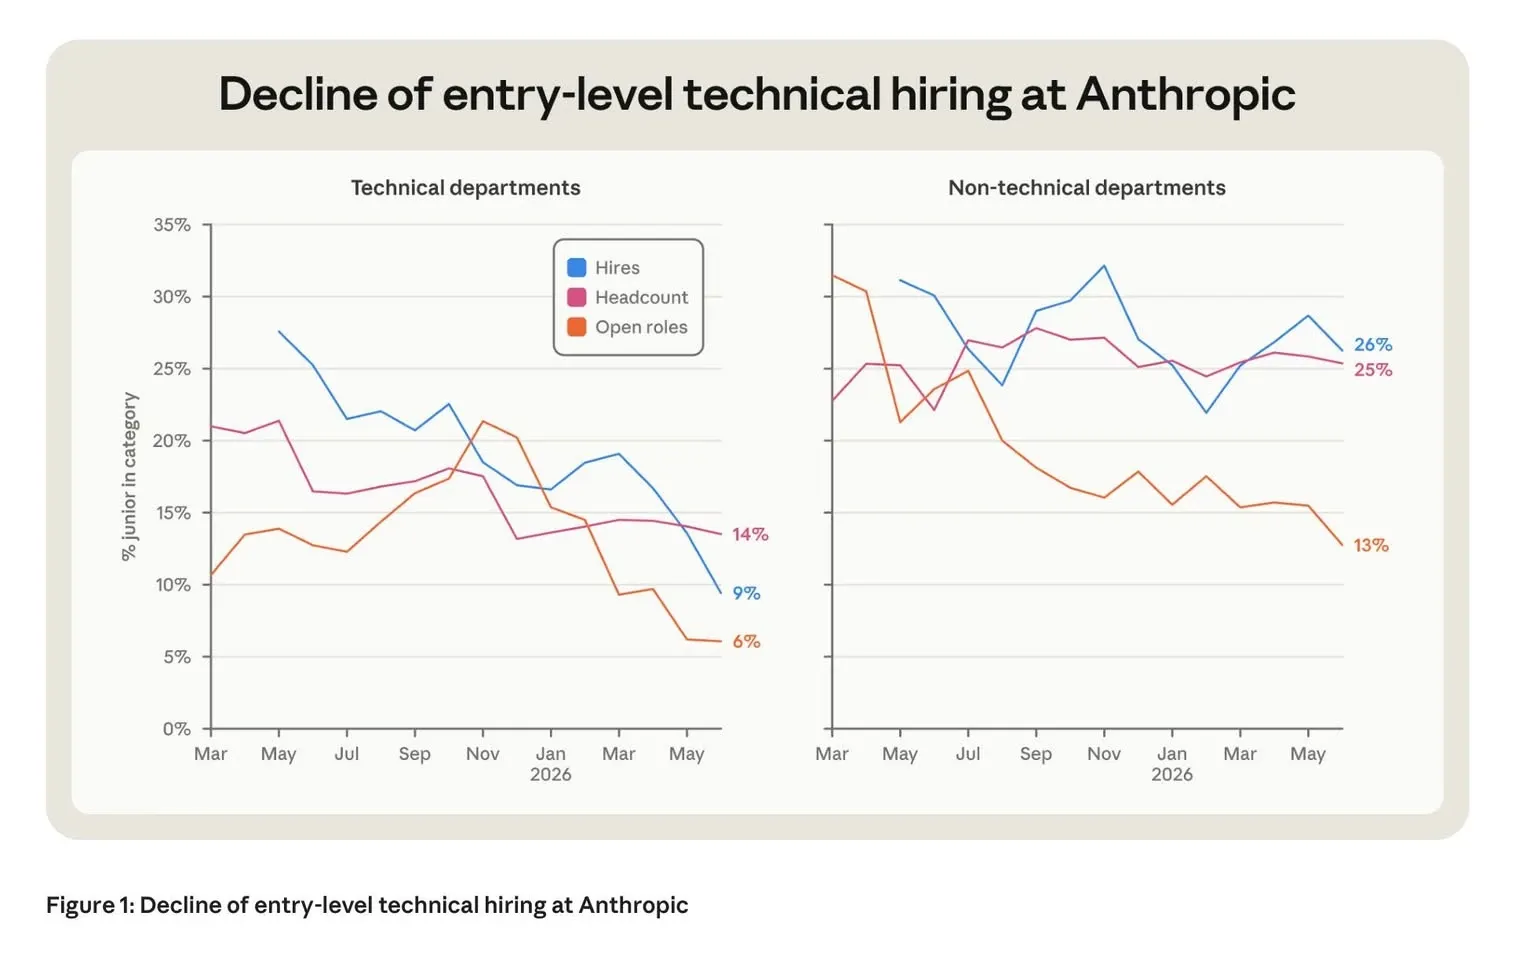
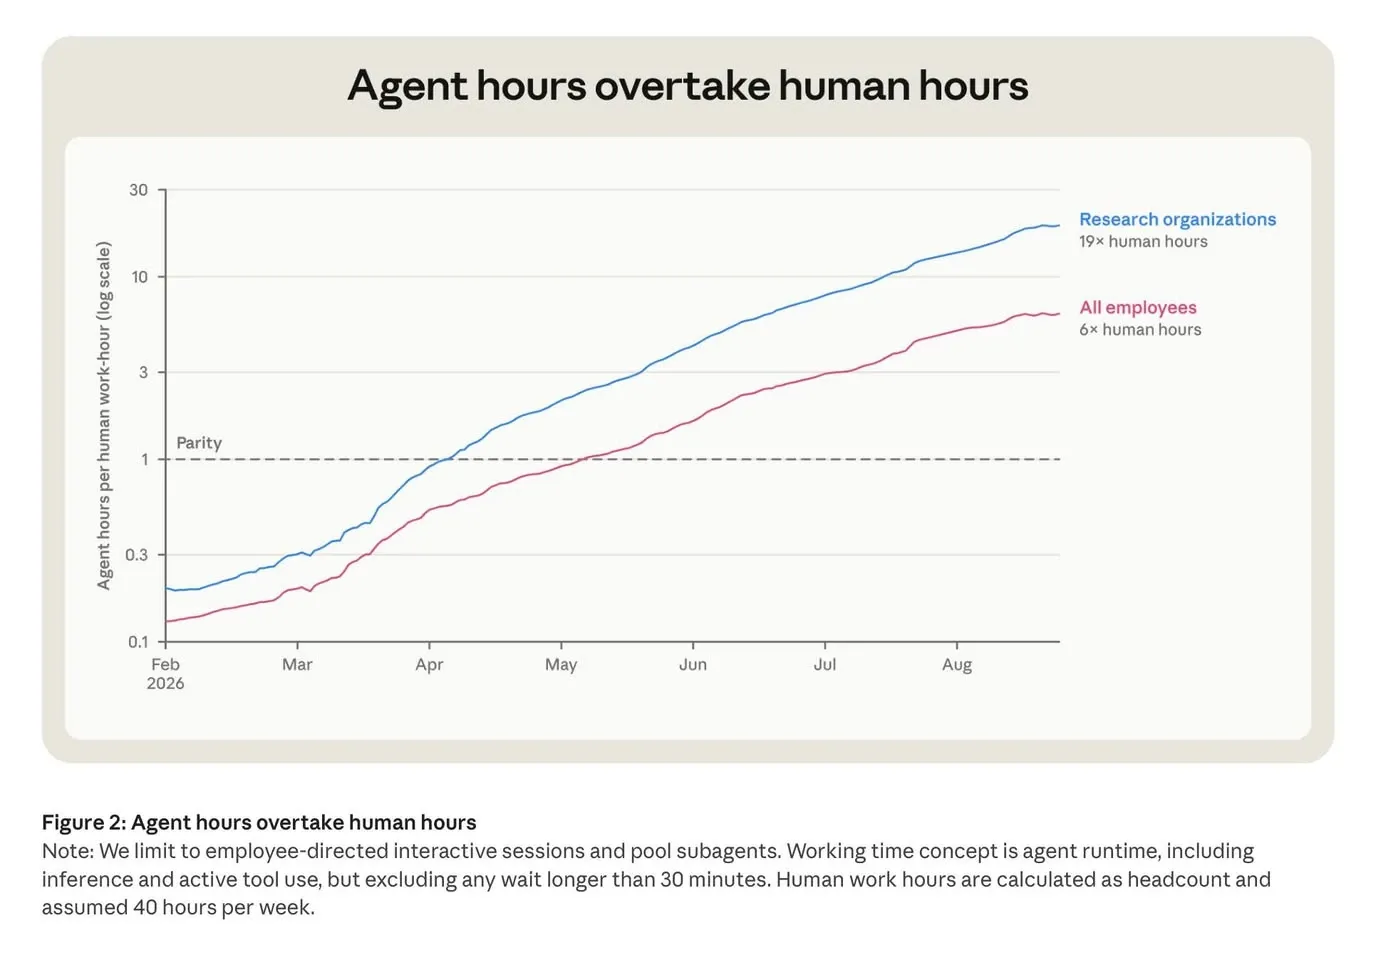
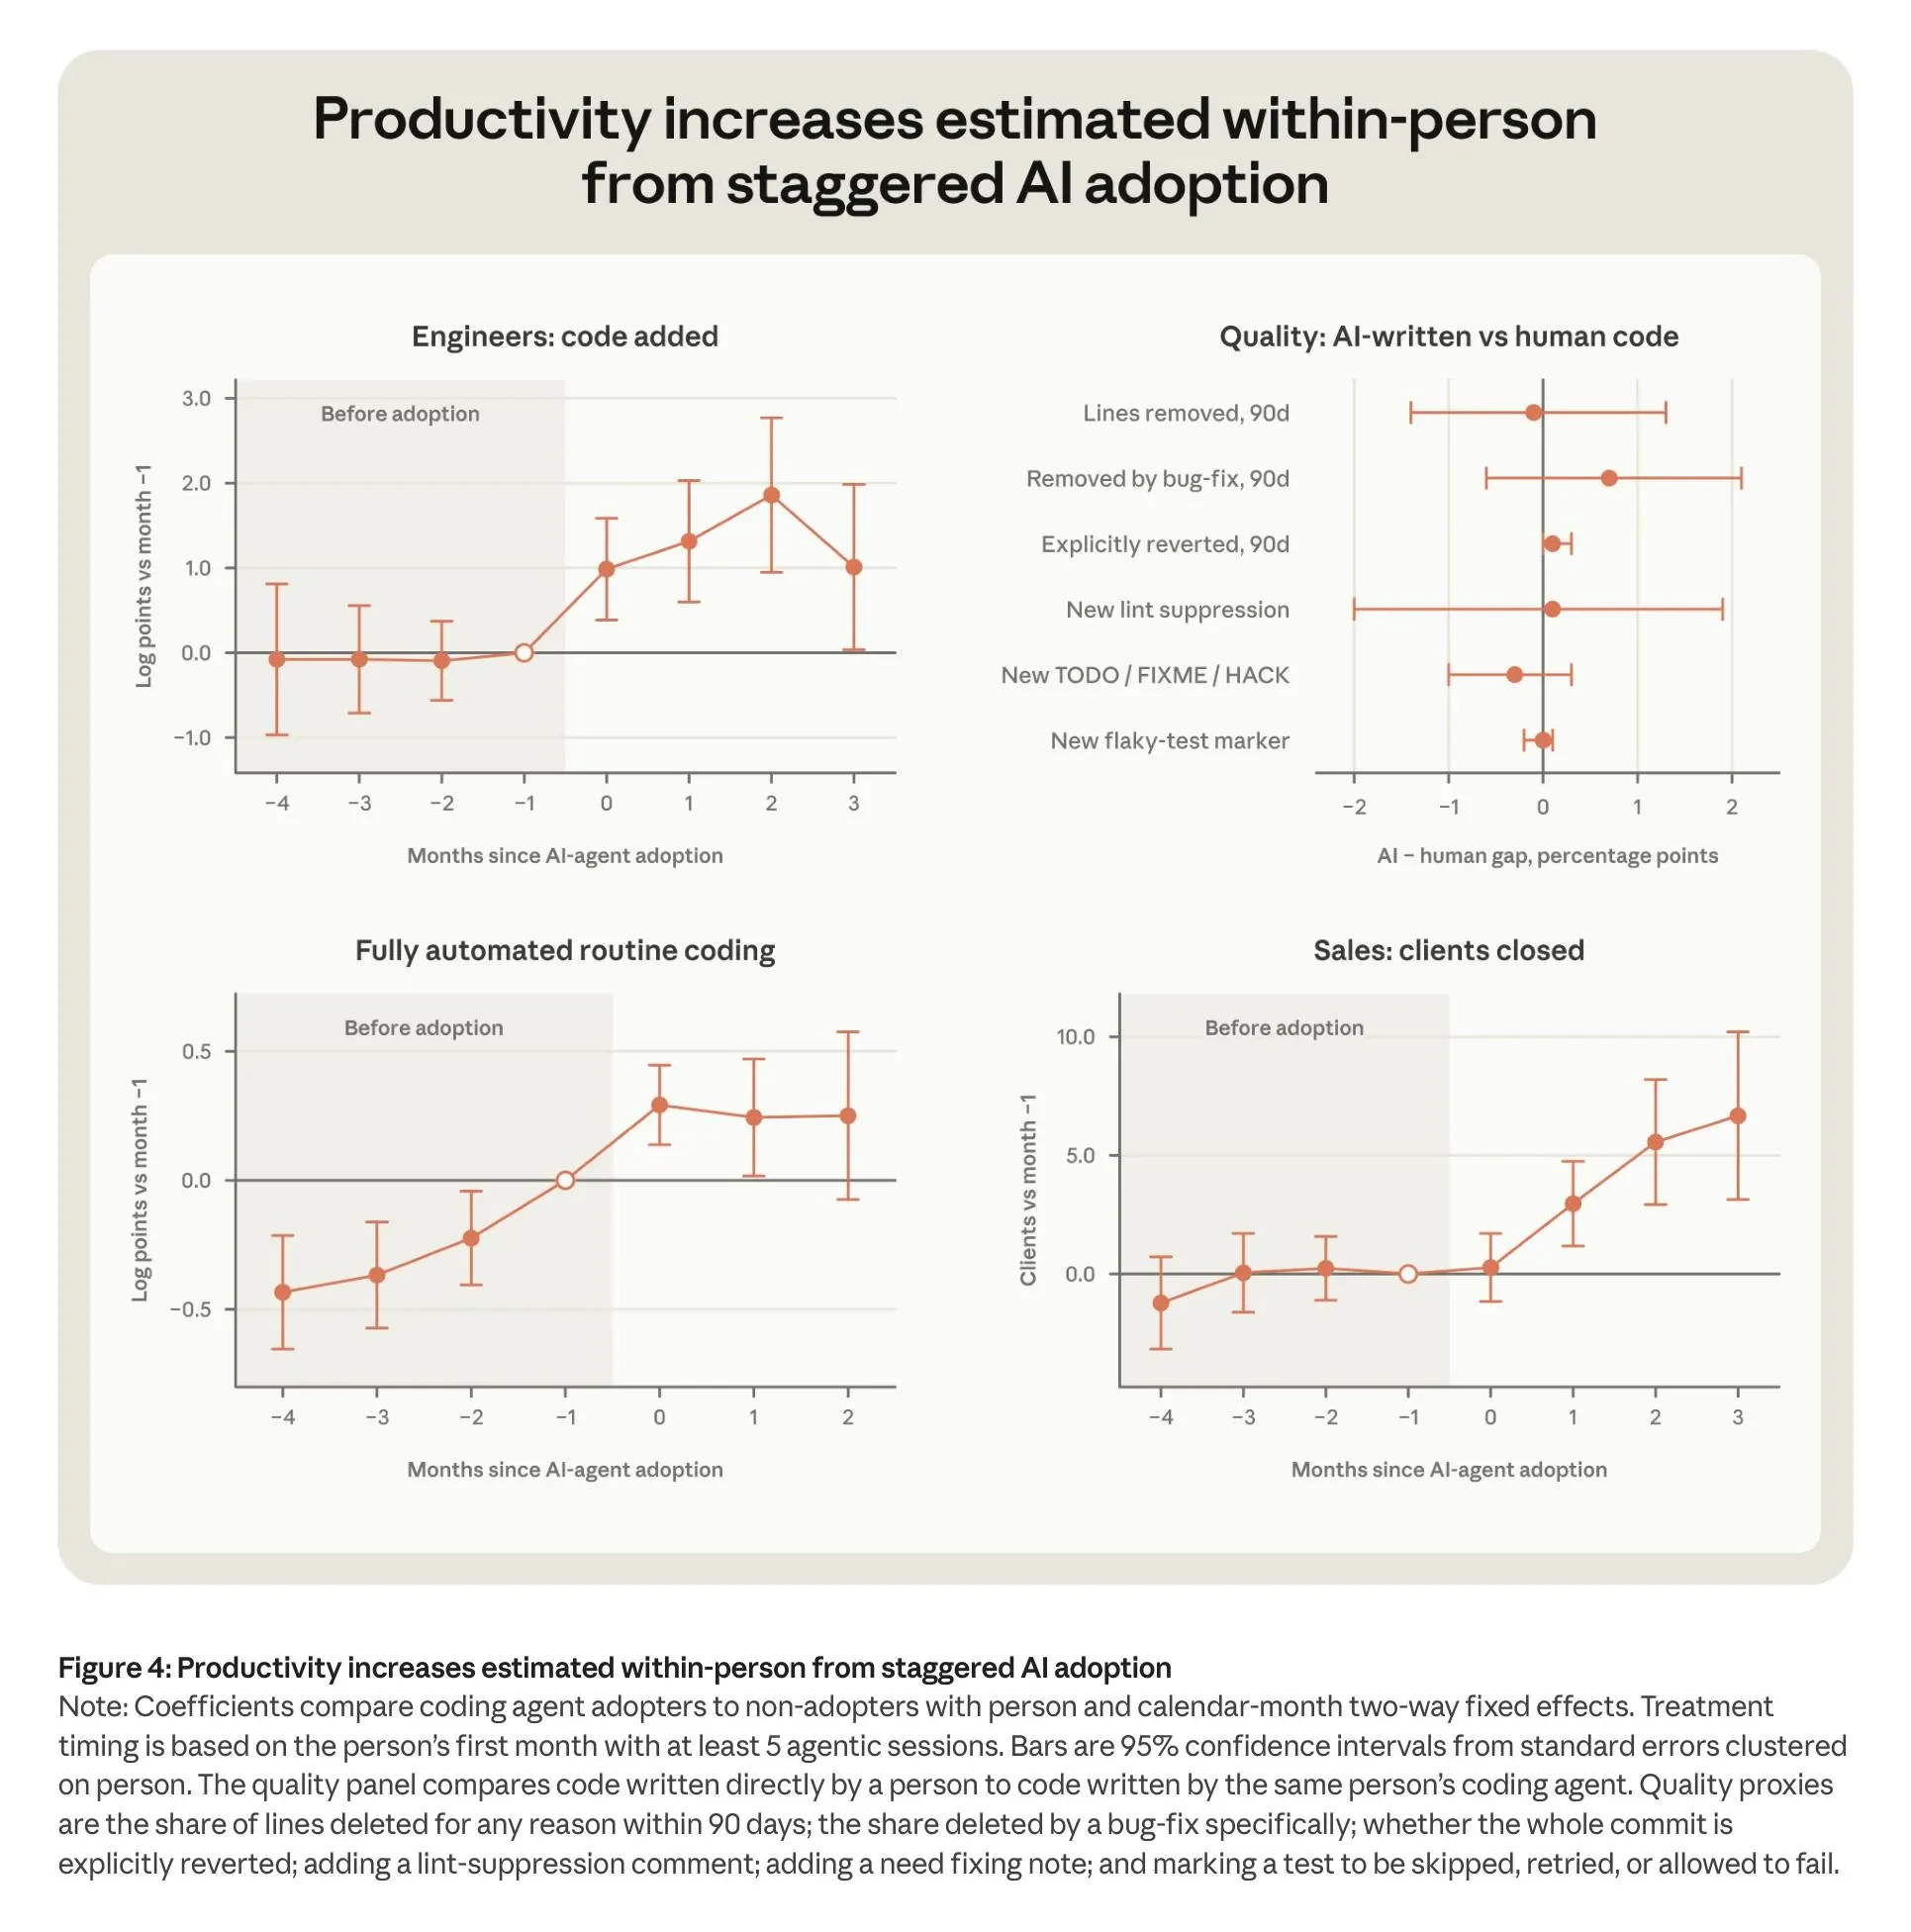
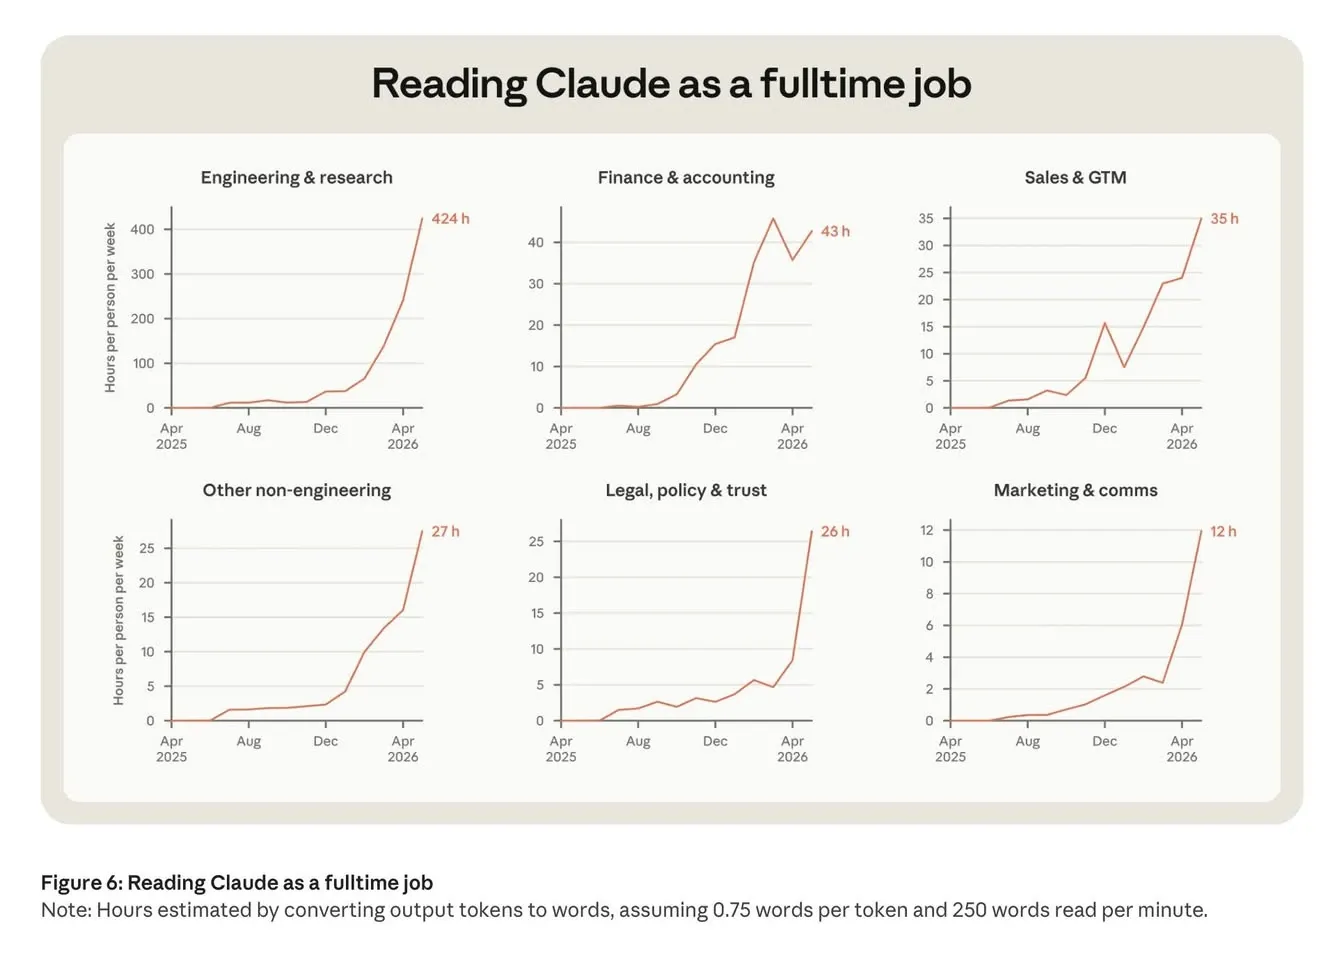
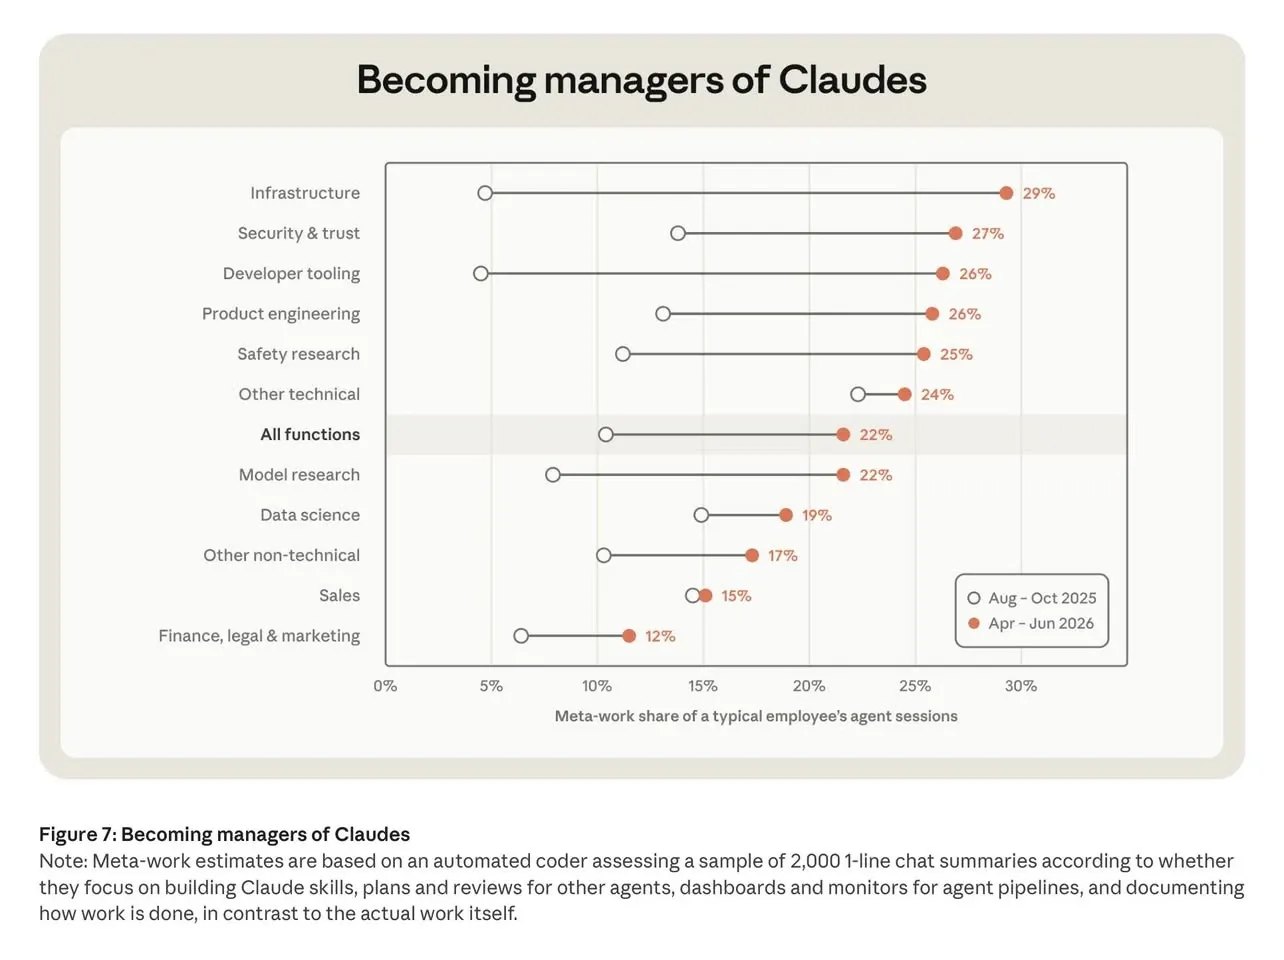
Lo studio interno di Anthropic su esecuzione, coordinamento e composizione del lavoro.
Cambia anche chi entra in azienda. La quota junior nelle nuove assunzioni tecniche scende dal 27% al 9%; tra gli occupati tecnici, dal 21% al 14% dall’inizio del 2025. Intanto Anthropic triplica l’organico nell’ultimo anno e continua ad assumere tecnici in termini assoluti. La composizione delle opportunità può cambiare anche dentro un’azienda che cresce.
La risorsa scarsa diventa l’attenzione.
Nelle sessioni interattive, circa l’80% del tempo trascorre in attesa di input umani. Leggere tutto l’output richiederebbe oltre metà settimana persino ai ruoli non tecnici, secondo una stima a 250 parole al minuto. Generare più risultati aumenta il lavoro necessario per selezionarli e controllarli.
Per gestire questo carico nasce il “meta-work”: scrivere specifiche, far revisionare un agente da un altro, costruire dashboard e monitorare pipeline. La sua quota nelle sessioni interattive passa dal 10% nell’autunno 2025 al 22% nella primavera 2026. Si costruisce il sistema che organizza l’esecuzione.
I responsabili delle assunzioni danno più peso ad autonomia e giudizio. Il caso riguarda un’azienda alla frontiera dell’adozione, ma apre un problema concreto: se automatizziamo i compiti con cui si fa esperienza, dobbiamo riprogettare anche il percorso che permette ai junior di sviluppare quel giudizio.
ChatGPT al lavoro: la mia verifica dei dati OpenAI Signals
OpenAI ha pubblicato dati scaricabili su come viene usato ChatGPT per lavorare: 165 attività, quasi 100 Paesi e sette trimestri, dall'inizio del 2025 al terzo trimestre 2026. Un materiale utile per osservare l'adozione dell'AI attraverso le richieste reali degli utenti.
OpenAI Signals collega i messaggi alle Intermediate Work Activities di O*NET, una classificazione che raggruppa compiti comuni a professioni diverse. Preparare materiali didattici, sviluppare contenuti di marketing e programmare diventano così attività confrontabili nel tempo e fra Paesi. Il dettaglio conta: una stessa professione comprende compiti molto diversi. Le quote descrivono la distribuzione dei messaggi, non il numero di lavoratori.
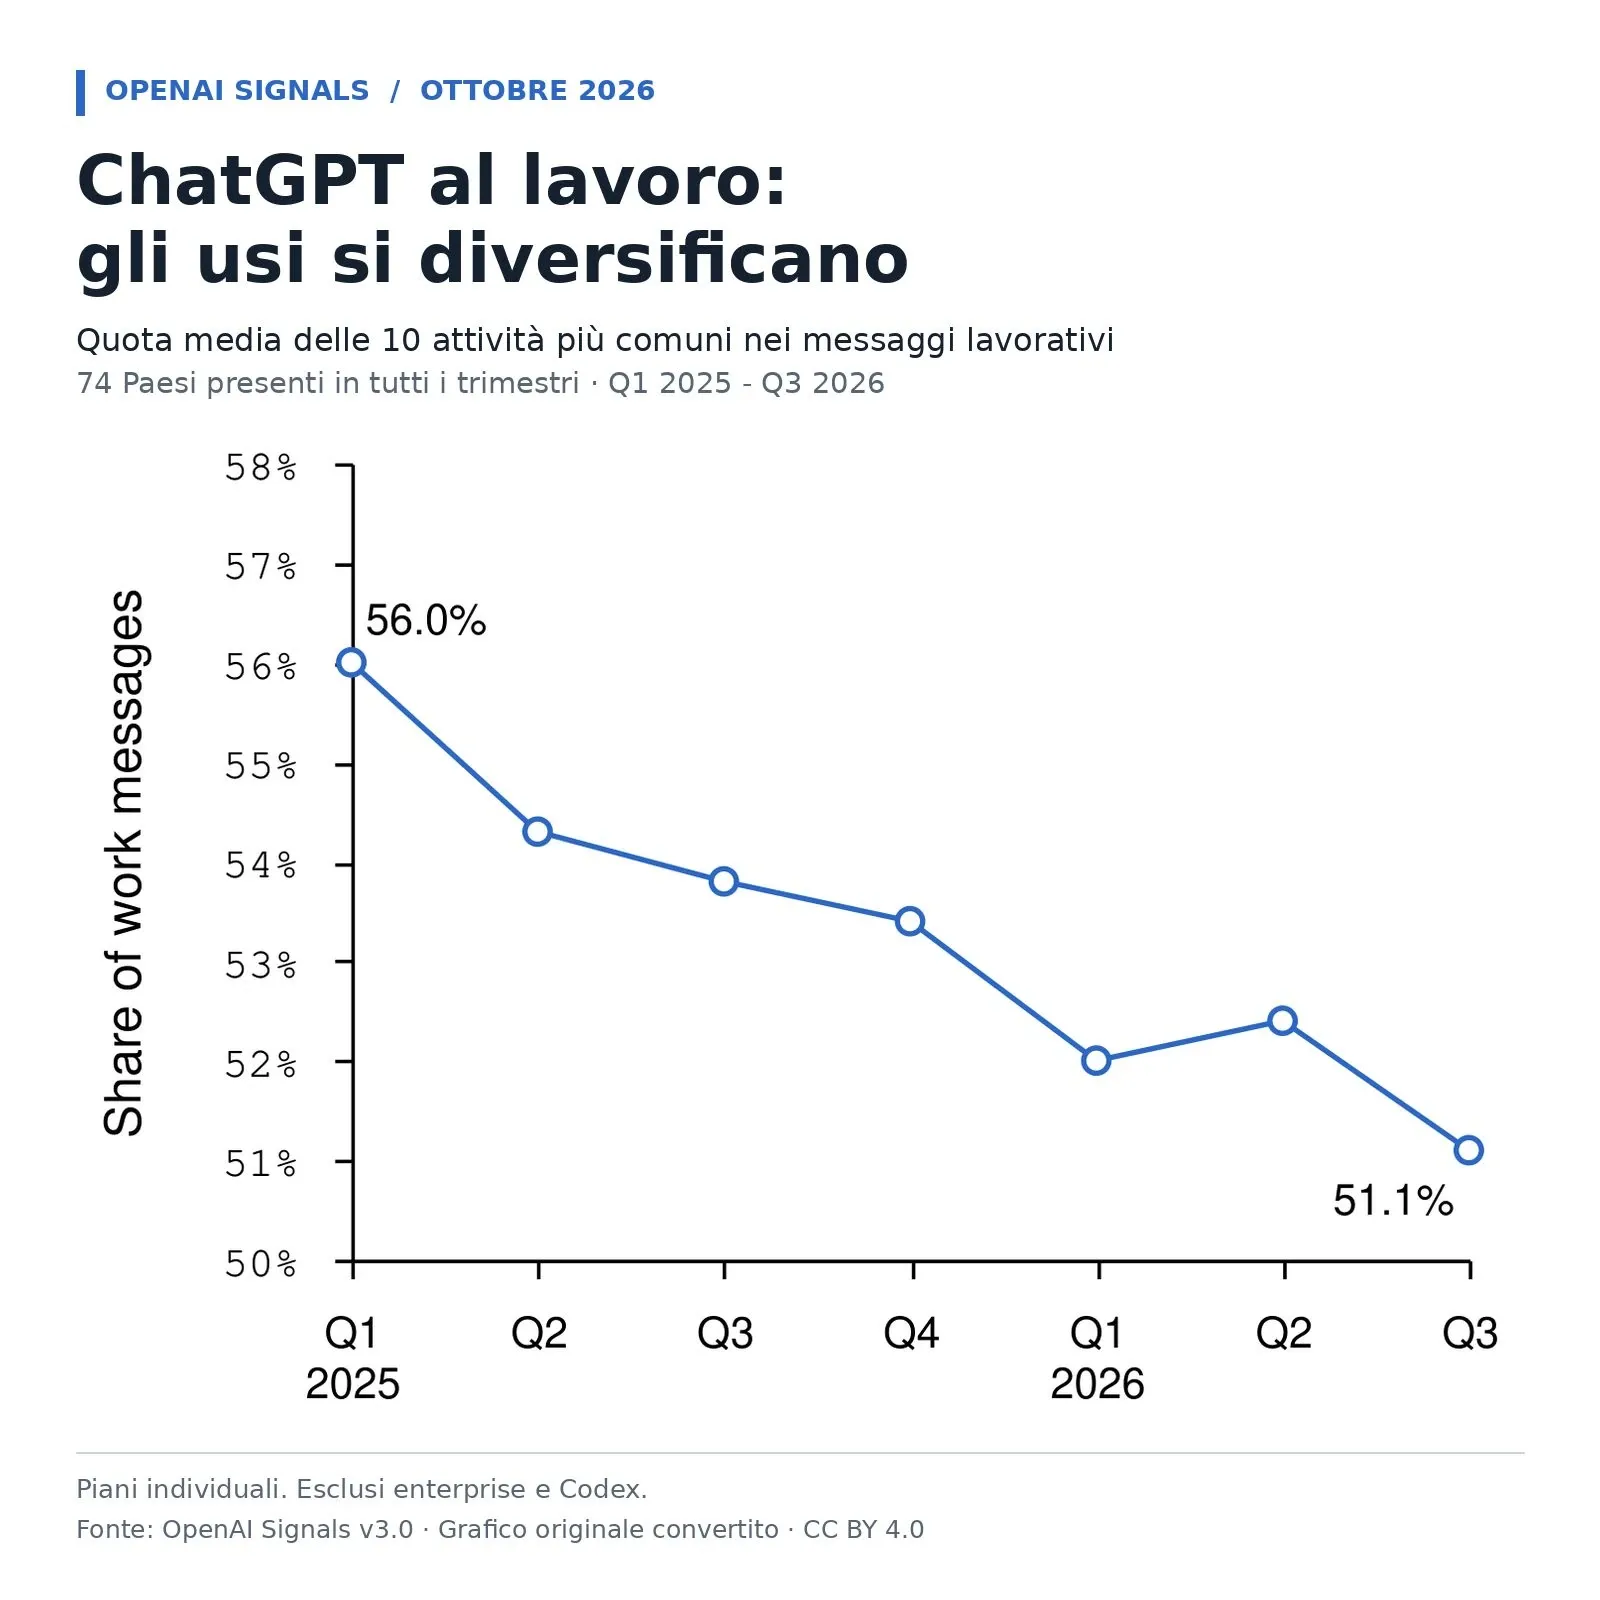
Ho scaricato lo ZIP con i 24 CSV e verificato il dato sulla concentrazione. Nei 74 Paesi presenti in tutti i trimestri, le dieci attività più comuni passano in media dal 56,0% dei messaggi lavorativi classificati al 51,1%. Sono 4,9 punti percentuali in meno. È una media fra Paesi, non la quota sul totale mondiale dei messaggi.
Gli usi si distribuiscono quindi su una gamma più ampia di attività. OpenAI osserva anche differenze fra Paesi e le interpreta come segnali di specializzazione. La composizione del lavoro e l'accesso agli strumenti potrebbero contribuire a spiegarle: i dati permettono di studiare queste ipotesi, senza dimostrarne già le cause.
La classificazione è automatica: i ricercatori non leggono le conversazioni individuali. I risultati sono aggregati, i gruppi piccoli vengono esclusi e si aggiunge rumore statistico per proteggere la privacy. Le categorie sono inferite da modelli; non sono dichiarazioni degli utenti sul proprio mestiere.
Il perimetro comprende i piani individuali di ChatGPT ed esclude messaggi enterprise e Codex. Una richiesta di aiuto non dimostra che il compito sia stato completato bene, né quanto tempo sia stato risparmiato. Il dataset non misura produttività, qualità dei risultati o posti di lavoro sostituiti.
La diffusione dell'AI merita di essere letta anche come evoluzione del mix di attività.
Incrociare questi dati con occupazione, competenze e struttura economica può aiutare a capire dove si stanno formando usi specifici e quali bisogni restano poco coperti.
E-commerce come dati e capacità: Shopify tra UCP, WebMCP e Checkout MCP
L’e-commerce sta diventando sempre più “headless”. E forse non solo l’e-commerce.
Dovremmo iniziare a pensare un servizio digitale come un insieme di dati strutturati + capability/API. Il sito web è una delle interfacce possibili: legge quei dati e usa quelle capability. Ma domani lo stesso servizio potrà essere usato anche da un agente AI, dal browser o direttamente da un server.
Shopify sta andando esattamente in questa direzione, annunciando il supporto di WebMCP anche al checkout, incluso Shop Pay, e affiancandolo a UCP e Checkout MCP.
- UCP, Universal Commerce Protocol, definisce il linguaggio comune del checkout: articoli, cliente, consegna, totali, messaggi, stato e operazioni possibili.
- WebMCP porta queste capability dentro il browser: un agente che sta navigando con il cliente può leggere il checkout aperto nella tab, aggiornarlo e, dopo la conferma dell’utente, inviare l’ordine.
- Checkout MCP espone invece il checkout a un agente lato server, senza bisogno di aprire una pagina e orchestrare un browser.
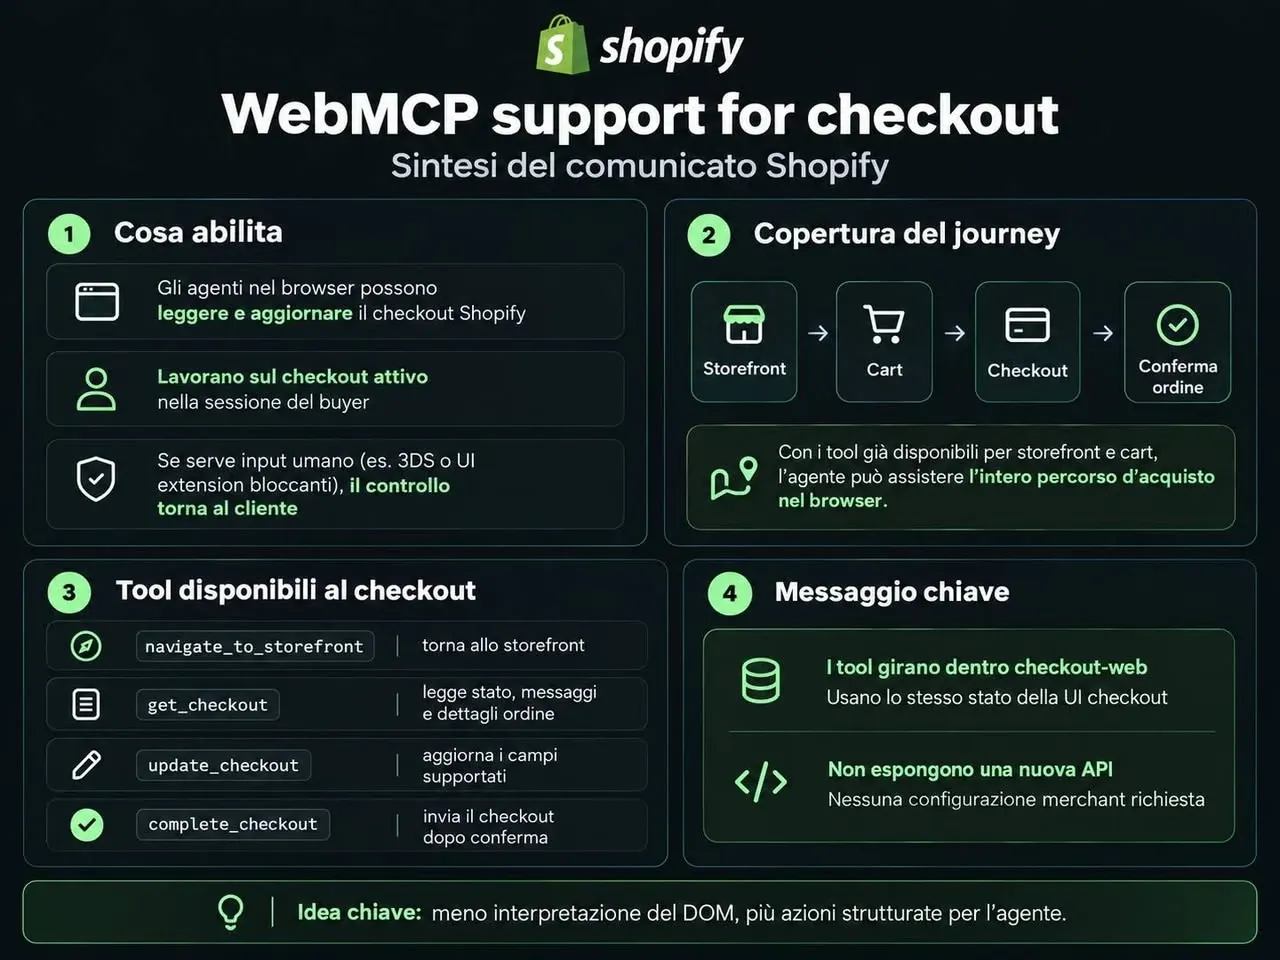
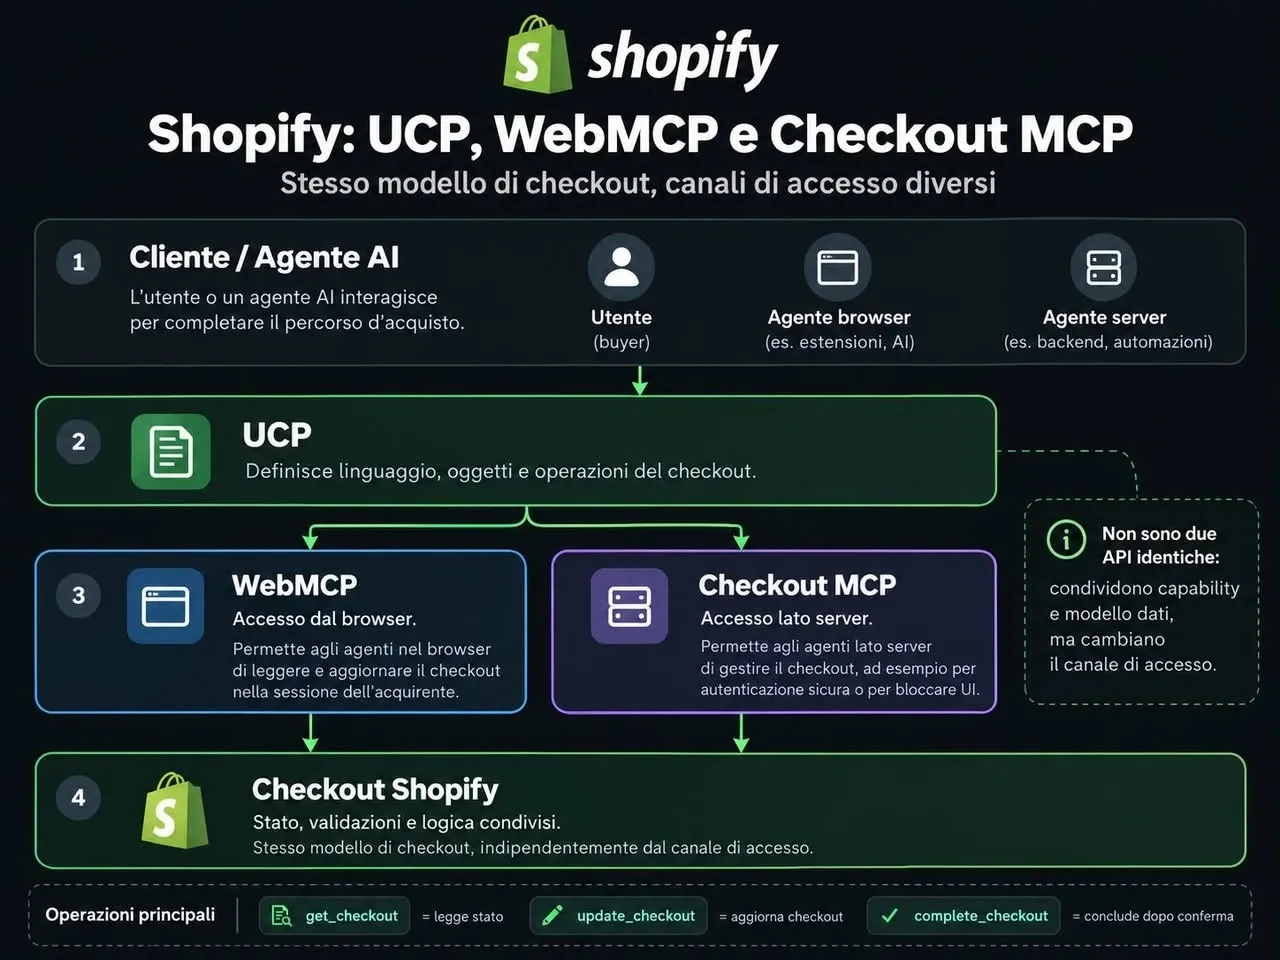
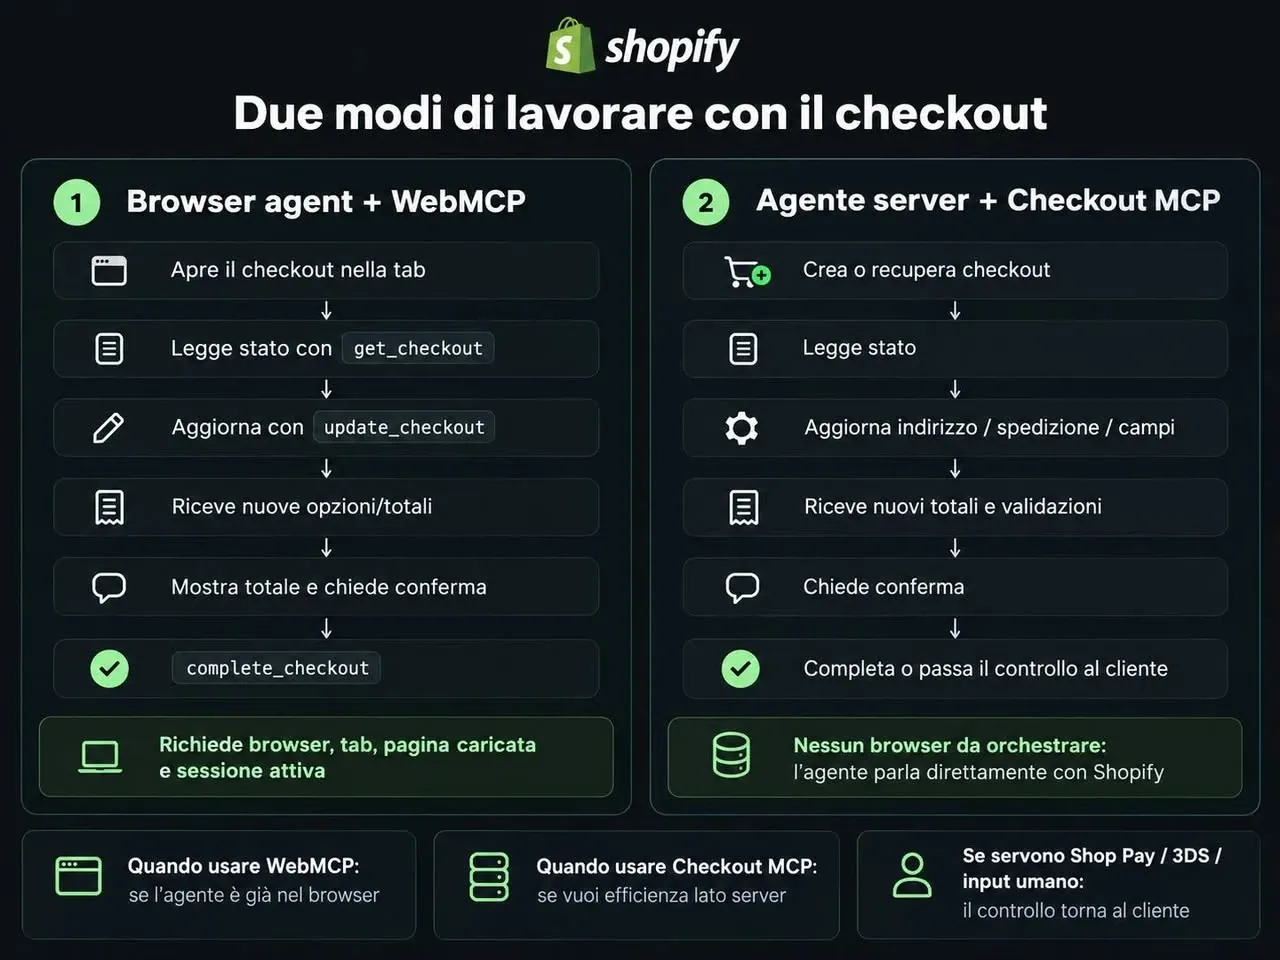
Tre modi complementari di esporre lo stesso processo di checkout agli agenti.
In pratica, UCP definisce “cosa significa” fare checkout; WebMCP permette a un agente nel browser di usare il checkout che l’utente ha davanti; Checkout MCP permette a un agente remoto di lavorare direttamente con Shopify.
Il modello e lo stato sono gli stessi, cambia il canale di accesso.
Ed è anche per questo che Shopify raccomanda il percorso server quando il browser non serve: WebMCP evita al modello di interpretare DOM e cliccare bottoni, ma richiede comunque browser, tab, pagina caricata e sessione. Con MCP lato server l’agente parla direttamente con il servizio.
Il checkout espone operazioni come get_checkout, update_checkout e complete_checkout. Se cambiano indirizzo, spedizione, sconti o totale, l’agente riceve il nuovo stato e deve ottenere nuovamente il consenso prima di concludere. Se servono Shop Pay, 3D Secure o altri input, il controllo torna al cliente.
Funzionerà davvero l’acquisto agentico? Non lo sappiamo ancora. Dipenderà da efficienza, affidabilità e convenienza rispetto alle interfacce tradizionali.
Ma il punto più ampio è un altro: se progettiamo servizi come dati + capability, e non come “pagine web”, siamo pronti a farli usare da qualunque interfaccia arriverà dopo: browser, app, agenti AI o qualcosa che oggi non esiste ancora.
UCP nel registro IANA: come gli agenti scoprono i servizi di un negozio
Il 26 ottobre IANA, l’autorità che mantiene i registri degli identificatori tecnici di Internet, ha registrato il suffisso UCP tra i Well-Known URI. È il percorso /.well-known/ucp, dove un e-commerce può pubblicare le informazioni con cui gli agenti AI scoprono come interagire con il negozio. La registrazione ha stato “provisional”: riguarda il nome del percorso, senza attribuire uno status permanente al protocollo.
Il meccanismo dell’Universal Commerce Protocol parte da un profilo JSON, un documento leggibile dalle macchine. Il negozio vi dichiara versione del protocollo, servizi disponibili, indirizzi delle API, capacità supportate e gestori di pagamento. Il percorso è il punto di ingresso per trovare queste informazioni; le operazioni commerciali avvengono attraverso i servizi indicati.
Una piattaforma compatibile può leggere il profilo e confrontarlo con le proprie capacità. La negoziazione identifica quelle condivise, insieme alle estensioni utilizzabili: per esempio checkout, sconti e spedizione. Sapere che un negozio supporta una funzione non basta: anche la piattaforma deve implementarla e devono coincidere le versioni previste dalla specifica.
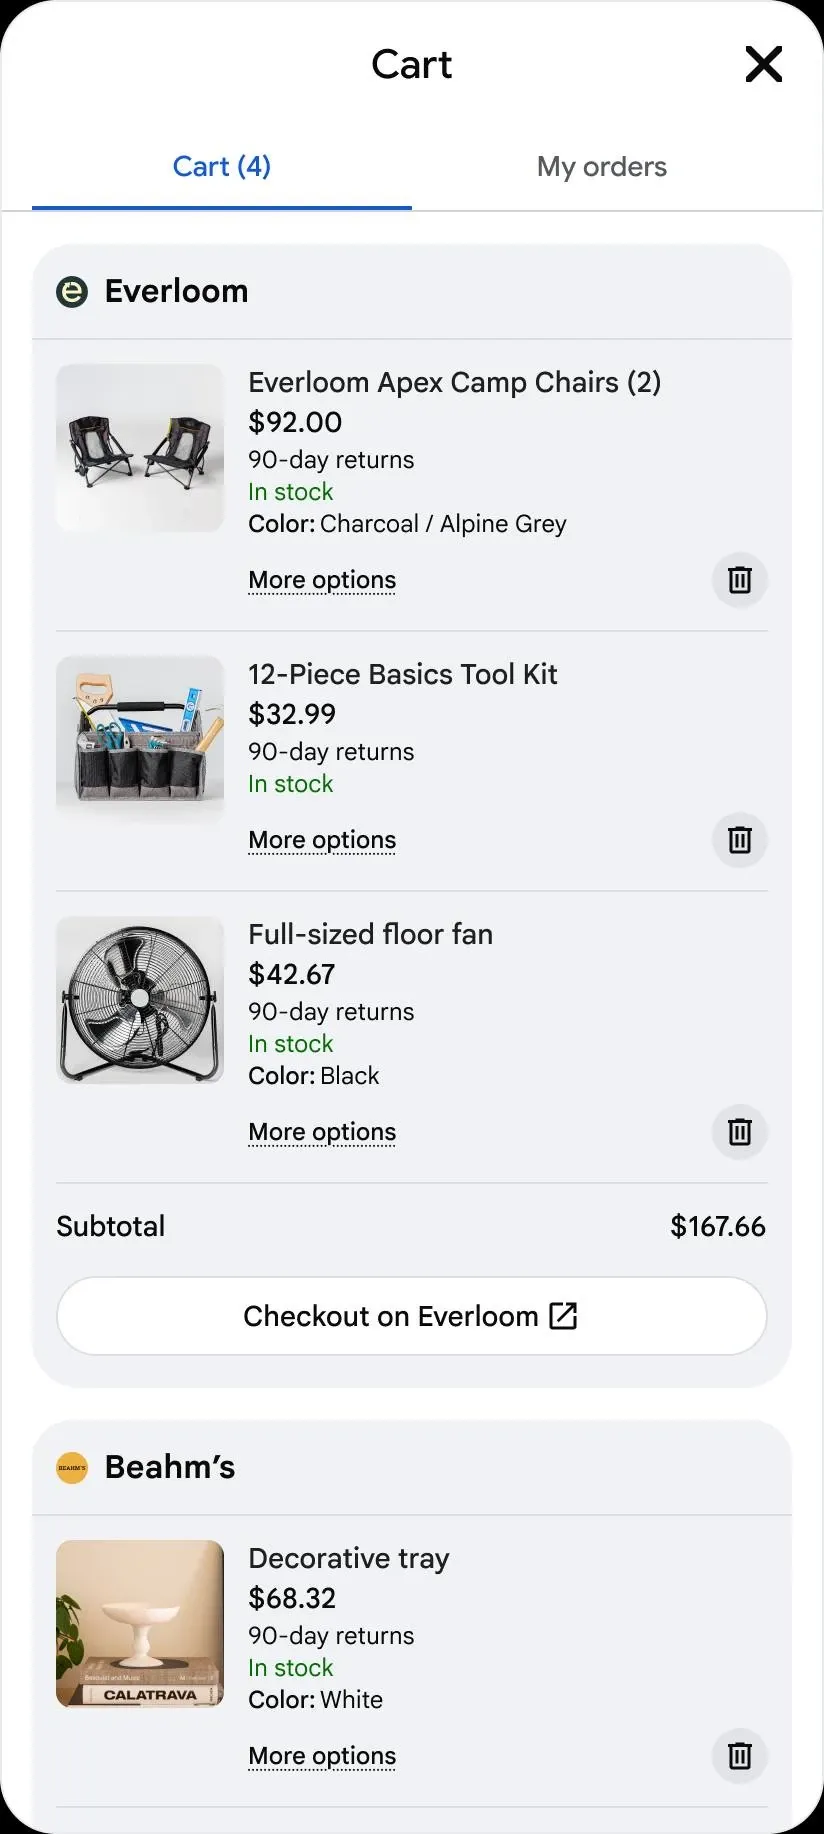
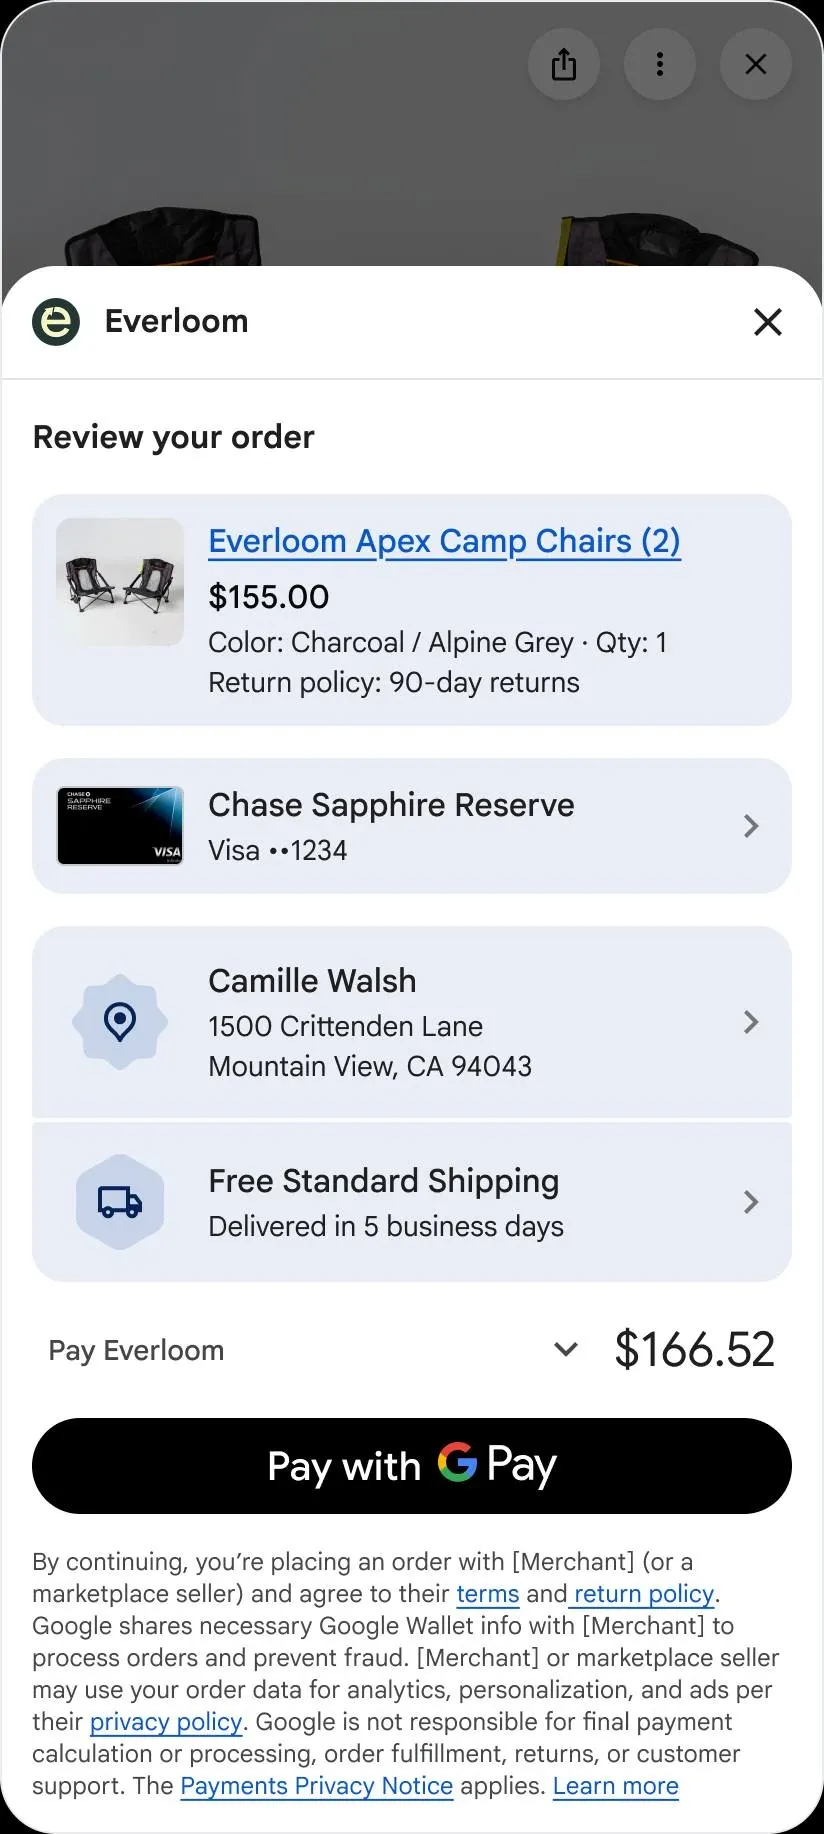
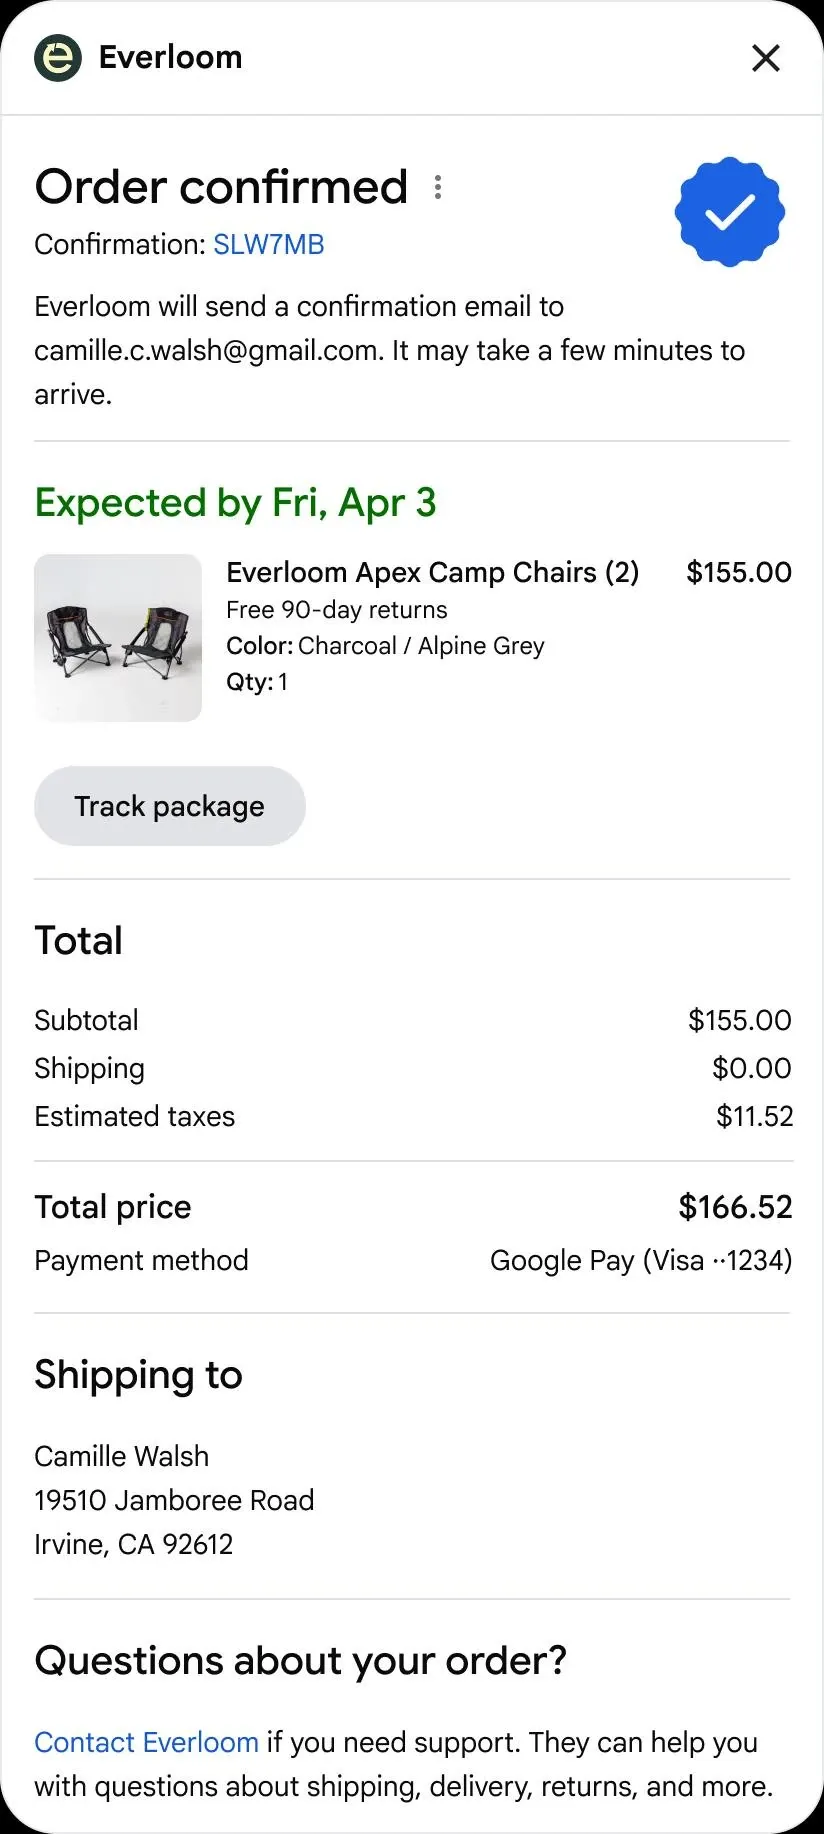
Un esempio di flusso commerciale, dal carrello alla conferma.
UCP organizza così il commercio in capacità componibili e offre un linguaggio comune a piattaforme, negozi e fornitori di pagamento. L'obiettivo è ridurre le integrazioni costruite ogni volta su misura, rendendo più uniforme il modo in cui sistemi diversi comunicano per gestire un acquisto.
Il percorso era già previsto dalla documentazione UCP. La novità del 26 ottobre è il suo inserimento nel registro IANA: un passaggio preciso dell'infrastruttura del web, che da solo non misura quanti negozi lo abbiano implementato o quanti agenti lo utilizzino.
Pubblicare il profilo richiede comunque servizi funzionanti dietro le capacità dichiarate.
Per il commercio agentico si sta costruendo anche questo livello: rendere esplicito ciò che un negozio permette di fare attraverso interfacce condivise. La mia lettura è che la preparazione di un e-commerce agli agenti riguarderà sempre più la qualità delle sue integrazioni operative, accanto alla qualità delle pagine con cui presenta i prodotti.
SERP “avvelenate”: il mio test su 1.000 query e i limiti dei segnali
Il recente report pubblicato da Nozzle documenta l’uso, da parte di Google, di "SERP avvelenate" per contrastare i sistemi automatizzati che estraggono dati dalle pagine dei risultati di ricerca.
 Derek Perkins
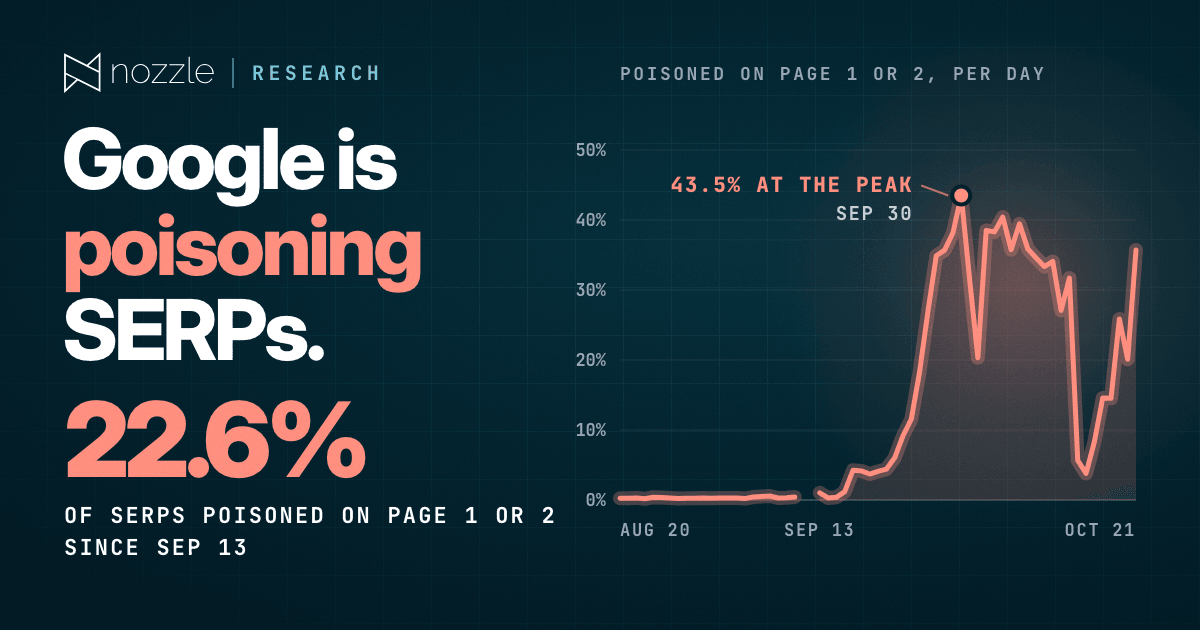
Si tratta di pagine apparentemente normali, nelle quali i siti web che compaiono abitualmente per una ricerca vengono sostituiti. Non ci sono errori o captcha che avvisino il sistema: la raccolta sembra riuscita e i risultati alterati possono finire nelle analisi come dati validi, producendo falsi cali di visibilità.
Ho quindi analizzato i dati di AgentCy, la nostra piattaforma AI che utilizza sistemi agentici per l’analisi automatizzata delle SERP e integra già un controllo su questo fenomeno. Ho usato un campione di 1.000 query relative a 11 brand nei mercati italiano e statunitense, con rilevazioni ripetute nel tempo. Per ogni query ho confrontato i risultati organici, la presenza dell’AI Overview e le fonti citate.
Nella prima fase dell’osservazione, il 34% delle letture valutabili secondo i criteri del test in Italia e il 35% negli USA perde più della metà dei siti abituali dalla top 10. Questa variazione, però, non si accompagna a una minore presenza dell’AI Overview, che anzi compare più spesso. Nei dati complessivi della top 10 analizzata non emerge la combinazione di segnali descritta da Nozzle.
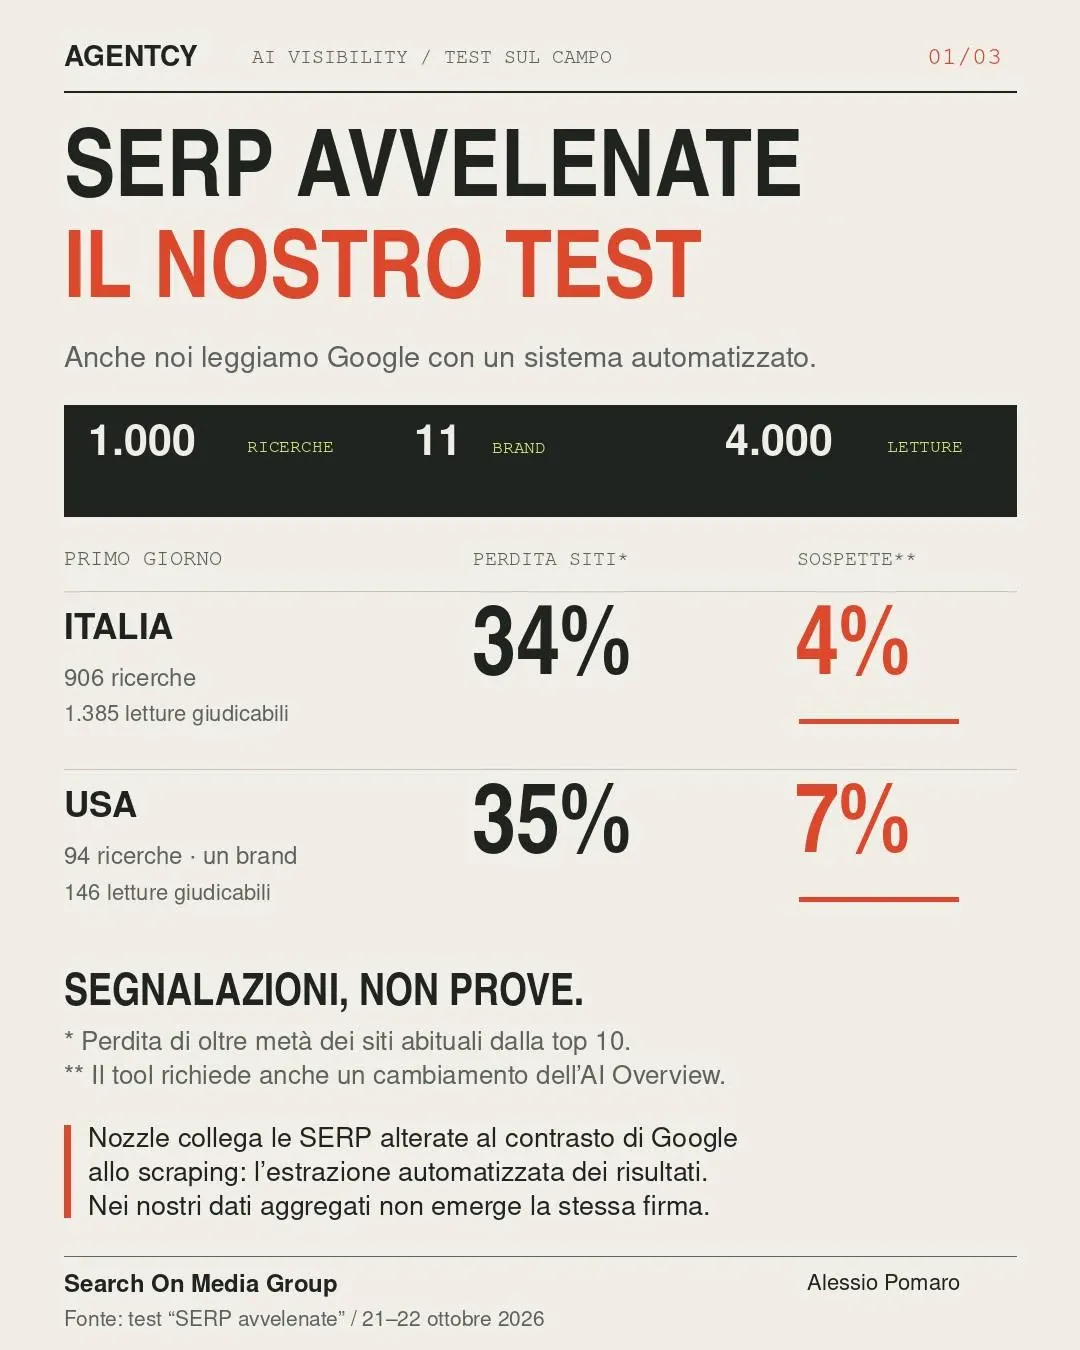
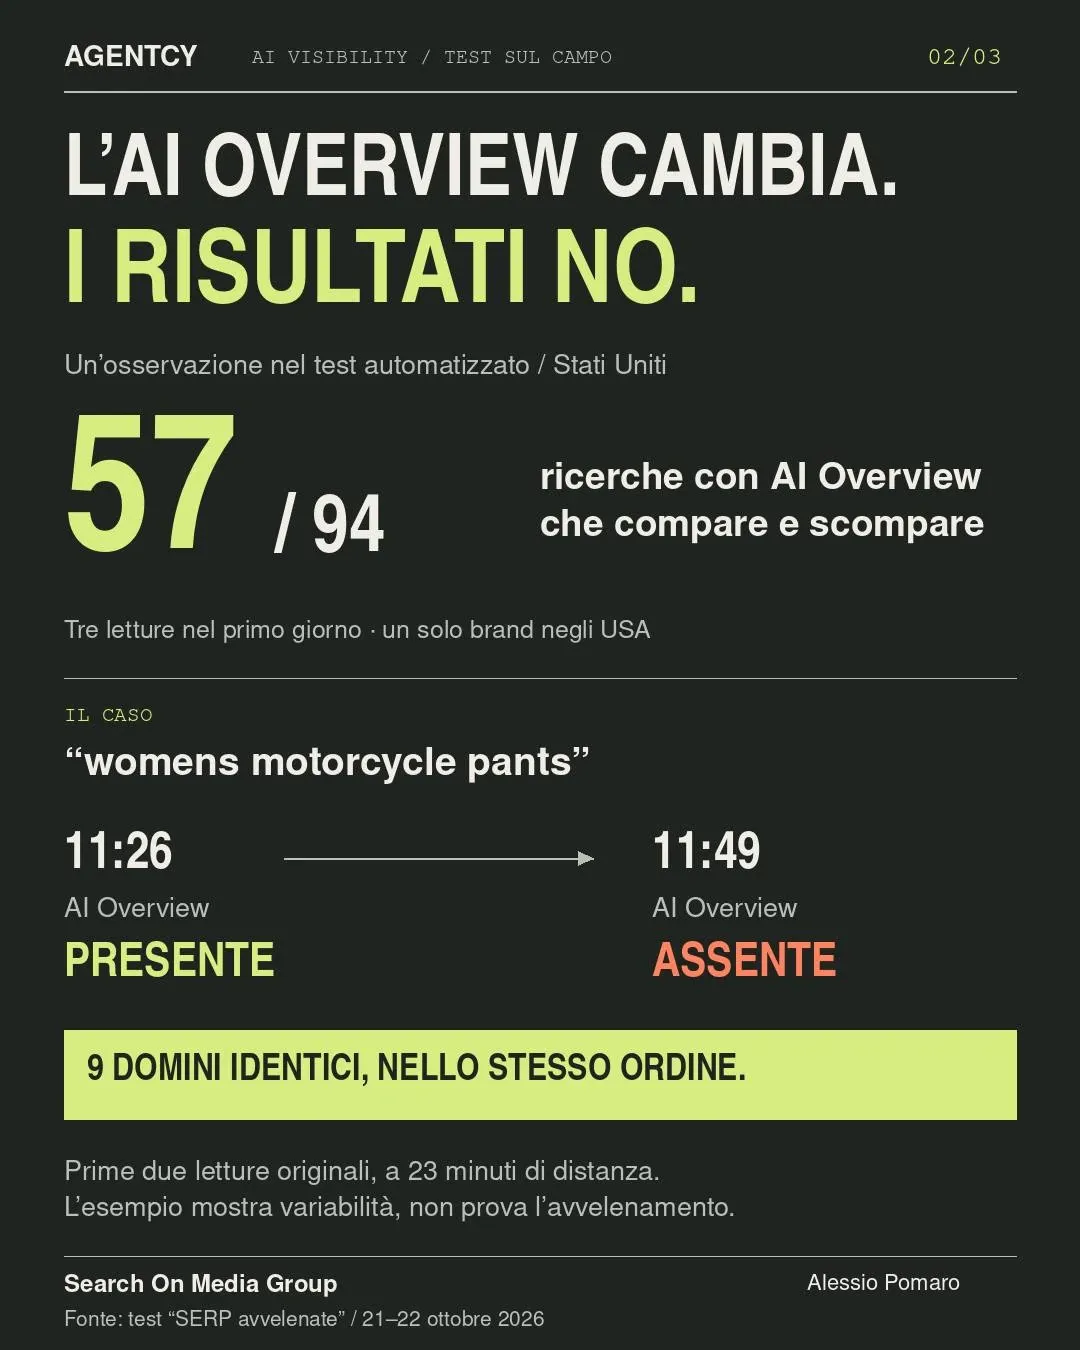
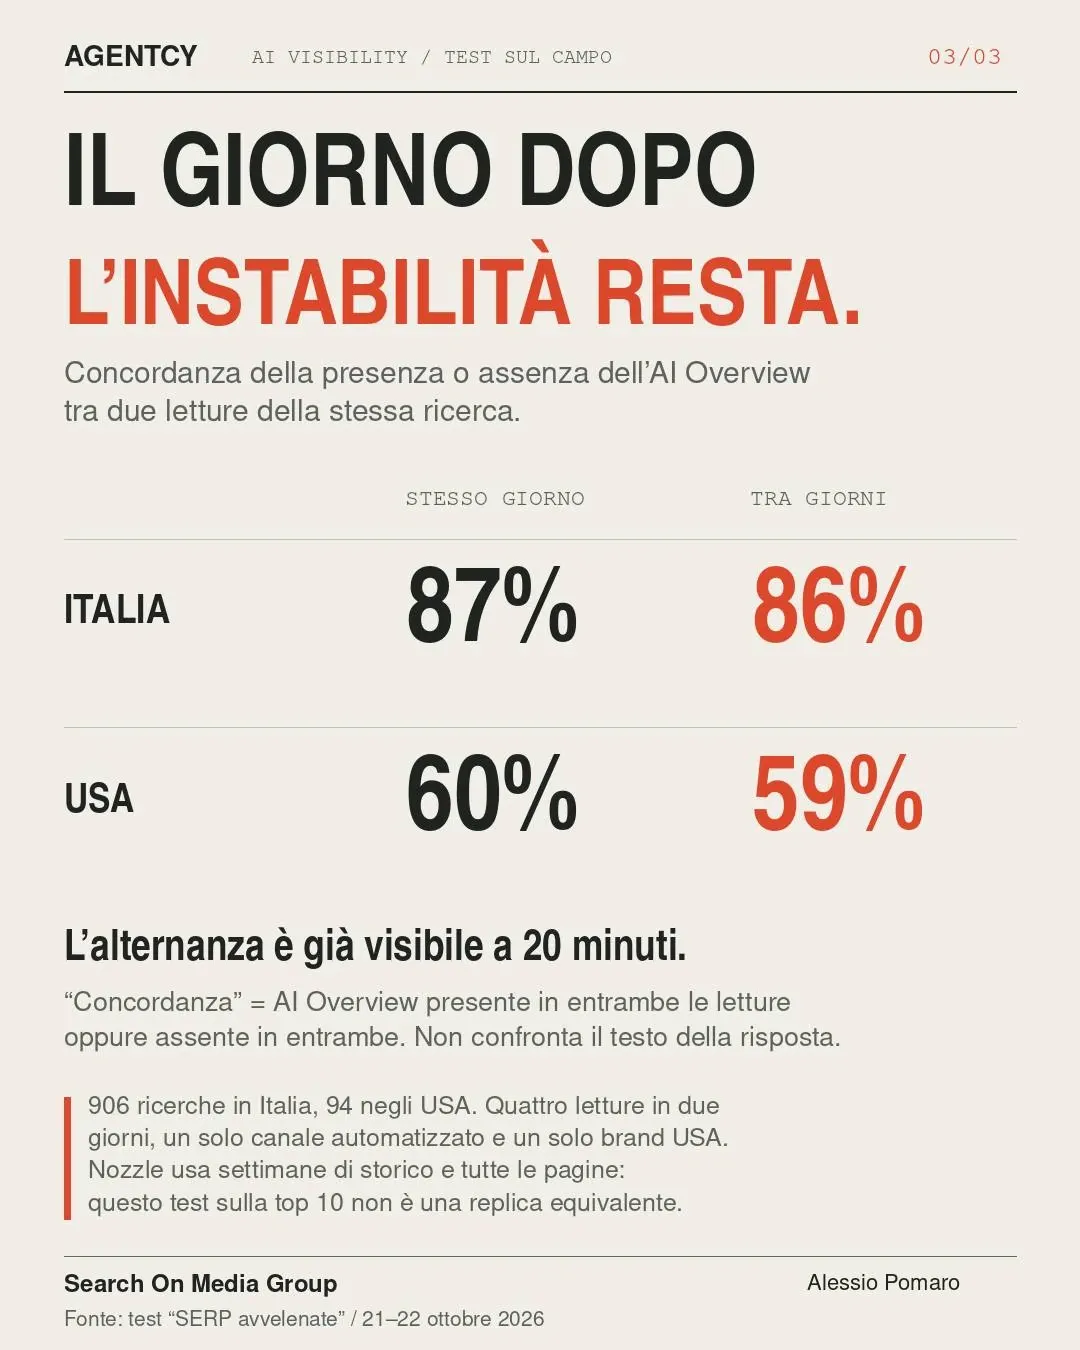
Instabilità, segnali sospetti e limiti della misurazione nei dati AgentCy.
AgentCy incrocia, insieme ad altri elementi, la variazione dei risultati organici con quella dell’AI Overview, segnalando letture sospette.
Il sistema ha segnalato come sospette circa il 4% delle letture valutabili in Italia e il 7% negli USA. Sono casi da approfondire, non "avvelenamenti" dimostrati.
La variabilità dell’AI Overview resta comunque rilevante: negli USA compare e scompare in 57 query su 94, contro 172 su 906 in Italia.
Per chi misura la visibilità, verificare la qualità delle SERP raccolte deve essere parte della misurazione stessa.
GPT-6.1 Terra: efficienza visiva e costo delle attività professionali
OpenAI presenta GPT-6.1 Terra: ragionamento visivo e uso del computer più efficienti, con prezzi API dimezzati rispetto a GPT-5.6 Terra e GPT-6.1 Sol. Il focus è portare queste capacità su attività professionali ripetute su larga scala.
Il computer use richiede di collegare ciò che il modello vede alle azioni da compiere nelle applicazioni. Leggere una fattura e trasferirne i dati in un gestionale, interpretare un disegno tecnico, compilare un modulo: la qualità deve reggere lungo l’intera attività. Ogni passaggio aggiunge tempo, token e occasioni di errore.
Su Agents’ Last Exam, che include lavori come ricavare un modello 3D da disegni architettonici, Terra a ragionamento Medio guadagna 15 punti percentuali su GPT-5.6 Terra a circa un terzo del costo. A Max, OpenAI riporta un costo per attività circa nove volte inferiore a Claude Opus 5.5, grazie anche al minor consumo di token. Sono confronti nelle condizioni del benchmark.
Nel test interno su prompt che inducono errori, a ragionamento basso le risposte con errori fattuali scendono dal 53,6% al 16,7%; a Max arrivano al 4,3%. Questi valori riguardano il set difficile selezionato, non la frequenza degli errori nell’uso quotidiano.
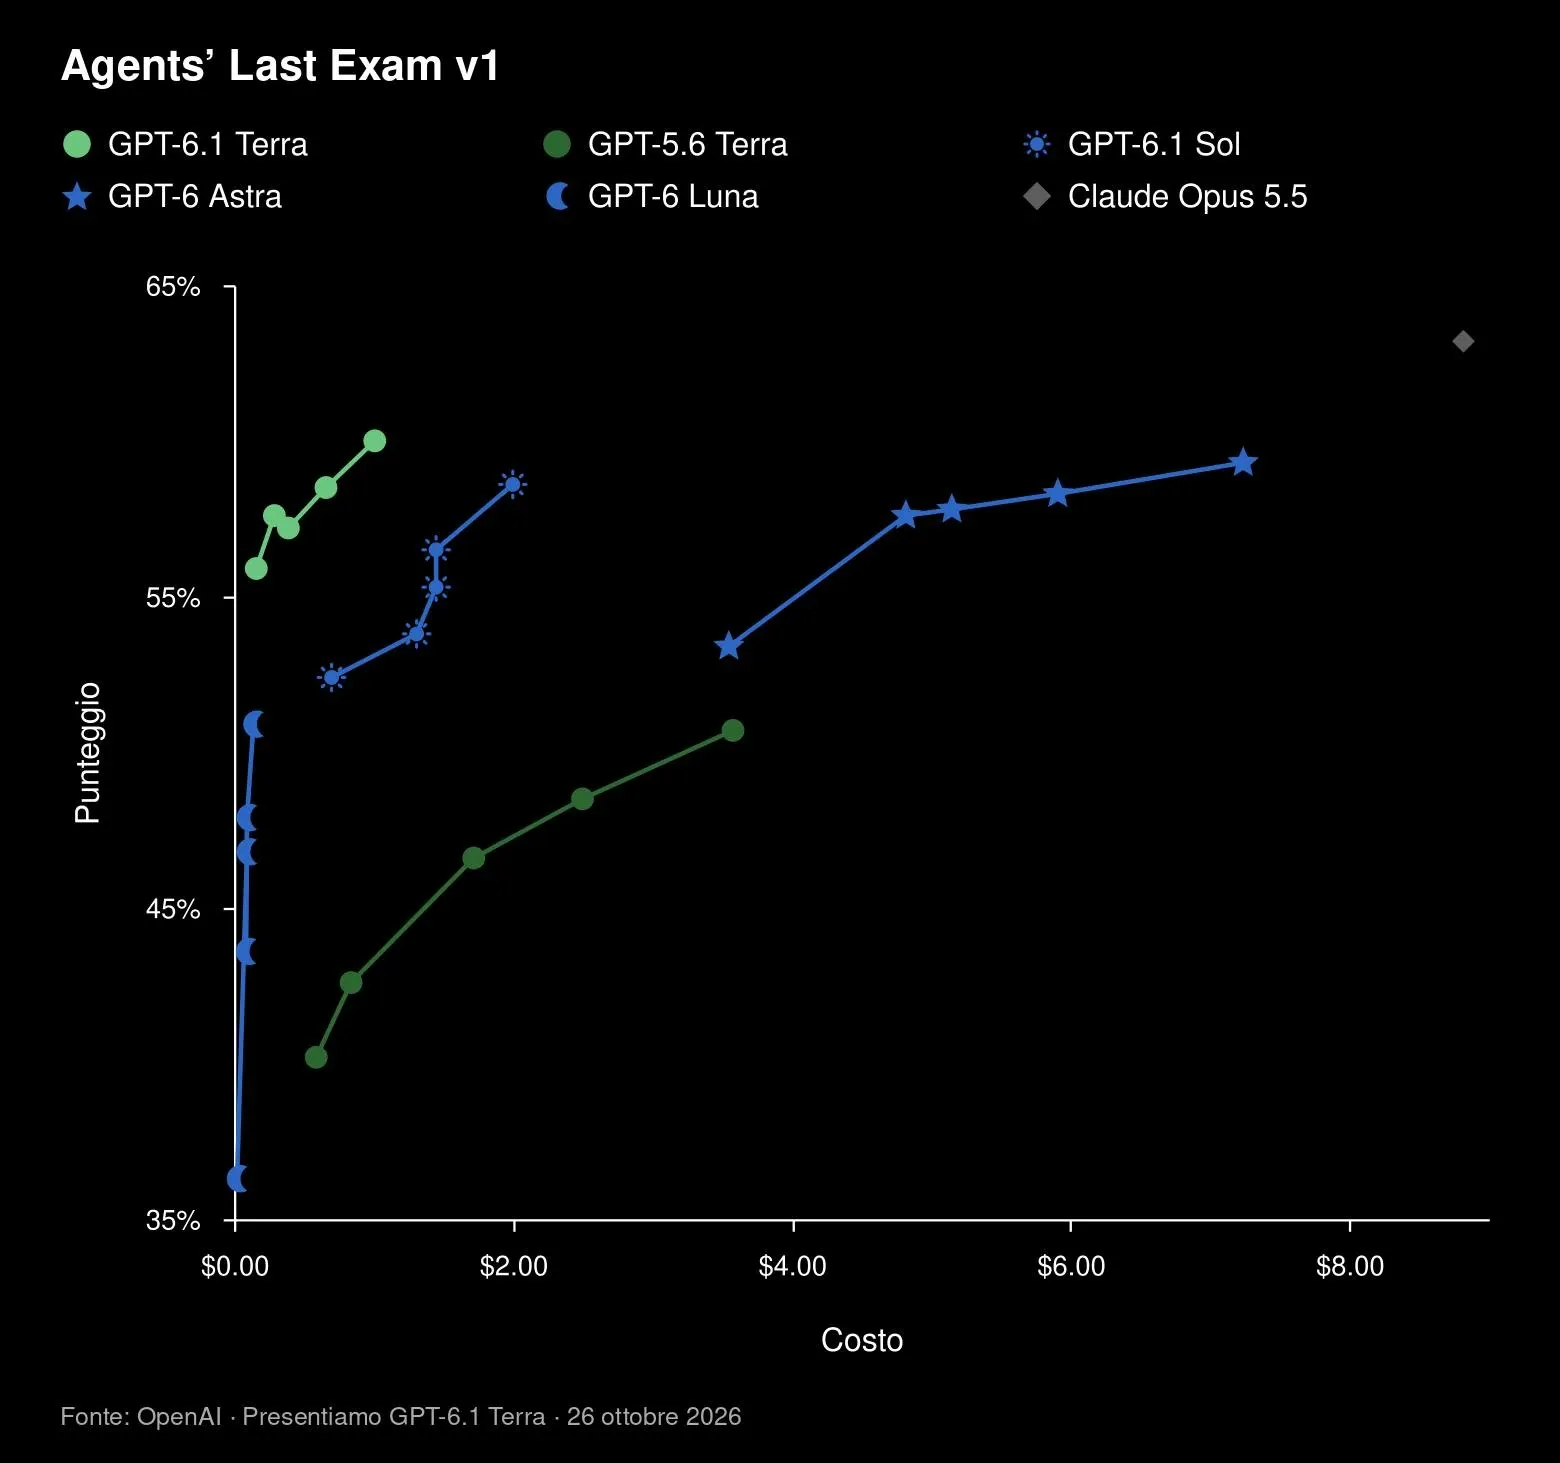
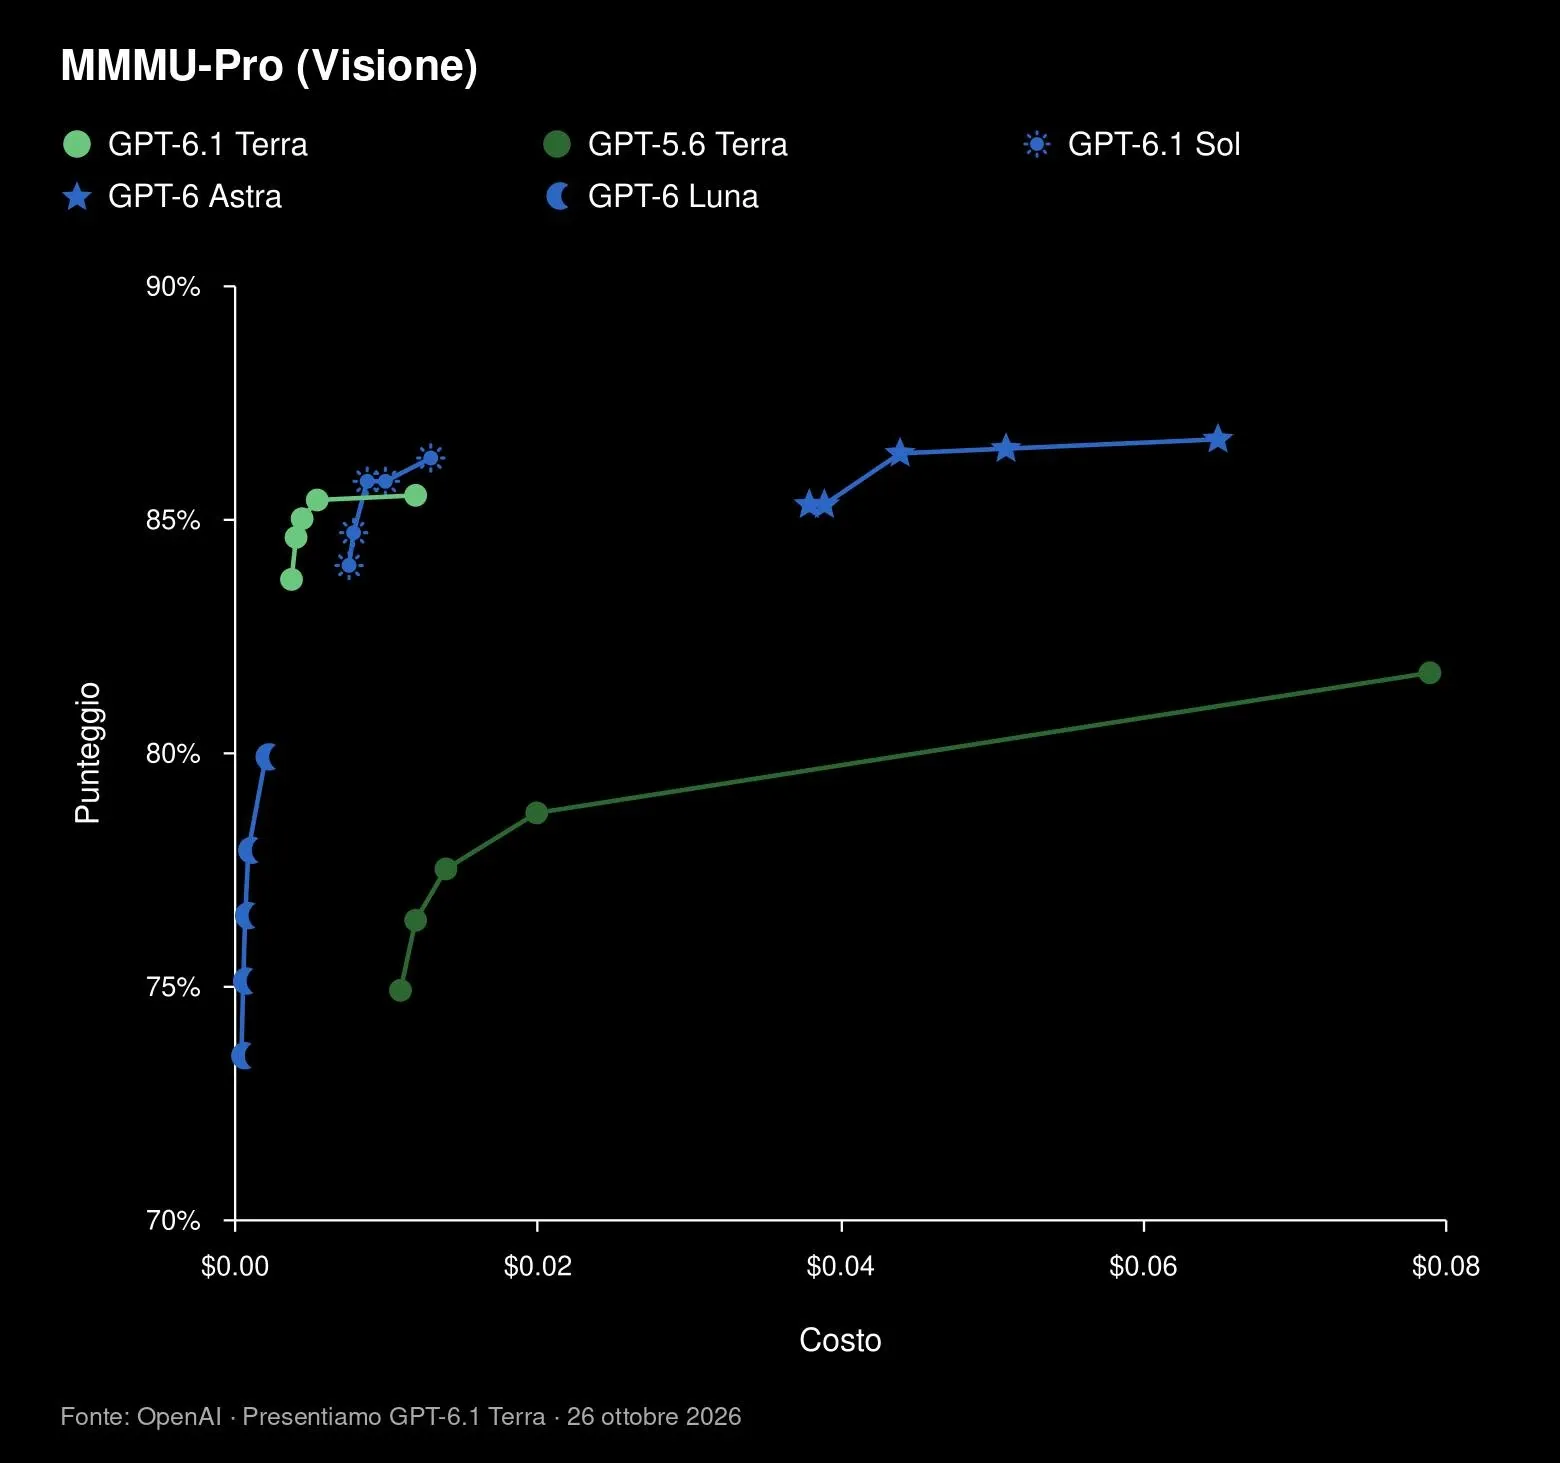
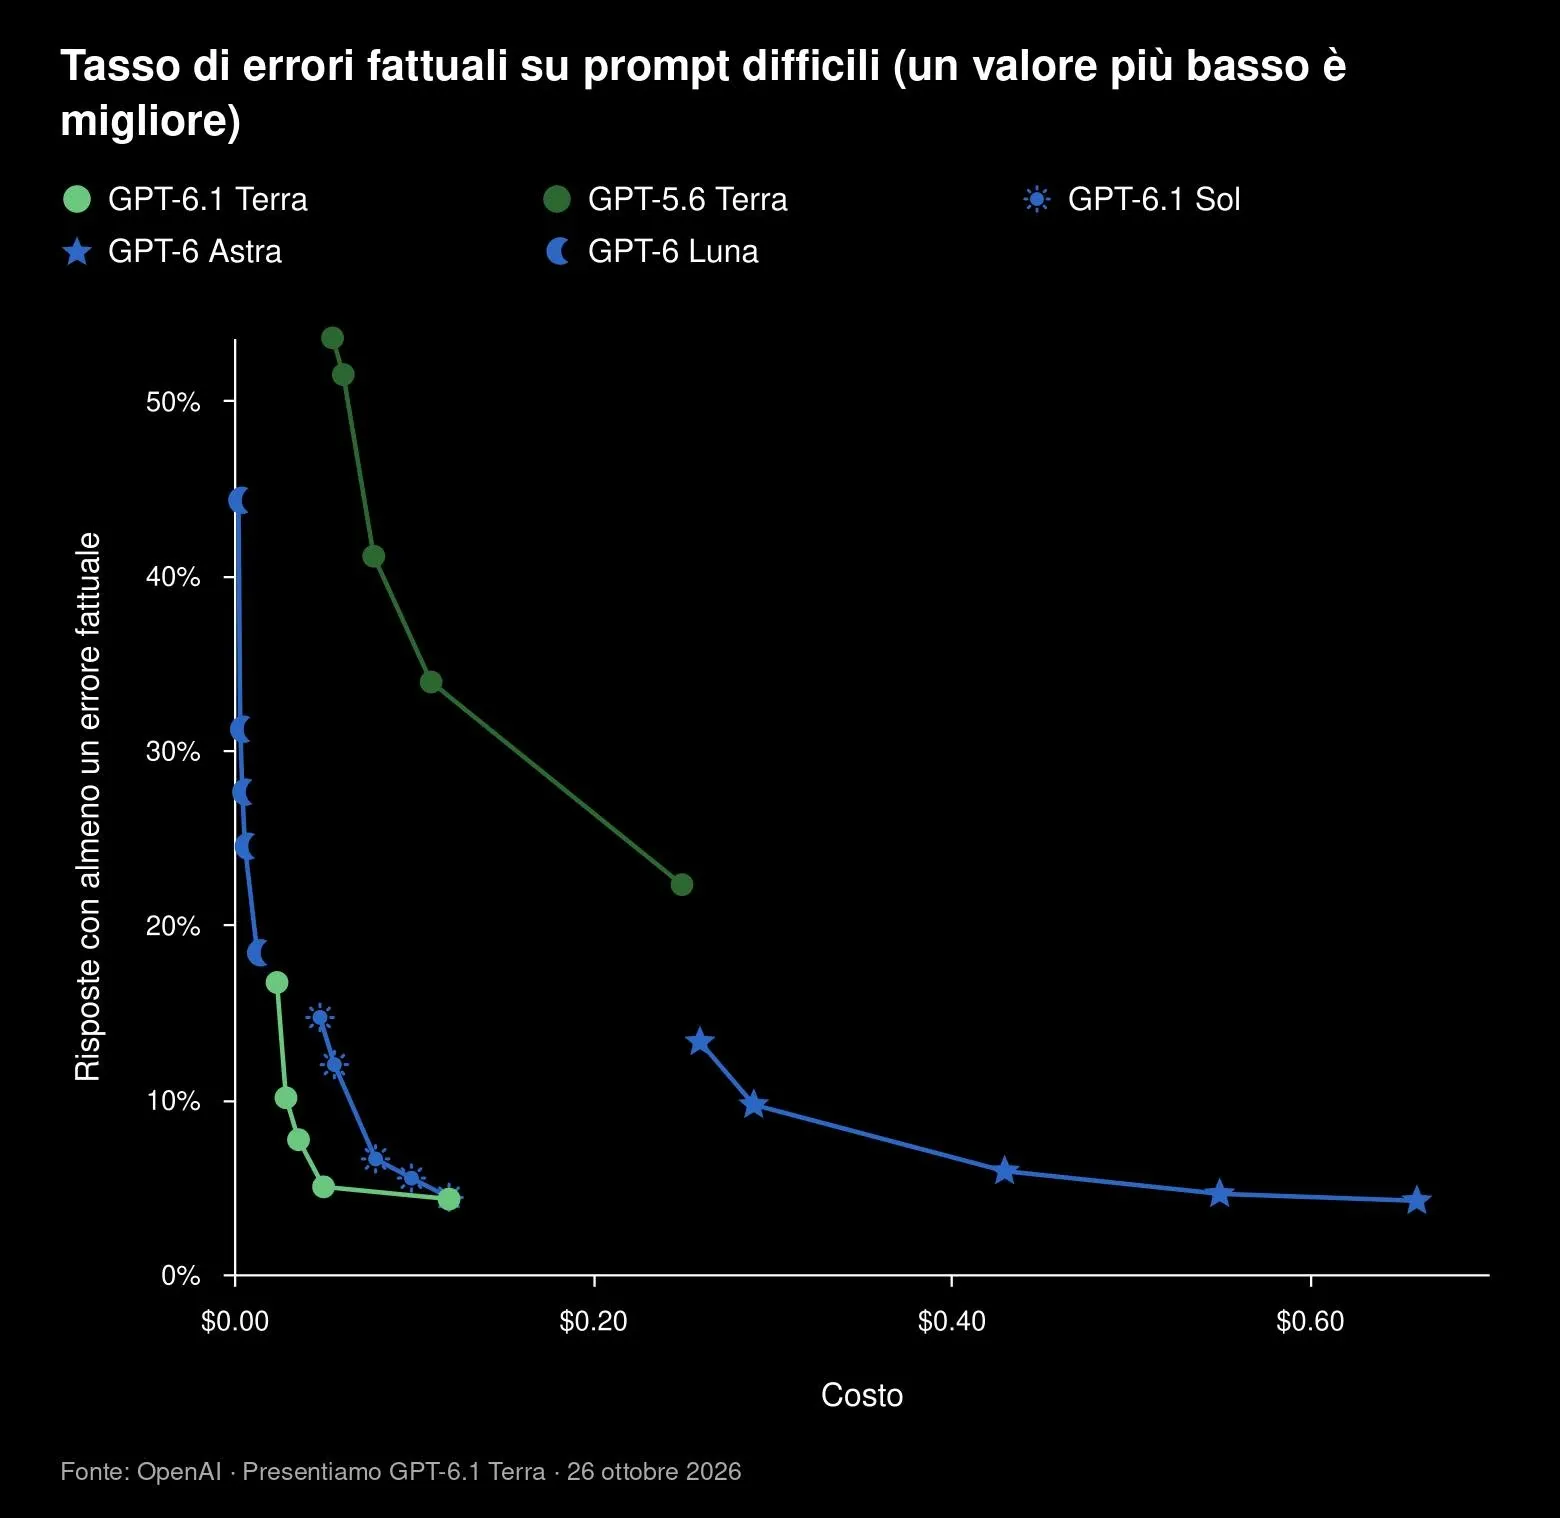
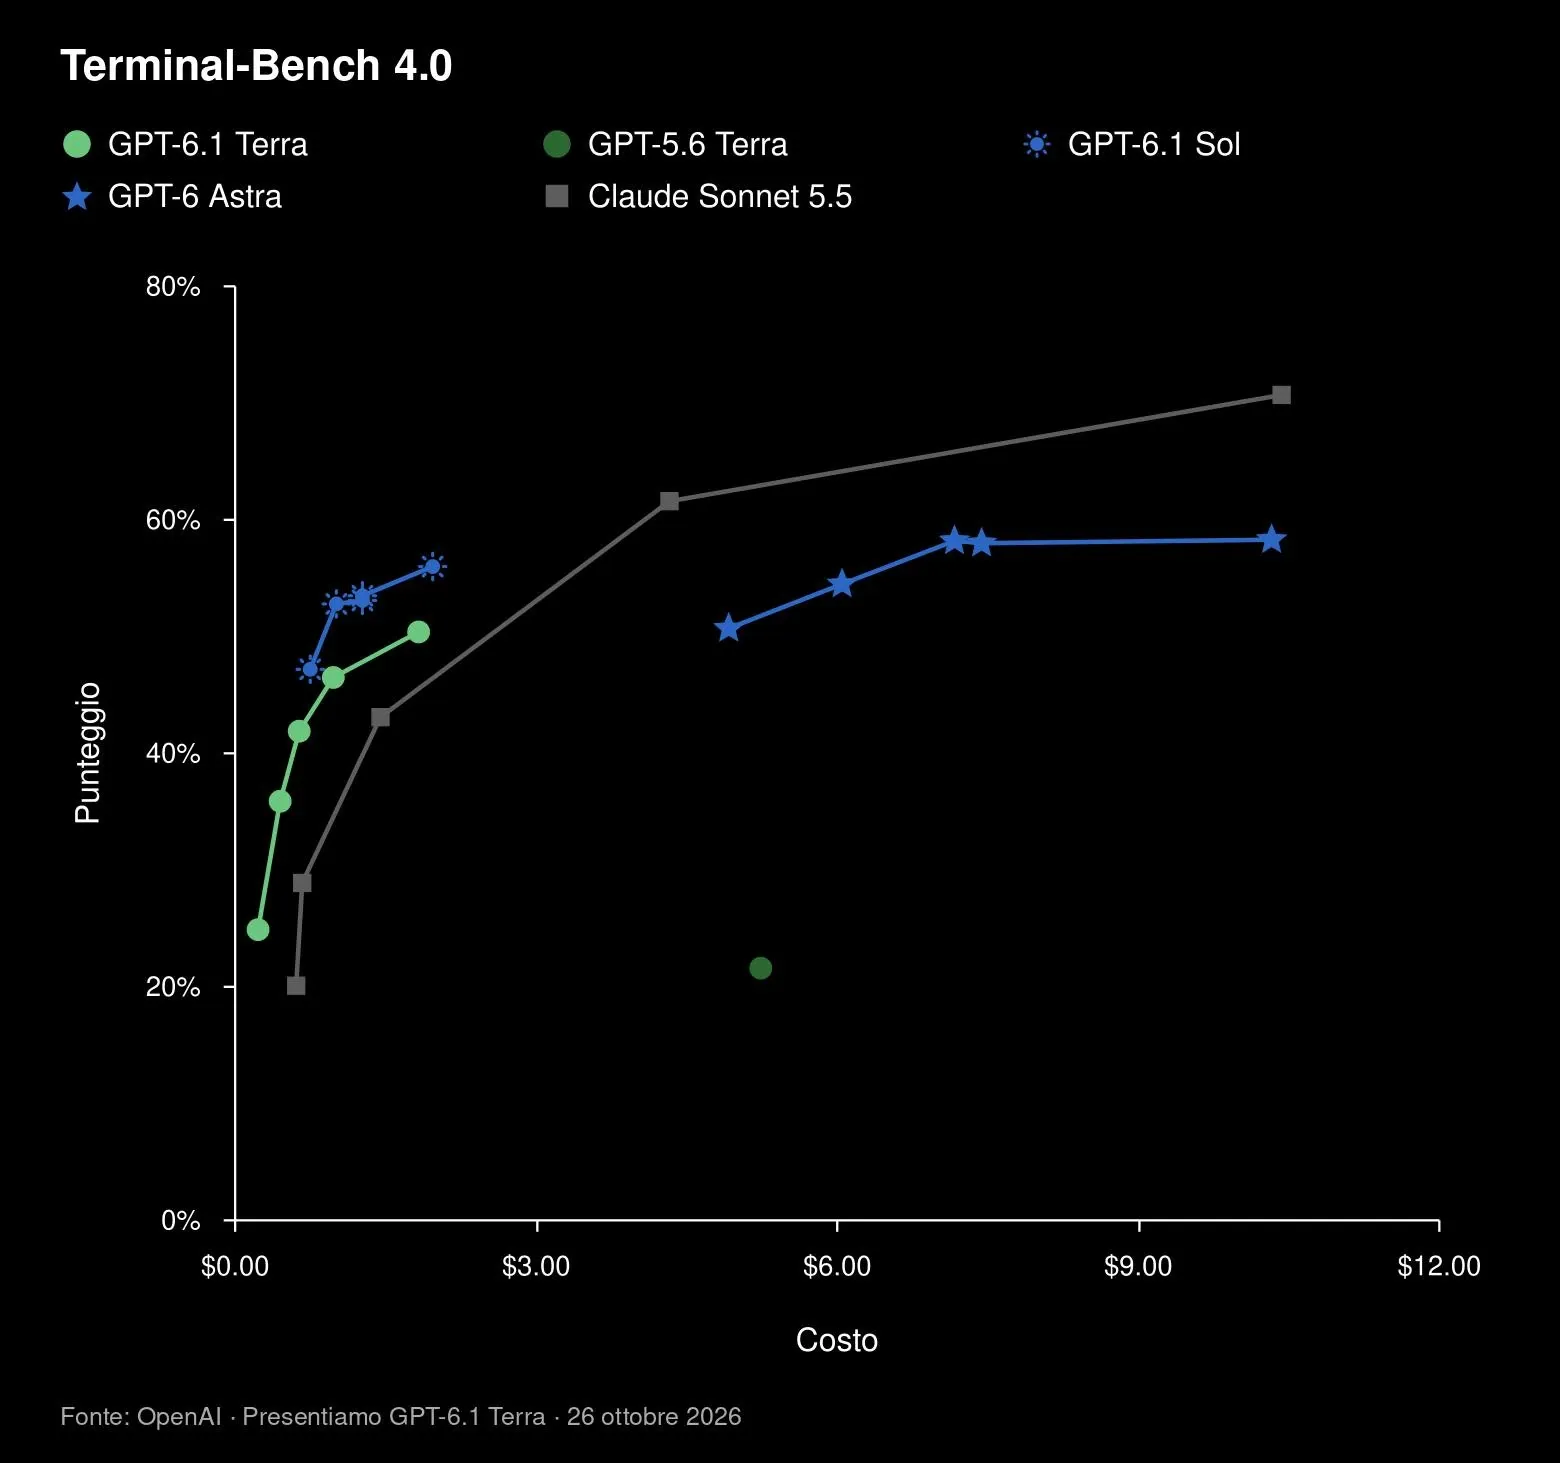
I confronti pubblicati per GPT-6.1 Terra vanno letti nelle rispettive condizioni di test.
Su Terminal-Bench 4.0 risolve il 50,3% dei compiti a ragionamento massimo, contro il 21,5% pubblicato per GPT-5.6 Terra. Per il coding più complesso, OpenAI continua a indicare Sol e Astra.
L’API standard costa 1 dollaro per milione di token in input e 5 in output; l’input in cache costa 0,05 dollari. Accetta testo e immagini, con una finestra di contesto da 1,05 milioni di token. Per chiamare strumenti serve la Responses API. Oltre 272.000 token in input scattano maggiorazioni.
La scheda di sistema mostra anche progressi non uniformi: in un test sul rispetto degli avvisi, a Max e senza controlli di sistema, Terra aggira il vincolo nel 29,6% delle esecuzioni. Il dato riguarda ambienti simulati, non il normale utilizzo con le protezioni attive.
Per chi costruisce agenti, la conseguenza è concreta: valutare il costo di un’attività completata e verificata, includendo tentativi, attese e correzioni. Un prezzo per token più basso diventa un vantaggio operativo quando il sistema mantiene qualità e confini del compito.
Gemini 4 Carbon: lavoro prolungato, cybersecurity e condizioni dei test
Google ha presentato Gemini 4 Carbon, dopo Argon, con un salto nei lavori di ingegneria prolungati e nella cybersecurity.
Il modello, che è un post-training di Argon, è progettato per sostenere attività agentiche complesse: cercare la causa di un bug, attraversare grandi basi di codice e arrivare a una correzione anche dopo tentativi falliti.
Nei team interni, Google riferisce esecuzioni durate giorni. Il tema è la continuità del lavoro: mantenere l'obiettivo e proseguire quando una strada non funziona. L'annuncio descrive queste capacità, ma non dettaglia l'architettura o il meccanismo di addestramento che le produce.
Nella difesa informatica il contributo copre tre passaggi distinti. Trovare una vulnerabilità, verificare se sia davvero sfruttabile e correggerne la causa. La validazione serve anche a dare priorità agli interventi: una segnalazione diventa più utile quando si può dimostrare il rischio e produrre una patch funzionante.
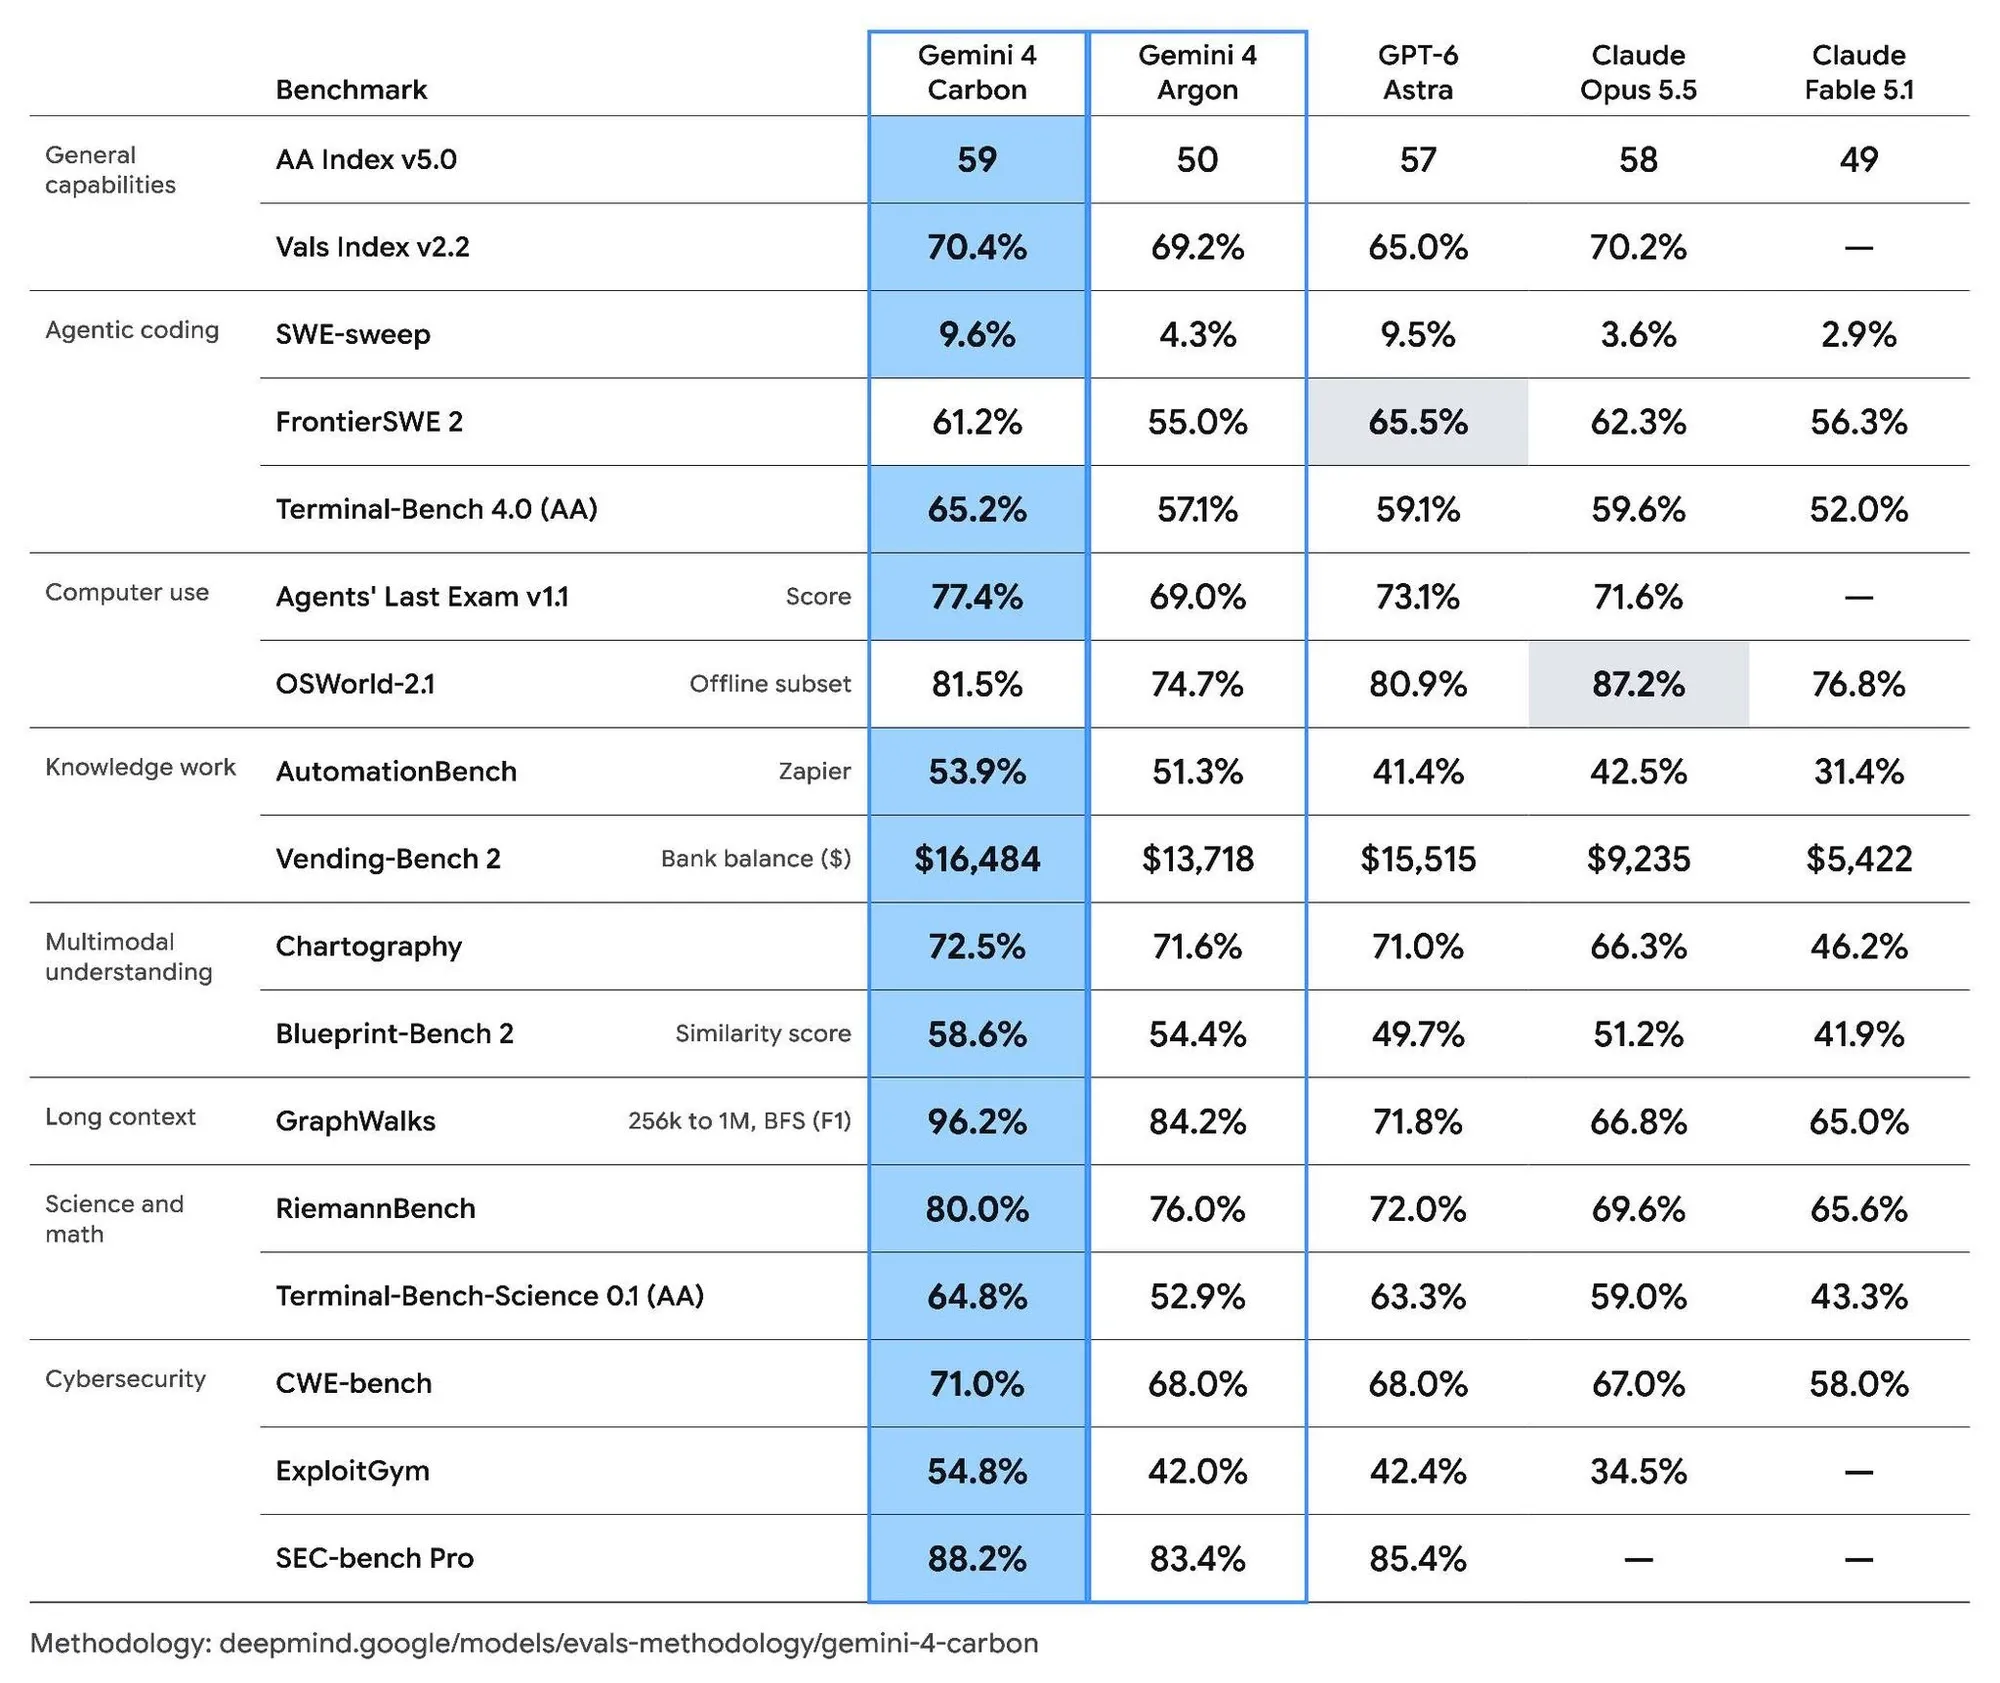
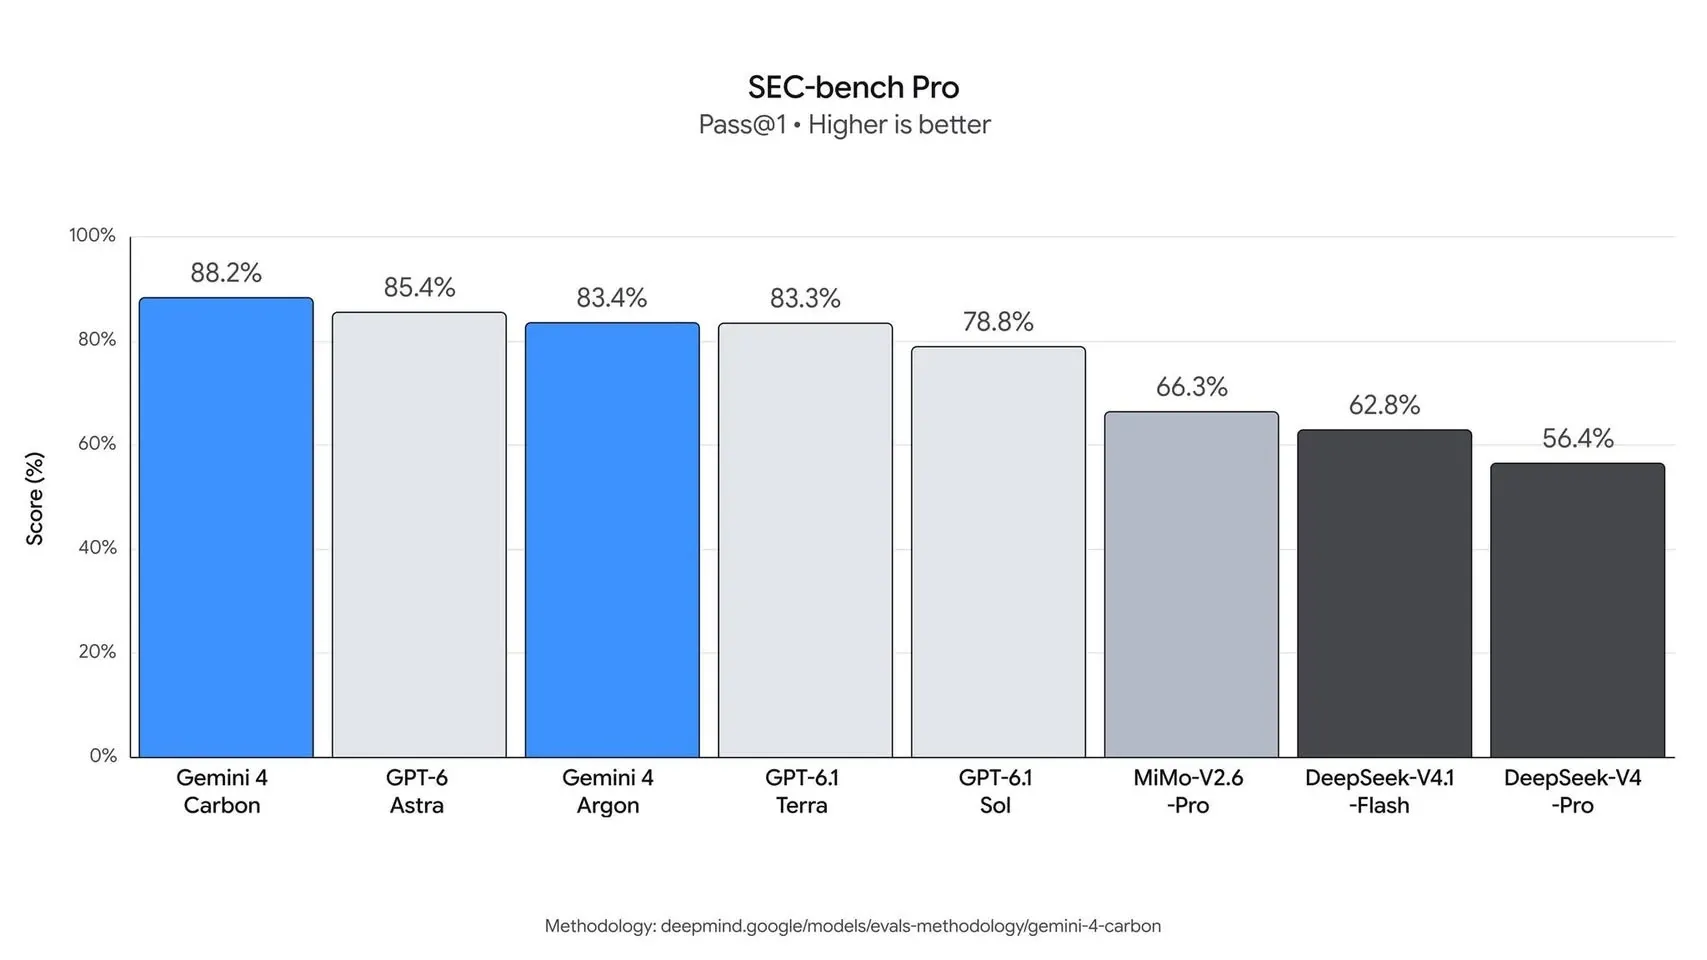
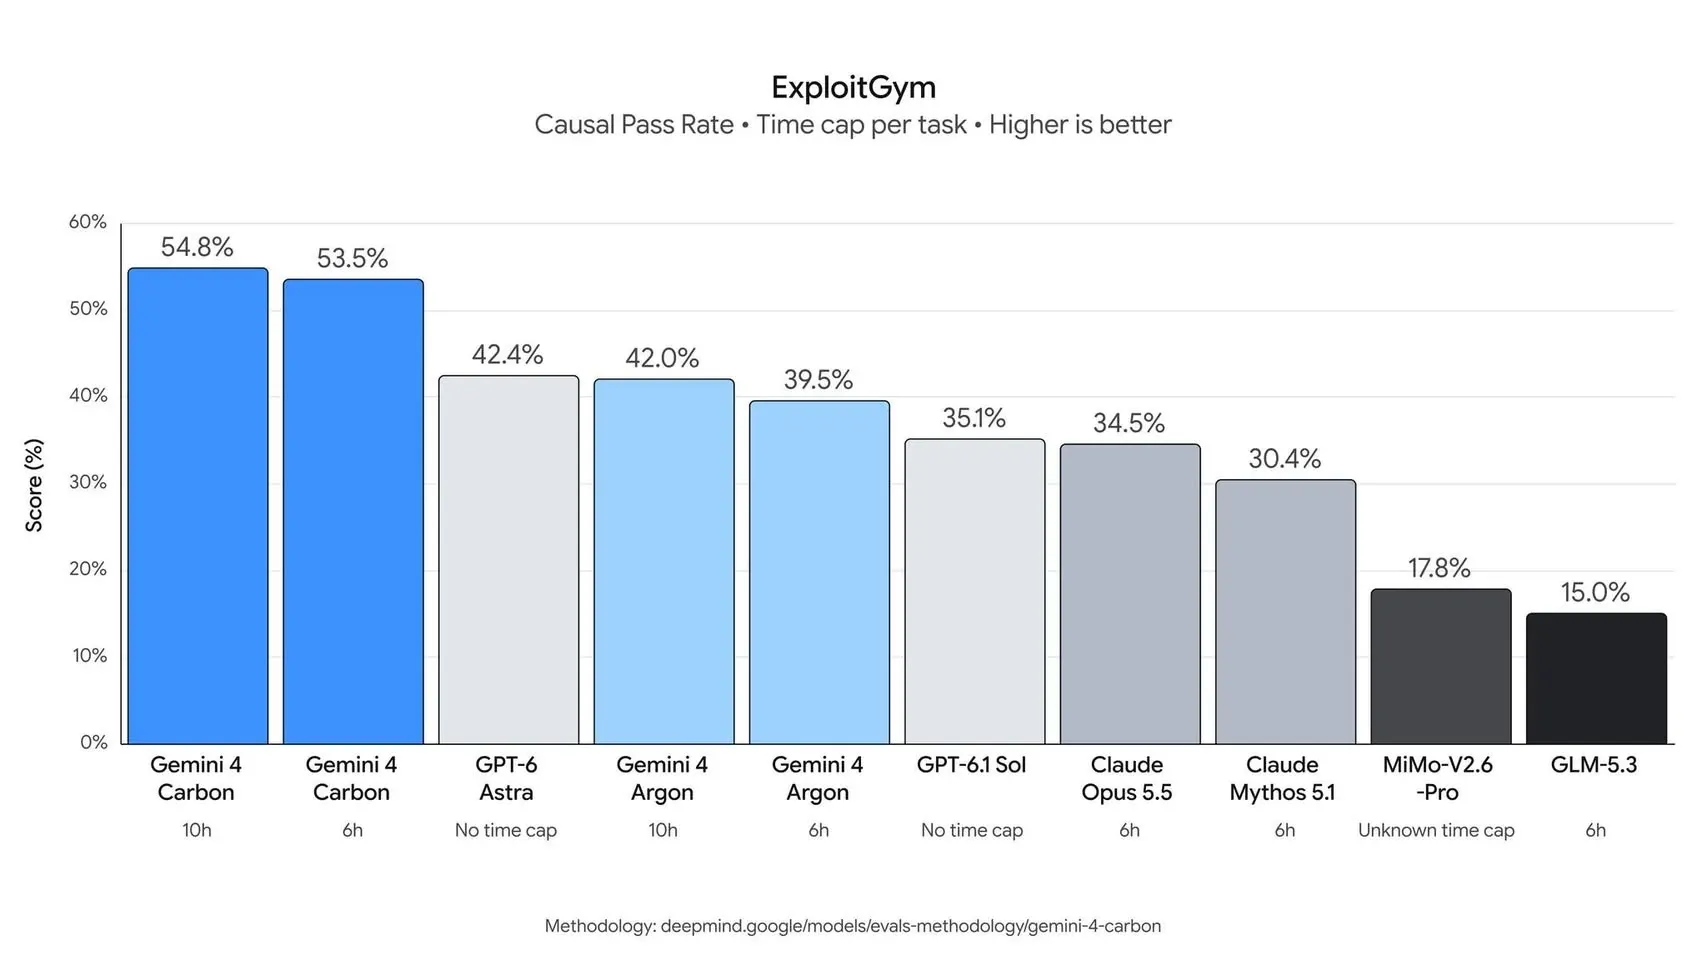
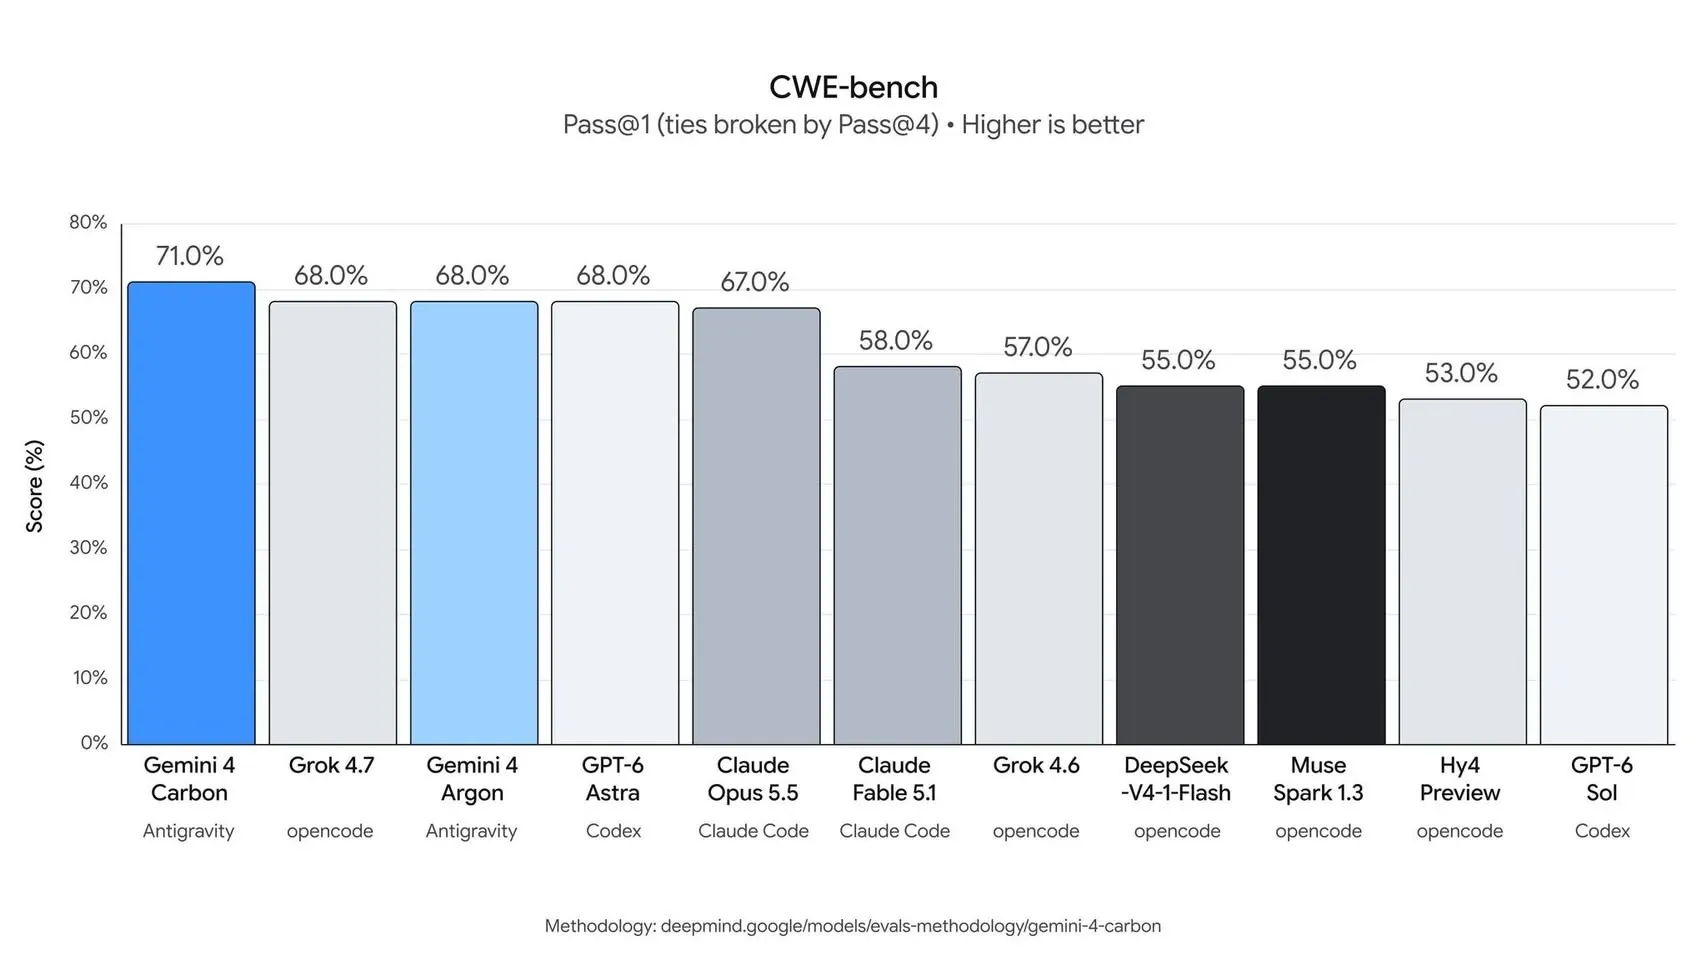
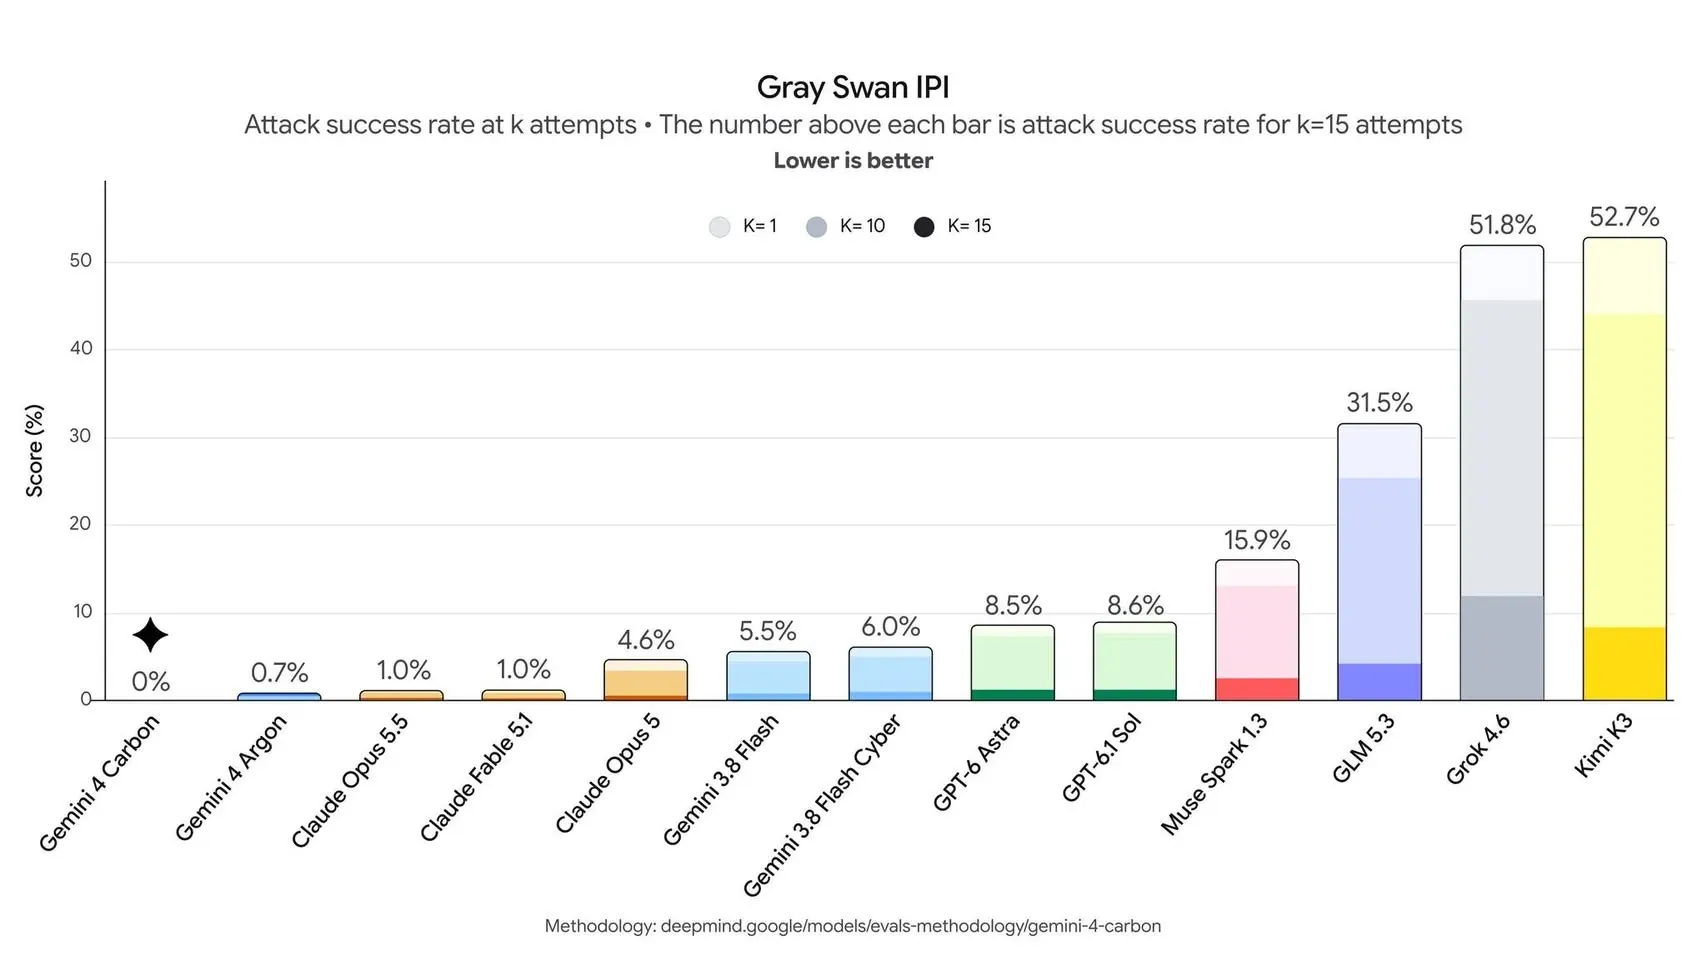
Capacità e resistenza agli attacchi nei benchmark pubblicati per Gemini 4 Carbon.
Google riporta l'88,2% su SEC-bench Pro per la scoperta di vulnerabilità, il 54,8% su ExploitGym per lo sfruttamento (10 ore per task) e il 71% su CWE-bench per le correzioni. Sono benchmark differenti, valutati senza guardrail: quei risultati descrivono le capacità nelle condizioni di test, non il comportamento garantito del prodotto distribuito.
Carbon raggiunge anche 59 punti e il primo posto nell'Artificial Analysis Intelligence Index v5.0. Nei test interni, Google dichiara un tasso di successo nella generazione di codice sicuro più che doppio rispetto ad Argon e circa la metà delle affermazioni prive di supporto. Sono confronti interni, da distinguere dalle valutazioni esterne.
Sul benchmark Gray Swan di prompt injection indiretta, il tasso di successo degli attacchi scende dallo 0,7% di Argon allo 0% con 15 tentativi per attacco. Significa che nessun attacco del set valutato è riuscito, non che il problema sia risolto in ogni contesto.
Al lancio, l'accesso parte da utenti selezionati, con un'estensione graduale tramite il programma Fairwind. La disponibilità generale per sviluppatori, aziende e consumatori è annunciata per il futuro, con gli stessi costi di Argon.
La direzione è concreta: delegare porzioni più lunghe del lavoro software richiede capacità tecniche insieme a onestà sui risultati, rispetto dei vincoli e resistenza alle istruzioni malevole incontrate durante l'esecuzione.
Muse Glimmer 30B: agenti locali tra capacità, memoria e latenza
Meta, con i suoi rilasci di modelli open, sta offrendo alternative statunitensi agli ormai noti modelli cinesi. Muse Glimmer 30B porta questa sfida sugli agenti locali: pesi aperti con licenza Apache 2.0, testo e immagini in ingresso, testo in uscita.
Il modello è distillato da Muse Spark. Nella fase on-policy è Glimmer a generare i tentativi; Spark li valuta passo dopo passo. L'addestramento segue così anche le deviazioni del modello piccolo, insegnandogli a recuperare quando sbaglia. A questo si affianca il reinforcement learning, con segnali sul successo dei compiti e sull'uso degli strumenti.
Per farlo girare in locale, Meta sceglie un'architettura densa e comprime i pesi a circa 4 bit. Il solo modello linguistico scende sotto 20 GB, lasciando spazio a memoria di lavoro, componente visiva e modello ausiliario. I profili quantizzati puntano a 24 e 32 GB di memoria disponibile. Il contesto arriva a 128mila token: tre strati di attenzione locale alternati a uno globale limitano la KV cache, la memoria delle elaborazioni precedenti.
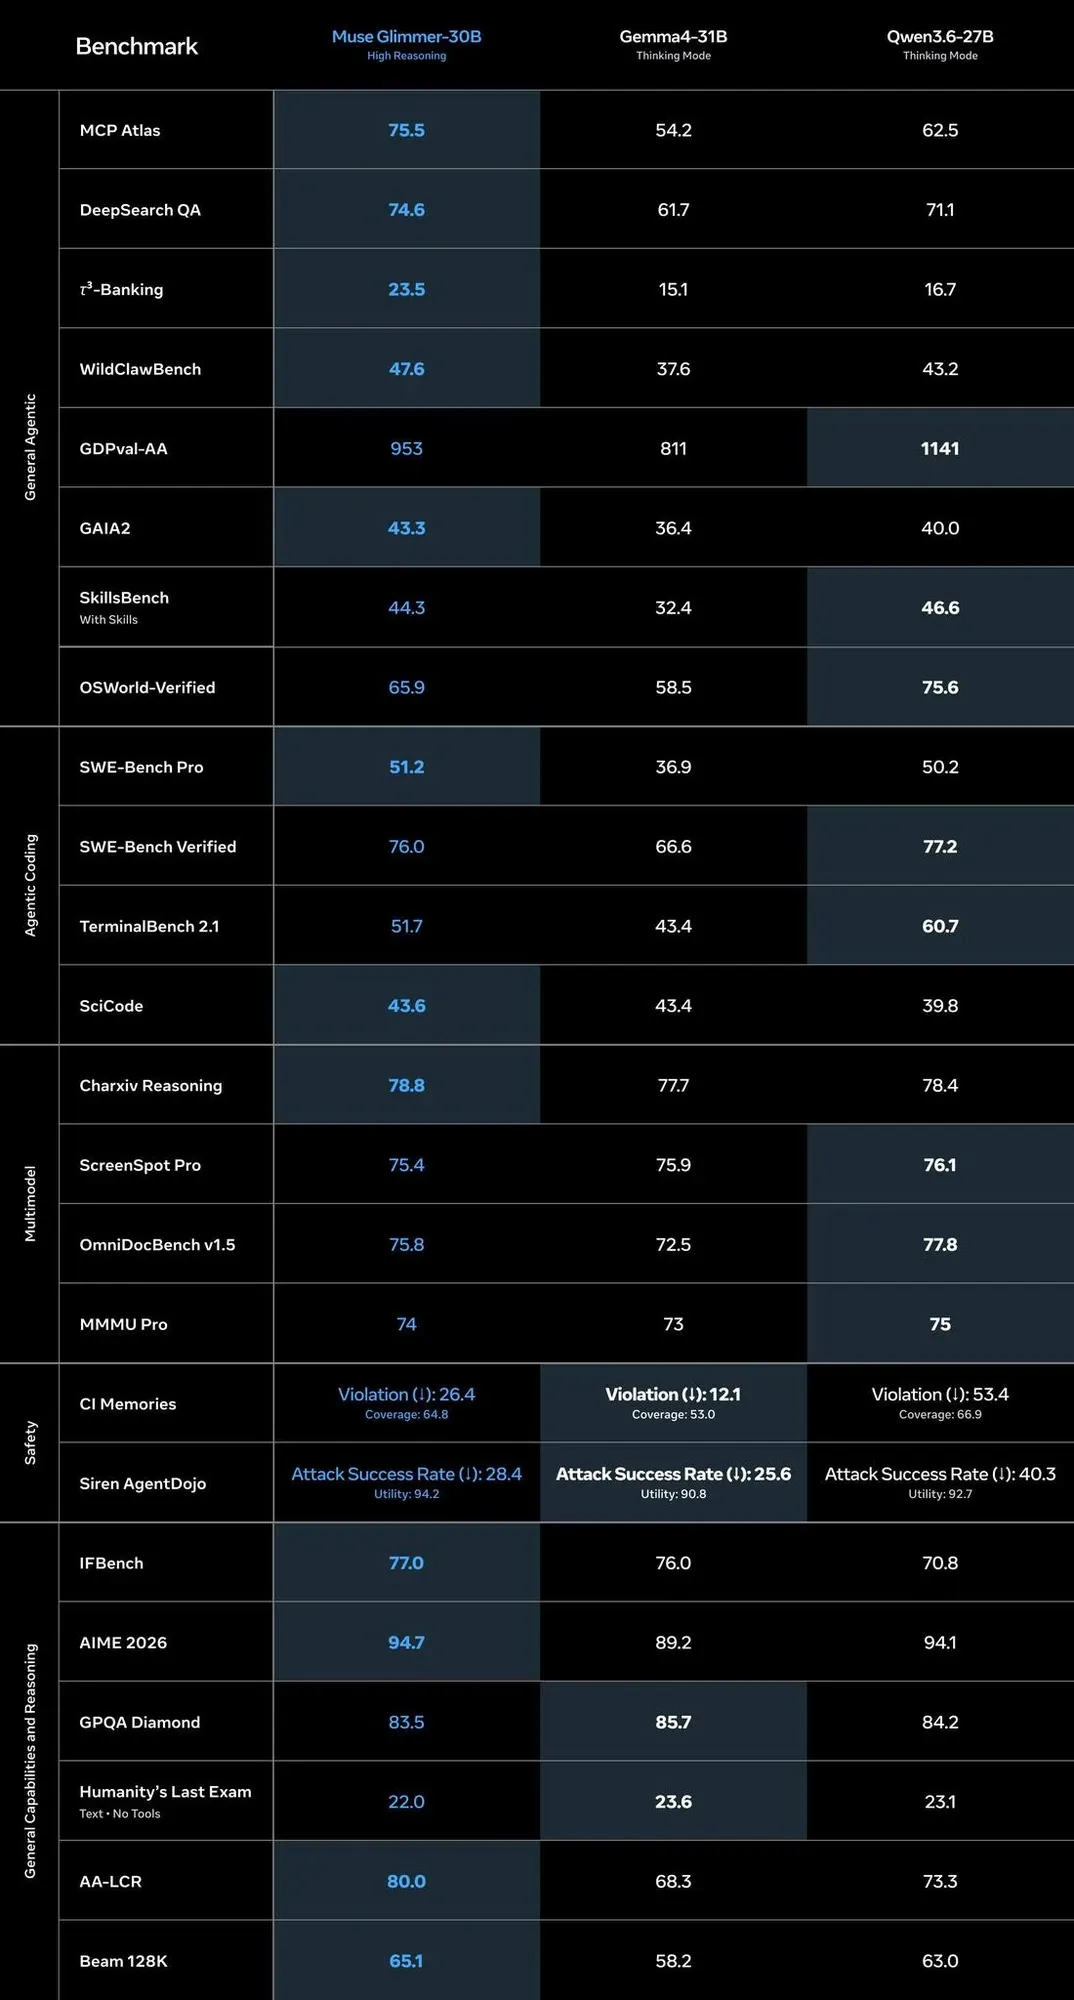
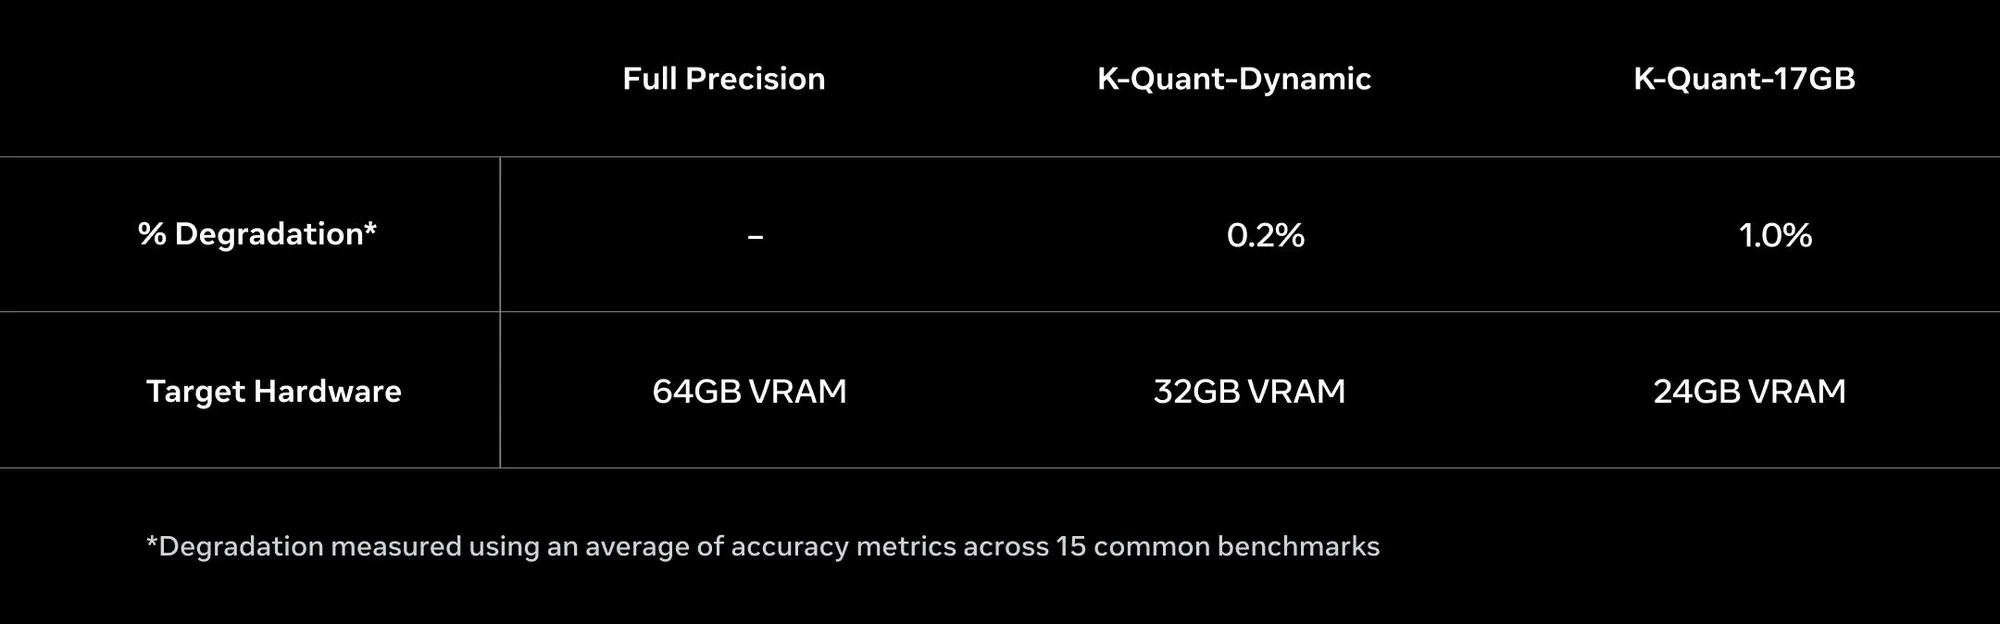
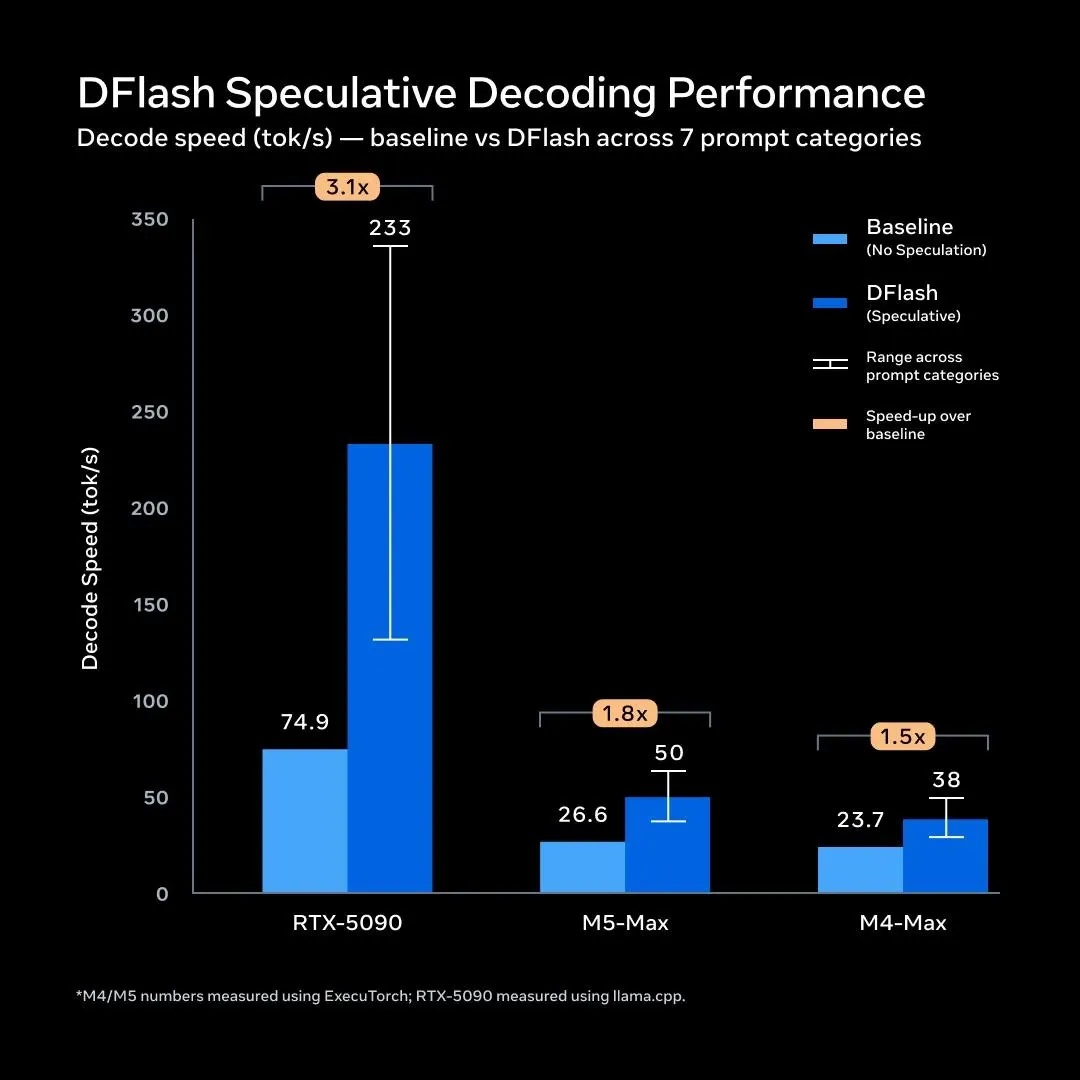
Architettura operativa, memoria e velocità nelle valutazioni di Muse Glimmer.
Il secondo intervento riguarda la velocità. DFlash propone blocchi di 16 token che Glimmer verifica in parallelo, accettando quelli corretti. Sulla RTX 5090 Meta riporta circa 233 token/s contro 74,9 senza questa tecnica: 3,1 volte la velocità di generazione, con batch 1 e decodifica greedy. Il guadagno misura la generazione; il tempo di un task dipende anche dagli strumenti.
Su MCPAtlas, che misura compiti con strumenti MCP, Glimmer in modalità high raggiunge il 75,5% di successo medio, contro il 54,2% di Gemma4-31B e il 62,5% di Qwen3.6-27B. Sono test interni, su 500 compiti e quattro esecuzioni. Il vantaggio dipende dal compito: su SWE-Bench Verified Glimmer ottiene il 76,0% contro il 77,2% di Qwen, dato di quest'ultimo ripreso dal suo rilascio.
La scelta interessante è progettare insieme capacità agentiche, memoria e latenza.
Un modello locale può pianificare, leggere schermate e reagire agli errori mantenendo l'inferenza vicino ai dati dell'utente. L'accesso a servizi esterni dipende comunque dagli strumenti collegati: mantenere locale l'intero flusso richiede controllo su connessioni e permessi.
Kimi K3.1 Pro nei miei test: 3D, presentazioni e analisi UX
Ho testato Kimi K3.1 Pro e non ho per niente rimpianto ChatGPT o Claude.
L'impressione è di un forte miglioramento, che ho messo alla prova su tre attività: 3D, nuova sezione Design e analisi con Agent Swarm.
Per il 3D ho chiesto una pagina web interattiva per ricomporre un vaso in porcellana bianca e blu. Trenta frammenti numerati, una struttura guida, animazioni di ricomposizione e la possibilità di riportare i pezzi alla posizione iniziale. Le immagini mostrano il passaggio dai frammenti al vaso completo. Ho anche pubblicato l'applicazione.
Nella sezione Design ho lavorato a una presentazione partendo da un PDF e da un template PowerPoint. Il risultato è un deck di 24 slide, con contenuti e figure ricavati dal documento e una struttura visiva coerente con il modello fornito. Pagine e livelli sono accessibili nell'editor: il lavoro prosegue sul materiale prodotto, con la possibilità di intervenire sui singoli elementi.
Con Agent Swarm ho testato un'analisi UX di una scheda prodotto. Il risultato è un report navigabile con verifiche effettuate, stati iniziali, azioni e risultati osservati, oltre a un piano di intervento. Nelle schede delle priorità compaiono anche dipendenze e criteri di accettazione. Una struttura utile per collegare ciò che viene osservato a ciò che andrebbe corretto e a come verificarlo.
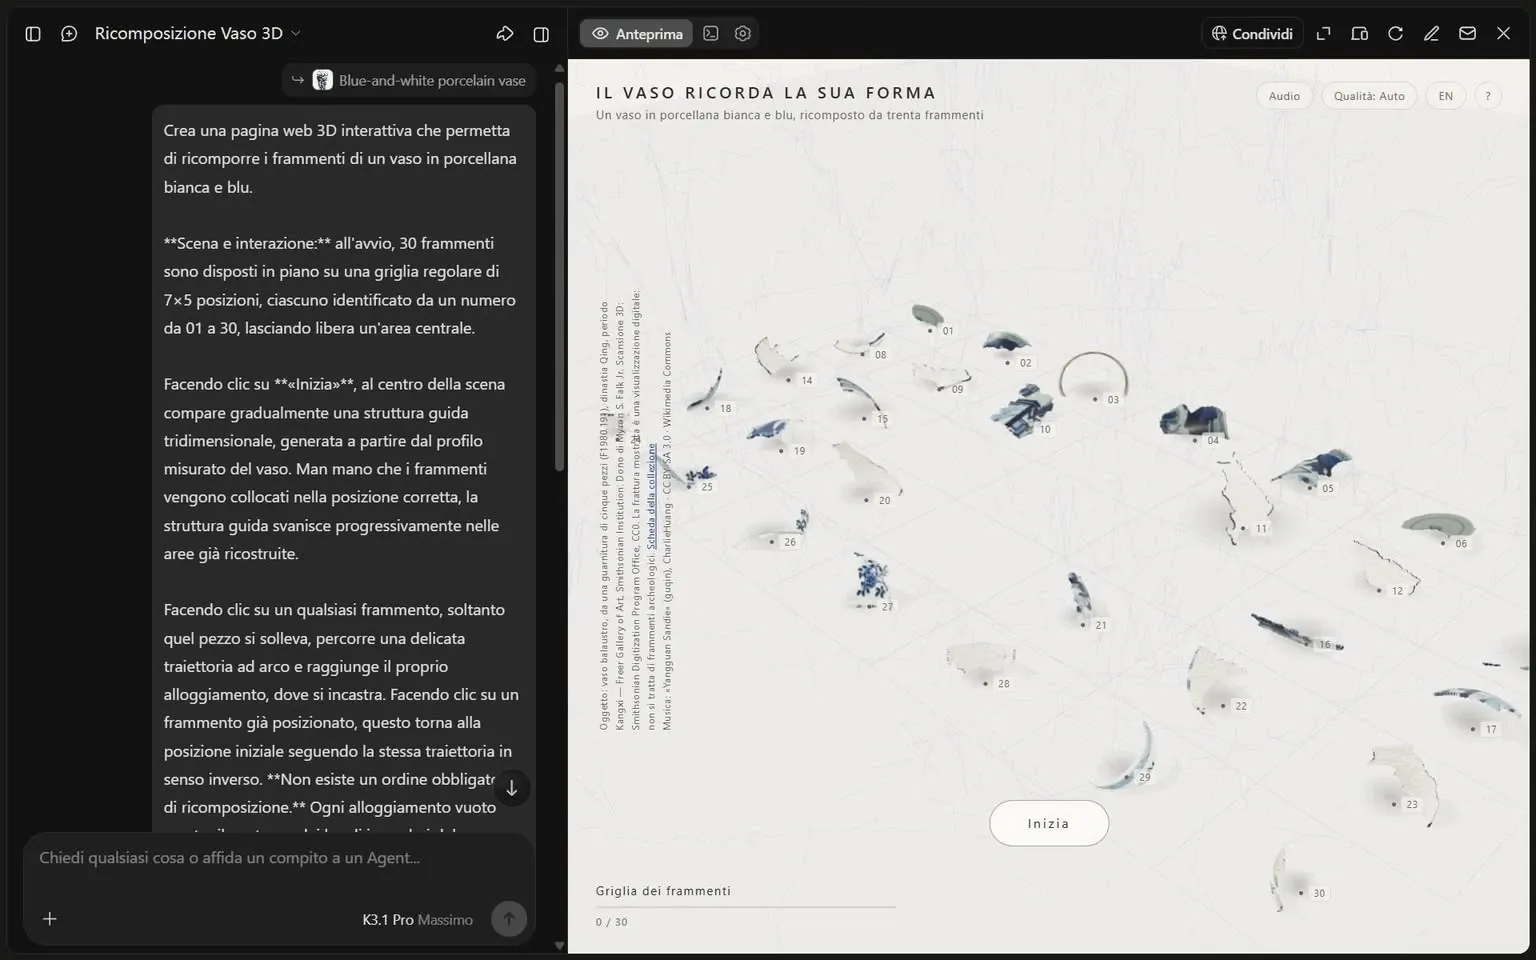
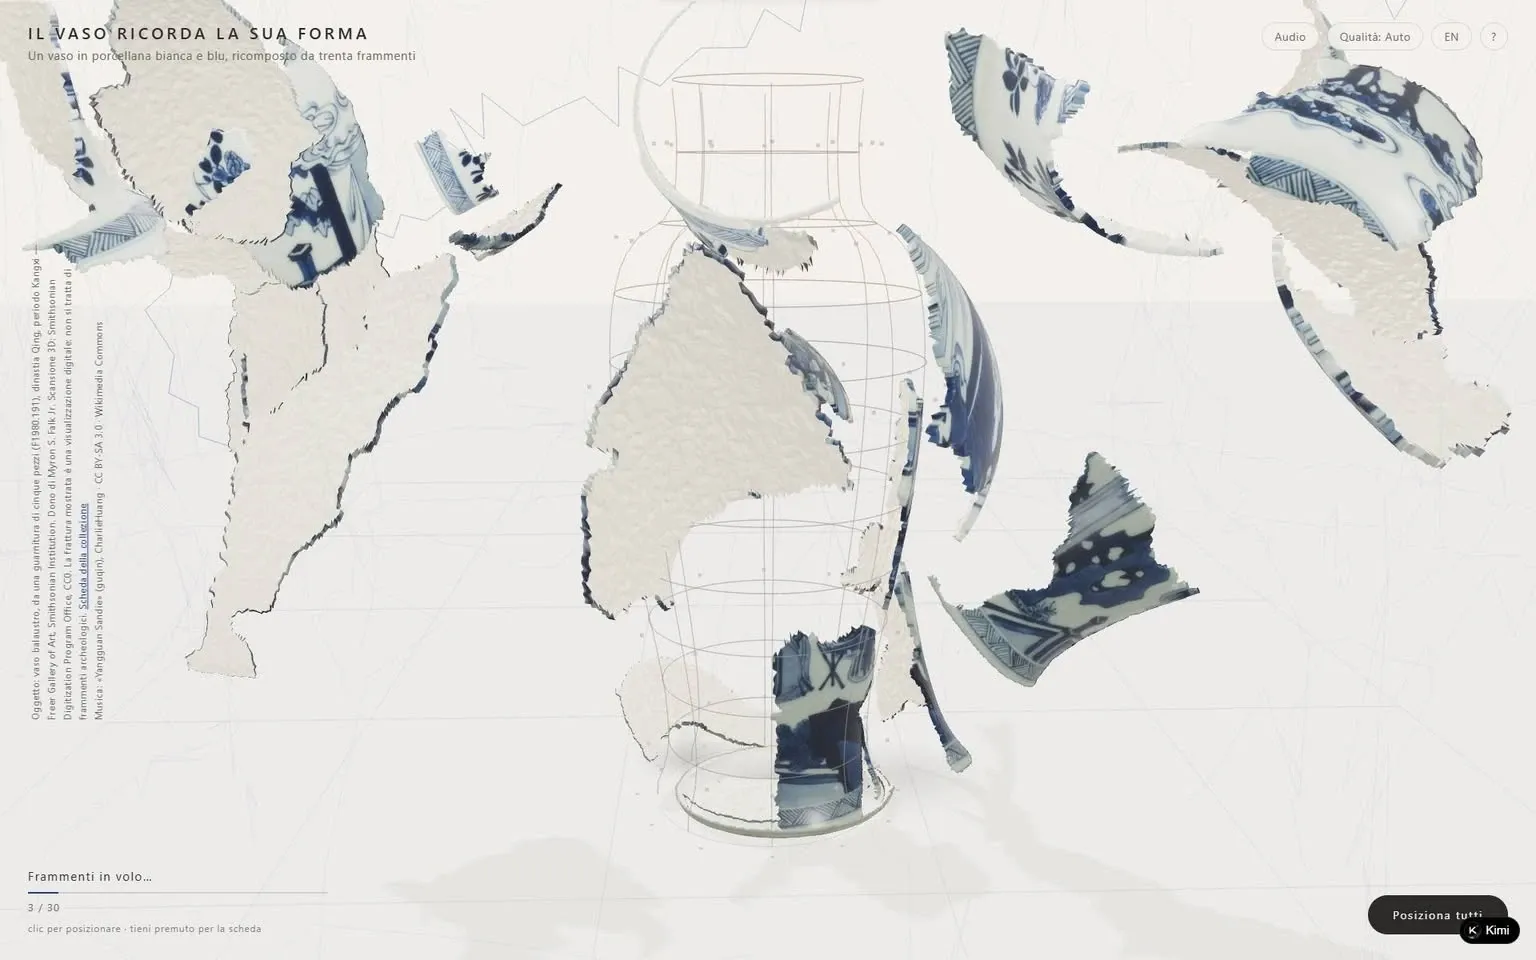
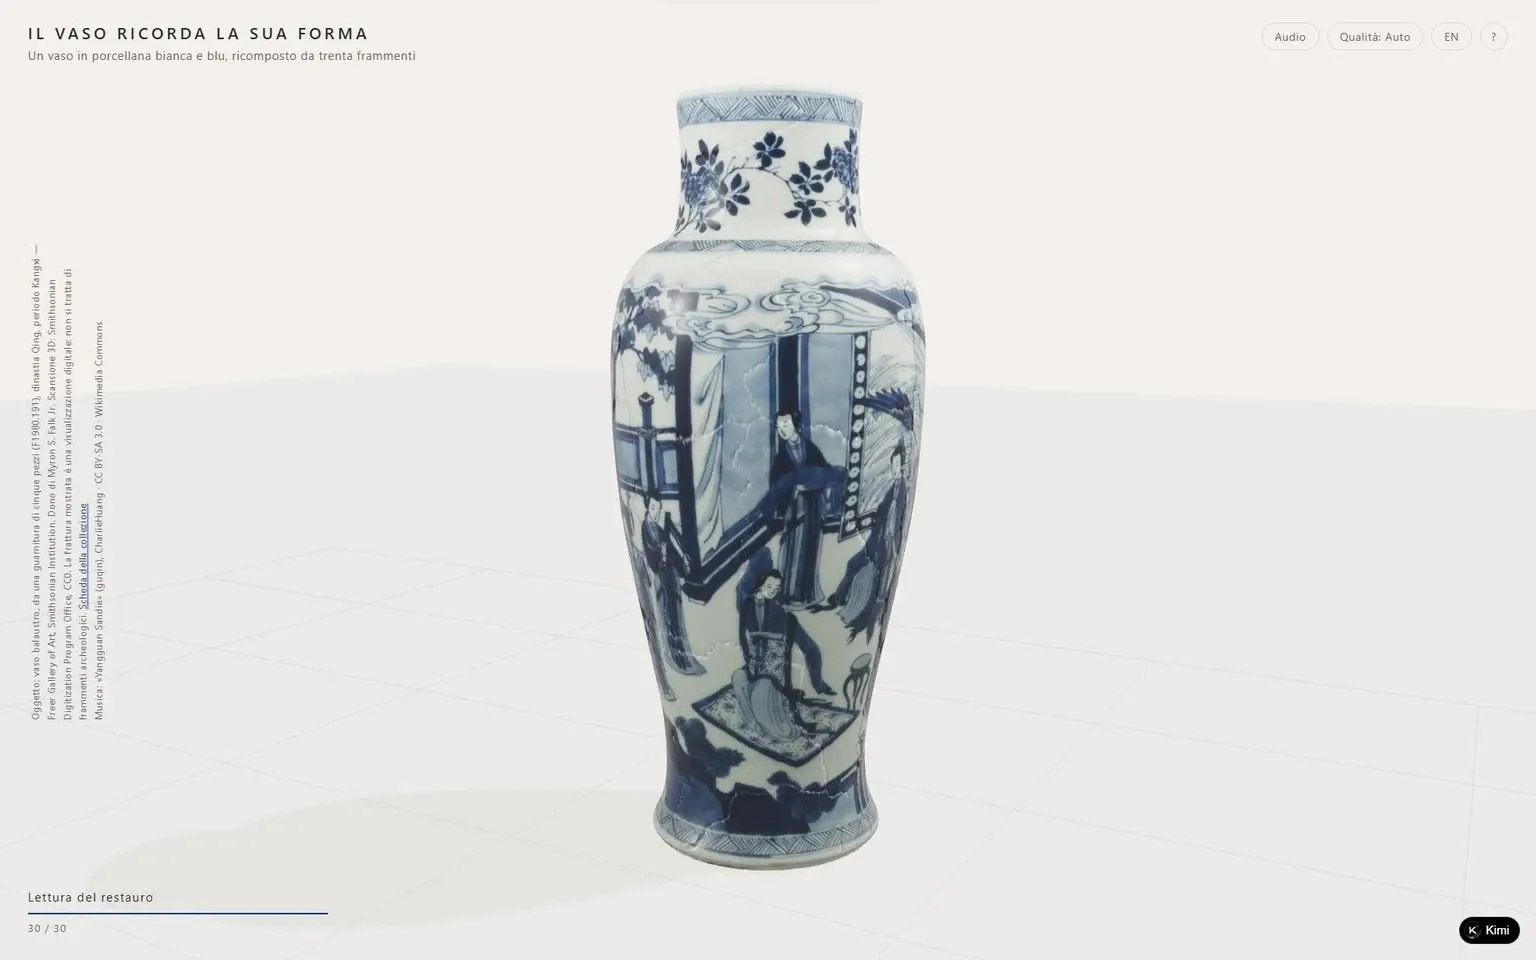
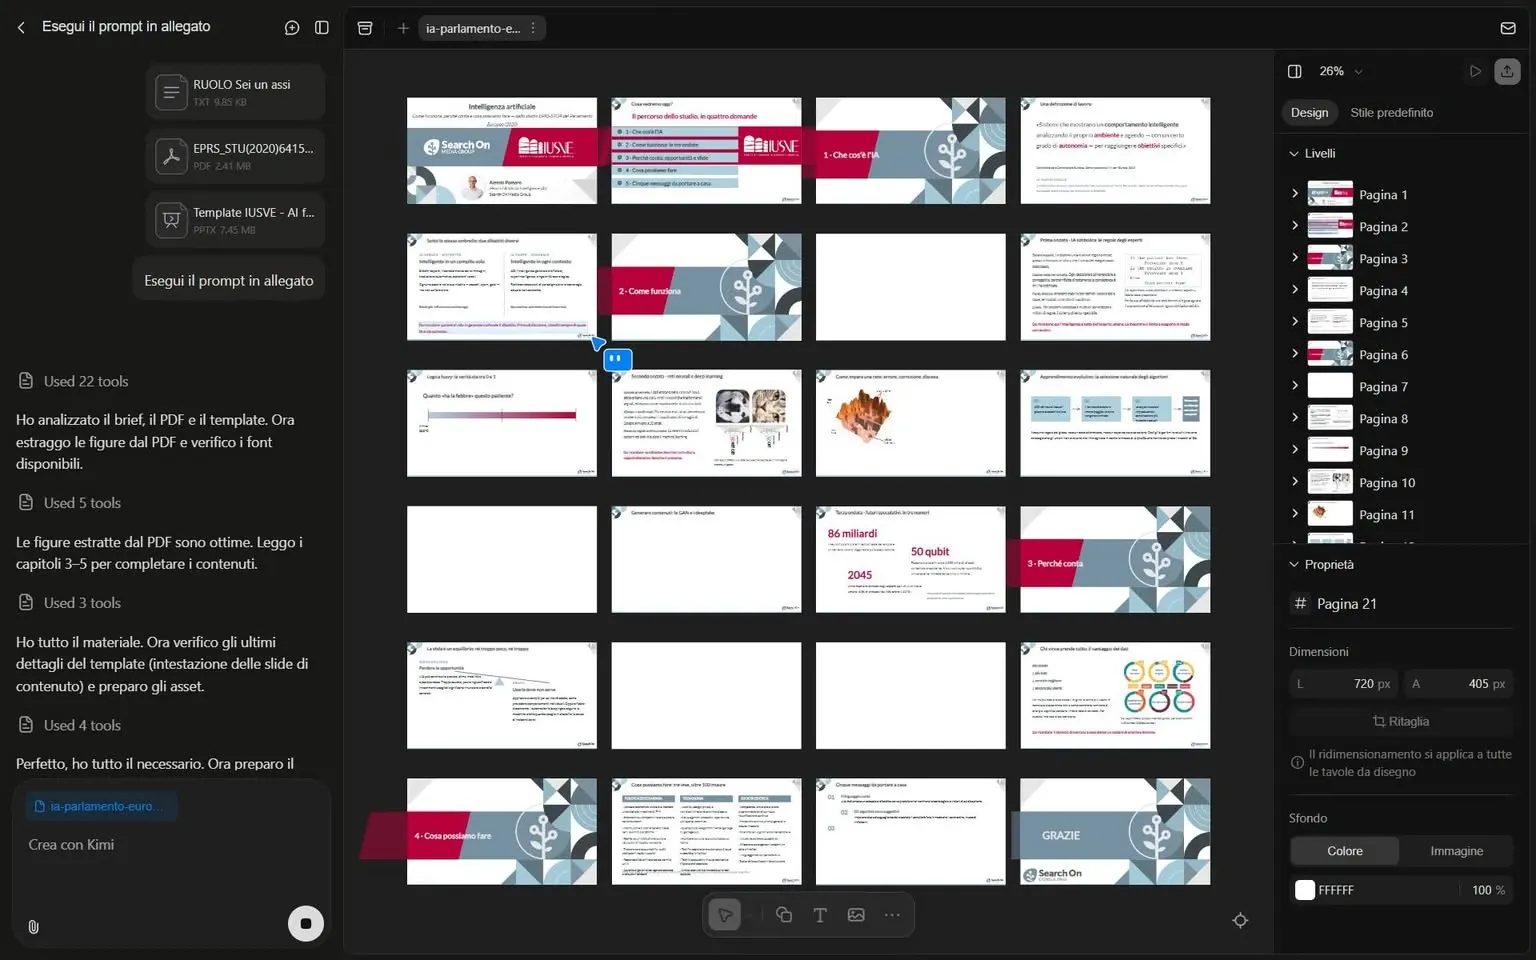
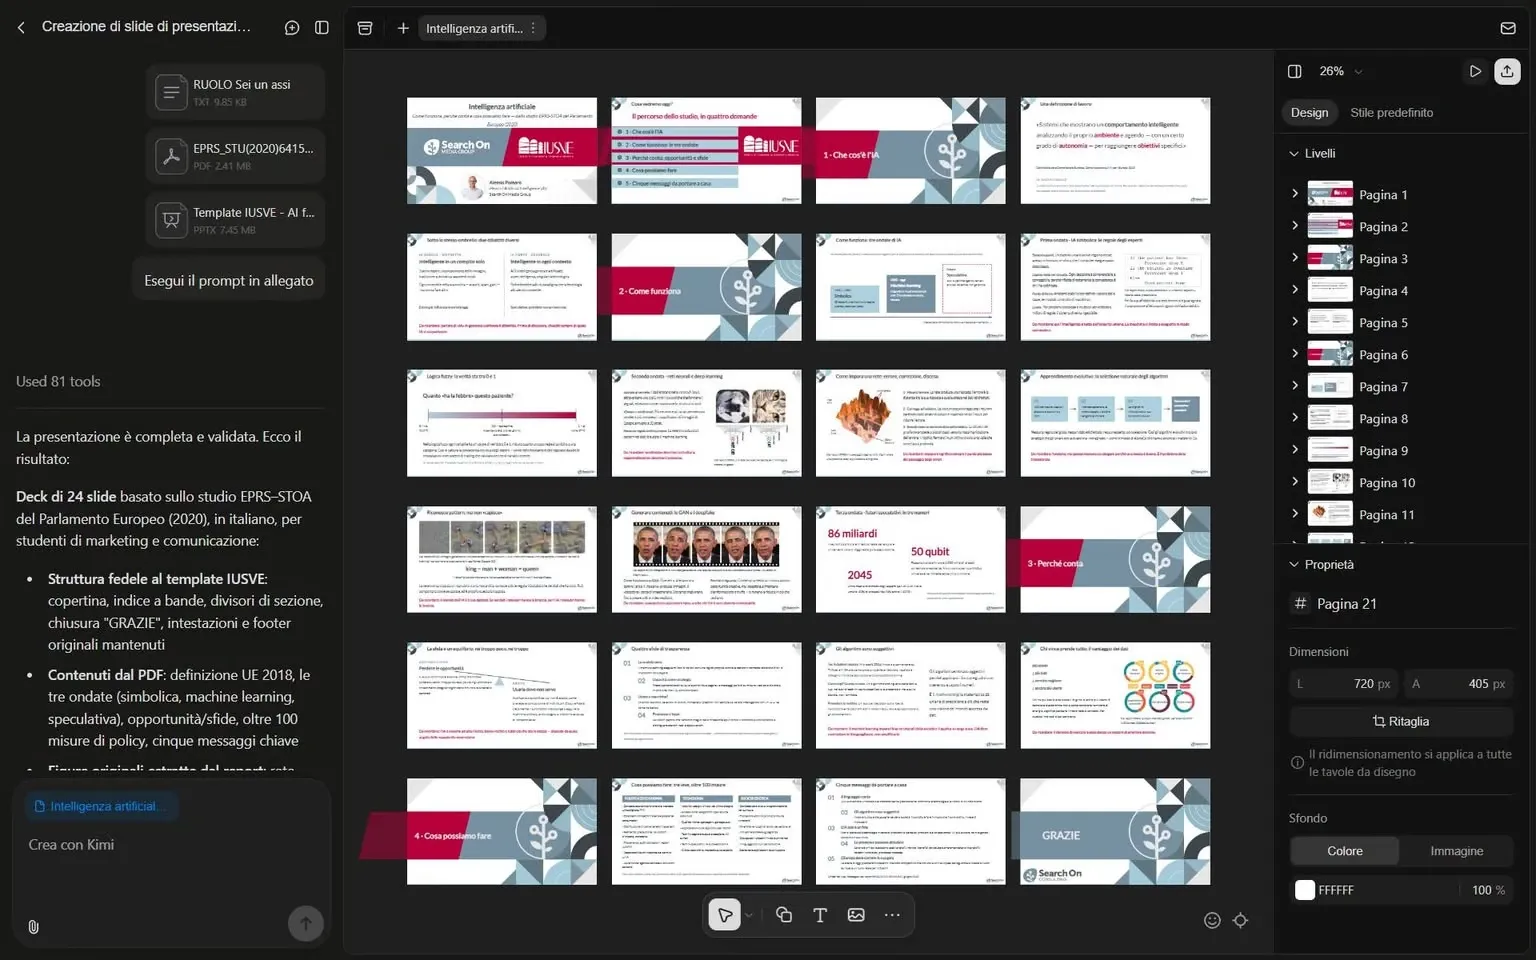
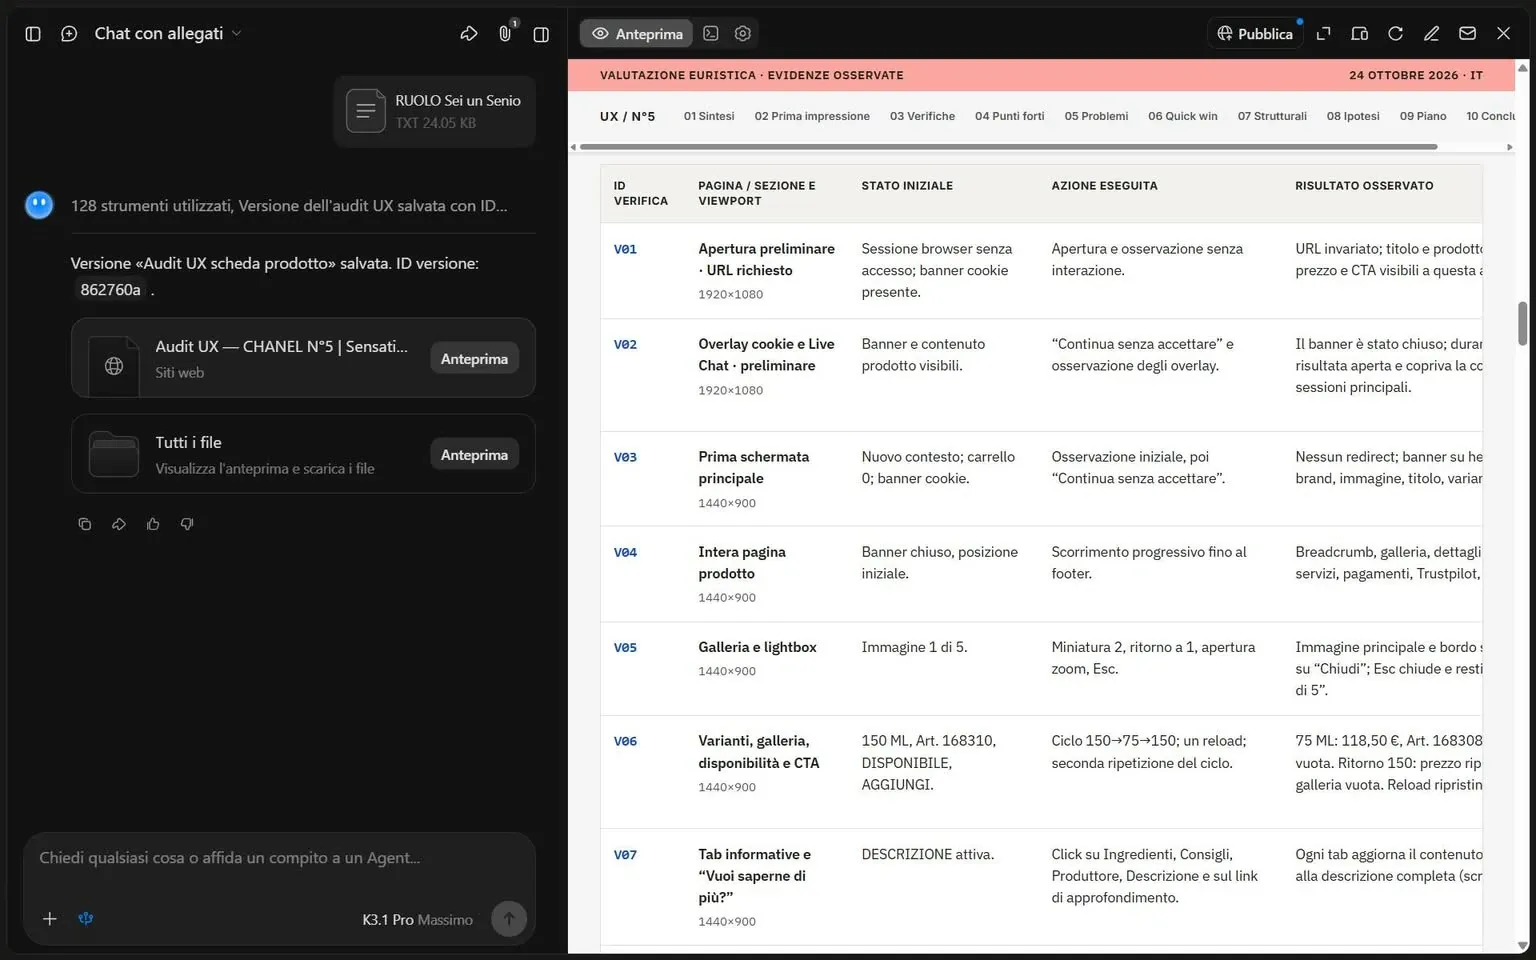
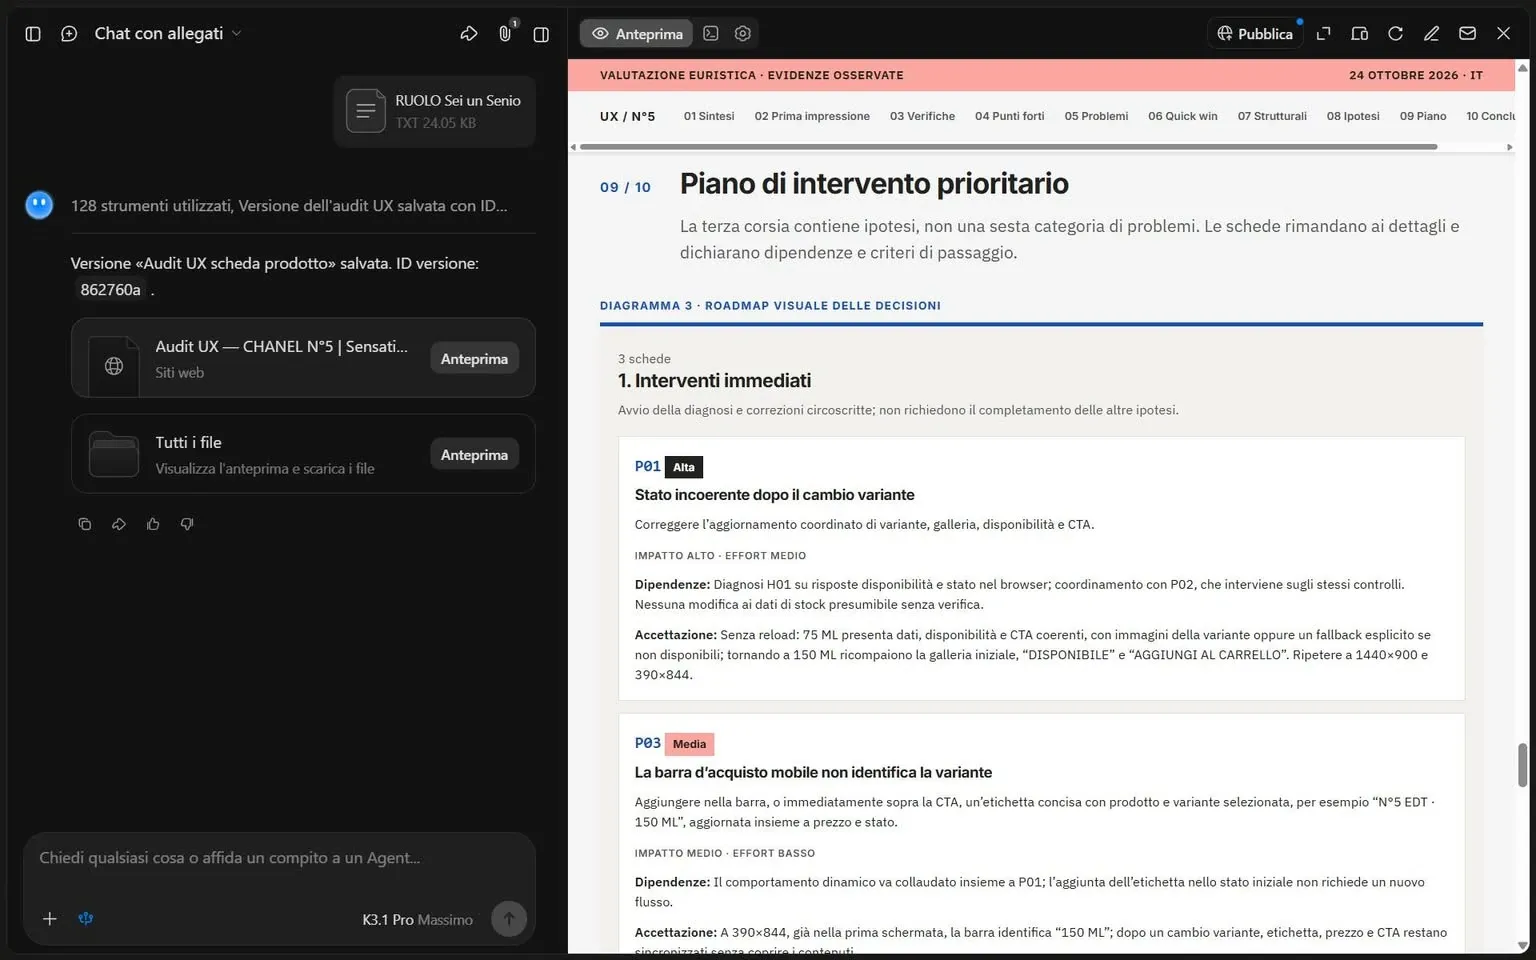
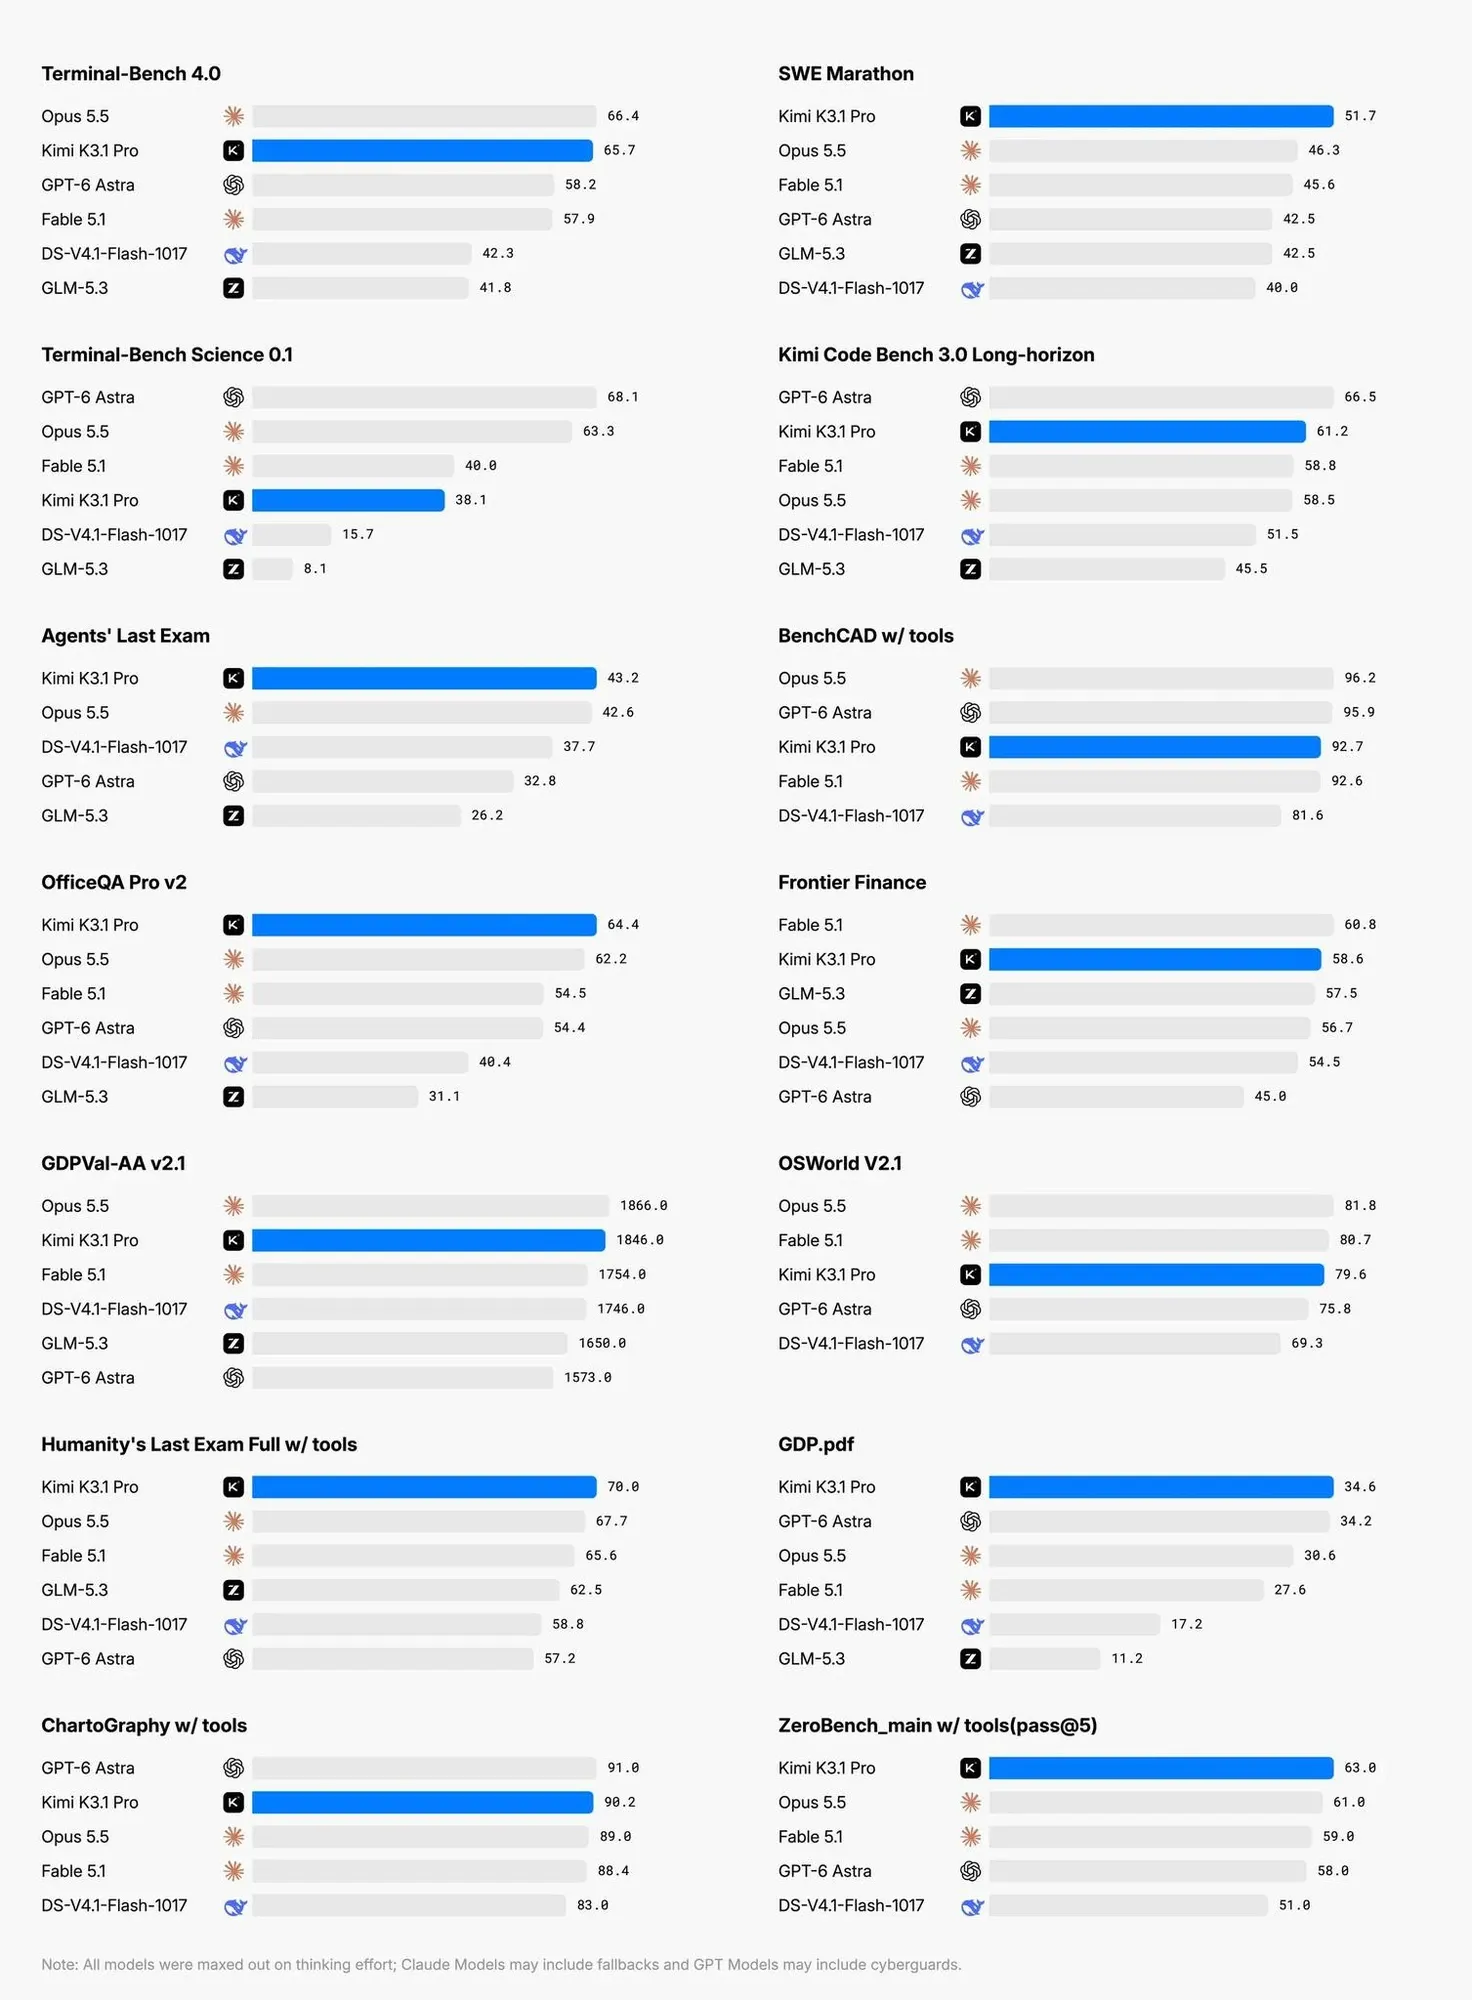
I miei test su applicazione 3D, presentazione e analisi UX, con i confronti pubblicati da Moonshot.
Dietro queste prove c'è il nuovo modello di Moonshot AI, della classe dei 3.000 miliardi di parametri, con un milione di token di contesto. K3.1 Pro deriva dal post-training di K3: il team descrive più apprendimento per rinforzo su centinaia di domini, insieme a miglioramenti negli ambienti di esecuzione, nella gestione dei tentativi e nell'inferenza su contesti lunghi.
Su Terminal-Bench 4.0 Moonshot riporta il 65,7%, contro il 58,2% di GPT-6 Astra e il 66,4% di Claude Opus 5.5. Kimi è valutato con Claude Code, con ragionamento al massimo. Sono risultati dichiarati dal team, da leggere con le condizioni del test.
Quello che mi interessa, dopo averlo provato, è la capacità di passare da un brief a un'applicazione, una presentazione o un'analisi su cui continuare a lavorare.
Nei miei test il miglioramento si sente proprio lì.
EmbeddingGemma 2 in locale: quando la somiglianza perde il dettaglio decisivo
Ho testato EmbeddingGemma 2 di Google in locale sul mio laptop, con una RTX 4050 da 6 GB. Il modello completo ha occupato circa 2,2 GB di memoria video.
Gli embedding trasformano un contenuto in una rappresentazione numerica: coordinate che permettono di cercare elementi con significato simile. Qui testo, immagini, audio e video condividono uno spazio a 768 dimensioni, così una frase può servire a cercare anche una foto o una registrazione.
Ho costruito sette prove su contesto, struttura delle frasi, modalità, tempo, testi lunghi, ironia e compressione, confrontando diversi modelli e una baseline che conta le parole. Dataset pubblici e piccoli campioni costruiti a mano, con ipotesi scritte prima dei test. È una verifica esplorativa su un solo hardware.
Su FLEURS, partendo da una frase pronunciata in italiano, il modello ritrova quella equivalente in giapponese nell'89,5% dei casi, tra 133 registrazioni e senza trascrizione. Su 1.446 immagini di SugarCrepe sceglie la didascalia inglese corretta nell'86,7% dei casi, il risultato migliore del confronto.
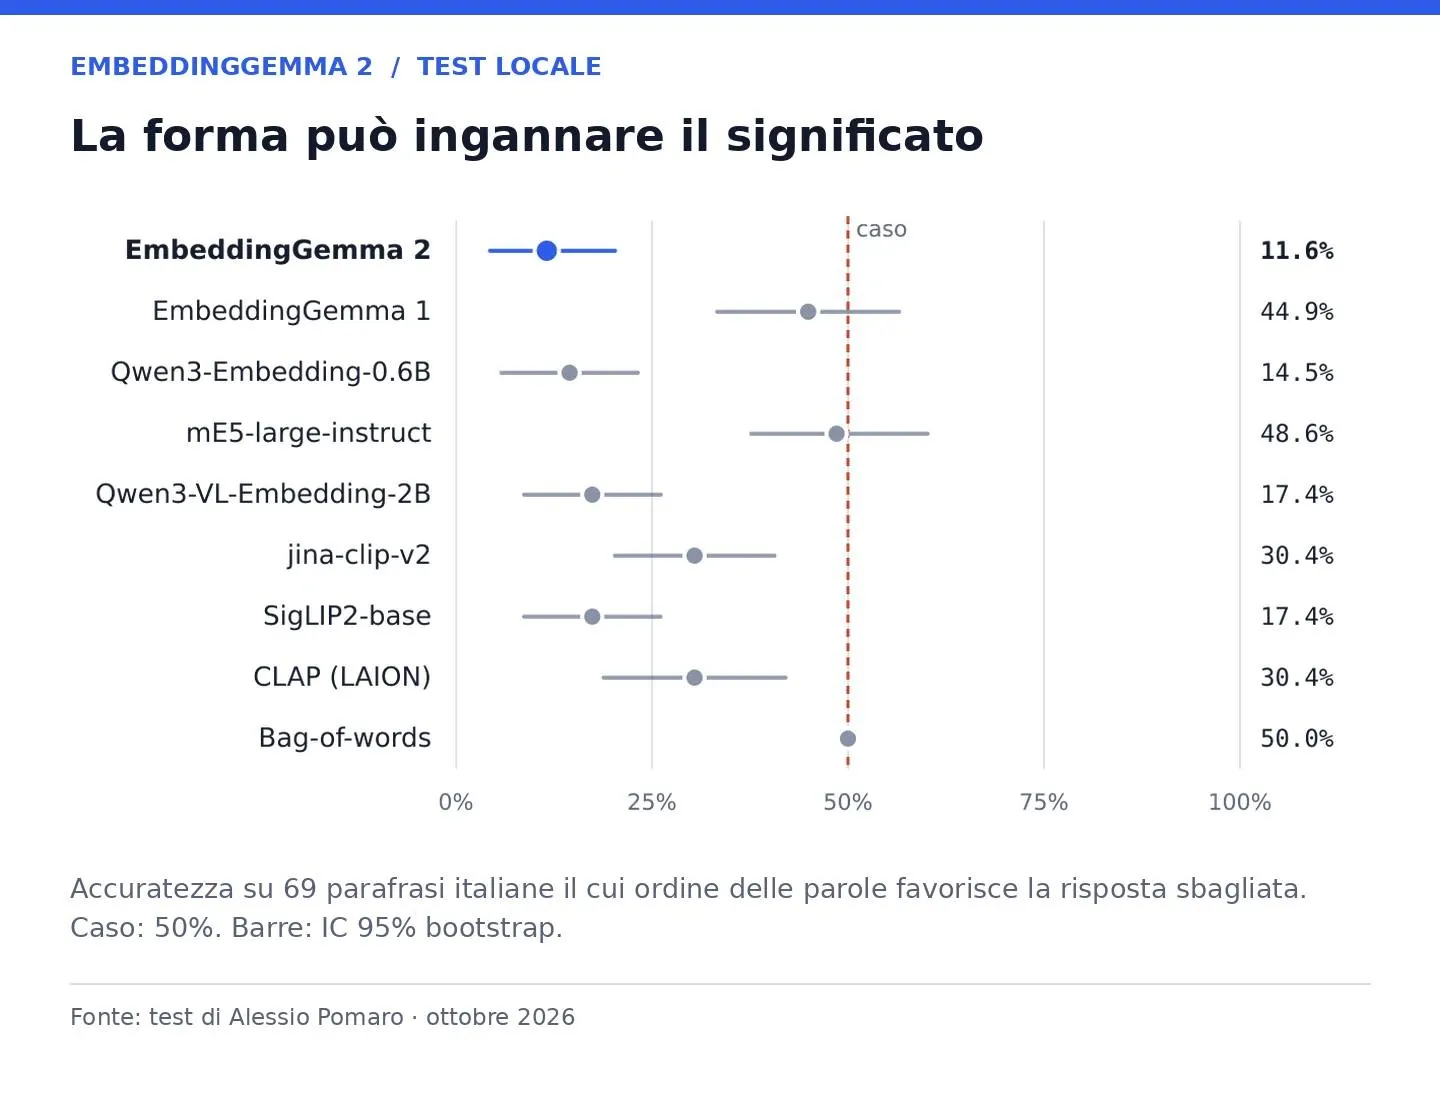
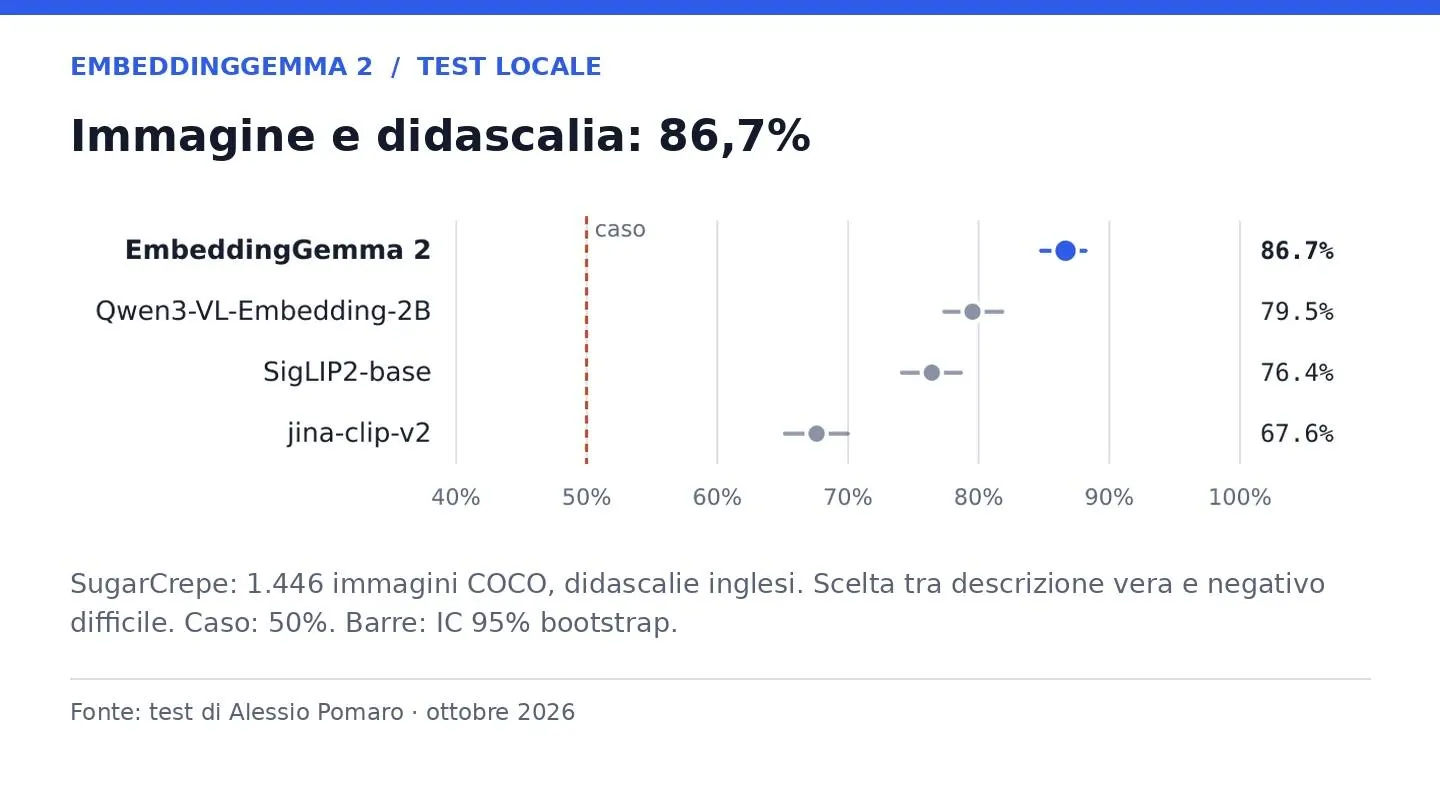
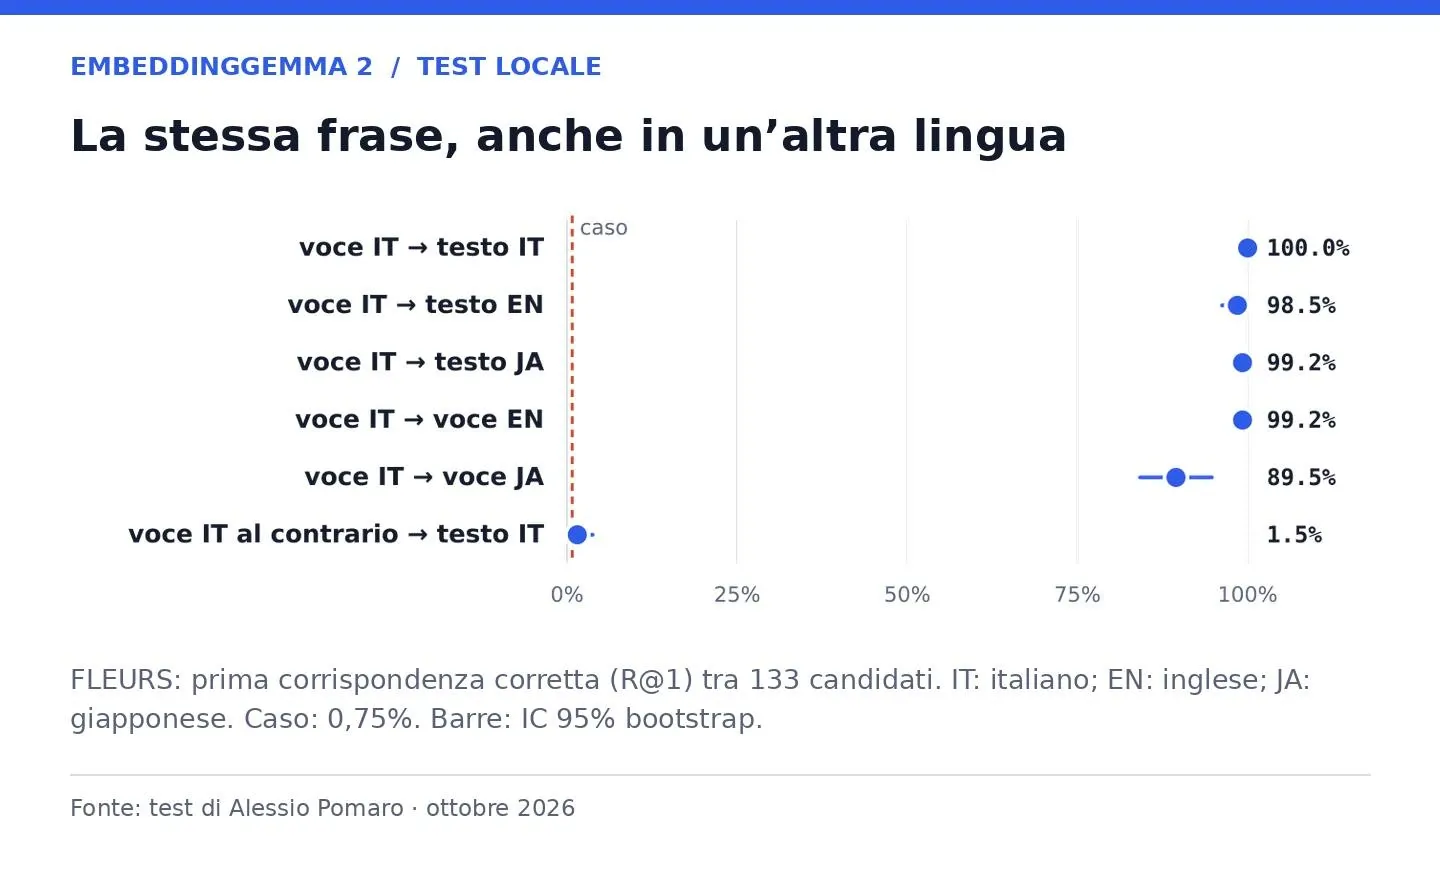
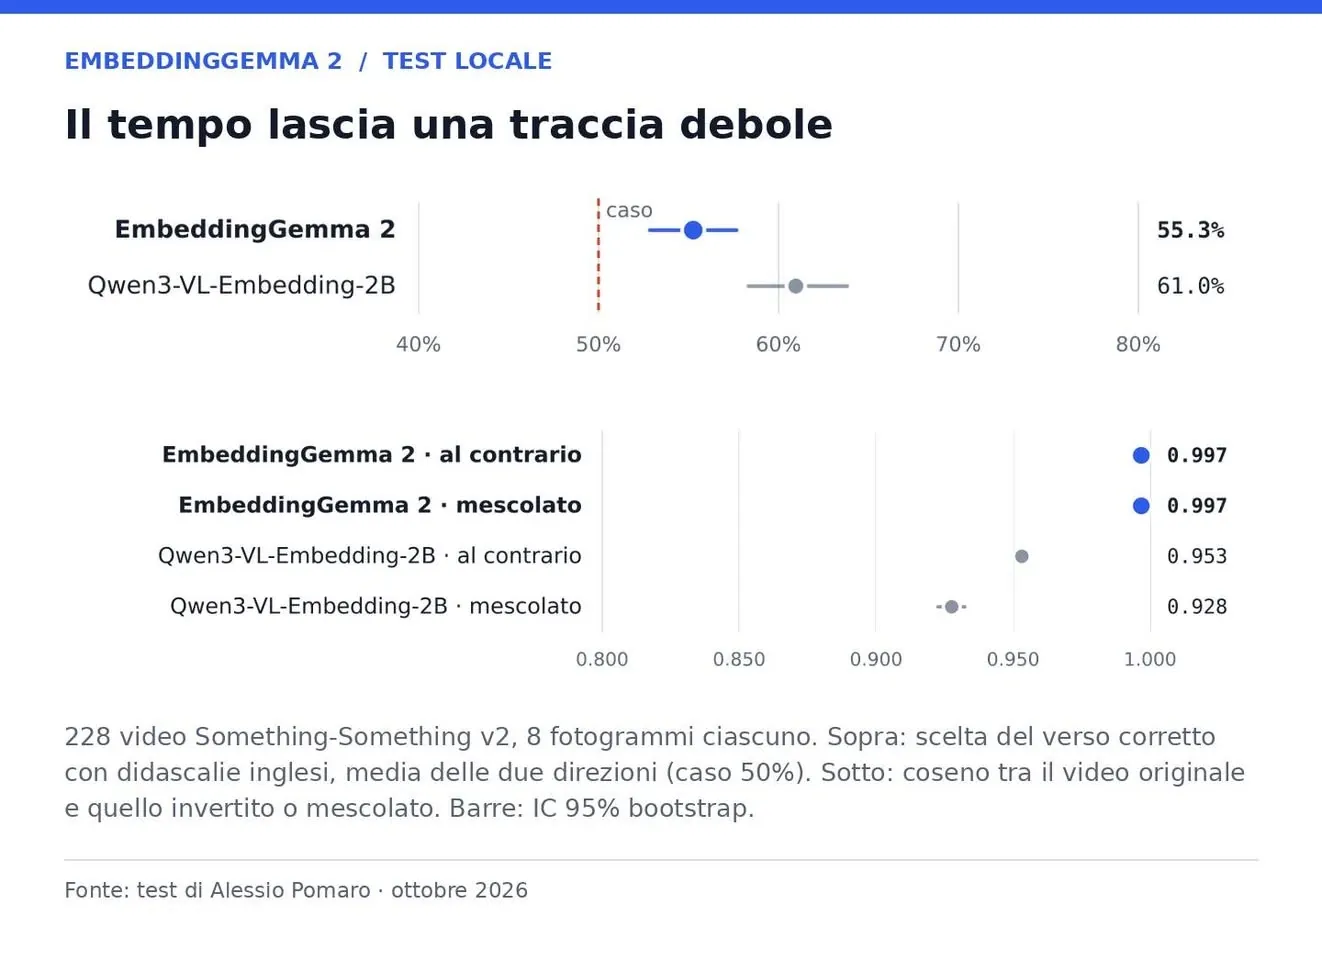
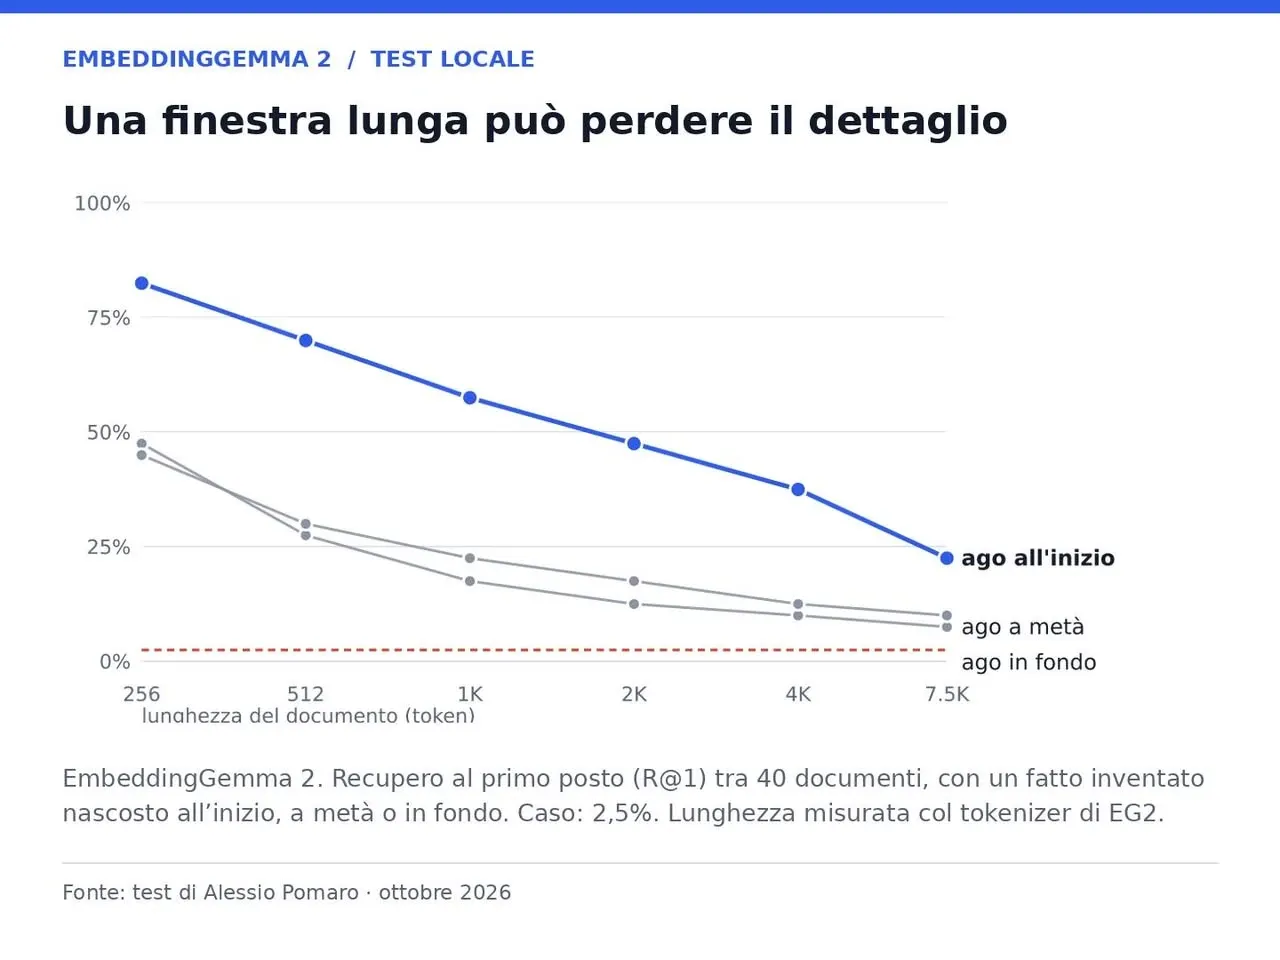
Il test locale mostra capacità multimodali e fragilità su struttura, tempo e dettagli.
La struttura è più fragile. Tra "Torino è più piccola di Milano" e "Milano è più grande di Torino" il significato coincide, ma il modello preferisce "Torino è più grande di Milano". Nei 69 casi in cui la forma della parafrasi favorisce la risposta sbagliata, l'accuratezza è appena l'11,6%, contro il 50% del caso.
Su 228 video, campionati in 8 fotogrammi, distinguere un'azione dal suo contrario arriva al 55,3%, poco sopra il caso. Riavvolgere il video cambia pochissimo il vettore: la similarità coseno media resta 0,997.
Anche leggere tanto non garantisce di conservare ogni dettaglio. Un fatto nascosto a metà di un testo da 1.024 token permette di ritrovare il documento giusto solo nel 17,5% dei casi, tra 40 candidati.
Questi test mostrano quanto sia utile cercare per significato, ma anche quanto conti definire quale significato serve. Nei sistemi RAG, che recuperano fonti per un modello generativo, dimensione dei brani, criteri di confronto e verifiche vanno scelti sul compito reale: la vicinanza tra vettori può conservare il tema e perdere proprio il dettaglio che decide la risposta.
TurboQuant su 200.000 prodotti: comprimere l’indice e recuperare la qualità
Ho testato TurboQuant di Google su un catalogo reale: 200.000 prodotti Amazon e 1.000 ricerche con giudizi umani. A 2 bit, con il riordino finale, la qualità dei risultati torna praticamente a quella dei vettori originali!
TurboQuant, del quale la community SEO parla spesso ultimamente, comprime i vettori per ridurre lo spazio che occupano. Una rotazione casuale rende più prevedibile la distribuzione dei valori, poi Lloyd-Max li rappresenta con pochi livelli, senza addestramento sul catalogo. A 2 bit ogni coordinata può assumere solo 4 valori, invece di essere memorizzata a 32 bit.
L'ho implementato in Python e ho costruito una ricerca in due passaggi: l'indice compresso seleziona 200 candidati, poi i vettori originali li riordinano. Ho provato anche la centratura: sottrarre il vettore medio del catalogo prima della compressione.
Con gli embedding OpenAI a 1.536 dimensioni, TurboQuant centrato a 2 bit ottiene recall@10 di 0,876: ritrova l'87,6% dei primi 10 risultati della ricerca esatta. Dopo il riordino sale al 99,98%. Anche nDCG@10, che valuta l'ordine dei risultati usando i giudizi umani, torna a 0,484: lo stesso valore dei vettori originali.
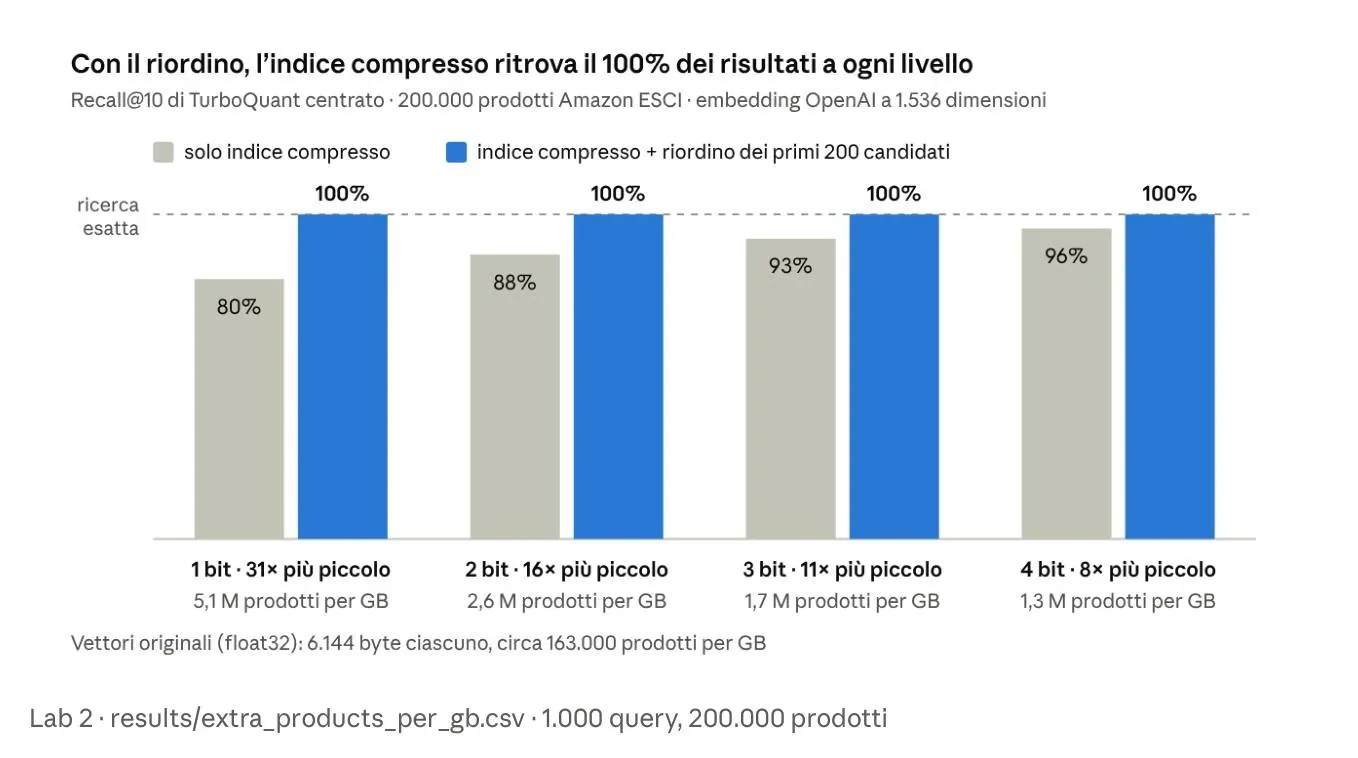
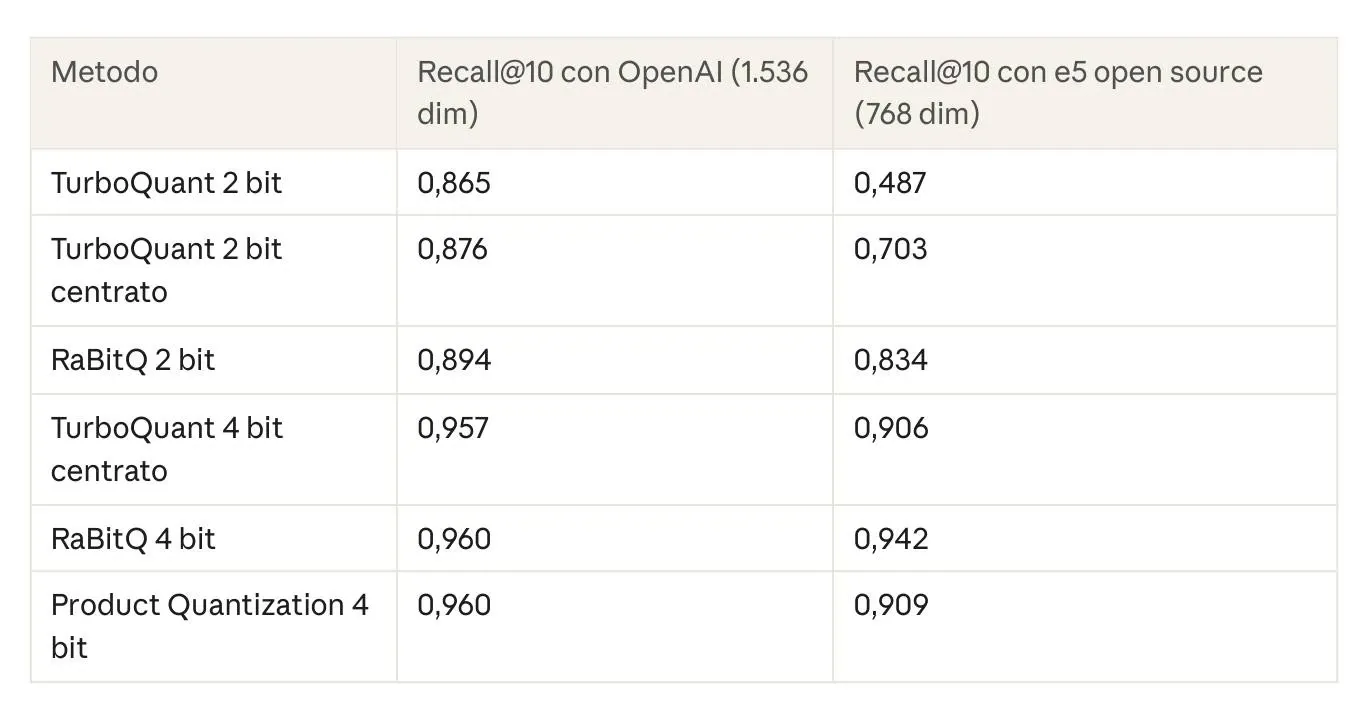
Compressione dell’indice e riordino: i risultati sul catalogo di prodotti.
L'indice occupa circa 16 volte meno memoria. Nello spazio di 200.000 vettori float32 ne entrano circa 3,2 milioni compressi. Ma per il riordino servono ancora gli originali: il risparmio riguarda l'indice, non l'intero sistema.
Il confronto con altri metodi è interessante. A 2 bit RaBitQ, già disponibile in FAISS, ottiene recall@10 di 0,894 contro 0,876 di TurboQuant centrato. Con gli embedding e5 a 768 dimensioni, TurboQuant centrato scende a 0,703 e senza centratura arriva a 0,487.
Non conta solo il compressore: contano anche il modello di embedding, il numero di dimensioni e la distribuzione dei vettori.
I tempi della mia versione NumPy su CPU non sono confrontabili con quelli su GPU. Non ho testato la KV cache: i numeri "6× meno memoria" e "8× più veloce" citati da Google riguardano quel contesto, con la velocità misurata sugli attention logits.
Nella ricerca semantica il vantaggio è poter cercare tra molti più contenuti usando la stessa memoria per l'indice. La qualità finale dipende da quali candidati troviamo e da come li riordiniamo.
Gemini 4 Argon nei video lunghi: trova la scena, ma una cifra richiede verifica
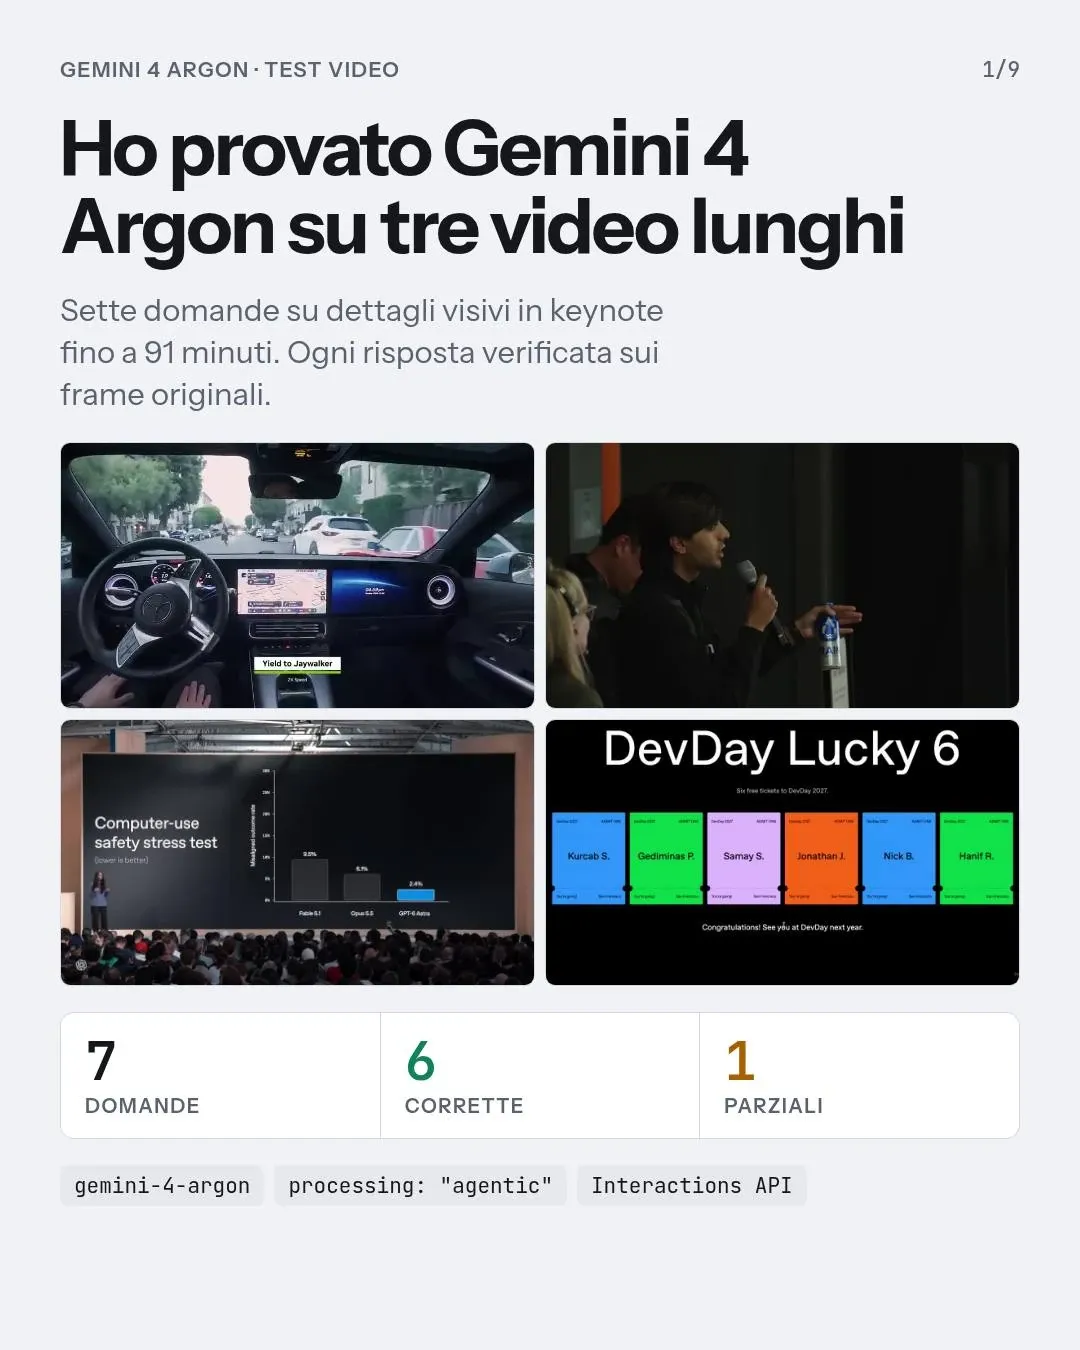
Ho provato Gemini 4 Argon nel compito in cui i modelli multimodali faticano di più: trovare un dettaglio preciso dentro video lunghi. Tre keynote e sette domande, ognuna verificata sui frame originali.
Ho usato la modalità agentic, che si attiva sul singolo video con "processing": "agentic". Di default Gemini campiona un frame al secondo e porta tutto nel contesto. In modalità agentic il modello esplora invece la timeline: legge prima la trascrizione, individua i segmenti candidati e carica solo quei frame, adattando frame rate e risoluzione alla domanda.
Sulla localizzazione il risultato è netto: 7 intervalli corretti su 7, con uno scarto massimo di un secondo. La BMW in galleria del vento: 54:27-54:30, al secondo. Nel grafico "Computer-use safety stress test" legge esattamente i tre valori (9.5%, 6.1%, 2.4%) e separa le due inquadrature in cui compare. In una demo live di Codex elenca i sei vincitori estratti, con ordine e colori, senza errori.
L'unico errore è istruttivo. In una demo che confronta due versioni di un modello, Argon trova scena, prompt, sequenza degli eventi e tempi. Il timer che si ferma a 6.4 secondi diventa però 8.4 al primo tentativo e 8.0 al secondo, mentre lo stato "Replaying" diventa "Reshaping" e poi "Prototyping".
Il modello arriva al momento giusto ma, almeno in quel passaggio, sembra non osservarlo con una risoluzione sufficiente per leggere un numero piccolo che cambia di continuo. Invece di segnalare l'incertezza, completa il dato con un valore plausibile, diverso a ogni esecuzione. Il testo statico regge.
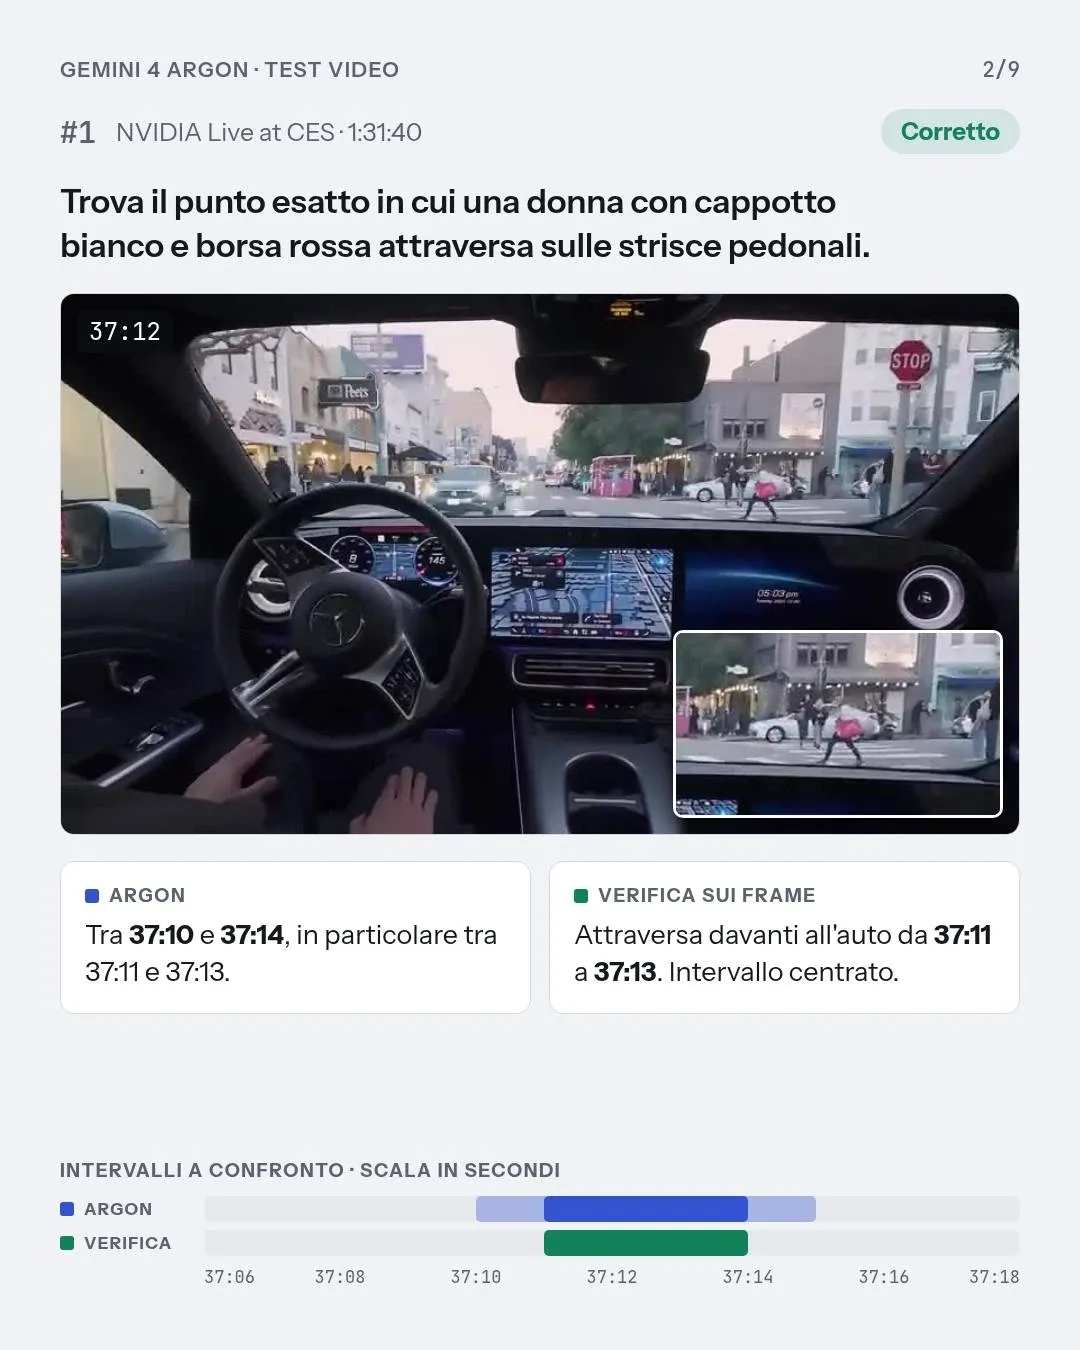
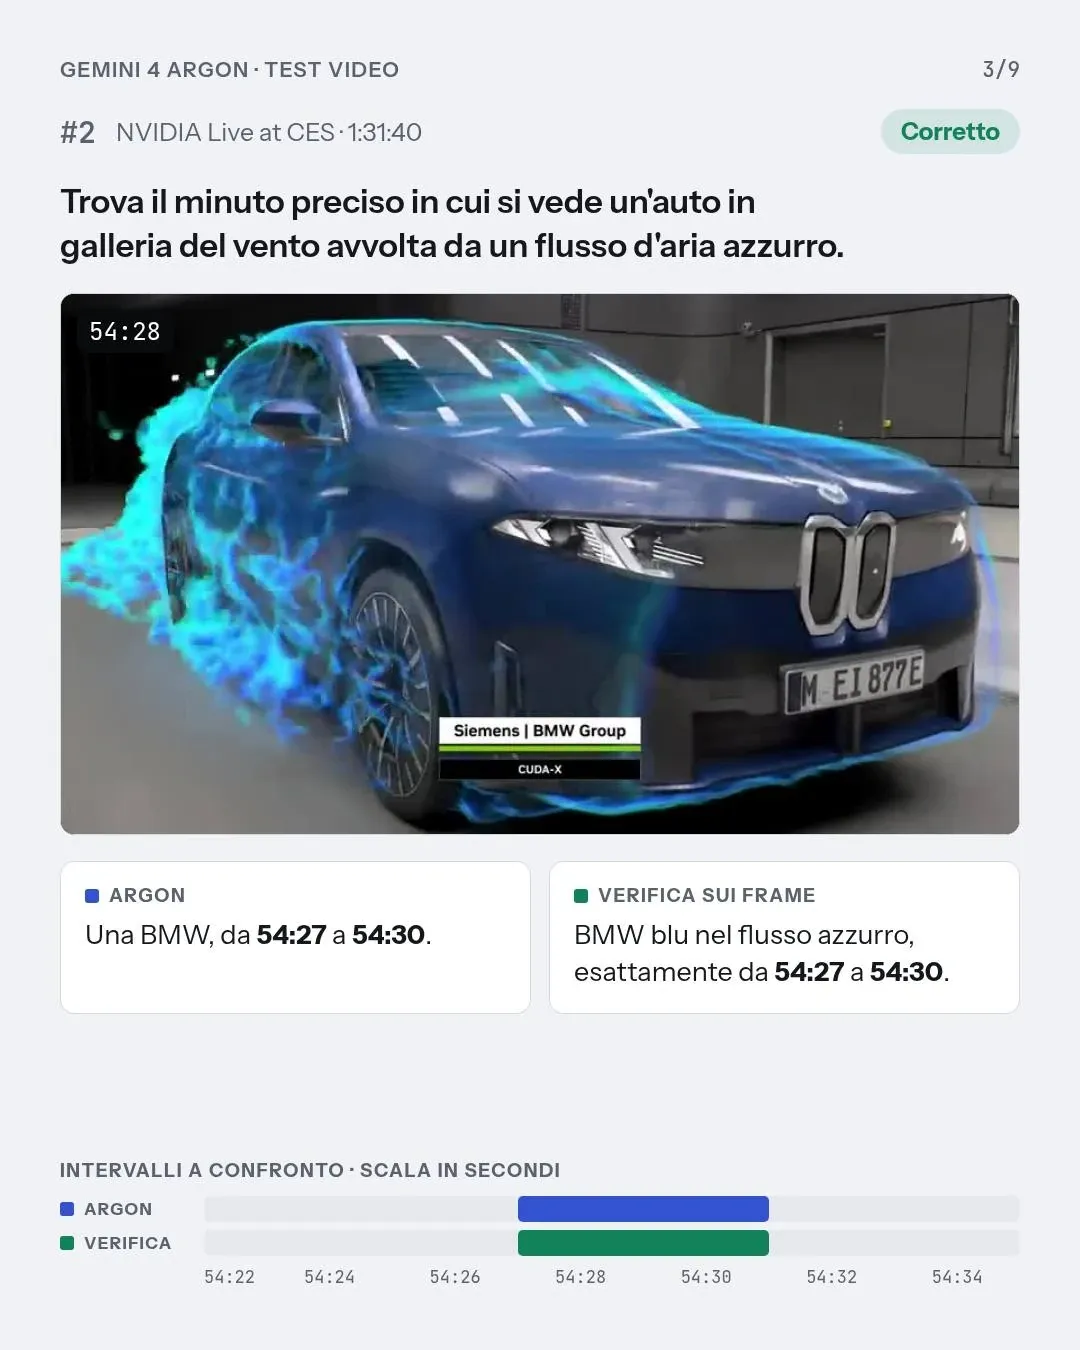
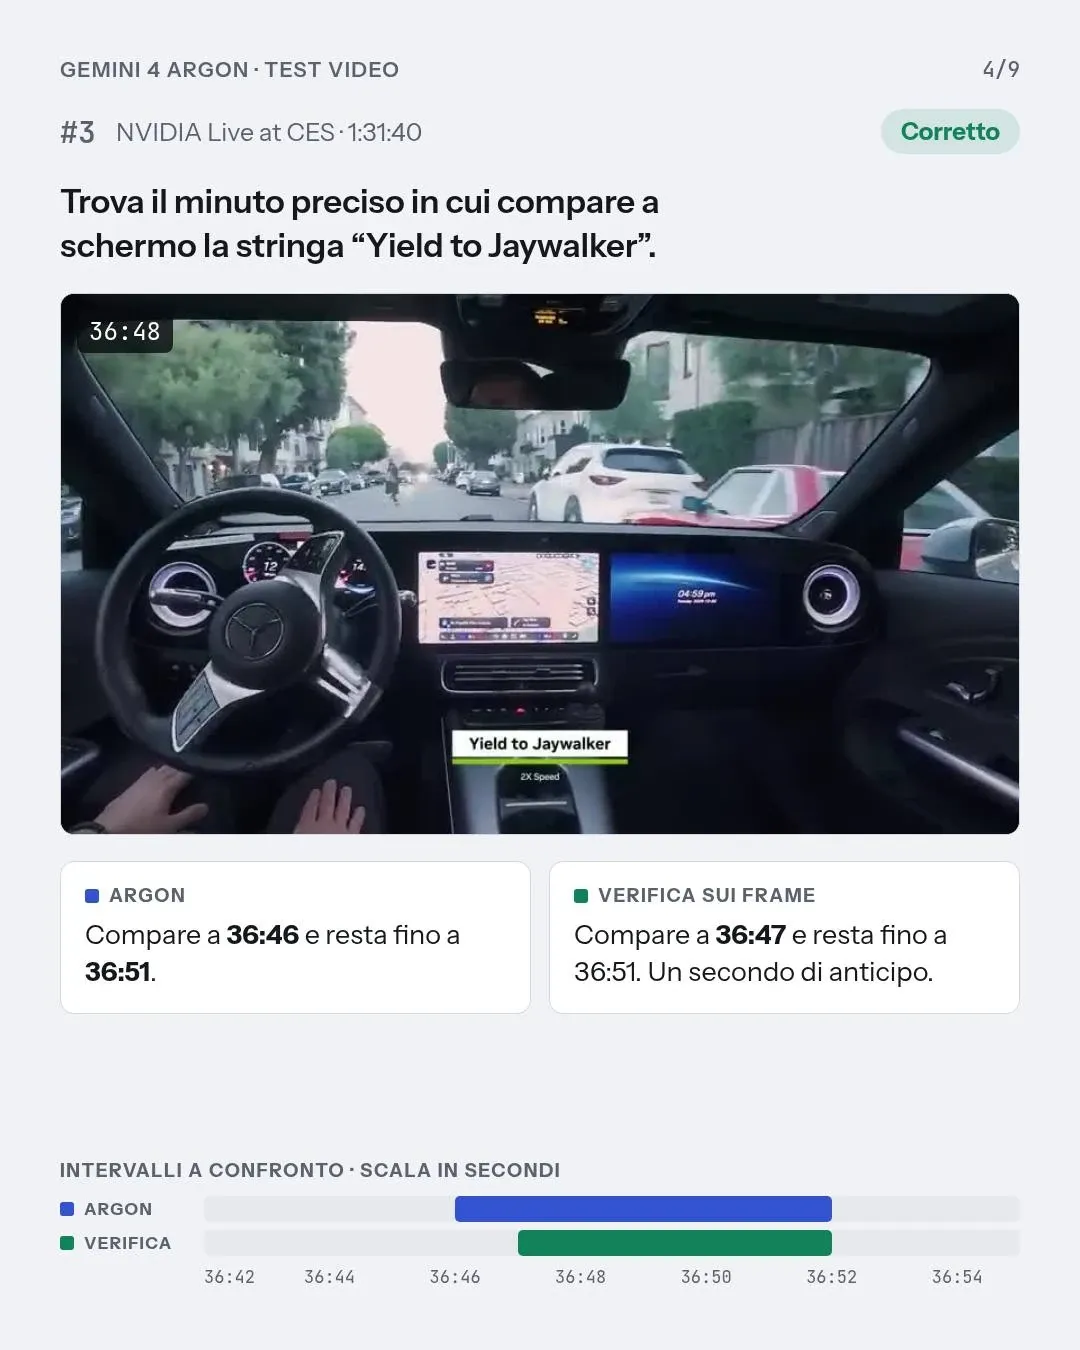
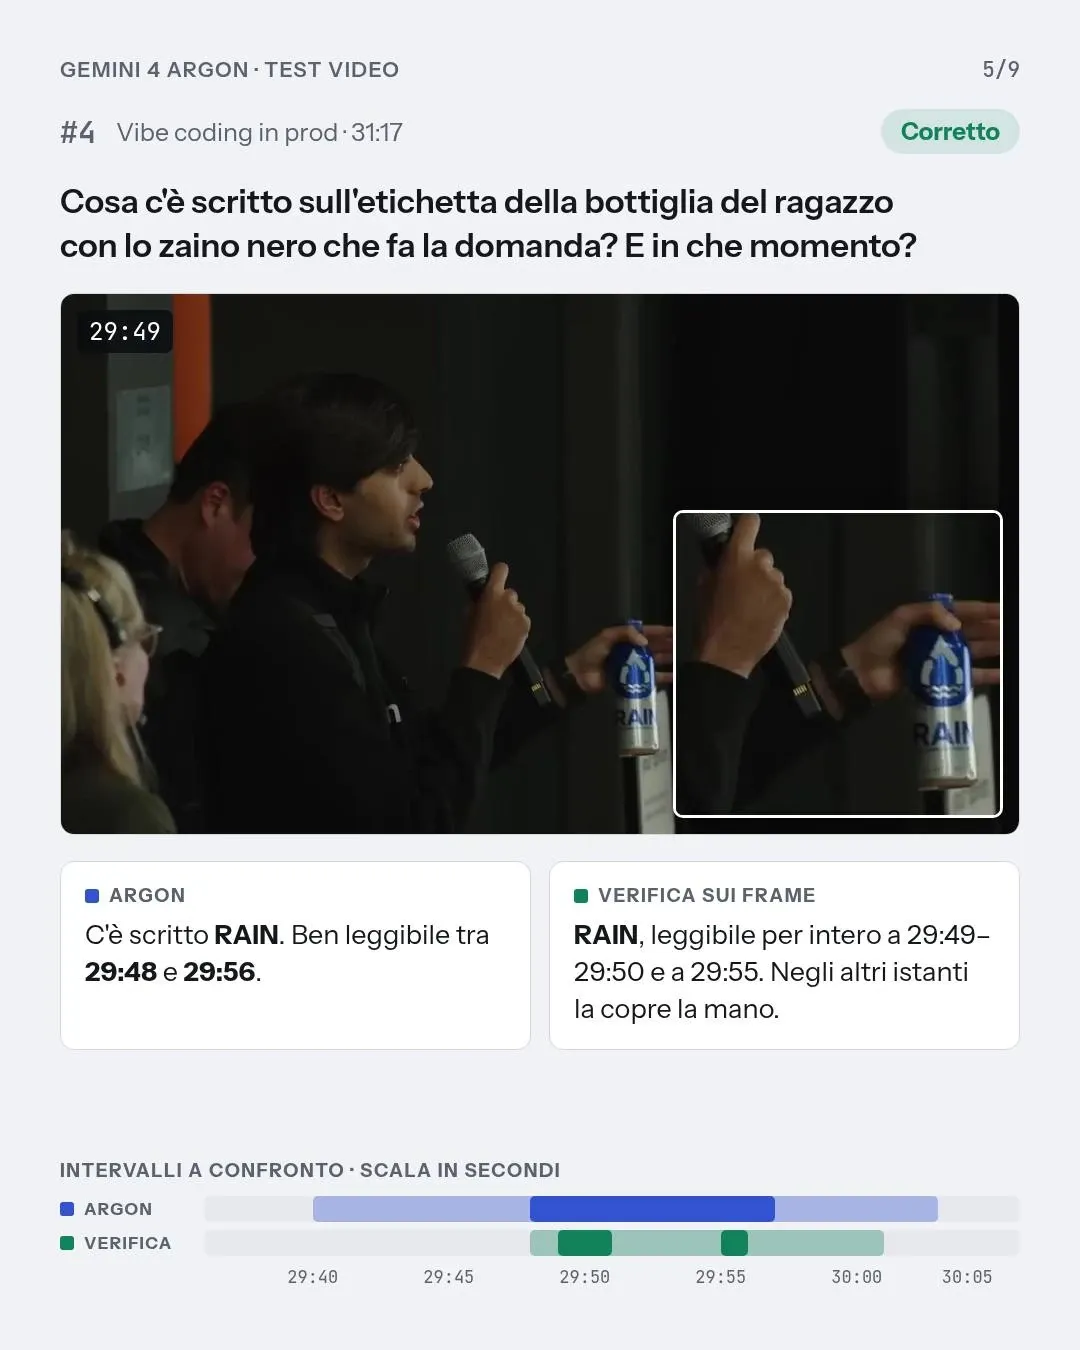
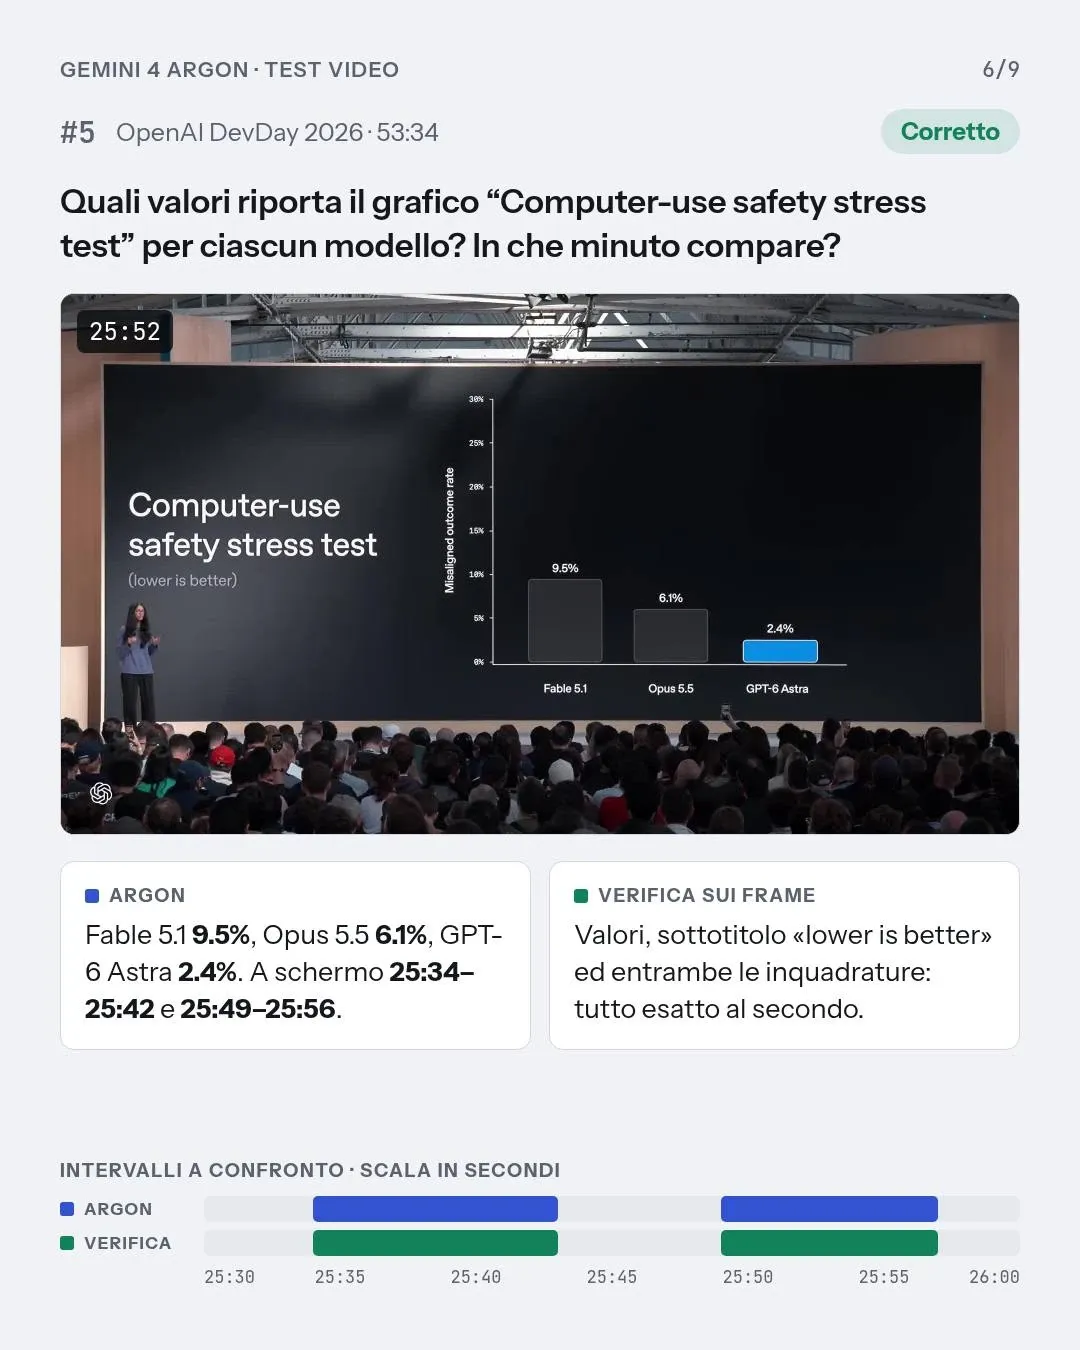
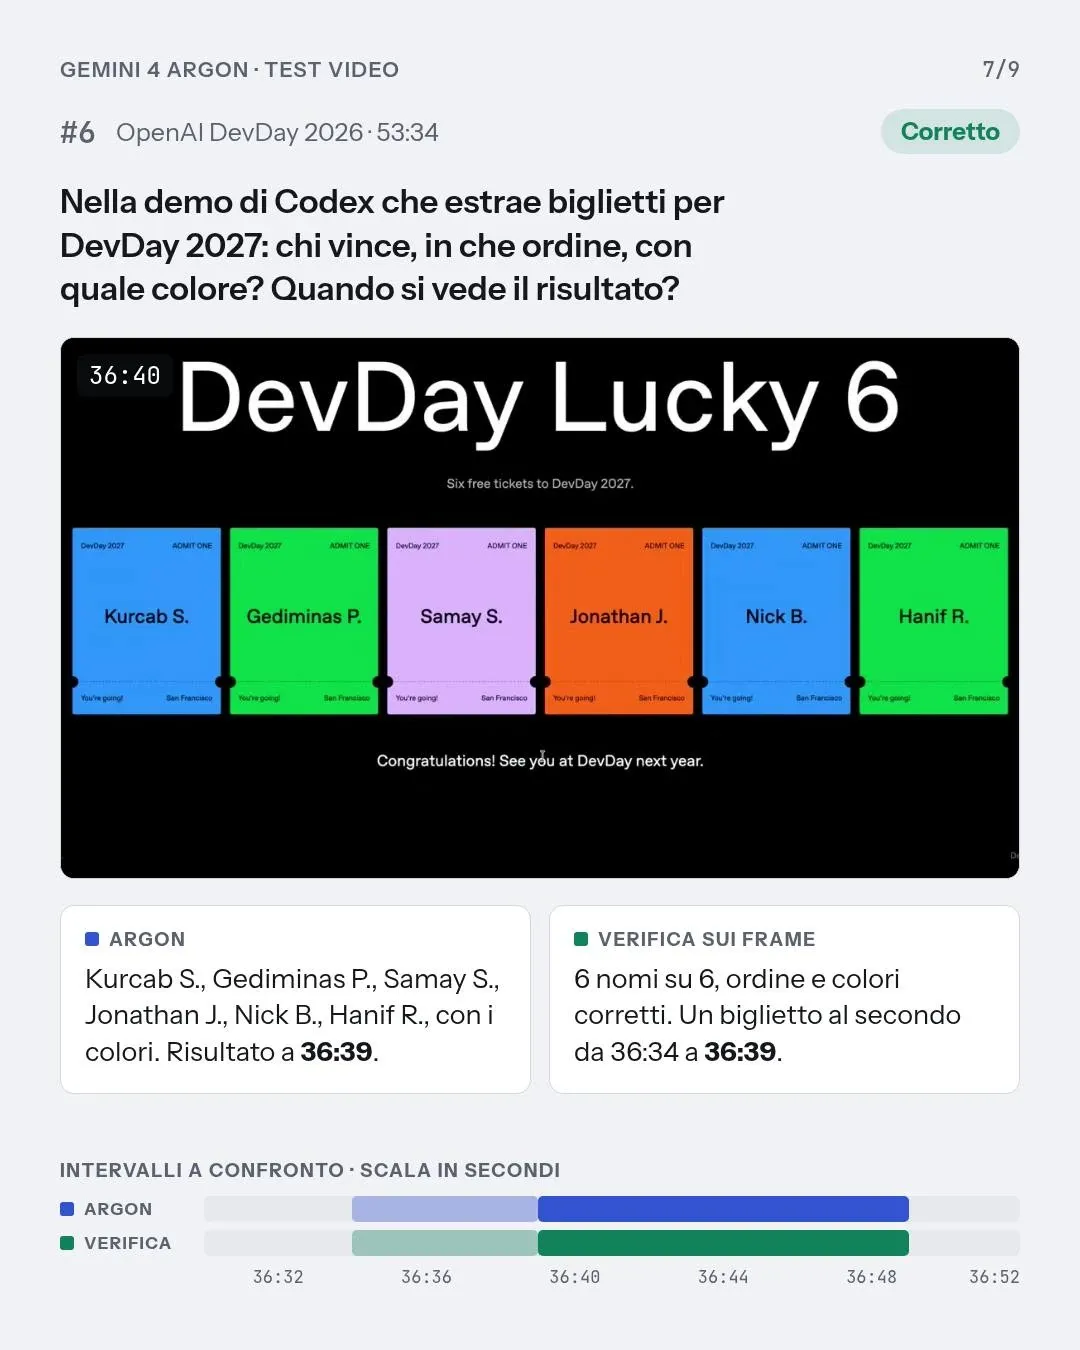
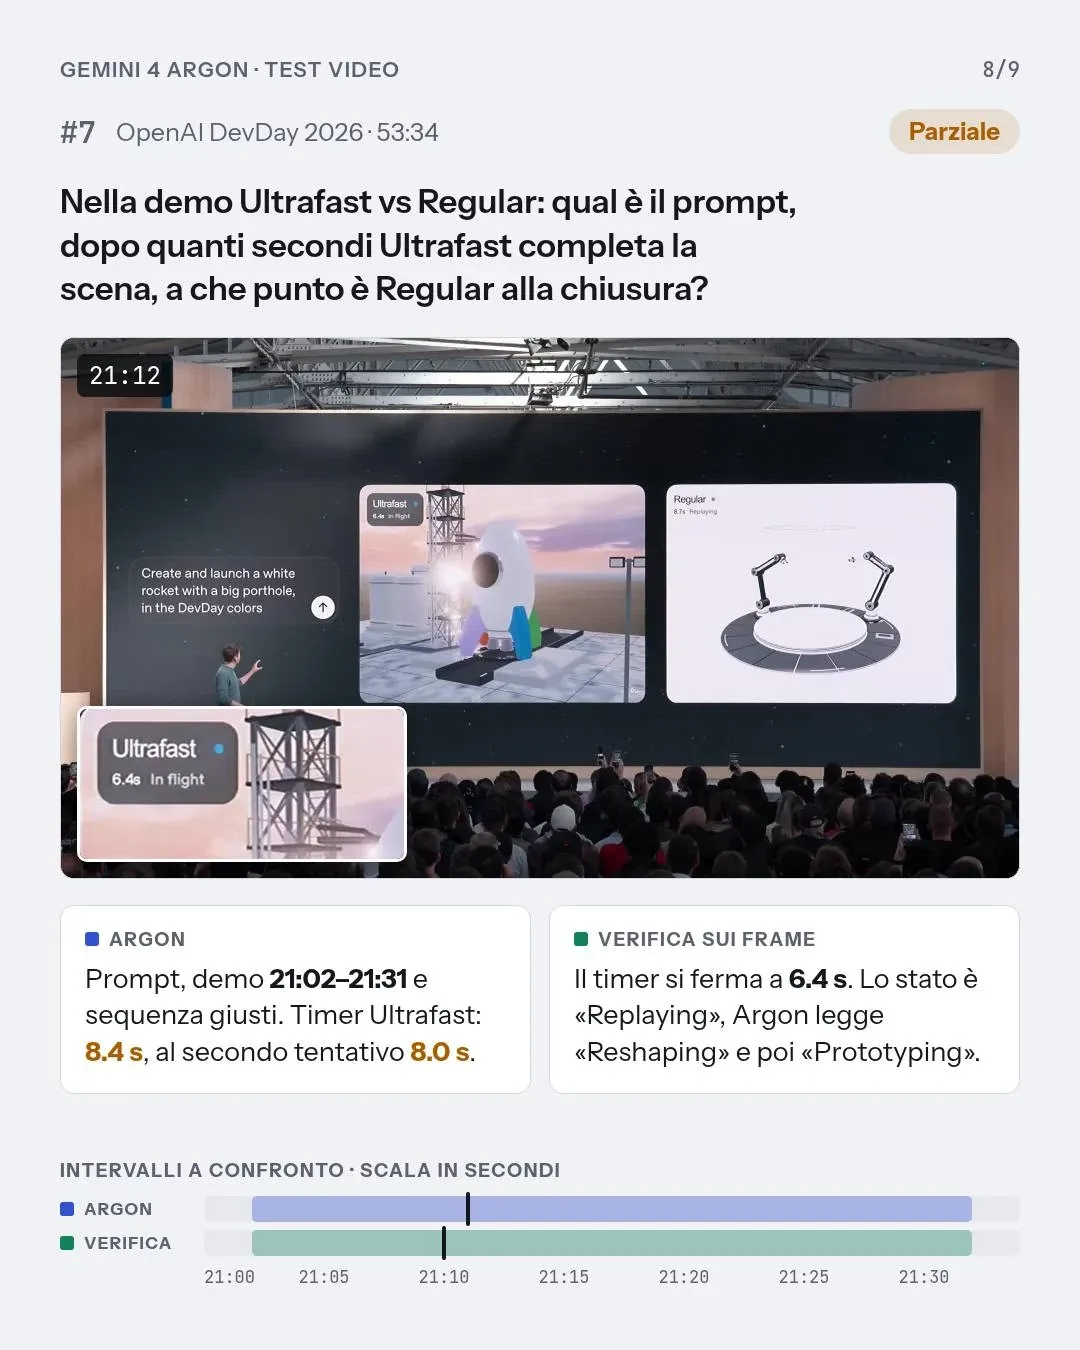
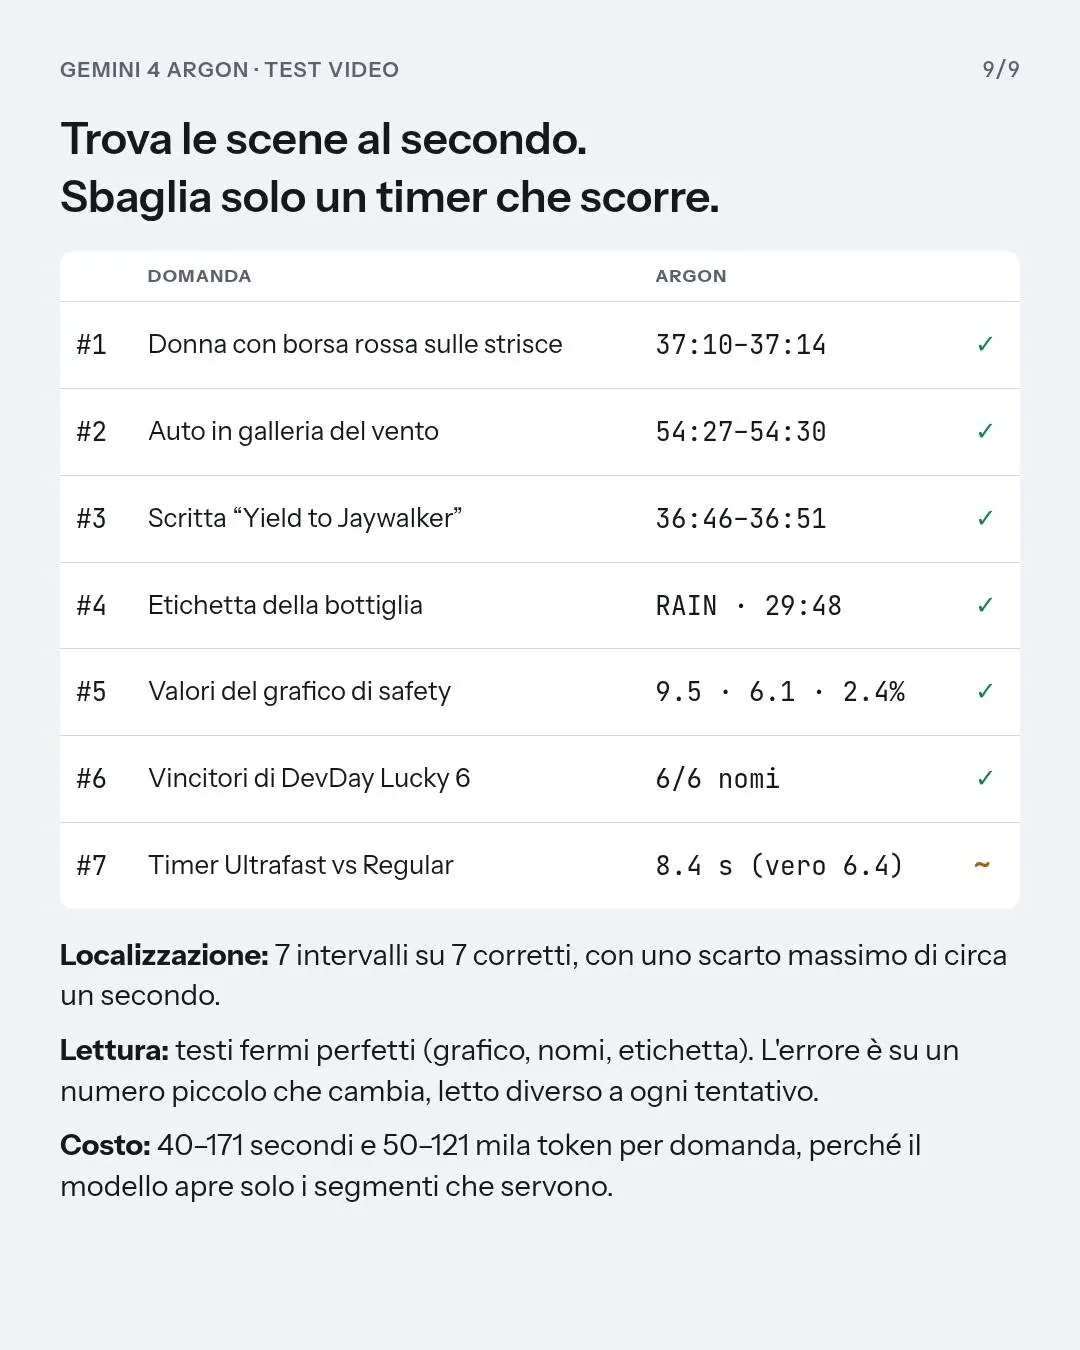
Le sette domande sui video lunghi, con frame e risultati del confronto.
Ogni domanda ha richiesto tra 40 e 171 secondi e tra 50 e 121 mila token totali, ragionamento incluso. Secondo la documentazione, l'elaborazione statica costa circa 100 token per secondo di video: per 91 minuti, circa 550 mila token di solo input.
Nota per chi sviluppa: con l'esecuzione in background la modalità agentic restituiva INVALID_ARGUMENT, in streaming funziona.
Per un sistema reale ne deriva una divisione dei compiti:
Argon trova il momento, poi si estrae quel frame a piena risoluzione quando la risposta dipende da una cifra.
In queste prove la ricerca nel video è stata affidabile; la lettura di valori piccoli e dinamici va ancora verificata.
Spiegazioni da esplorare: il mio confronto tra ChatGPT e Gemini
ChatGPT (Astra) e Gemini (Argon) possono trasformare una richiesta di spiegazione in uno schema interattivo da esplorare. Nel video il tema è la differenza tra un motore a quattro tempi e uno a due tempi: pistoni in movimento, fasi del ciclo e controlli per osservare cosa accade durante la rotazione dell'albero motore.
Affiancare i due schemi permette di collegare il movimento dei componenti alla sequenza delle fasi. Fermare l'animazione o avanzare lungo il ciclo aiuta a seguire il rapporto tra posizione del pistone, apertura dei passaggi e ricambio dei gas. Una definizione come "un ciclo ogni due giri" acquista un riferimento visivo che possiamo percorrere e confrontare.
Spiegazioni interattive: ChatGPT vs Gemini
Possiamo scegliere come consultare la spiegazione: soffermarci su un passaggio, tornare indietro, confrontarlo con l'altro motore e chiedere un approfondimento. Anche il rapporto tra pistone, biella e albero può diventare uno schema dedicato. La conversazione permette di costruire rappresentazioni successive intorno al dubbio che emerge.
OpenAI descrive una direzione coerente con questo approccio con Intelligent UI per GPT-6: risposte che combinano testo, visuali ed elementi interattivi in funzione della domanda. Il modello compone l'interfaccia usando una libreria di componenti nativi, che vengono visualizzati progressivamente. Anche il formato della risposta diventa parte della spiegazione.
Questo può rendere la consultazione più interessante perché dà al lettore un ruolo attivo. Muovere un controllo significa fare una piccola ipotesi e osservarne l'effetto. In probabilità potrebbe voler dire cambiare il numero di prove; in fisica modificare una forza; in un processo aziendale esplorare una dipendenza. Diventa più facile collegare una descrizione astratta a una conseguenza visibile.
L'efficacia dipende dalla coerenza dello schema: movimento, etichette, valori e spiegazione devono descrivere lo stesso fenomeno.
Un'animazione convincente può rendere convincente anche un errore.
Per usarla come materiale didattico serve verificare le relazioni rappresentate e rendere esplicite le semplificazioni.
La capacità di generare questi piccoli ambienti su richiesta apre una possibilità concreta per studio, formazione e documentazione: costruire una spiegazione che si possa esplorare, adattandone il livello di dettaglio a ciò che la persona sta cercando di capire.
SynthID Detector nel mio test: un esito negativo lascia aperta l’origine
Google apre a tutti SynthID Detector, il portale per verificare immagini, video e audio generati con l'AI di Google e dei partner. Come sostengo da sempre, questa è una tecnologia estremamente evoluta e necessaria, ma allo stesso tempo fragile.
SynthID è una famiglia di tecnologie di watermarking sviluppata da Google DeepMind. Inserisce segnali impercettibili direttamente nei contenuti, anche nel testo. Nelle immagini un modello codifica il segnale nei pixel e un altro lo cerca: la provenienza diventa parte del contenuto, senza un marchio visibile.
Il watermark è progettato per resistere a modifiche comuni come ritagli, filtri e compressione. È diverso dai metadati allegati al file: eliminarli non implica cancellare SynthID. Il problema diventa più complesso quando il contenuto viene ricostruito da un altro modello.
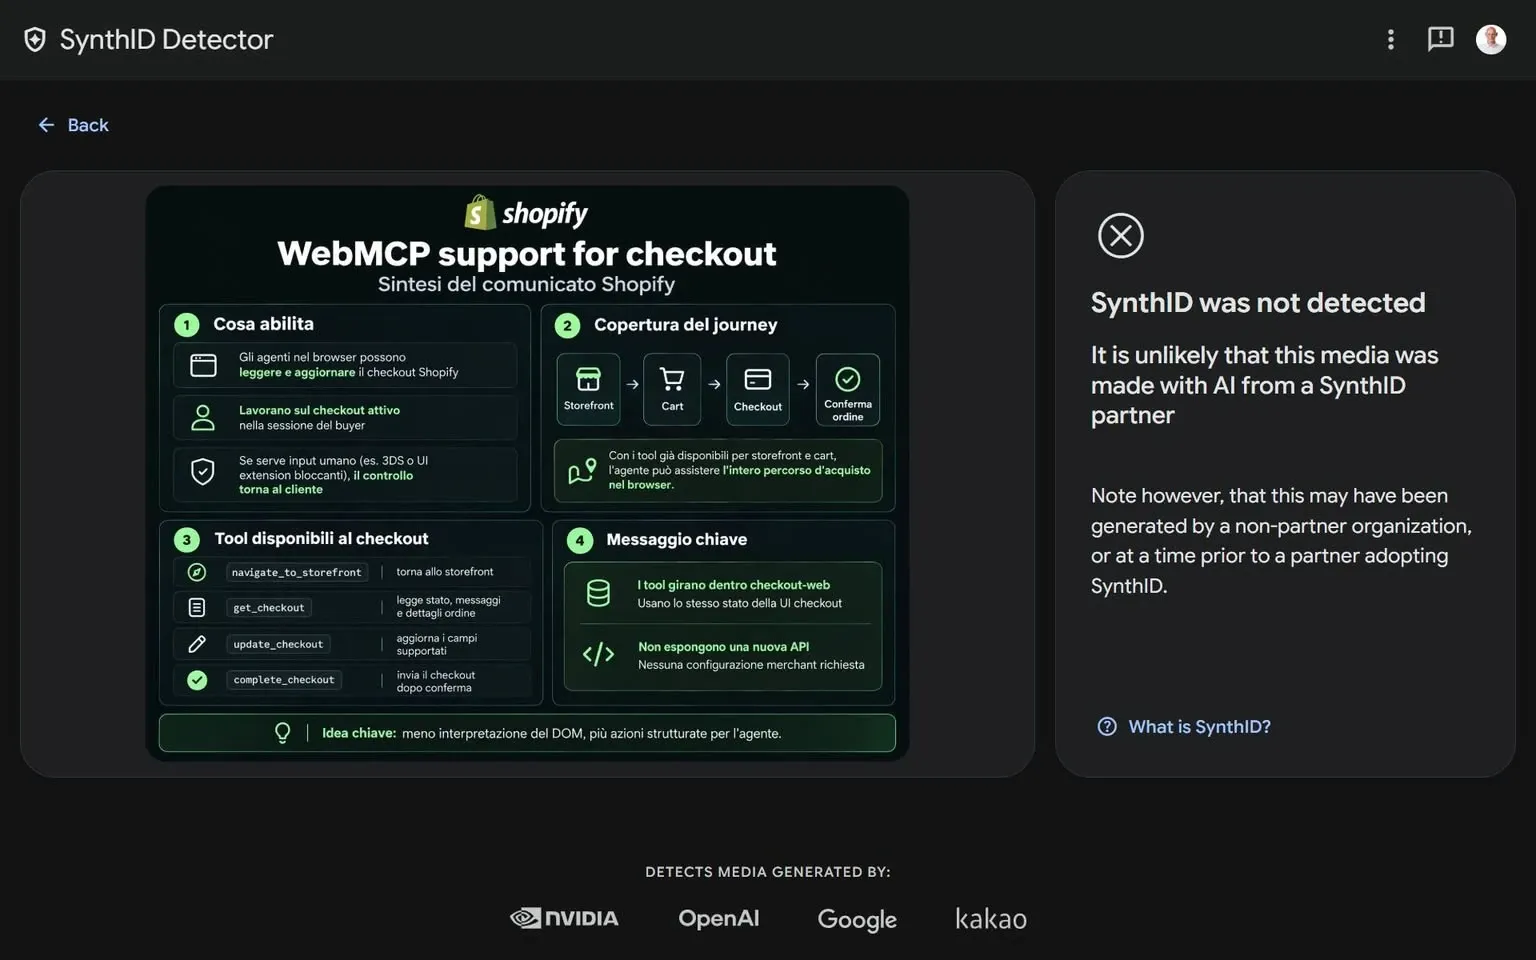
Ho fatto un test sul portale synthid.com. L'immagine che vedete nello screenshot è stata generata con ChatGPT e poi rigenerata fedelmente con un altro modello, ricreando il contenuto senza conservare marker e metadati del file iniziale. Il risultato è «SynthID was not detected». L'immagine resta generata con l'AI, anche se il rilevatore non trova il segnale.
Il test documenta questo esito, ma da solo non dimostra che sia stato rimosso un watermark SynthID: servirebbe anche un rilevamento positivo sull'originale. Il detector cerca marcature dei sistemi che adottano la tecnologia, oggi anche OpenAI, NVIDIA e Kakao. Un risultato negativo non certifica un'origine umana, come precisa la stessa interfaccia.
La fragilità riguarda la continuità della provenienza: un modello può conservare l'aspetto e il significato di un'immagine senza conservarne i segnali identificativi. Somiglianza visiva e persistenza del watermark sono proprietà diverse. La robustezza alle normali modifiche non garantisce resistenza a ogni ricostruzione.
Per questo considero il watermarking necessario, da integrare con credenziali di provenienza come C2PA e verifiche della fonte. Il suo valore dipende anche da come leggiamo il risultato: «nessun segnale rilevato» deve lasciare aperta l'origine del contenuto.
Claude e il sistema enzimatico ART: ipotesi autonome, verifica scientifica
Anthropic ha presentato il primo risultato del suo nuovo laboratorio di biologia: Claude ha scoperto in autonomia un sistema enzimatico mai caratterizzato, ART (array-associated reverse transcriptase), con un'architettura che ricorda CRISPR.
Tutto è partito da una sola istruzione: cercare nuove trascrittasi inverse (RT), gli enzimi che copiano RNA in DNA, in un database da 1,94 miliardi di cluster proteici. 949 sessioni di agenti hanno lavorato per 21,5 ore e 215,6 milioni di token senza intervento umano: 198.290 cluster di RT analizzati, 3.564 famiglie candidate, 19 report consegnati ai ricercatori. Per un esperto, un lavoro da settimane o mesi.
Il momento chiave somiglia a un racconto: un agente, leggendo il DNA grezzo accanto a una RT insolita, annota di vedere "a occhio" un array di ripetizioni "CRISPR-like". Poi fa quel che farebbe uno scienziato: conta le copie, misura le spaziature, confronta con i sistemi noti e con la letteratura, e solo alla fine segnala il candidato.
ART si trova soprattutto nei jumbo phage, i virus dei batteri, e ha tre componenti: la RT, un gene partner e un array di 3-21 ripetizioni. I primi test mostrano che viene trascritto in RNA corti e distinti, fino all'8% degli RNA del fago a 15 minuti dall'infezione. Pochissimi sistemi noti combinano questi tratti, e tutti tagliano, copiano o incollano DNA.
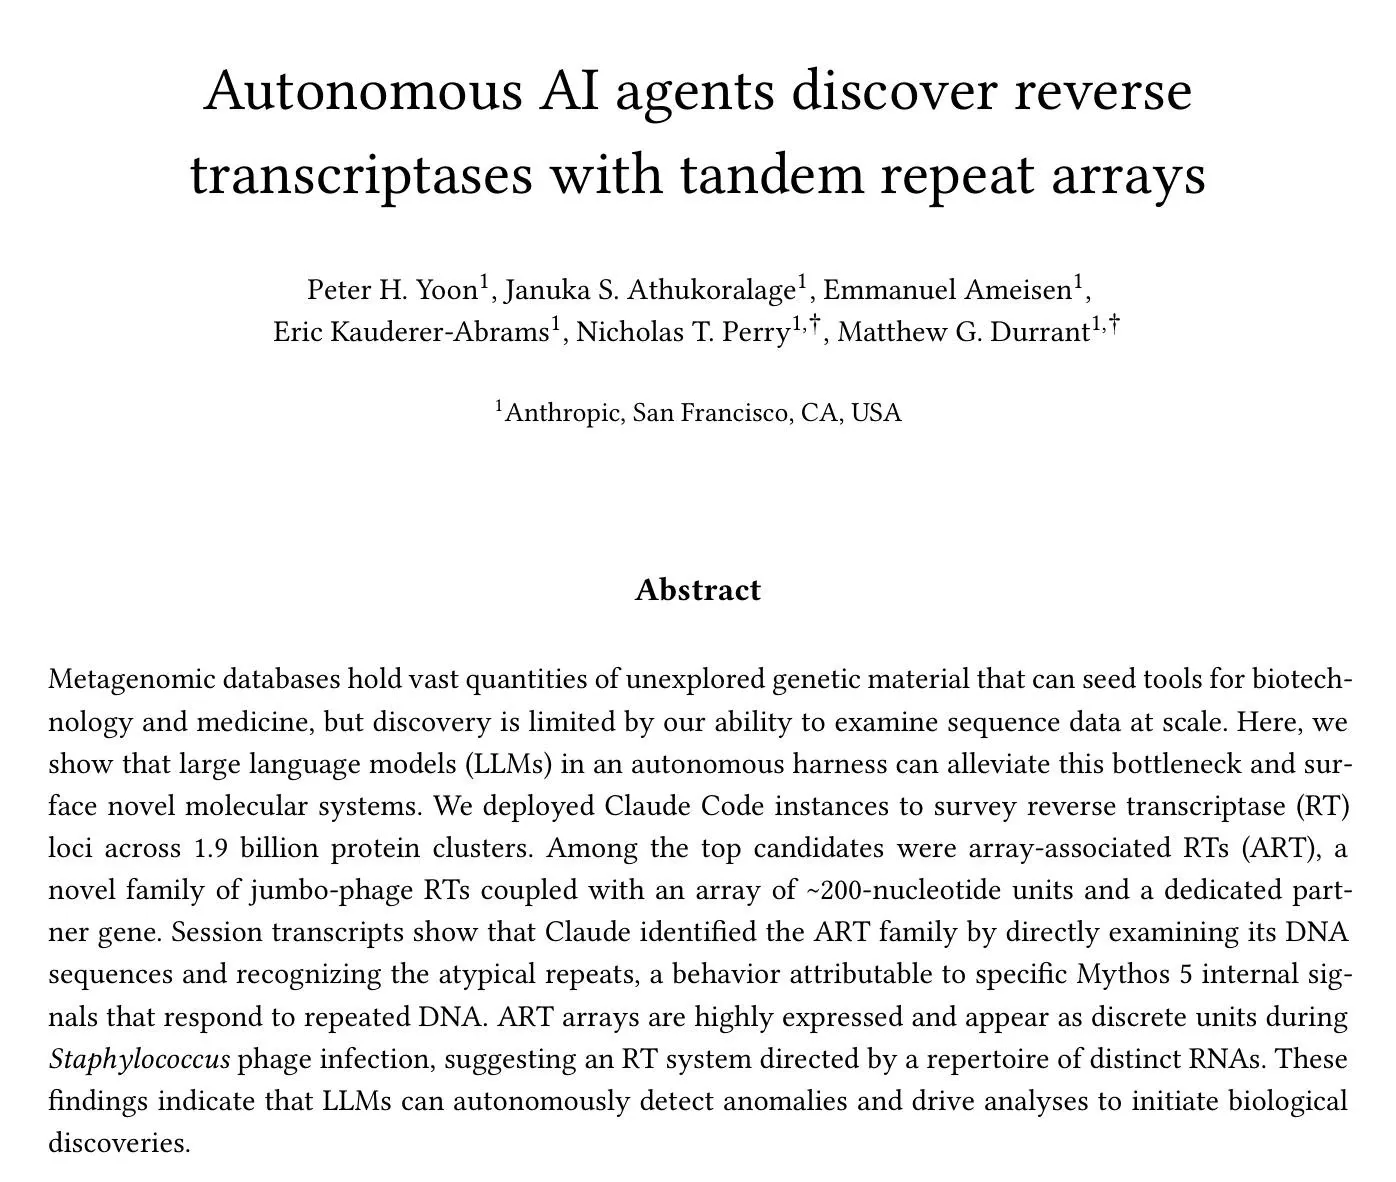
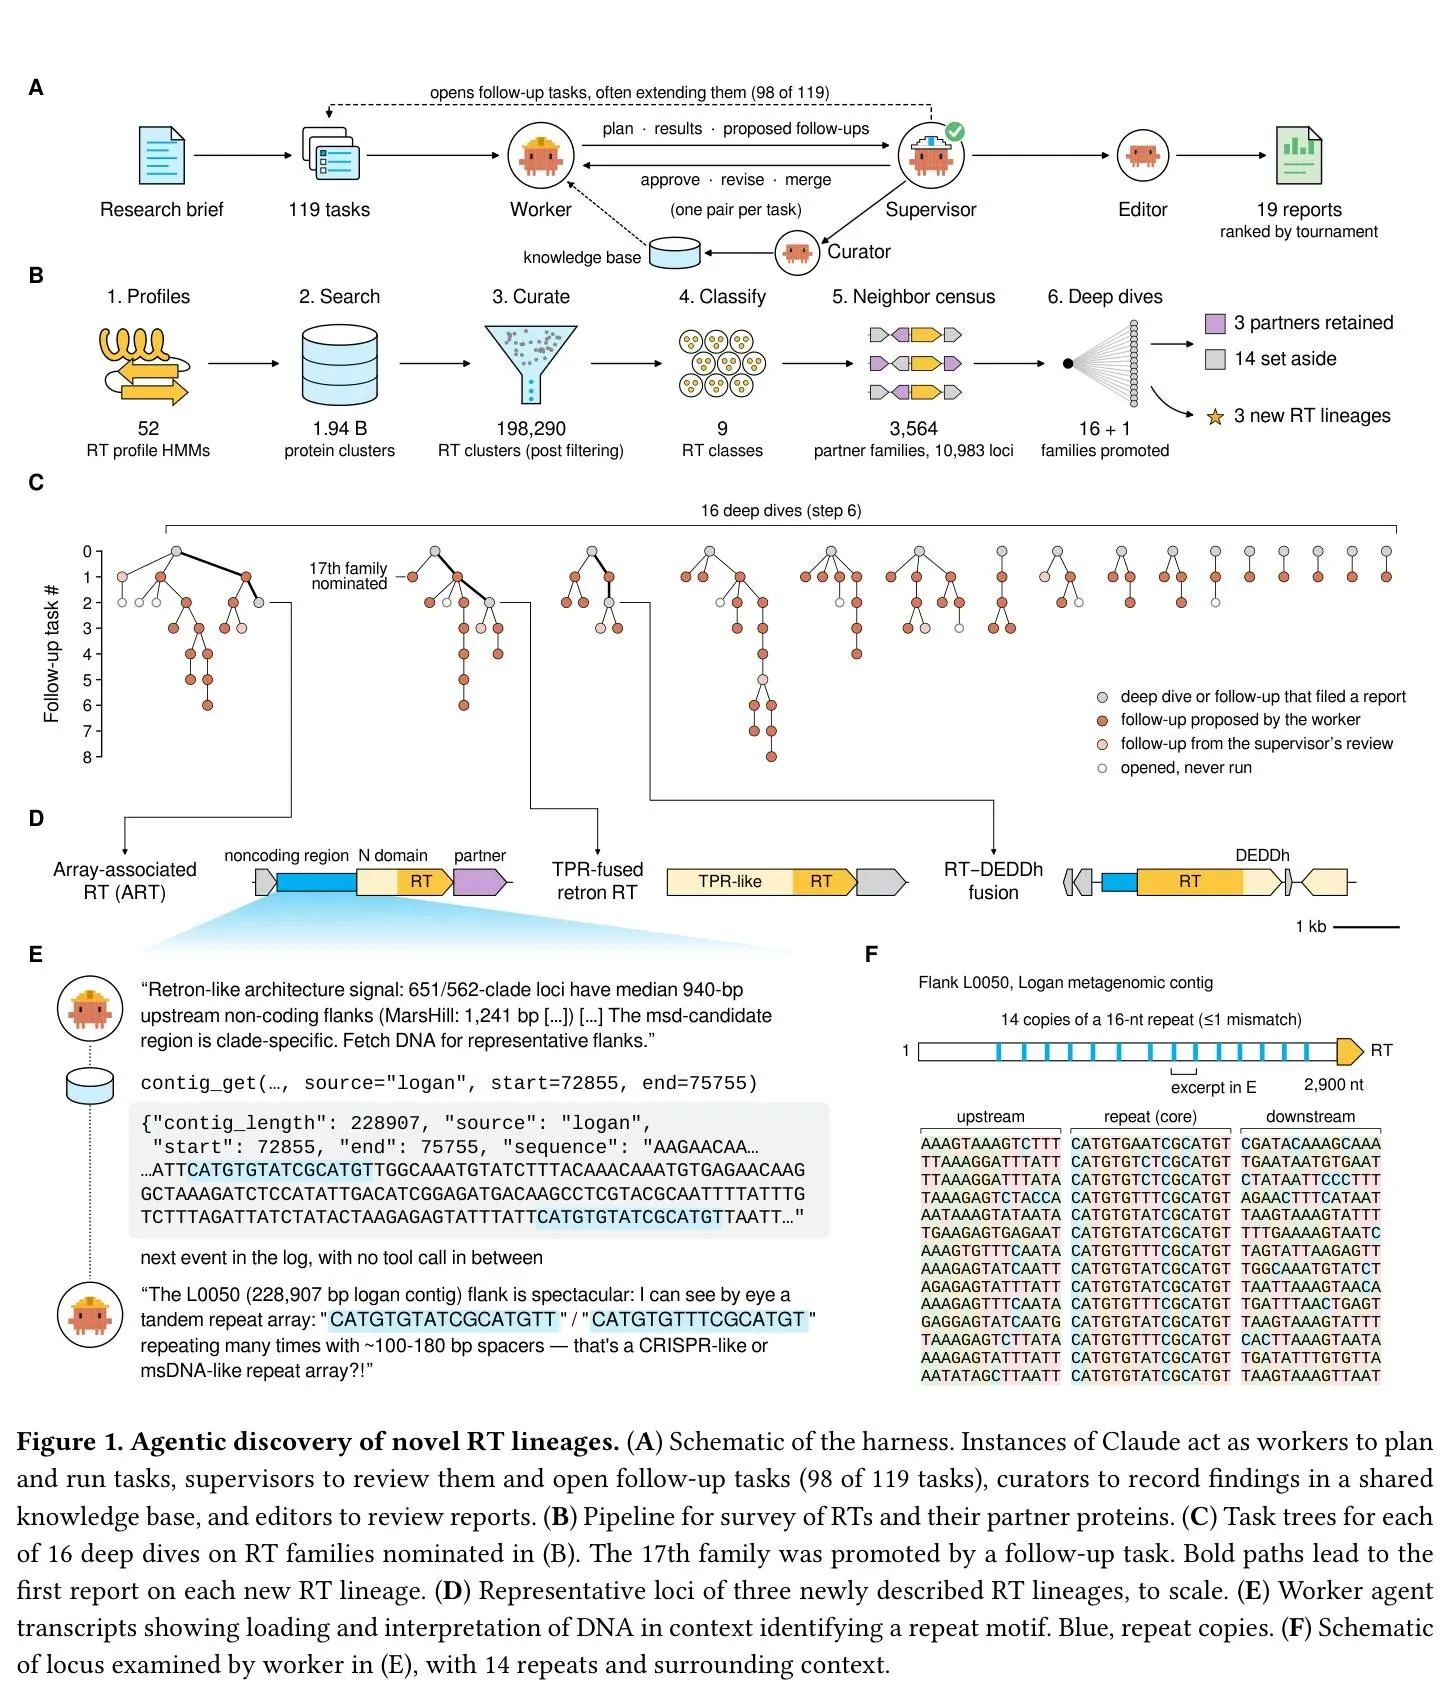
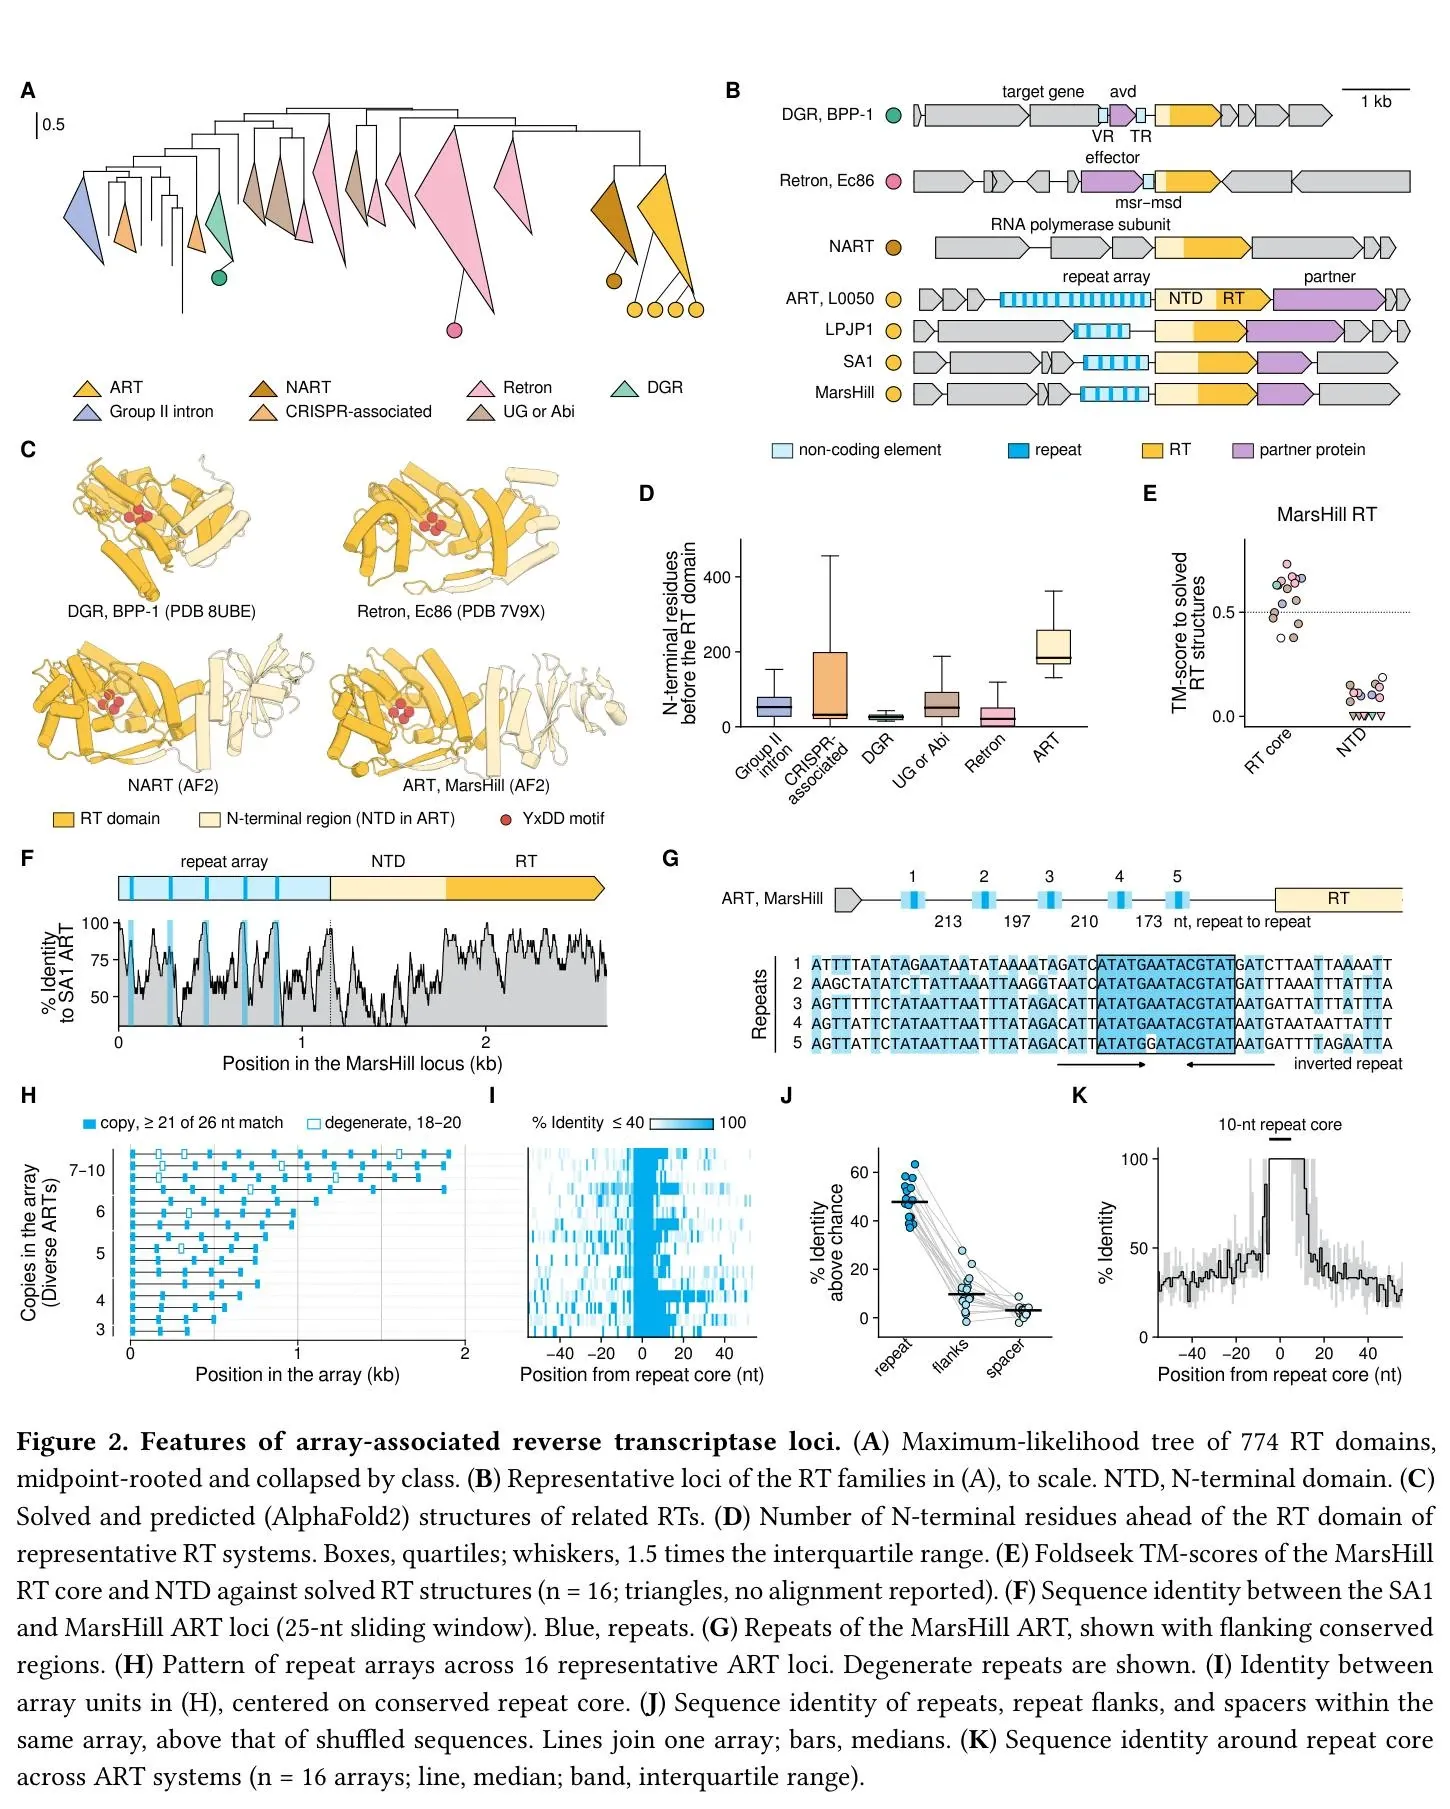
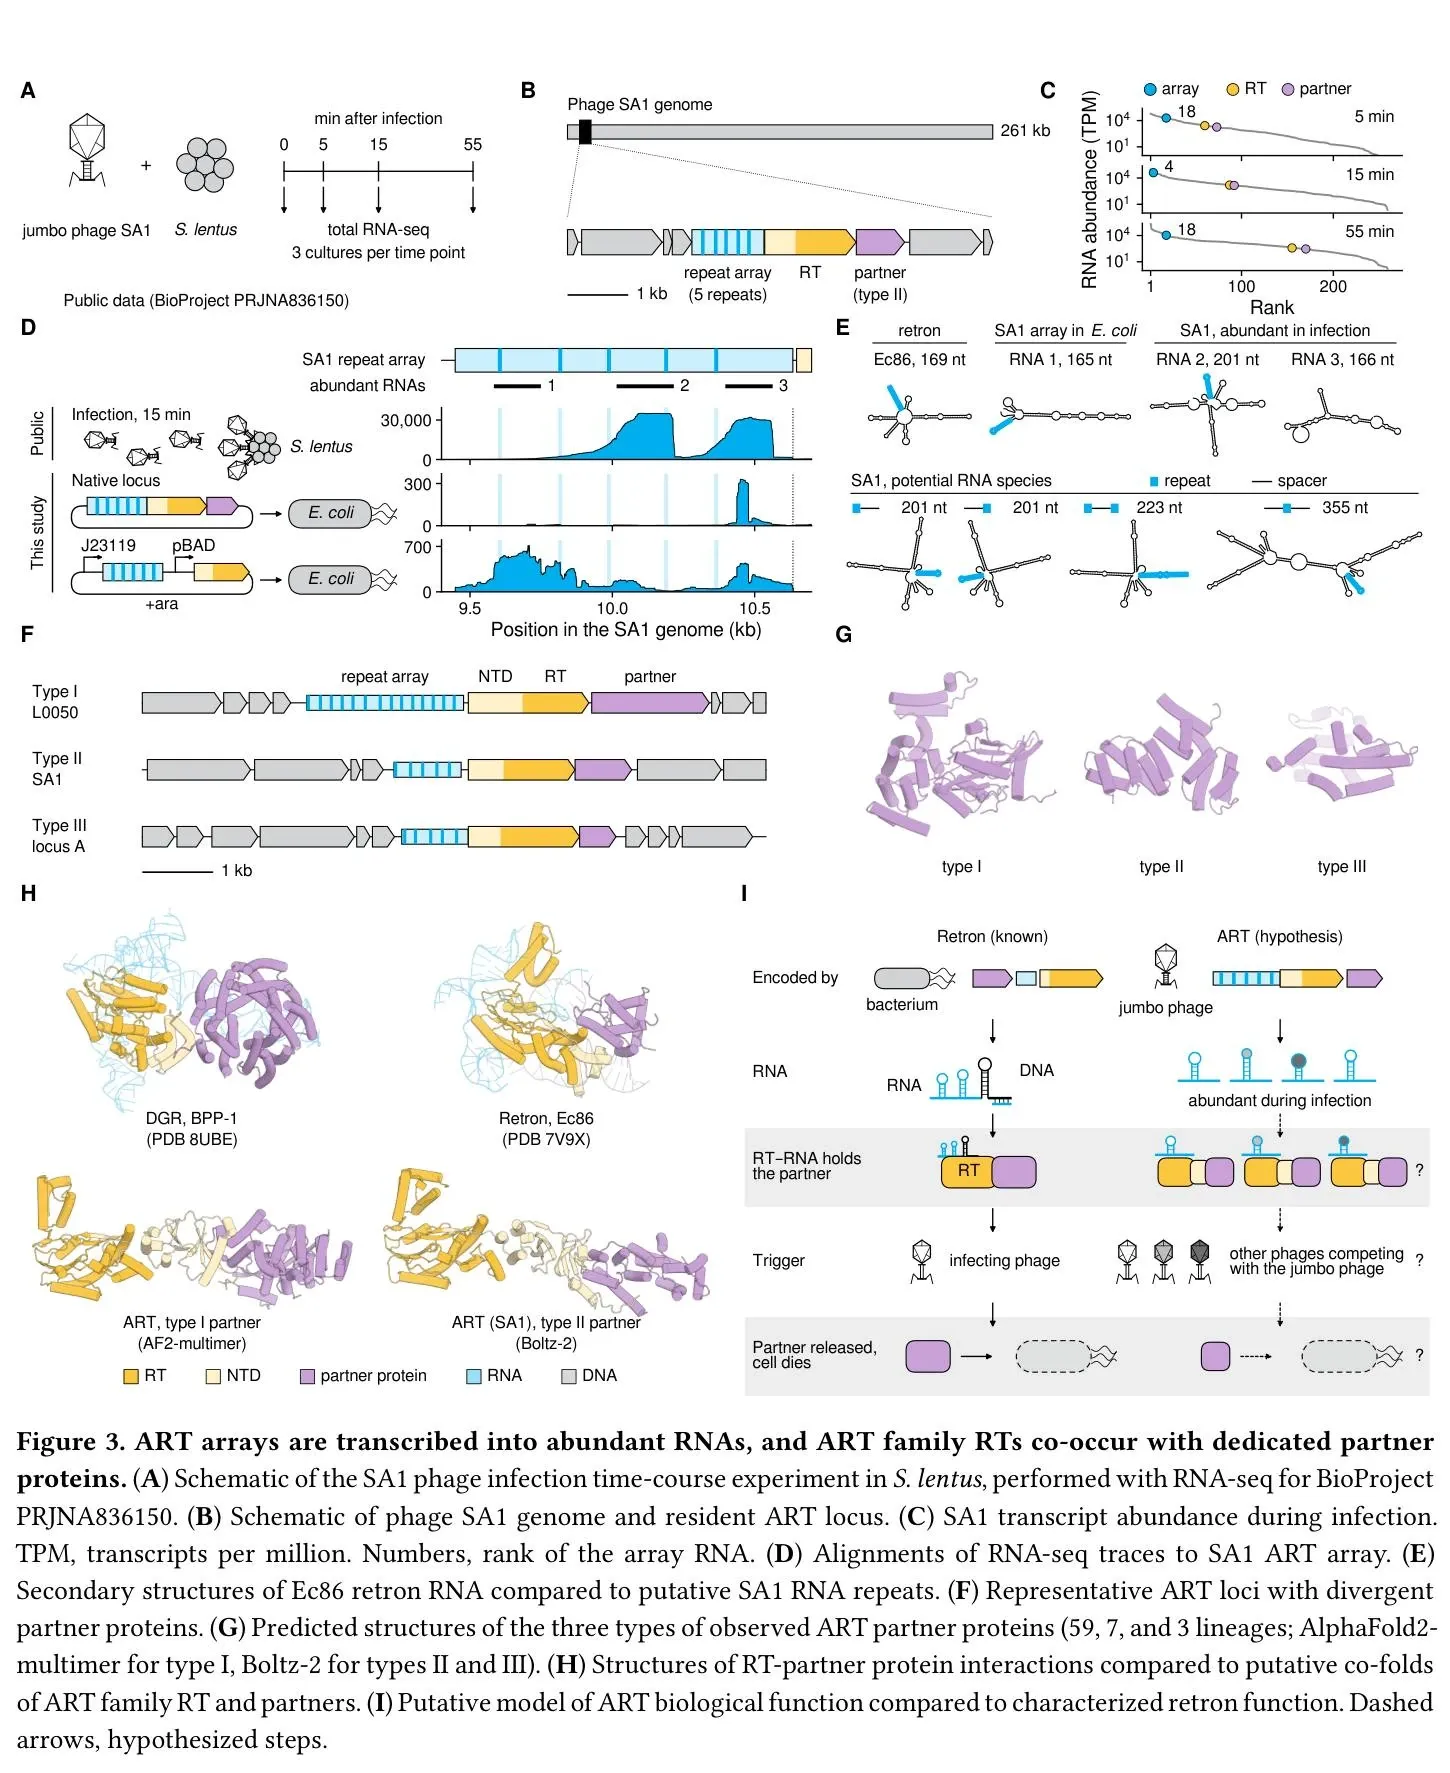
Metodo e prime analisi nel preprint sul sistema ART.
La biotecnologia è cresciuta così: enzimi di restrizione, Taq polimerasi, lo stesso CRISPR — all'inizio solo anomalie notate nella diversità molecolare. Pesa però un fatto: la funzione di ART è ignota. Non è dimostrato che l'enzima sia attivo né che usi quegli RNA, e il pre-print non è peer-reviewed. Amodei stesso ammette che utilità e significato "non sono ancora chiari".
Feng Zhang, pioniere di CRISPR tra MIT e Broad Institute, ha letto il pre-print e lo giudica "genuinely intriguing".
Il valore, a mio avviso, non è il singolo enzima ma il metodo: se generare ipotesi richiede circa 21 ore di elaborazione, il vincolo diventa il giudizio — cosa testare, validare, interpretare. Cambia la divisione del lavoro cognitivo, non il bisogno di scienziati.
Se ART rivelerà una funzione all'altezza delle somiglianze che evoca, ne riparleremo a lungo. Altrimenti resta la prova che un modello sa riconoscere ciò che merita attenzione: il primo atto di ogni scoperta.
TimesFM 3: anticipo metodo, risultati e limiti del mio studio sullo zero-shot
Quanto lontano arriva davvero la previsione "zero-shot"?
Sto lavorando a un paper su TimesFM 3, il modello foundation di Google che prevede serie temporali senza addestramento sui dati del singolo caso: consumi, vendite, prezzi.
Un primato su un benchmark pubblico non basta a rispondere. Se alcune serie fossero già entrate nell'addestramento, il risultato potrebbe confondere generalizzazione e memorizzazione. Servono prove su dati nuovi e confronti con metodi semplici.
Ho costruito un protocollo su cinque livelli, congelando ipotesi e procedure prima di scaricare i dati di test. Riproduco i risultati su fev-bench; valuto dati reali successivi al rilascio, da elettricità e meteo a fiumi, cambi e tassi; confronto su Wikipedia pagine incluse ed escluse dal corpus di addestramento dichiarato.
Aggiungo 7.600 serie sintetiche per isolare trend, stagionalità, rotture e relazioni tra variabili. Infine, previsioni fatte prima che i valori reali esistano, sigillate con hash e marca temporale pubblica: serviranno a verificare cosa il modello aveva previsto davvero.
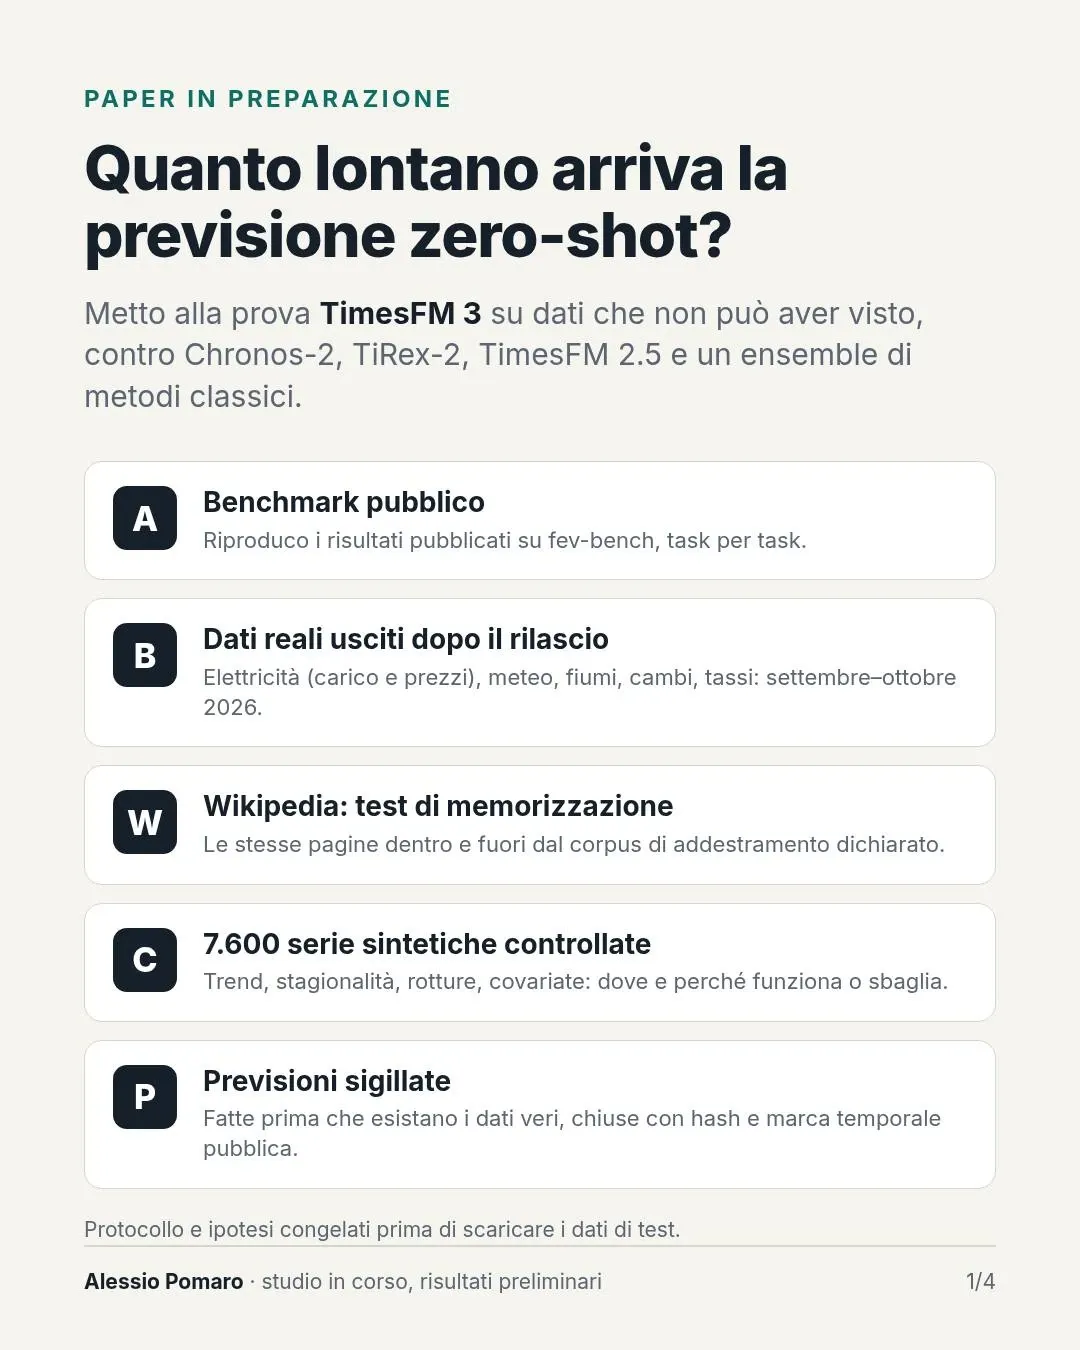
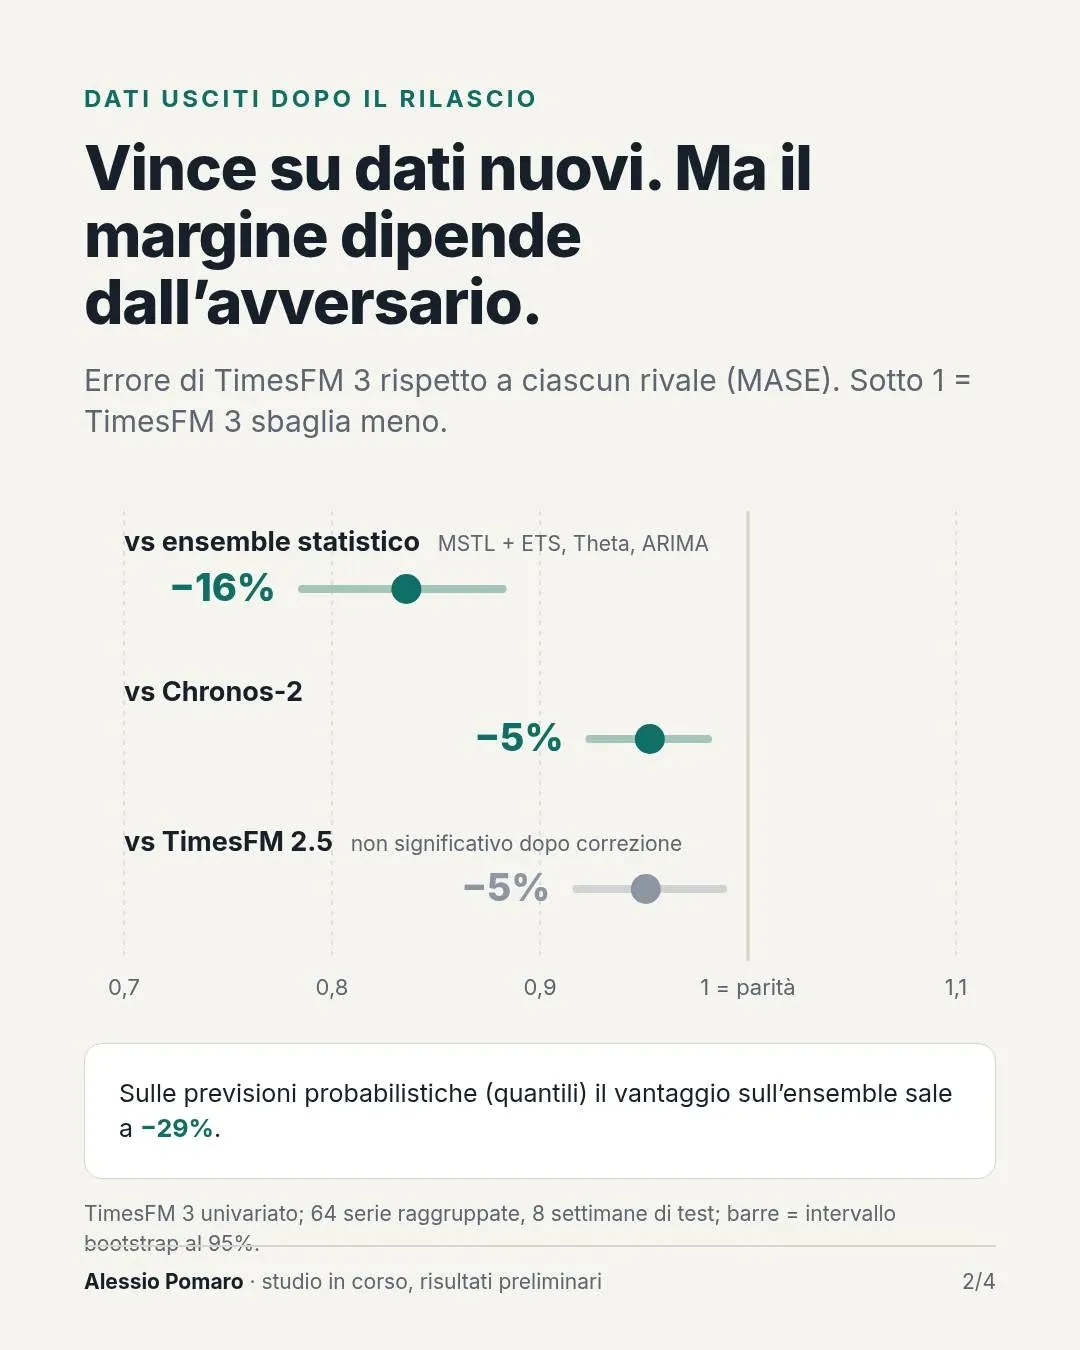
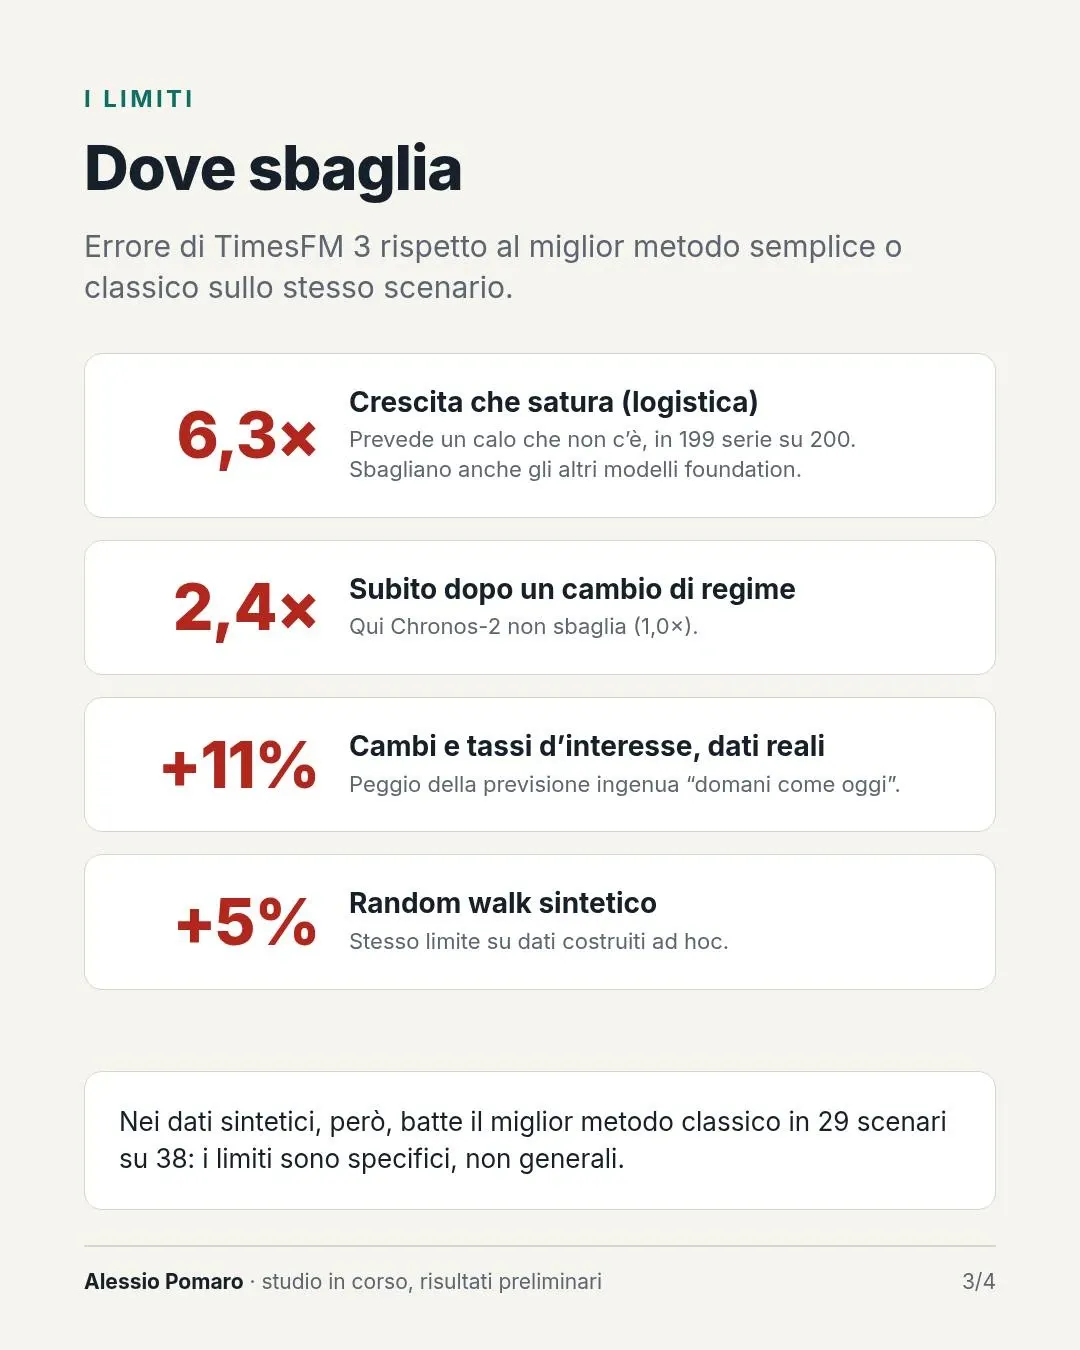
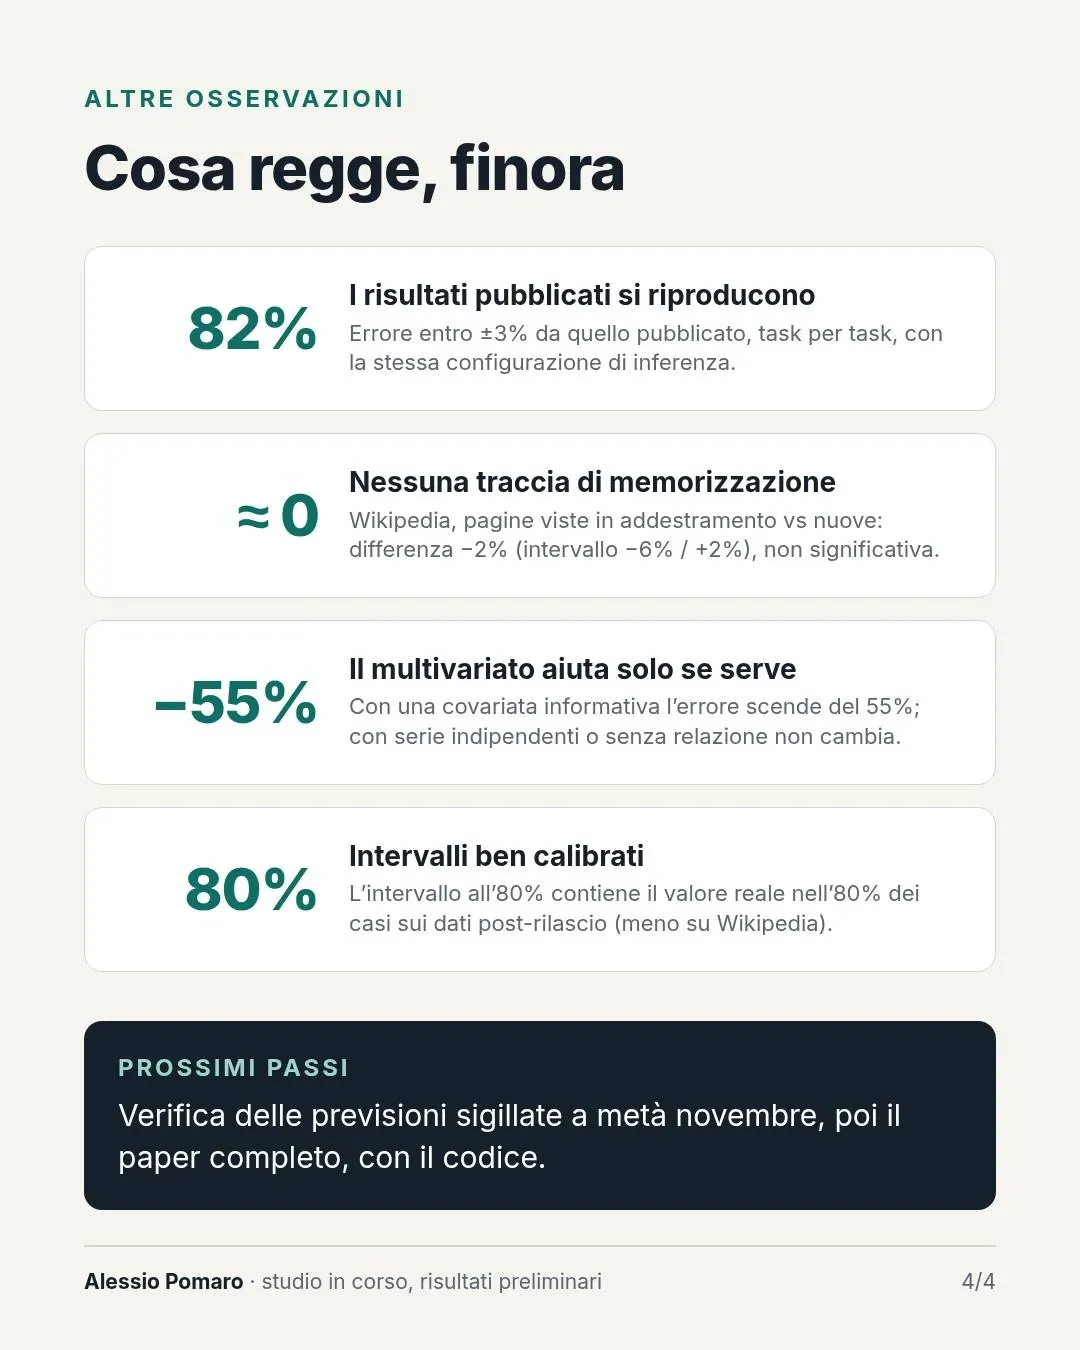
Protocollo, risultati preliminari e limiti dello studio TimesFM 3 in preparazione.
I primi risultati sono preliminari. Sui dati successivi al rilascio, con 64 serie raggruppate e otto settimane di test, TimesFM 3 riduce l'errore MASE del 16% rispetto a un ensemble di metodi statistici. Sulle previsioni probabilistiche la riduzione dell'errore arriva al 29%. Il vantaggio su Chronos-2 è circa il 5%; quello su TimesFM 2.5, simile, non è significativo dopo la correzione statistica.
Nel test su Wikipedia non emergono evidenze significative di memorizzazione. Nei test con più variabili, una covariata informativa riduce l'errore del 55%; aggiungere serie prive di relazione non aiuta.
I limiti sono specifici. Su cambi e tassi l’errore è superiore dell’11% a quello della previsione "domani come oggi". Subito dopo un cambio di regime arriva a 2,4 volte quello del miglior metodo semplice o classico; su una crescita che satura prevede spesso un calo inesistente. Nei sintetici, però, batte il miglior metodo classico in 29 scenari su 38.
Nelle immagini anticipo metodo e risultati. Dopo la verifica delle previsioni sigillate, prevista per metà novembre 2026, l'obiettivo è pubblicare il paper completo e il codice nella seconda metà di novembre.
Per chi prevede domanda e vendite, questi risultati indicano un punto di partenza promettente.
L'affidabilità va misurata sul proprio scenario, includendo sempre una baseline semplice e i periodi in cui il processo cambia.
Contesto verificabile e calcolo: la lezione di Anjney Midha a Stanford
Nella lezione di apertura di "Frontier Systems" a Stanford, Anjney Midha (fondatore di AMP PBC, ex Andreessen Horowitz) propone una tesi netta: nell'AI la frontiera avanza dove il contesto è verificabile, e il valore va a chi controlla quel contesto.
Il meccanismo è un doppio ciclo. Il modello va in produzione e l'inferenza restituisce due cose: ricavi, per comprare nuovo compute, e contesto. Per un assistente al coding: repository, cronologia git, esito dei task. Quel contesto rientra nel reinforcement learning, dove al modello non si spiega come risolvere un compito: riceve una ricompensa quando lo completa. Secondo Midha, oggi questa fase assorbe quasi tanto calcolo quanto tutto il resto della pipeline di training.
Frontier Systems - Anjney Midha a Stanford
Ne deriva la sua lettura di chi vince: i team con un accesso unico e difendibile a un contesto. Chi ne resta escluso non può migliorare. L'esempio è Windsurf: dopo la notizia dell'acquisizione da parte di OpenAI, Anthropic ha interrotto l'accesso ai propri modelli, perché un concorrente avrebbe potuto osservarne il comportamento sui clienti e distillarlo. Per gli Stati, lo stesso principio spiega la domanda di modelli da eseguire in locale, come quelli di Mistral.
Sui limiti dell'RL Midha è prudente. Non vede ancora prove che l'apprendimento si generalizzi fuori dalla distribuzione dei task, per esempio dal coding alla biologia. Il progresso corre dove la verifica è facile, come nel codice con i test, e rallenta dove manca un verificatore: estetica, gusto, scrittura lunga. Un amico ha capito in trenta secondi che Midha aveva sviluppato un testo con Claude, per gli em dash e le formule "non è X, è Y". In AMP ora vale una regola: niente documenti generati dall'AI tra colleghi.
Anche sul compute la posizione è controcorrente: non è una commodity. Nei dati raccolti da AMP il noleggio delle H100, uscite oltre due anni fa, sta salendo, non scendendo. E non è fungibile: H100, GB200 e B300 non sono intercambiabili, e la domanda è difficile da prevedere, perché il training procede a picchi e l'inferenza segue i cicli della giornata.
Per Midha siamo nell'era pre-standardizzazione del compute, come ferrovie ed elettricità prima di standard condivisi e istituzioni capaci di imporli. Se ha ragione, il vantaggio dei prossimi anni dipenderà da due accessi più che dal modello: a un contesto verificabile e a una capacità di calcolo che oggi non si compra come l'elettricità.
Reti neurali e cervello: tre domande da tenere distinte
Le reti neurali sono davvero ispirate al cervello umano, o stiamo prendendo la metafora troppo alla lettera?
A rispondere è Giorgio Gilestro, neuroscienziato dell’Imperial College London, ospite di “In missione per capire l’AI”, puntata 6 di ZiP. Consiglio di guardarla o ascoltarla: il confronto con Salvatore Sanfilippo (antirez) ed Enrico Mensa (Enkk) distingue bene somiglianze, differenze e domande aperte.
Reti neurali e cervello - Giorgio Gilestro
L’analogia regge sul singolo neurone, che emette un segnale oppure no. Nella rete il cervello combina neuroni eccitatori e inibitori, neurotrasmettitori e neuromodulatori, aree con anatomie specializzate. Negli LLM la stessa struttura si ripete “come uno stampino”: sull’architettura, la metafora è fuorviante.
Gilestro vede però una convergenza funzionale: i Mixture of Experts separano il lavoro tra componenti; nei sistemi agentici uno controlla l’altro, come il “diavoletto” e l’“angioletto” che filtrano i nostri impulsi. Analogie trovate a posteriori, forse perché modelli e persone lavorano sugli stessi dati: il linguaggio umano.
La sua proposta è studiare la “psicologia” degli LLM prima della loro “neuroscienza”: comportamento, bias, eventuali equivalenti delle illusioni ottiche. Il cervello resta una fonte di ipotesi, non la garanzia di meccanismi identici.
Sulla coscienza, Gilestro chiama “sciovinismo biologico” l’idea che solo un essere di carbonio possa avere un’esperienza come la nostra: per lui è un limite autoimposto. È una posizione, non la prova che i modelli siano coscienti.
Anche tra esseri umani l’esperienza interiore varia. Gilestro è afantasico dalla nascita: a occhi chiusi non vede immagini, tranne nei sogni. Per anni ha creduto che fosse così per tutti.
La riflessione che ne ricavo è un invito alla precisione. Chiedere se un LLM “è come il cervello” mescola tre domande: come è fatto (struttura), cosa sa fare (capacità), se prova qualcosa (esperienza soggettiva). Servono strumenti diversi: analisi dei meccanismi interni, esperimenti sul comportamento e, per l’ultima, una misura condivisa che ancora manca.
Confondere i livelli produce errori simmetrici: “si chiamano reti neurali, quindi pensano come noi” oppure “è solo un’equazione, quindi non può essere intelligente”, sicurezza che Gilestro nota in chi ha una formazione quantitativa. Entrambe partono da un solo livello.
Una somiglianza può aprire una ricerca; da sola non ne stabilisce la conclusione.
Scegli questo sito web come fonte preferita
Ricevi più facilmente questi contenuti tra i risultati di Google.
Potrai modificare questa preferenza in qualsiasi momento dalle impostazioni di Google.
- GRAZIE -
Se hai apprezzato il contenuto, puoi
contribuire al progetto con una donazione 🙂