Efficienza degli agenti AI: come ridurre token e costi senza perdere qualità
Una demo “wow” non è un punto di arrivo: un agente AI diventa utile quando è efficiente. Da un progetto reale, 7 concetti per ridurre token, costi e rumore: tool bloat, payload, budget, web search, costo per task e Programmatic Tool Calling.
Lavorare con gli agenti AI è straordinario. A tratti magico.
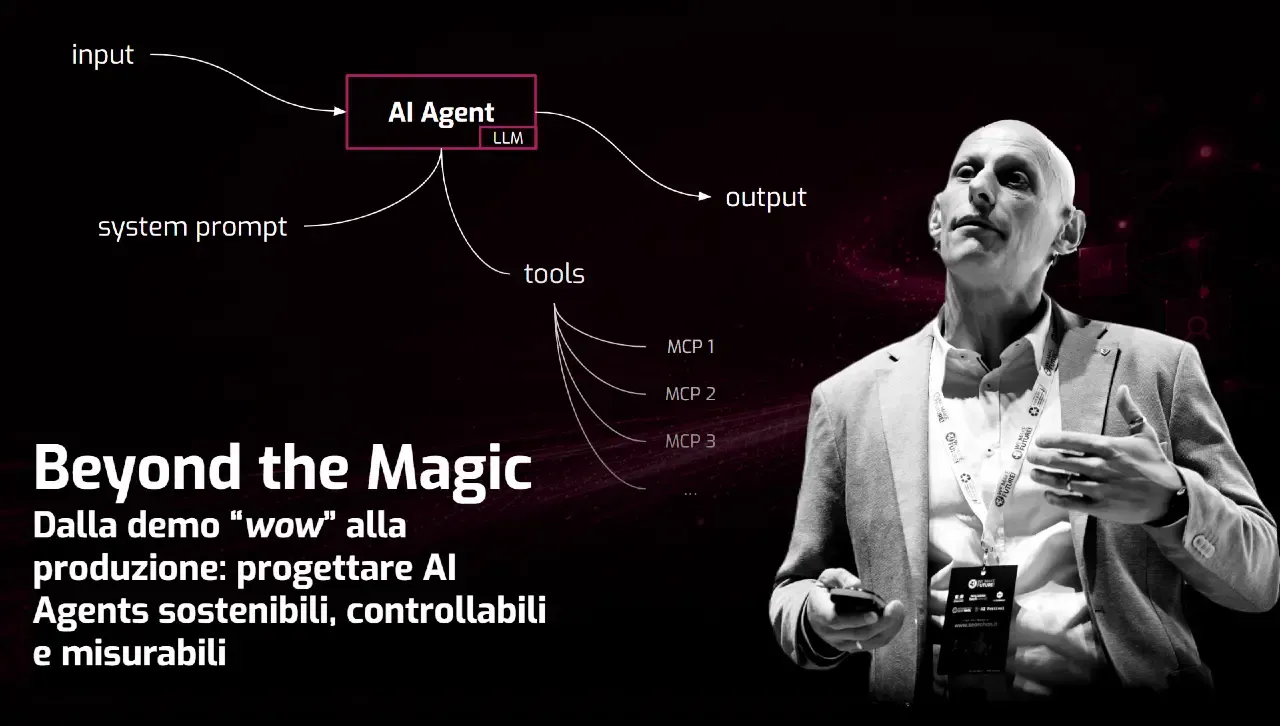
Creiamo l'agente, scegliamo il modello, scriviamo un system prompt curato, colleghiamo i tool via MCP (un'altra piccola magia di questa tecnologia), gli diamo l'input e otteniamo un output perfetto. L'effetto wow da post social è garantito!
Ma quando lo mettiamo in produzione?
In una demo premiamo l'autonomia. In produzione, l'autonomia senza controllo diventa costo.
Di questo ho parlato al WMF - We Make Future 2026, con l'intervento "Beyond the Magic".
Beyond the Magic: dalla demo "wow" alla produzione - WMF 2026
Qui ripercorro il viaggio, raccontato attraverso un progetto reale, e aggiungo alcuni aspetti che ho approfondito dopo l'evento.
Per approfondire questi temi e capire come applicarli concretamente al marketing, ho organizzato un seminario tecnico e operativo dedicato agli Agenti AI per il Marketing.
Dalla demo alla produzione: vedremo come trasformare le sperimentazioni in soluzioni concrete, affrontando le scelte tecniche e operative che fanno davvero la differenza.
Il progetto: un agente che costruisce il piano editoriale
Facciamo un esperimento, che in realtà è un progetto vero: costruiamo un agente AI in grado di produrre piani editoriali data-driven per un team editoriale.
Un LLM performante, un system prompt dettagliato che descrive ogni aspetto del comportamento, uno user prompt altrettanto preciso. E poi i tool:
- la web search nativa del framework agentico;
- il server MCP di DataForSEO, che estrae dati da Google Trends, SERP, YouTube, Google News, query e volumi di ricerca;
- altri server MCP per i post social di Instagram e TikTok, per intercettare i trend che stanno esplodendo.
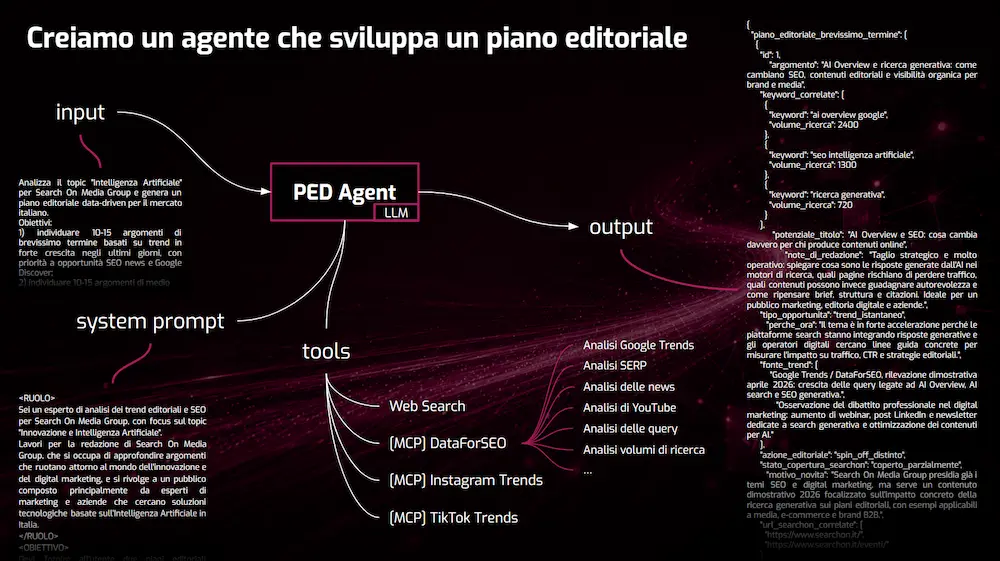
Facciamo partire il processo. Dopo qualche minuto, l'output è pronto. È il piano editoriale perfetto: contenuti da sviluppare, query di ricerca da intercettare, note editoriali.
Ma.. c'è un enorme "ma".
I token in input sono elevatissimi. Siamo al limite della finestra di contesto del modello. Con due conseguenze:
- un rischio: perdere precisione e affidabilità, perché il modello lavora su un contesto enorme;
- un problema: il costo, insostenibile per l'obiettivo dell'applicazione.
Quale componente del workflow impatta maggiormente nei consumi? L'analisi dei trend social.
A questo proposito, una parentesi sul contesto. Studi come Lost in the Middle e Context Rot mostrano che un contesto più grande non produce automaticamente un ragionamento migliore. Tutti i modelli frontier testati degradano all'aumentare della lunghezza dell'input, e il degrado arriva prima del limite tecnico. Non è una questione di capacità dei modelli, ma di rumore.
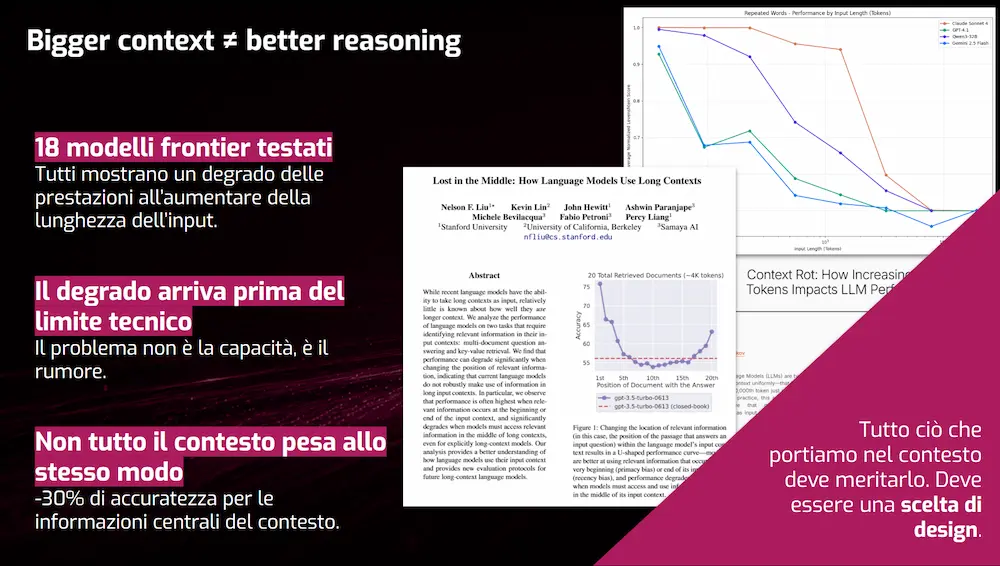
Tutto ciò che portiamo nel contesto dell'agente deve meritare di essere presente. E questa deve essere una scelta di design.
Da questo progetto ho ricavato 7 concetti, che raggruppo in quattro azioni utili a rendere più efficienti i nostri agenti: Ridurre → Guidare → Controllare → Osservare.
1) Ridurre: l'agente non deve vedere tutto
Il primo concetto: l'agente deve vedere solo ciò che gli serve per decidere.
Nel nostro esempio, i trend social arricchiscono sicuramente il processo. Ma serve davvero il reasoning di un agente per questo step?
Attenzione: l'obiettivo non è togliere informazioni all'agente. È togliere dal suo loop operativo ciò che può essere elaborato in modo più efficiente.
Il loop operativo è l'orchestrazione che l'agente mette in atto: riceve l'obiettivo, produce un piano d'azione, usa dei tool, valuta gli output, e così via, fino al raggiungimento della missione. Cosa deve stare dentro e cosa fuori?
| Dentro al loop (le decisioni) | Fuori dal loop (le elaborazioni) |
|---|---|
| scegliere le fonti | raccogliere dati grezzi |
| valutare le opportunità | normalizzare i trend |
| confrontare alternative | deduplicare |
| produrre l'output finale | filtrare il rumore, comprimere i segnali |
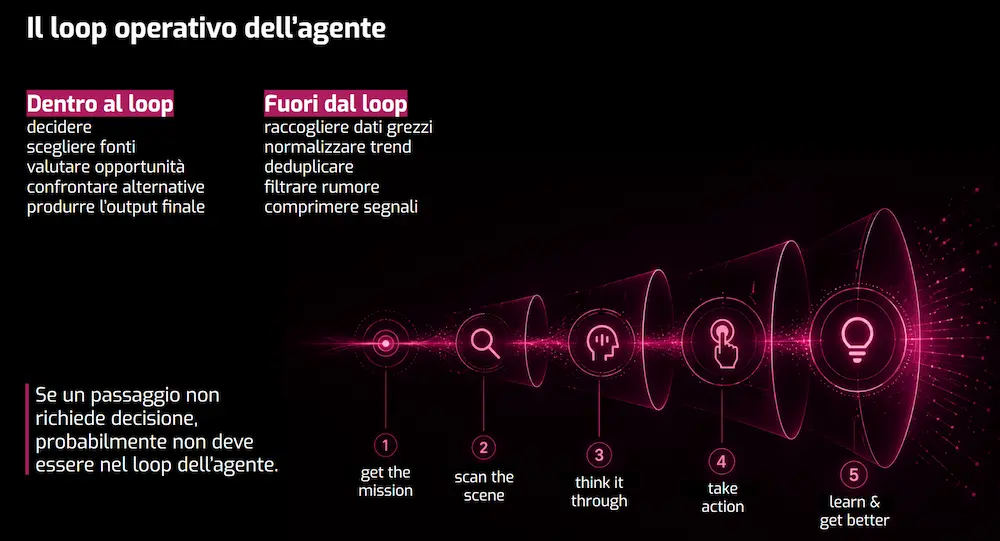
La regola è semplice:
Se un passaggio non richiede una decisione, probabilmente non deve essere nel loop dell'agente.
Quindi cambiamo architettura. I post social vengono estratti via API; con la programmazione si filtrano i dati e li si ripulisce dal rumore; i dati puliti passano a un LLM "flash" (piccolo, veloce, economico) che produce un report dei trend social in crescita. Il report diventa parte dell'input dell'agente, ad esempio nello user prompt.
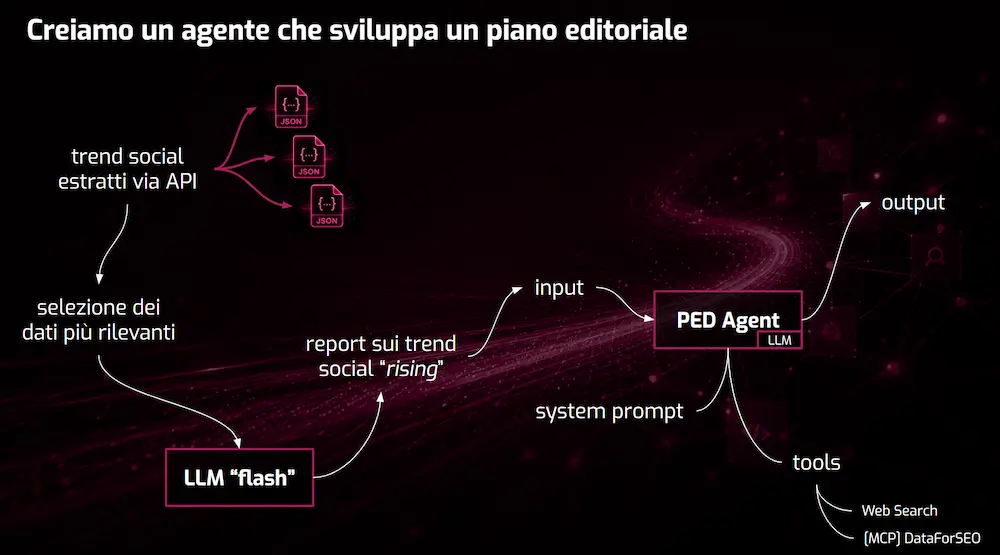
Non stiamo togliendo informazioni. Stiamo cambiando architettura.
Testiamo. L'output è ancora perfetto, e abbiamo ridotto i token in input del 40-50%. Ma il sistema è ancora troppo costoso. E c'è un'altra osservazione, ben più interessante: sommando i token di system prompt e user prompt, il risultato è infinitesimale rispetto al consumo dell'applicazione.
Non sono i prompt a pesare. Sono i tool.
Il tool bloat
Non è un problema della mia applicazione: è un problema strutturale, e si chiama tool bloat.
Anthropic ha raccontato un caso in cui le definizioni dei tool consumavano 134.000 token prima ancora che l'agente li utilizzasse. Cloudflare, nello stesso periodo, ha pubblicato Code Mode partendo dalla stessa diagnosi. Quando i vendor diagnosticano il problema dei loro stessi prodotti, smette di essere un dettaglio implementativo e diventa un principio di design.
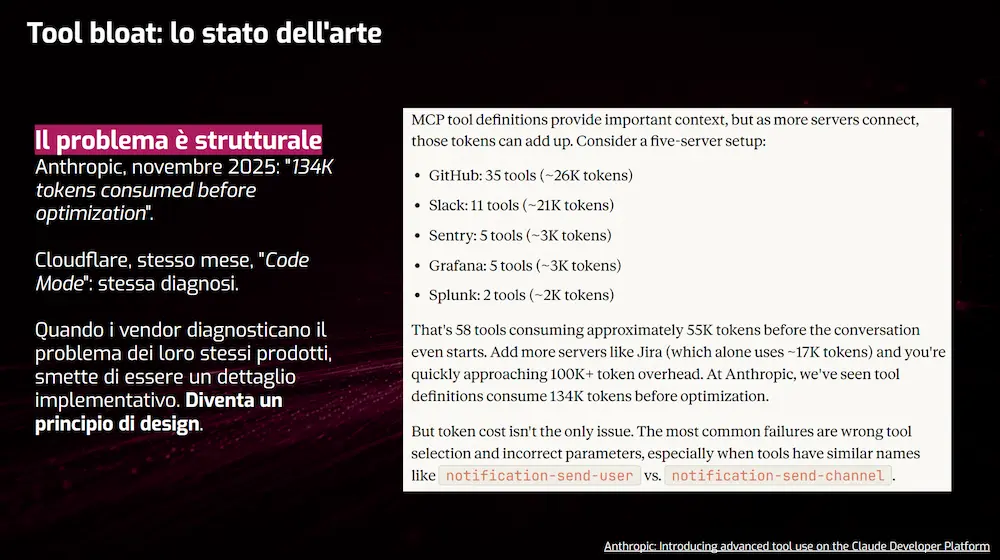
Nel pensiero comune il contesto di un agente è formato da system prompt + user prompt. Ma questa è solo la punta dell'iceberg. Quello che pesa davvero è la parte che non si vede: gli schemi delle API dei tool, i payload che l'agente prepara per chiamarli, i payload di risposta, i passaggi intermedi, i retry, la memoria.
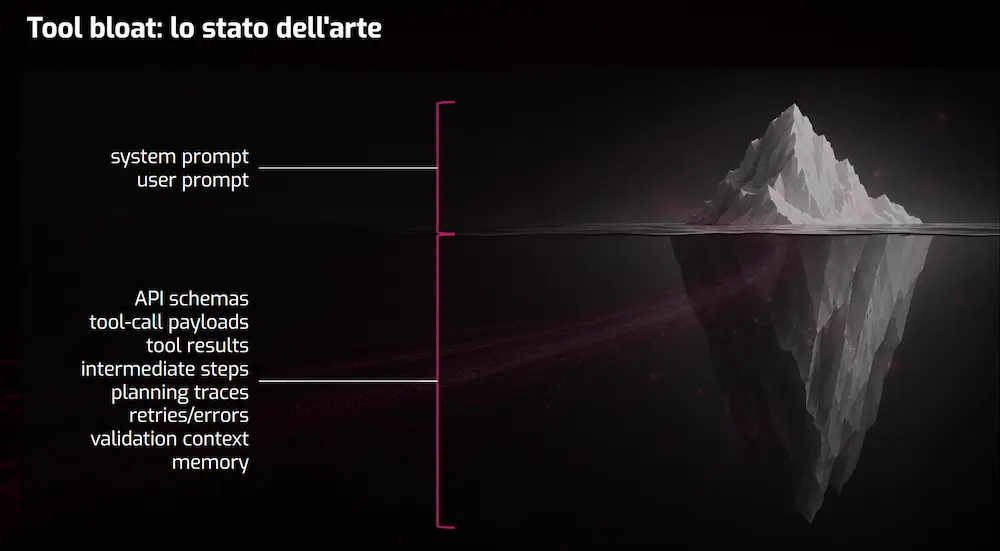
Sul mio progetto l'ho misurato: system e user prompt valevano il 2,2% dell'input, i tool il 91,5%. All'istante zero, prima che l'agente avesse fatto qualunque azione, il contesto era già a 54.678 token, di cui 46.947 erano definizioni di tool.
2) Ridurre: i tool dei server MCP vanno scelti minuziosamente
Quando connettiamo un server MCP a un agente tendiamo a lasciare attivi tutti i tool che espone. In questo modo aumentiamo le possibilità a disposizione dell'agente e favoriamo la scoperta dinamica dei tool, giusto?
Giusto in fase di ricerca e sviluppo. In produzione significa portare rumore nel contesto e alzare i costi.
Il server MCP di DataForSEO espone 79 tool. Ogni tool abilitato, solo per essere disponibile, porta nel contesto la sua definizione e lo schema dei parametri. Lasciando attivi solo i tool strettamente necessari, 7, abbiamo ridotto le definizioni di circa 150.000 caratteri: quasi il 90%.
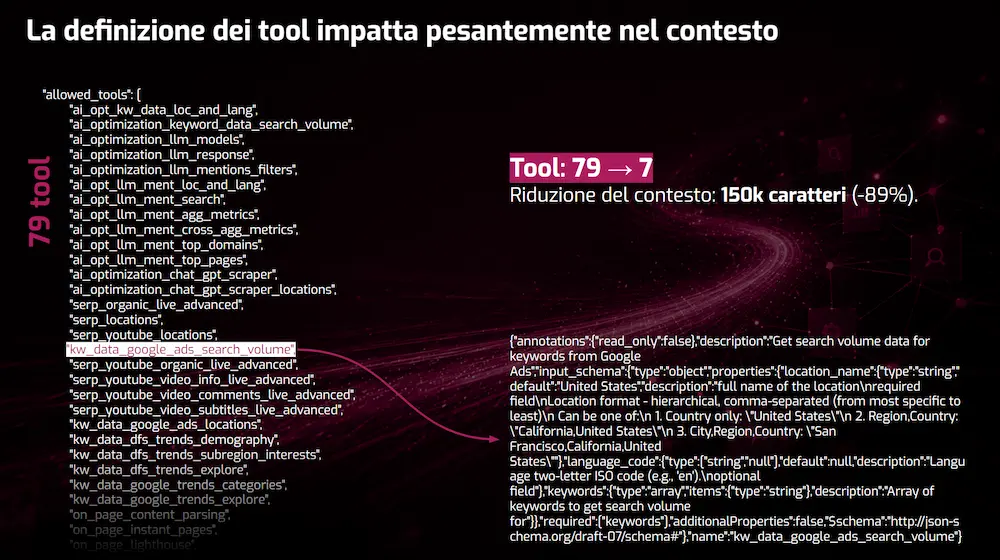
Un intervento banale, con un impatto enorme. Ma attenzione a come si sceglie! In un test avevo lasciato che fosse il modello a scoprire i tool da usare, per poi tenere solo quelli utilizzati. Errore: un agente saturo di contesto usa meno tool (23 chiamate su 7 tool diversi, contro 37 chiamate su 17 tool diversi dell'esecuzione alleggerita). Avrei tenuto i tool che l'agente riusciva a usare quando era in difficoltà, non quelli che gli servono quando lavora bene.
La scelta si effettua studiando la documentazione e testando le API, non solo guardando i log.
3) Guidare: l'agente costruisce il payload, va istruito
Il terzo concetto: è l’agente a costruire il payload di input dei tool, quindi va istruito attentamente.
Durante il reasoning possiamo immaginare che l'agente ragioni in questo modo: "devo estrarre le query che stanno avendo un picco di ricerche". Quindi si chiede: "ho un tool per farlo?", e controlla nel contesto le definizioni dei tool. Successivamente, "di quali parametri ha bisogno?". Li trova, li valorizza, costruisce il payload ed effettua la chiamata. Il tool risponde, e la risposta rientra nel loop.
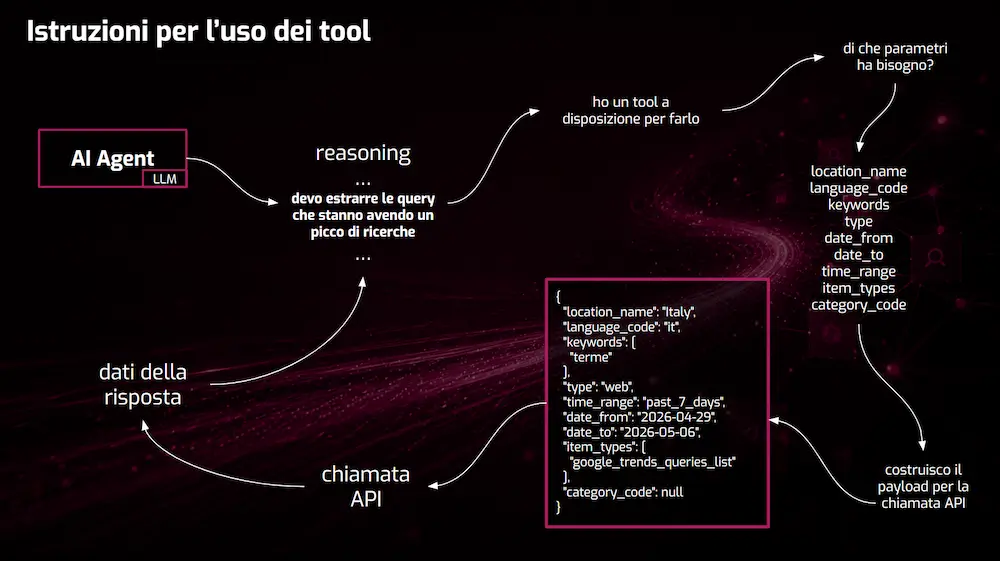
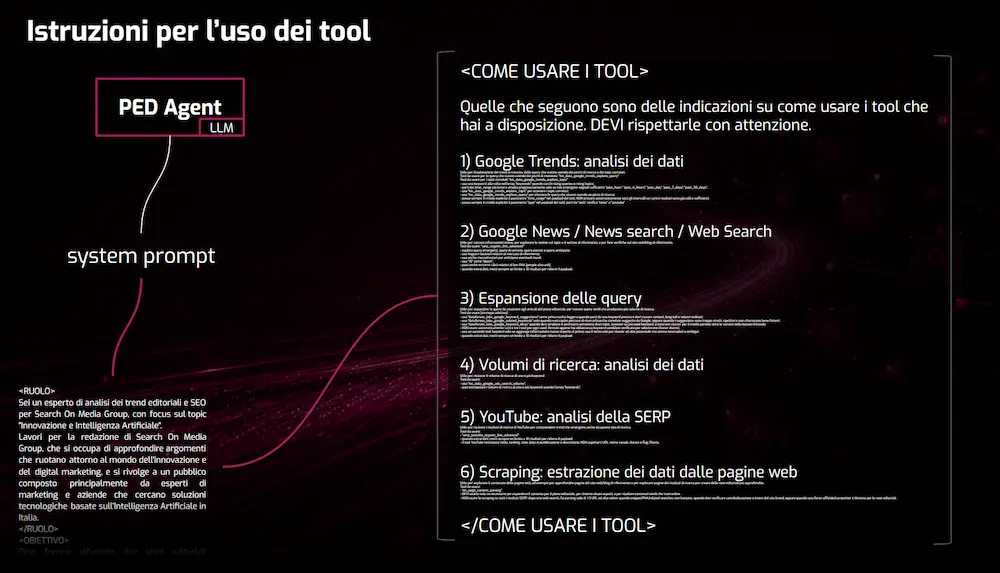
Possiamo quindi istruirlo con un blocco ad hoc nel system prompt (nel mio caso <COME USARE I TOOL>): per ogni azione, quali tool usare e come valorizzare i parametri. Ad esempio per Google Trends ho dato le seguenti istruzioni: partire dagli intervalli più brevi (past_hour, past_4_hours, past_day…) e ampliare progressivamente, senza provare tutte le combinazioni. Per l'espansione delle query, una strategia adattiva: prima un tool, e solo in determinate condizioni il secondo, e poi il terzo.
Il principio:
fermarsi quando abbiamo informazioni sufficienti, non quando abbiamo esaurito tutti i tool disponibili.
Un dettaglio che ho verificato dopo il WMF, e che per me è fondamentale: i modelli possono applicare in modo molto rigido anche istruzioni che introducono inefficienze. Nel mio system prompt c'era una riga ragionevole: "quando un tool prevede il parametro limit, impostalo a 100, servono abbastanza righe per individuare la coda lunga". L'agente ha obbedito. Quella sola riga determinava il 68% del payload di DataForSEO: portarla a 10 (una scelta operativamente sensata per l'azione richiesta) ha ridotto il payload da circa 396.000 a 110.000 token. Potare i tool ne aveva liberati otto volte meno.
Non si tratta di insegnare all'agente operazioni che non sa svolgere, ma di rendere sistematico ciò che può applicare "a caso". L'agente è resiliente: se sbaglia un parametro, ritenta. Ma ogni tentativo fallito è un turno intero del loop (ragionamento, chiamata, risposta, rilettura di tutto il contesto). Nei miei test, passando da istruzioni generiche a istruzioni mirate, a parità di token le chiamate sono scese da 27 a 19, i turni a vuoto da 2 a 0, il reasoning del 33%. Nel percorso complessivo di ottimizzazione di quel progetto: da 824.253 a 133.128 token (-84%), senza pagare la riduzione con la qualità (anzi: volume mediano delle keyword da 1.600 a 2.400, coda lunga dall'11% al 39%).
4) Guidare: dare un budget all'agente
Il quarto concetto: le istruzioni di budgeting sull'uso dei tool riducono costi, latenza e comportamenti ridondanti.
Anche qui un blocco dedicato nel system prompt (<BUDGET TOOLS>) con istruzioni di questo tipo: lavora con un budget progressivo, raccogli prima un insieme minimo di segnali forti e solo dopo approfondisci i cluster più promettenti. Obiettivo operativo: 20-25 chiamate ai tool per esecuzione, con un massimo di 50.
Sono limiti fisici dell'applicazione? No: sono istruzioni che diamo all'agente: funzionano come orientamento, non come garanzia.
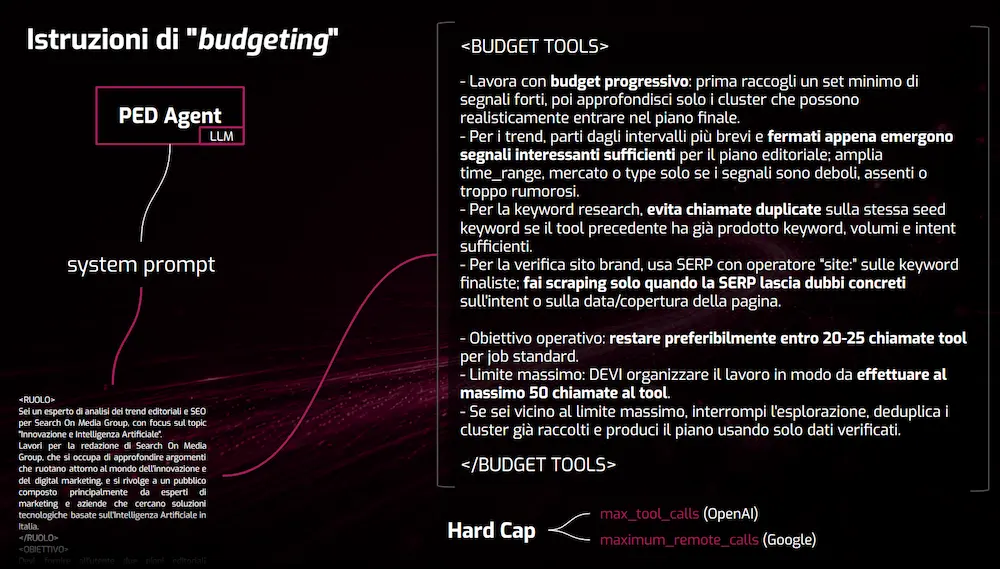
Per imporre limiti fisici occorre intervenire a livello di orchestrazione, eventualmente sfruttando i controlli messi a disposizione da framework e SDK, che variano in base alla tipologia di tool utilizzati.
L'unione tra indicazioni e limiti fisici ci permette di controllare al meglio il budget.
Cosa succede, in pratica? Il budget non taglia le chiamate: le redistribuisce. Nei miei test le chiamate sono passate da 19 a 22 mentre i token sono diminuiti, perché diventano più mirate (più ricerche SERP ma di peso quasi dimezzato, volumi di ricerca raggruppati in una sola chiamata invece di tre). E la qualità dell'output è salita.
C'è un effetto curioso: l'agente tende a reinvestire il budget che liberiamo. In un caso le chiamate SERP sono scese da 4 a 3, ma ciascuna è passata da 5.600 a 10.800 token.
Il prezzo per token non è il costo del task
Una parentesi che al WMF non c'era, ma che oggi per me è centrale. Quando scegliamo il modello per un agente guardiamo il listino: dollari per milione di token.
Il listino dice quanto costa un token. Non dice quanti ne serviranno per completare un task.
Ho messo alla prova quattro modelli su un agente reale in produzione, che costruisce piani editoriali per il blog di un e-commerce beauty: stessi dati registrati e serviti identici a tutti, stesse condizioni, nessuna istruzione sull'uso dei tool. Ecco cosa è emerso (listini al 29/9/2026, costo dei tool escluso):
| Modello | Posizione a listino | Costo medio per task |
|---|---|---|
| gpt-6-luna | 1° (il più economico) | 0,011 $ |
| gpt-5.6-terra | 4° (il più caro) | 0,159 $ |
| gemini-3.8-flash | 2° | 0,165 $ |
| claude-sonnet-5 | 3° | 0,734 $ |
Il modello con il listino più alto in output (terra, 12 $/M) spende per task quanto Gemini Flash, che a listino costa circa tre volte meno. E due modelli con lo stesso prezzo in input (terra e Sonnet 5, 2 $/M) hanno avuto costi diversi di 4,6 volte.
Perché? Il costo dipende dai seguenti tre aspetti
- Quanti turni esegue il modello: a ogni turno rilegge l'intero contesto accumulato. Terra chiude sempre in 4 turni raggruppando le chiamate indipendenti nello stesso turno; Gemini ne fa 8, quasi una chiamata alla volta.
- Quanto contesto accumula: Sonnet, il più esplorativo, ha elaborato 6,6 volte l'input di terra con un numero simile di chiamate.
- Quanto lo protegge la cache: le riletture servite dalla cache costano circa un decimo. Nel test OpenAI ne serve il 90%, Gemini su Vertex AI il 47%.
Per verificarlo ho fatto un test a parità di lavoro: 24 chiamate indipendenti, eseguite o tutte nello stesso turno (2 turni) o una per turno (25 turni). In sequenza, il costo senza cache cresce di 6-8 volte, perché lo stesso contesto viene riletto 11,6 volte. In parallelo, Gemini costa la metà di terra, come dice il listino. In sequenza, costano uguale.
La metrica corretta da osservare è il costo per task: quanto spendo per ottenere il risultato finito, misurato sul mio task e con i miei tool, e letto insieme alla qualità (meglio ancora: il costo per task riuscito).
Conta anche la prevedibilità: Terra ha costi quasi identici a ogni esecuzione, Gemini è oscillato fino a 3 volte. E una sola istruzione nel system prompt ("puoi richiamare più strumenti nello stesso turno, e devi farlo quando i dati sono indipendenti") può cambiare la politica di un modello, e quindi la fattura.
5) Controllare: la web search nativa costa, e spesso non sappiamo come funziona
Il quinto concetto riguarda la web search integrata nei framework agentici. Facilissima da implementare: basta un parametro, o una spunta in un'interfaccia visuale. Ma, come sempre, la semplicità si paga.
In ambiente OpenAI si pagano 10 dollari ogni 1.000 chiamate, più i token estratti al costo del modello. In ambiente Google 14 dollari ogni 1.000 query (Gemini 3), con i token estratti non conteggiati come input. Sono sistemi difficili da confrontare, ma dalla mia esperienza hanno due caratteristiche in comune:
- su larga scala impattano sui costi;
- sono poco controllabili: non sappiamo esattamente cosa entra nel contesto dell'agente.
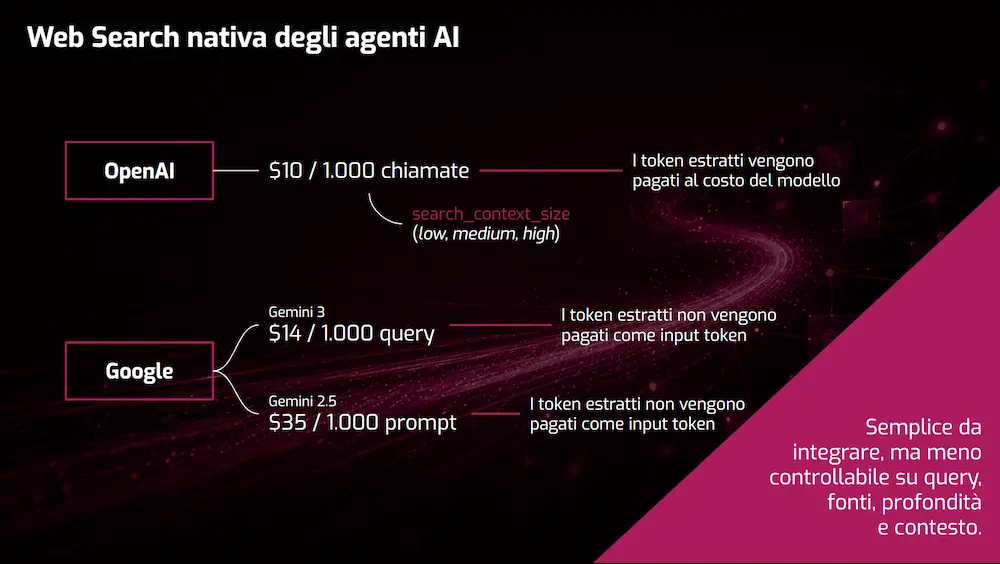
L'alternativa è costruire una web search personalizzata: con strumenti come Tavily, che offre output già LLM-friendly, oppure con i tool di DataForSEO, dove possiamo costruire vere strategie di ricerca unendo la search e lo scraping dei contenuti, in modo progressivo. Nel mio progetto questo ha abbattuto i costi fino all'80%, e soprattutto ha dato il controllo preciso di ciò che entra nel contesto.
Dopo l'evento ho messo a confronto le tre opzioni sullo stesso compito, costruito per obbligare a più ricerche dipendenti l'una dall'altra. Il risultato non è una classifica: è un trade-off.
| Configurazione | Token in input | Chiamate | Fonti primarie | Fatti verificati |
|---|---|---|---|---|
| Ricerca nativa OpenAI (medium) | 59.741 | 7 | 90% | 3 su 4 |
| DataForSEO (SERP + parsing) | 54.644 | 19 | 57% | 4 su 4 |
| Tavily (search) | 29.093 | 16 | 80% | 3 su 4 |
Ricerca nativa, DataForSEO e Tavily a confronto
Tavily porta metà del contesto della ricerca nativa, ma paga 16 chiamate a tariffa piena: contesto più leggero, fattura più alta. DataForSEO è l'unica configurazione a 4 fatti su 4, ma restituisce contenuto "sporco" (markdown grezzo, menu di navigazione, boilerplate: circa 6.200 token contro i 1.500 di prosa pulita di Tavily). Con la ricerca nativa, il contenuto estratto non è nemmeno esposto dall'API: non lo leggi, non lo filtri, non lo comprimi.
La ricerca non è un costo: sono due. Il modello e il tool. Ottimizzarne una sola può peggiorare l'altra.
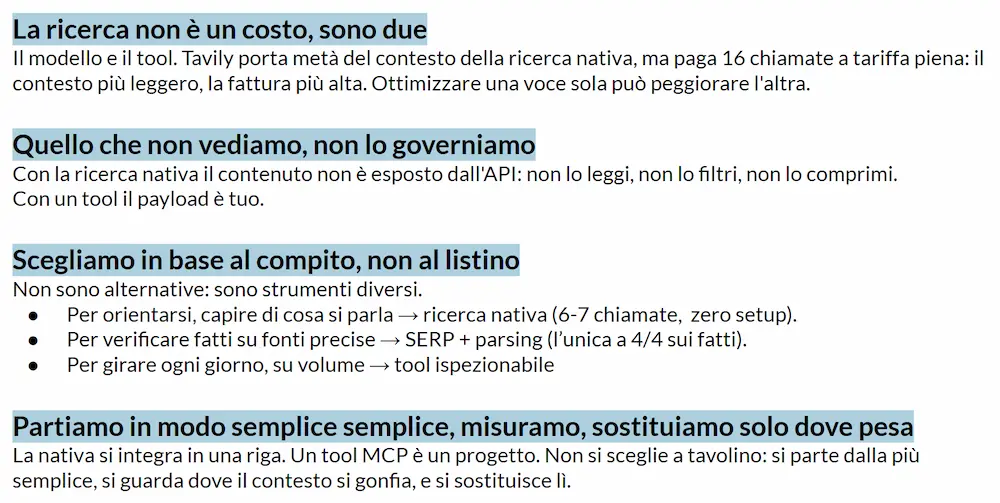
La mia indicazione: partire dalla soluzione più semplice (la nativa si integra in una riga), misurare, e sostituirla solo dove il contesto si gonfia.
6) Controllare: i server MCP non sono ottimizzati per la nostra applicazione
Il sesto concetto è quello che a me ha aperto la mente sullo sviluppo di sistemi agentici.
MCP, come protocollo, nasce per interfacciare i tool a un agente. Ma non è detto che i server MCP siano ottimizzati per questo utilizzo. Spesso sono un semplice incapsulamento delle API dei servizi. E, aggiungo, probabilmente non saranno mai ottimizzati per la nostra applicazione specifica.
Un esempio. L'agente decide di cercare sulla SERP di YouTube: prepara il payload, usa un tool, e la risposta (un JSON) rientra nel loop. Ogni item della risposta corrisponde ai dati di un video, con decine di attributi: id, rank, thumbnail, id e logo del canale, durata…
All'agente, per decidere, servono tutti questi dati?
NO! Gli servono quelli indicati dalle frecce: titolo, descrizione, visualizzazioni, data. Questo fa capire immediatamente il tasso di "rumore" che portiamo nel contesto, e lo spreco di token che ne deriva.
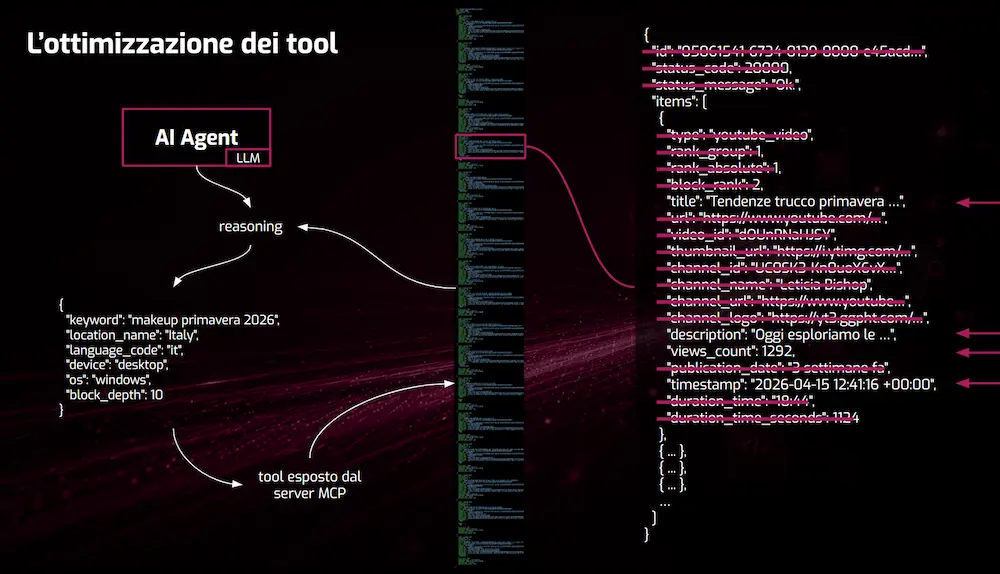
Cosa possiamo fare? Invece di usare il tool del server MCP, implementiamo una funzione custom, che usa la stessa API ma che, prima di far rientrare i dati nel contesto dell'agente, pulisce tutto il rumore. Non usiamo più il tool MCP: usiamo il function calling, con un payload snello. Nel nostro caso, in media, -80%.
Non è una sintesi: è una selezione di dati. Non serve saper scrivere un server MCP, servono dodici righe di codice che scelgono sette campi. Chi usa un coding agent se le fa scrivere, ma nessuna AI può sapere quali sette campi servono: dobbiamo saperlo noi.
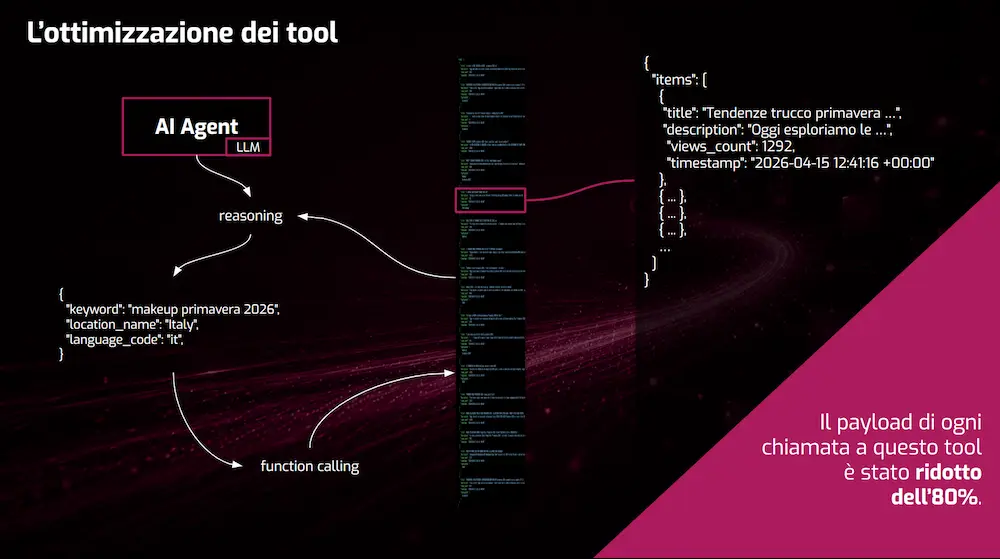
E visto che stiamo implementando una funzione, possiamo spingerci oltre e aggiungere una funzionalità: l'URL del video, che abbiamo a disposizione, viene passato a un LLM "flash" per ottenere i topic trattati. Questo dato entra nel payload.
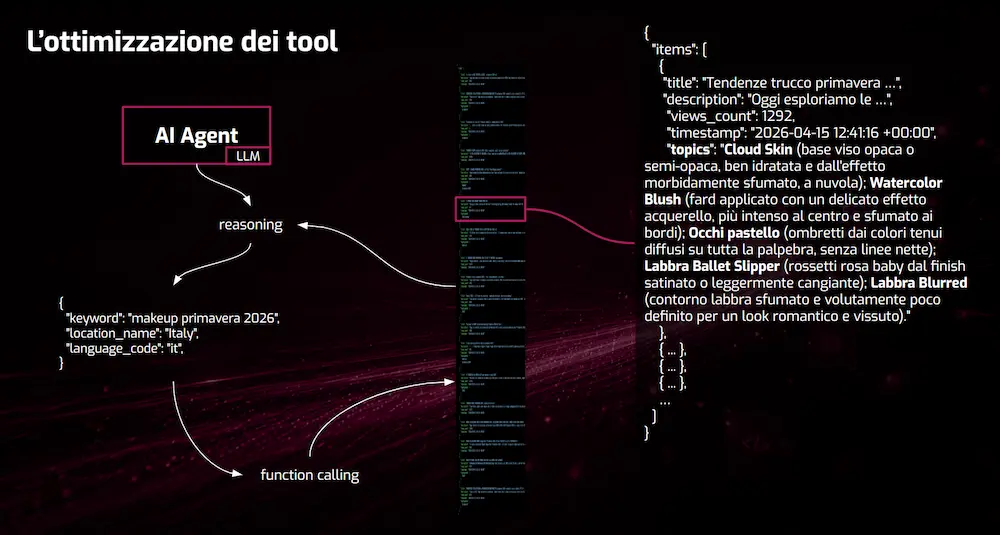
Qui sacrifico leggermente lo snellimento del payload per aumentare drasticamente la qualità del dato che porto nell'agente. Non solo meno rumore e meno costi: più informazione utile.
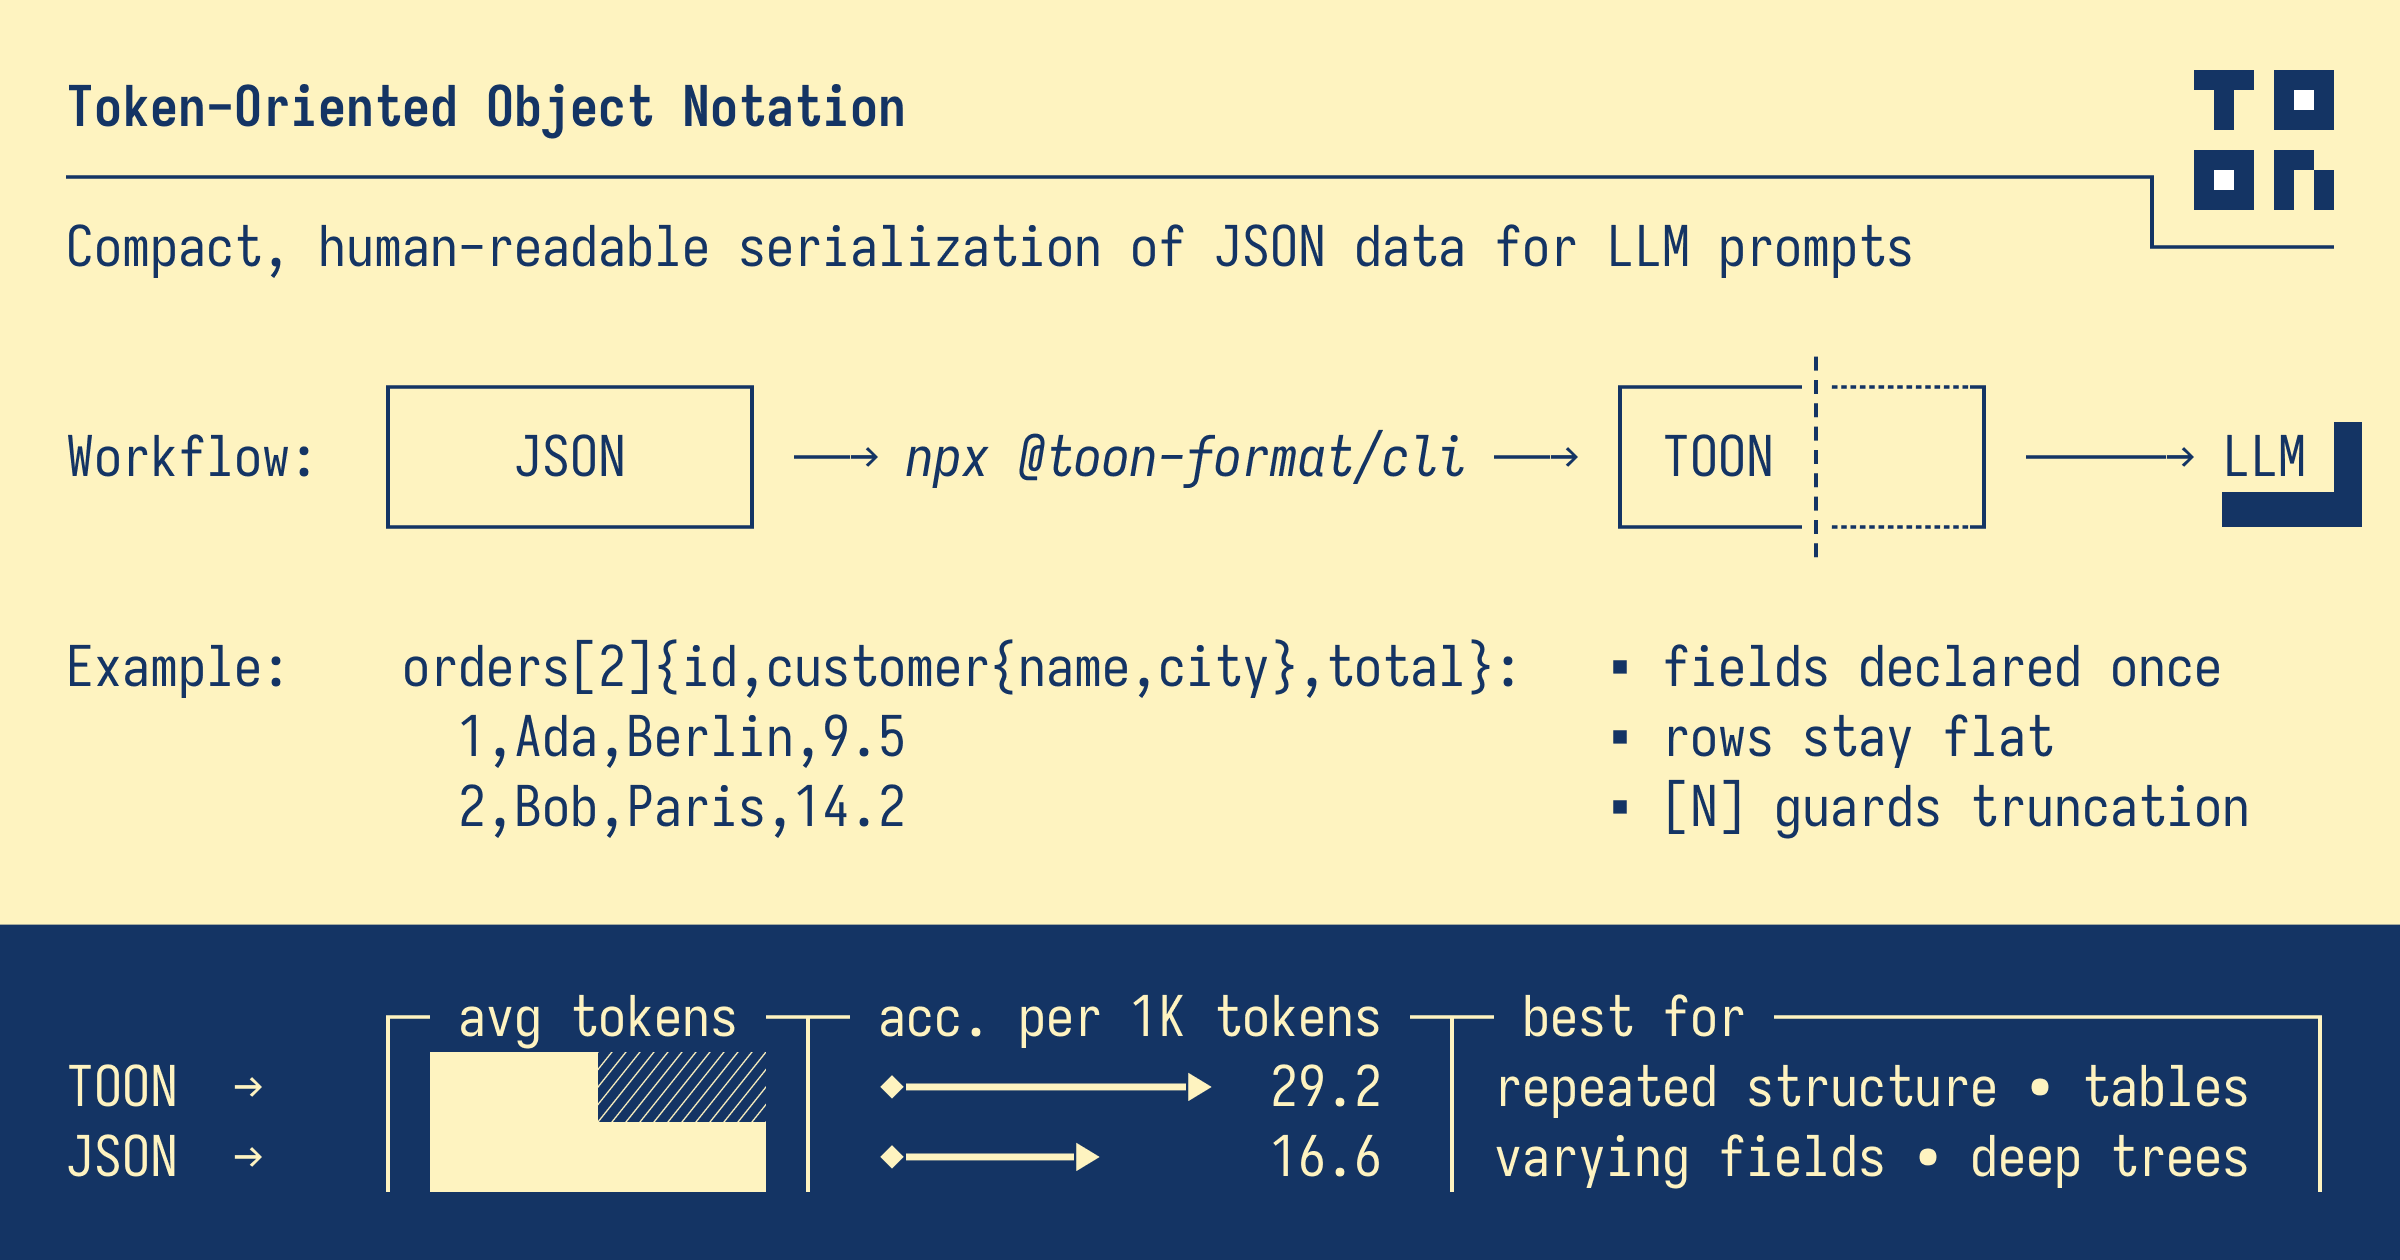
Si può ottimizzare anche il formato. I dati di scambio tra tool e agente sono di solito JSON, che per strutture ripetitive come queste spreca caratteri. Con formati come TOON (o formati custom che ci possiamo inventare) lo stesso payload si può ridurre anche del 60% senza perdere informazioni.
 Johann Schopplich
C'è poi un'ultima opportunità. Quando connettiamo un server MCP, la definizione dei tool e dei parametri è decisa da chi lo ha sviluppato: non abbiamo nessun potere di intervento. Se la funzione la scriviamo noi, la definizione la scriviamo noi. E possiamo spiegare all'agente, nel dettaglio, come usare la funzione e come valorizzare al meglio i parametri: le istruzioni che prima stavano nel system prompt possono vivere dentro il tool.
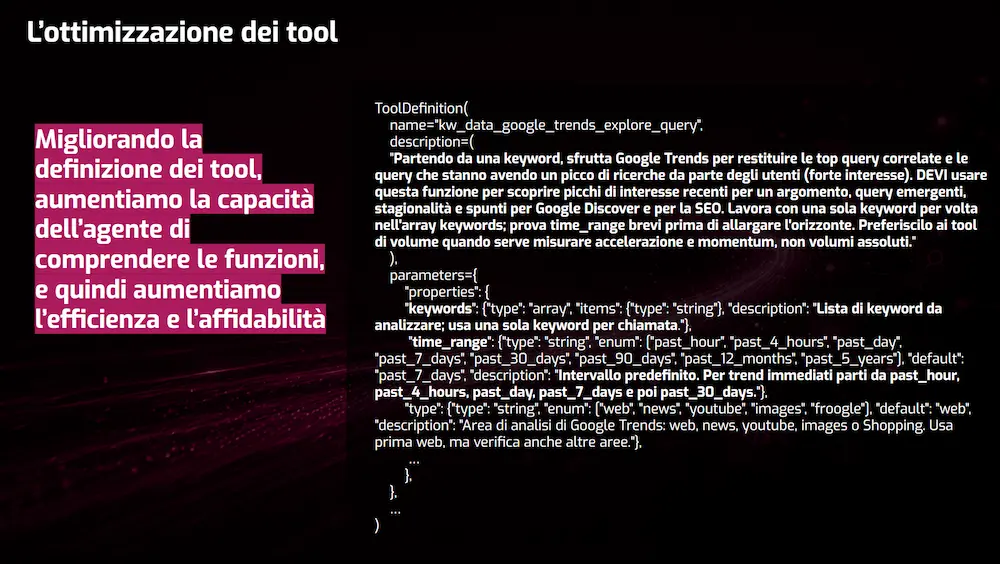
Per me, questa è l'essenza del prompt engineering applicato alle applicazioni agentiche. Non è solo nel system prompt che possiamo fare la differenza.
Con tutte le ottimizzazioni viste fin qui siamo riusciti a ridurre mediamente del 75% i costi di esecuzione del progetto, trasformando una demo wow in un processo prima di tutto contenibile, ma soprattutto molto più affidabile.
L'evoluzione: Programmatic Tool Calling
Anche questa è una parte che non c'era nel mio intervento, perché la funzionalità non esisteva ancora. Ed è l'evoluzione naturale del concetto 6.
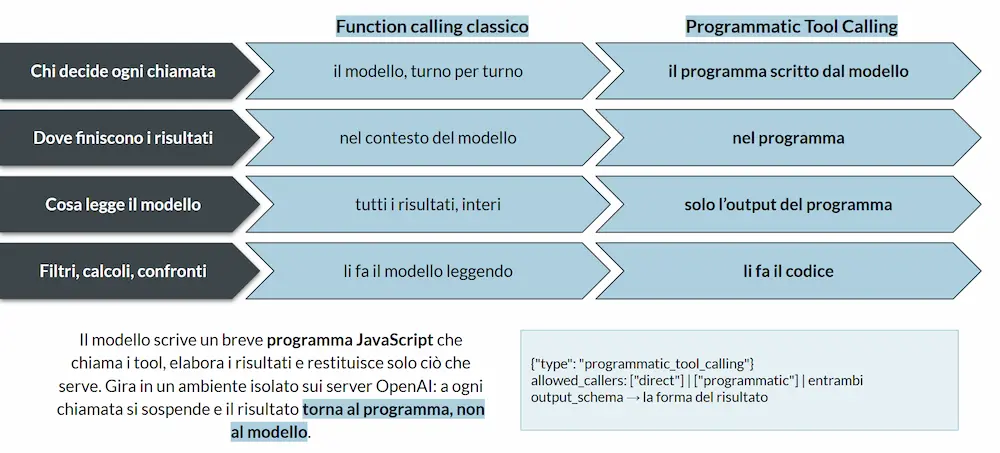
Nel function calling classico ogni chiamata la decide il modello, turno per turno, e tutti i risultati rientrano interi nel suo contesto: filtri, calcoli e confronti li fa il modello leggendo. Con il Programmatic Tool Calling (PTC) di OpenAI il modello scrive invece un breve programma JavaScript che chiama i tool, elabora i risultati e restituisce solo ciò che serve. Il programma gira in un ambiente isolato sui server OpenAI: a ogni chiamata si sospende, e il risultato torna al programma, non al modello.
È la stessa idea del filtro che avevamo scritto a mano, con una differenza: ora il filtro lo scrive il modello.
L'ho messo alla prova su due task molto diversi, con gli stessi modelli e senza mai nominare il PTC nel prompt.
| Task A: esplorazione | Task B: verifica di massa | |
|---|---|---|
| Cosa fa | L'agente che costruisce il piano editoriale e deve leggere i risultati per decidere |
40 keyword × (volume + ricerca site: sulblog) = 80 chiamate, per una shortlist con regola esatta |
| Dati che tornano al modello |
60-97% | 12-52% |
| Effetto sul costo |
nessun risparmio; con un modello +116% (80 chiamate invece di 52) |
fino a -86% |
| Accuratezza | invariata | migliore (con PTC obbligatorio, shortlist sempre corretta) |
Nessun risparmio sull'esplorazione, fino a -86% sulla verifica di massa.
Nel Task A il programma faceva solo da contenitore per chiamate parallele, cosa che il function calling ottiene già nello stesso turno: il modello doveva comunque leggere i dati per decidere. Nel Task B, invece, delle risposte dei tool (118.000 caratteri) il modello ha ricevuto solo la tabella finale. E applicare "a occhio" una regola su 40 risultati porta errori: in modalità standard un modello ha sbagliato la shortlist in tutte le esecuzioni.
Il prezzo da pagare non è in token, ma in tempo: con il PTC obbligatorio, nel Task B il tempo è triplicato (fino a 5 volte con un modello più piccolo). E restituire troppi dati costa due volte: l'output di un programma troppo lungo viene troncato, e un modello ha dovuto ripetere le chiamate.
La domanda da farsi è semplice:
Il modello ha bisogno di leggere i dati, o solo di un risultato calcolato da quei dati?
Il PTC conviene per la stessa operazione su una lista lunga, per risultati voluminosi da cui servono pochi campi, per regole esatte (soglie, filtri, ordinamenti) e per calcoli e aggregazioni. Non conviene (o con cautela) per l'esplorazione, quando la latenza è importante, o con modelli piccoli. La soluzione è un'architettura ibrida: i tool di esplorazione restano a chiamata diretta, le verifiche di massa passano da un programma.
7) Osservare
Il settimo concetto è quello che manca: l'osservabilità.
Gli agenti AI possono (anzi, devono!) essere monitorati in ogni dettaglio: ogni decisione, ogni tool, ogni payload, ogni passaggio. E anche con controlli qualitativi automatici, sistemi che valutano la qualità dell'output in base a metriche che definiamo noi, e ci avvertono quando un'esecuzione non rispetta il nostro standard.
Noi usiamo sistemi sviluppati internamente, ma un'ottima soluzione è LangSmith: traccia con estremo dettaglio ogni azione di un agente o di un workflow multi-agente, permette alert personalizzabili e la creazione di grader basati su LLM.
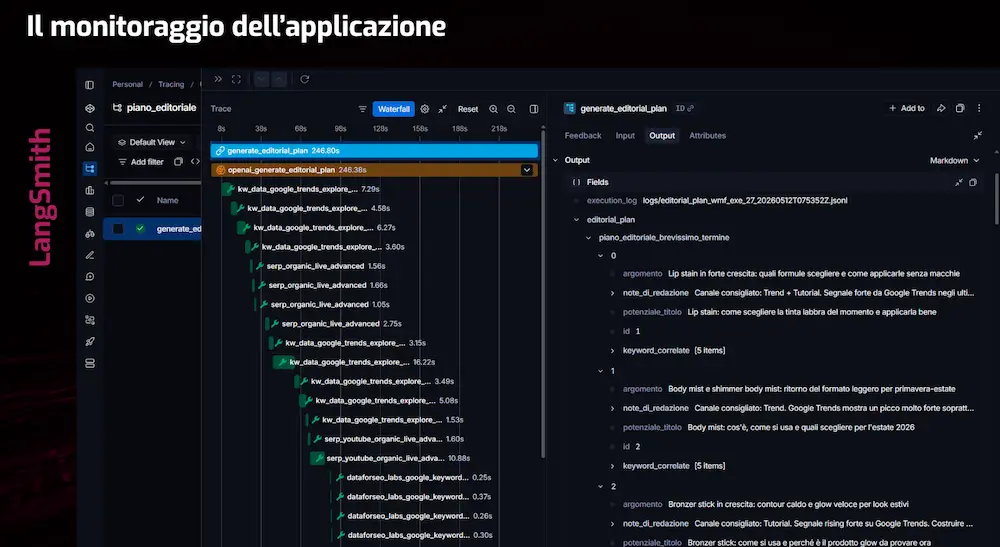
Perché è così importante?
Un agente che sbaglia non si spegne. Continua a produrre output plausibili, ben formattati, consegnati in orario.
Salta metà del protocollo perché è saturo di contesto, tira a indovinare i parametri, reinveste il budget liberato in chiamate più pesanti. "È acceso" non basta: dobbiamo sapere se funziona. E per misurarlo non bastano le richieste API: servono la quota di dati che torna nel contesto, il numero di chiamate per task, il tempo totale, il costo per task riuscito.
Uno sguardo al futuro: tre tappe
Chiudo come ho concluso l'intervento, con uno sguardo alle applicazioni agentiche di domani, attraverso tre concetti.
1. Eterogeneità computazionale
I processi più ripetitivi e di routine saranno svolti sempre più da modelli piccoli, mentre orchestrazione e reasoning saranno affidati a modelli più grandi. Un paper di NVIDIA (Small Language Models are the Future of Agentic AI) propone proprio sistemi eterogenei, con latenza e FLOPs ridotti di 10-30 volte a parità di accuratezza. È lo stesso principio che abbiamo applicato ai trend social, portato a livello di sistema: non il modello più potente, ma quello adeguato al compito.
 Peter Belcak
2. Agentic Context Engineering
Il system prompt smetterà di essere un file statico di istruzioni per diventare un playbook dinamico, che si auto-aggiorna in base all'osservazione dell'output dell'agente. Una sorta di fine-tuning del contesto, senza modificare i pesi del modello.
 Qizheng Zhang
3. Code Execution. La visione di Anthropic per cui l'agente, invece di ragionare, chiamare un tool, leggere i dati e ripartire, sviluppa una piccola applicazione che orchestra le chiamate e fa entrare nel contesto solo il risultato finale. Il Programmatic Tool Calling visto sopra ne è, di fatto, una declinazione.
 Anthropic
Dalla magia al design dell'architettura
Spero che il viaggio sia servito a far capire un aspetto: passando dalla demo alla produzione, quella che chiamavamo magia diventa design dell'architettura.
Diventa decidere cosa deve entrare nel loop. Quali strumenti devono essere disponibili. Come devono essere chiamati. Cosa devono restituire. Quanto il sistema può spendere. E come possiamo misurare ciò che accade.
Passando da una demo alla produzione,
la “magia” diventa “design dell’architettura”.
Non so se sia una buona notizia per tutti, ma per me lo è:
anche nelle applicazioni agentiche, a fare la differenza rimane la conoscenza chirurgica dei processi.
Scegli questo sito web come fonte preferita
Ricevi più facilmente questi contenuti tra i risultati di Google.
Potrai modificare questa preferenza in qualsiasi momento dalle impostazioni di Google.
- GRAZIE -
Se hai apprezzato il contenuto, puoi
contribuire al progetto con una donazione 🙂